[AAFLOW+] Stateful Operator Abstraction with Zero-Copy Distributed KV Cache Orchestration for Multi-Agent Workflows
AAFLOW+系统将KV缓存作为一等分发系统对象,实现零拷贝的多智能体工作流执行状态共享
[AAFLOW+] Stateful Operator Abstraction with Zero-Copy Distributed KV Cache Orchestration for Multi-Agent Workflows: AAFLOW+系统将KV缓存作为一等分发系统对象,实现零拷贝的多智能体工作流执行状态共享
一、论文概述
| 属性 | 内容 |
|---|---|
| 论文标题 | [AAFLOW+] Stateful Operator Abstraction with Zero-Copy Distributed KV Cache Orchestration for Multi-Agent Workflows |
| 论文编号 | arXiv:2607.10987 |
| 作者 | Arup Kumar Sarker, Alexander James Halpern, Mills Staylor, Aymen Alsaadi, Gregor von Laszewski, Yue Cheng, Shantenu Jha, Geoffrey Fox |
| 机构 | University of Virginia Biocomplexity Institute, Rutgers University |
| 标签 | multi-agent, KV cache, distributed systems, workflow, zero-copy, state management |
| 图表数 | 10 张 |
| 可下载图片 | 是 |
摘要: Multi-agent LLM systems increasingly integrate retrieval, planning, and reasoning, but remain fundamentally text-centric, requiring agents to repeatedly recompute shared context through expensive prefill. Although single-request inference is known to be accelerated by KV-cache management, it is usually restricted to local serving scopes. We introduce AAFLOW+, a stateful extension of agentic workflow operators that makes KV cache a first-class distributed systems object. AAFLOW+ builds process-le…
二、核心思想
问题:多智能体系统中文本中心通信方式导致每个代理需要重新解释(pre-fill)共享上下文,造成大量重复计算。虽然单次请求推理中KV缓存管理已被证明可加速,但通常仅限于本地服务范围内。方案:AAFLOW+将有状态算子抽象引入多智能体工作流,将KV缓存作为第一类分布式系统对象,提供Materialize/Fork/Transfer/Merge/Eviction六种操作原语,实现跨分支执行图的零拷贝KV状态共享。
三、技术架构
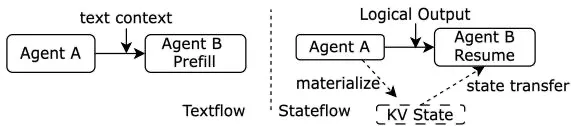
现有文本中心(textflow)的多智能体系统中,共享上下文只能以文本形式在代理间传递,下游代理必须对相同上下文重复执行昂贵的 prefill;AAFLOW+ 转向状态流(stateflow),直接传输可复用的 KV 执行状态。
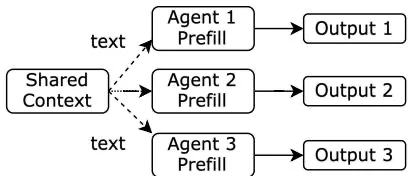
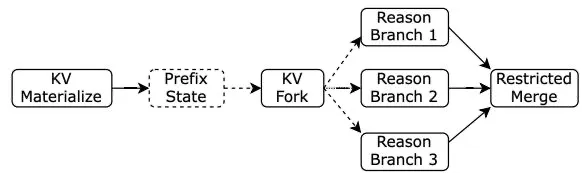
在树状/分支的多代理执行图中,多个分支共享同一前缀上下文,文本方案会在每个分支上重复相同的 prefill 计算。
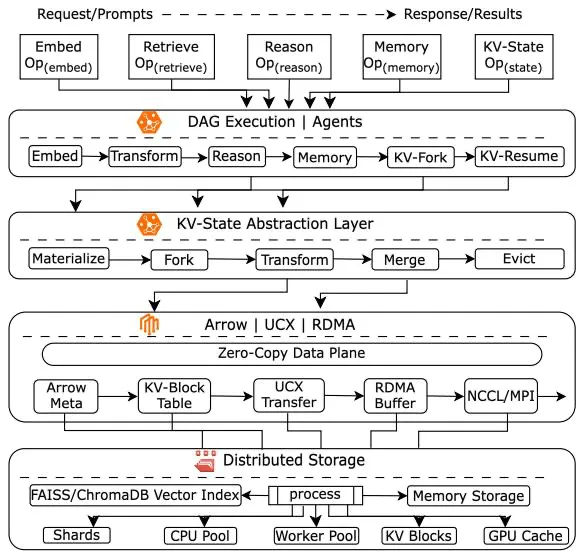
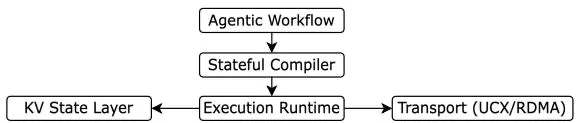
分层架构:
- Layer 1: 编译器(Compiler)— 将Agent工作流编译为有状态执行图
- Layer 2: 运行时(Runtime)— 执行有状态操作符、管理任务调度
- Layer 3: KV状态层(KV State Layer)— 存储、追踪和管理KV状态
- Layer 4: 传输子系统(Transport)— 网络感知的KV状态传输
有状态算子: Op_i^s = (I_i, O_i, S_i^in, S_i^out, f_i, P_i, sigma_i)
- 在传统算子(I,O,f,P)基础上增加:状态输入S_in、状态输出S_out、状态转换符sigma
KV状态对象: S_KV = (M, Theta, B, Pi, Lambda, Gamma)
- M=metadata, Theta=KV type, B=size, Pi=position, Lambda=lineage, Gamma=ownership
成本模型:
- Text-based k-agent: T_text^k ~ k*T_prefill(L) + sum_j T_decode(Y_j)
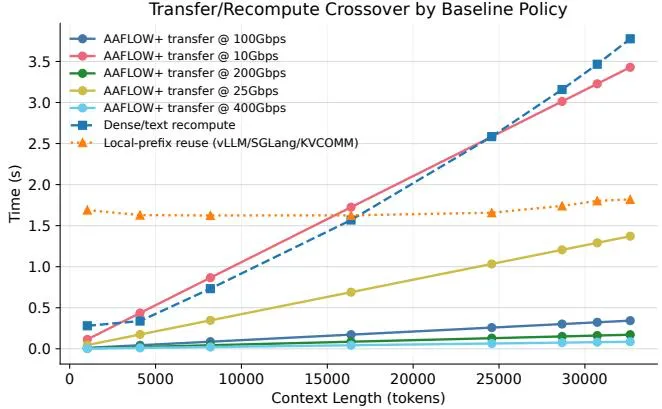
- AAFLOW+: T_transfer(KV) + T_resume + Omega_state < T_prefill(L) + Omega_text
核心公式:
- Eq(1): W = {Op_embed, Op_retrieve, Op_reason, Op_memory, Op_upsert}
- Eq(5): T_agent = T_prefill(L) + T_decode(Y) + Omega
- Eq(6): T_text^k ~ k*T_prefill(L) + sum T_decode(Y_j)
- Eq(7): T_transfer(KV) + T_resume < T_prefill(L)
- Eq(8): Op_i^s = (I_i, O_i, S_i^in, S_i^out, f_i, P_i, sigma_i)
KV 状态生命周期:
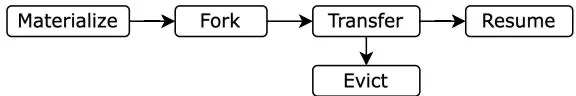
每个 KV 状态从物化(creation)开始,经 Fork/Transfer 被复用,最终在不再被引用时按 LRU/ARC 策略淘汰(eviction),血缘(lineage)与所有权(ownership)贯穿全程。
有状态算子的组合:
有状态算子将推理算子(reasoning operators)与 KV 状态算子(state operators)组合在同一执行图中,虚线表示状态依赖边 E_s,实线表示数据依赖边 E_d。
系统架构:
四、核心创新
| 创新点 | 描述 |
|---|---|
| KV作为一等对象 | KV缓存是具有血缘跟踪、所有权语义的可重用执行工件 |
| 六种KV操作原语 | Materialize, Fork, Transfer, Resume, Merge, Eviction |
| 状态感知调度 | 基于转移vs重计算的成本模型做出最优调度决策 |
| RDMA-like零拷贝传输 | 高效的网络KV传输,避免重复pre-fill计算 |
| 编译器和运行时 | 集成HF transformers的原型实现,支持多种拓扑 |
五、代码实现分析
编译器(Compiler):
- 解析Agent工作流W
- 构建有状态执行图G_s=(V, E_d, E_s)
- E_d表示数据依赖边,E_s表示状态依赖边
KV-State Manager:
- 维护KV状态元数据目录(M)
- 追踪KV状态的血缘关系(Lineage)
- 管理KV状态的所有权(Ownership)
- 实现LRU/ARC淘汰策略
Transport Subsystem:
- 网络感知的KV状态传输
- RDMA-like高效传输协议
- 比较transfer cost vs recompute cost做决策
Branching Optimization:
- 在fork点判断:是transfer父分支KV还是让子分支recompute
- 基于上下文长度、网络带宽、KV大小做决策
六、实验结果
实验设置:
- 模型:HF + Mistral
- 后端:HF transformers
- 规模:最多16个Agent
5组实验结果:
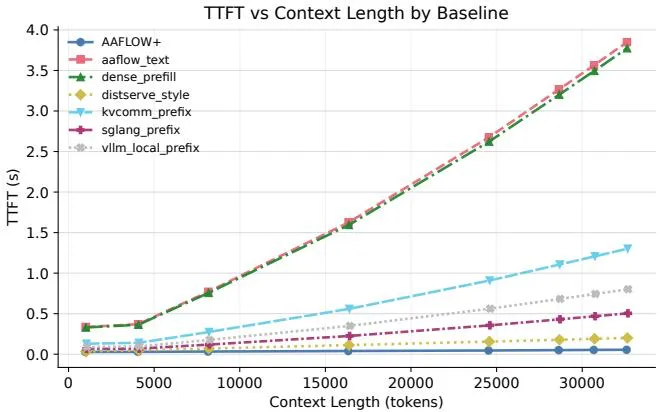
- TTFT vs 上下文长度:文本基线(textflow)的 TTFT 随上下文长度线性扩展,而 AAFLOW+ 通过直接传输 KV 状态避免了重复 prefill,TTFT 增长明显更平缓。
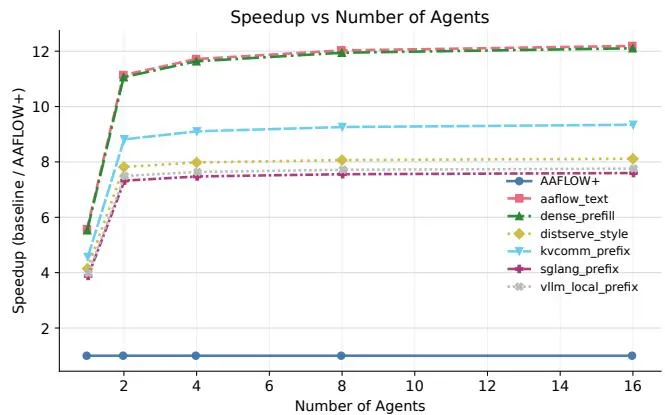
- 多Agent扩展:随着 Agent 数量增加,传统文本方案的总延迟和加速比迅速恶化,AAFLOW+ 的有状态算子抽象展现出良好的扩展性。
- Transfer vs Recompute 收益:分析了 RDMA-like 传输相对于重计算的边界条件,确定何时传输 KV 状态比重新 prefill 更优(约 2× 收益)。
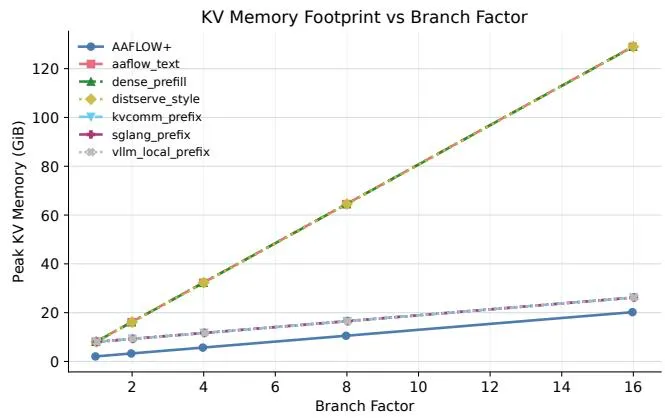
- 内存效率:平均峰值 KV 内存占用显著降低,验证了 KV 状态可复用性对内存压力的缓解效果。
- 吞吐量与框架开销 Omega 分析:证明 AAFLOW+ 的系统开销远低于节省的计算成本。
七、相关工作
- 多智能体工作流编排(Text-based workflows)
- KV缓存服务(单请求范围局限)
- 分布式LLM serving
- Agentic workflow orchestration
- Distributed inference systems
本文区别:首次在有状态多智能体工作流中将KV缓存提升到一等分发系统对象级别。
八、总结
贡献:
- 提出AAFLOW+框架和有状态算子抽象,将KV缓存作为一等分布式系统对象
- 设计六种KV操作原语(Materialize/Fork/Transfer/Resume/Merge/Eviction)
- 实现零拷贝KV状态共享,显著减少多智能体系统中的重复预填充计算
- 开发集成HF transformers的原型编译器和运行时
影响:
- 为多智能体LLM系统提供了一种新的执行状态管理范式
- 使KV缓存管理从局部服务扩展为分布式系统级操作
局限性:
- 当前依赖HF transformers后端,扩展到其他框架需要额外适配
- KV状态的网络传输带宽约束在特定网络环境下可能成为瓶颈
参考资源: