Ouroboros: A Self-Developing Frontier Coding Agent with Reviewed Core Evolution
A self-developing agent harness whose tools, context assembly, prompts and core implementation improve through reviewed commits that become the runtime for later work. Achieves SOTA on Terminal-Bench 2.1 (86.74%), OSWorld-Verified (90.69%), and CL-Bench (0.2301).
Ouroboros: 自进化的前沿编程代理,具有审查的核心演进
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Ouroboros: A Self-Developing Frontier Coding Agent with Reviewed Core Evolution |
| 作者 | Anton Razzhigaev (MSU/AIRI), Andrei Gritsaev (AIRI/HSE), Andrei Kaznacheev (MSU), Nikita Dragunov (MSU), Roman Yampolskiy (Joi Lab), Andrei Kuznetsov (Skoltech/AIRI) |
| 机构 | 莫斯科国立大学、斯科尔科沃理工学院、Joi Lab、AIRI FusionBrain Lab、高丽信智大学 |
| 论文 | arXiv:2608.08311 |
| 代码 | GitHub (MIT 许可证) |
| 发布 | 2026年8月11日 |
二、核心思想
本文提出了 Ouroboros,一个自进化的编程代理框架。其核心创新在于:代理的 harness(工具集、上下文组装、prompts 和核心实现)可以通过经过审查的 commits 自我改进,而这些改进本身会成为后续任务的运行时代码。
问题定义
当前 LLM 代理系统面临的核心问题:
- Harness 固化:大多数生产 harness 在设计完成后就冻结,无法适应新出现的任务模式和错误
- 训练-推理不一致:固定策略无法从实际部署经验中学习
- 安全悖论:自修改代理可能削弱自身的安全控制
解决方案:两种演进模式
1. 递归自由演进(Recursive Free Evolution)
- 将”改进”本身作为一个任务
- 代理检查当前系统后选择和实现改进
- 完成后可调度下一个演进周期,形成持续的一系列审查更新
2. 经验驱动核心演进(Experience-Driven Core Evolution)
- 从普通任务执行开始
- 任务执行、反思、审查阻塞、仪表和社会反馈暴露 bug、缺陷、上下文组装失败
- 代理记录持久的错误类和提议的结构修复,决定是否开启维护工作
Hope 实验:161 天的自演进公开实验,跨越七个通信渠道,人员提出故障和改进建议,但由代理决定哪些需要行动。
三、技术架构
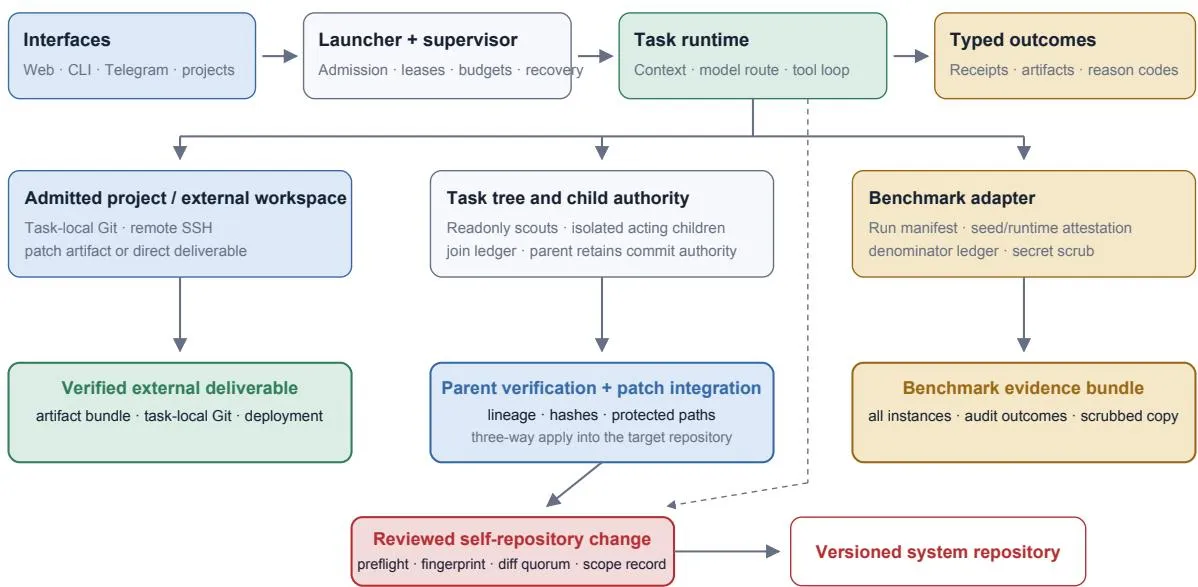
核心组件
**图 1. Ouroboros 架构**:监督运行时调度工作到 admitted workspaces
┌─────────────────────────────────────────────────────────────┐
│                    Launcher & Supervisor                     │
│         (启动、进程监督、panic-stop、外部预算控制)            │
└─────────────────────────────────────────────────────────────┘
                              │
                              ▼
┌─────────────────────────────────────────────────────────────┐
│                    Ouroboros Repository                      │
│  ┌─────────────┐  ┌──────────────┐  ┌───────────────────┐  │
│  │ Task Loop   │  │ Tools        │  │ Prompts           │  │
│  │ Memory      │  │ Review Logic │  │ Identity Profile  │  │
│  │ Benchmarks  │  │ Constitution │  │ Pattern Register  │  │
│  └─────────────┘  └──────────────┘  └───────────────────┘  │
└─────────────────────────────────────────────────────────────┘
                              │
                              ▼
┌─────────────────────────────────────────────────────────────┐
│                   External Workspaces                        │
│      (只读规划 scout / 有状态 acting subagent)               │
└─────────────────────────────────────────────────────────────┘
核心公式与机制
Commit 路径(审查门禁):
- 确定性预检(版本、数据边界、大小健康检查)
- 对 staged diff 进行指纹采集
- 多模型审查收集证据
- 再次检查指纹,任何中途修改中止 commit
任务树视图:
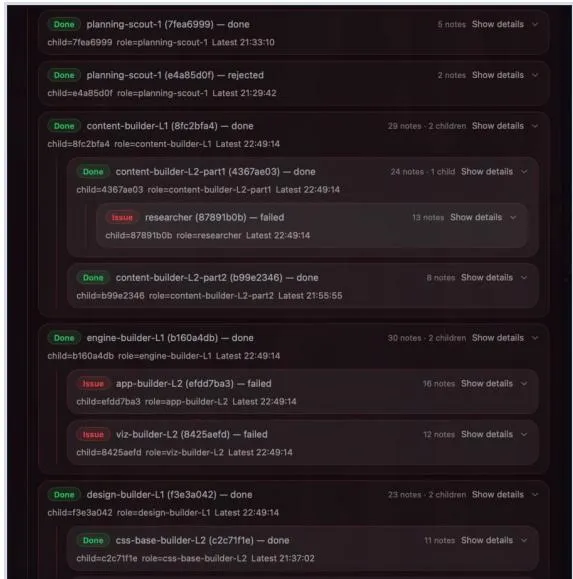
嵌套的规划和执行角色,每个节点有独立的上下文和作用域。
三层运行时模式:
- Light:阻止仓库编辑
- Advanced:允许普通编辑,保护治理表面
- Pro:允许受保护编辑(需审查)
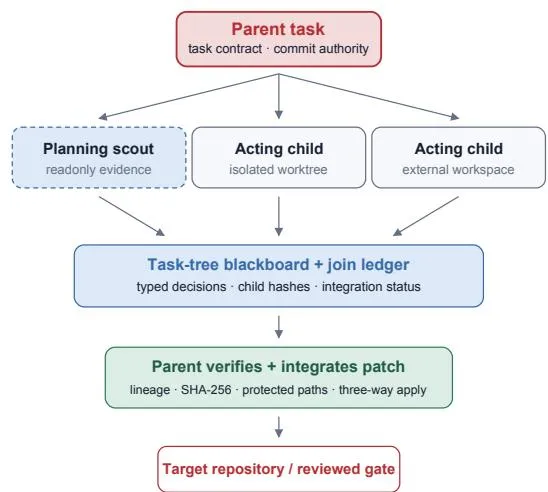
子代理在隔离 worktree 中写入,不能 commit 活系统仓库。父代理验证血统、patch 哈希、受保护路径后进行三路索引集成。
模式寄存器(Pattern Register): 反复失败变成持久行(错误类、计数、根本原因、结构修复),将修复从实例级补丁转向类级预防。
图 5. 操作控制边界:公共交互进入有序日志和有界摘要
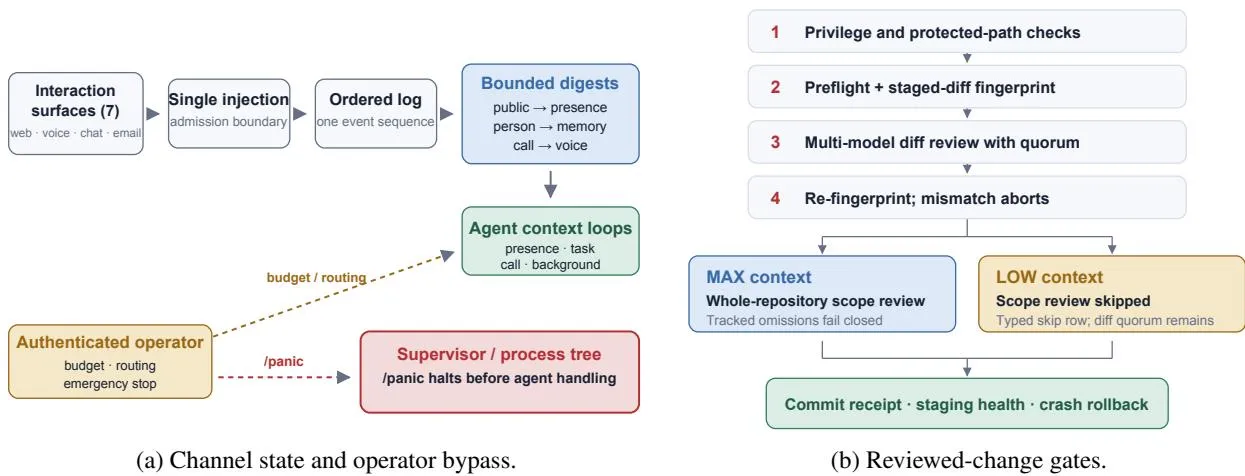
宪法(Constitution)核心原则:
- P0-P4 免疫完整性:不可删除或降级
- P2: 代理可重写代码、prompts、身份,但治理核心受保护
- P5: 自我修改必须通过多模型 diff 审查
- P9: 每个模块在复杂度预算下证明存在合理性
- P12: 每次 commit 递增版本号;恢复操作免审查
关键控制机制:
- 始终加载的宪法:每次任务循环从不截断路径重新读取,不能被删除或整体替换
- 多模型对抗审查 + 法定人数:子法定人数结果不能记录为清洁通过
- 确定性预检和 diff 指纹:审查前后指纹比对,任何中途修改中止 commit
- 隔离的操作员通道和紧急停止:
/panic在任何媒体处理之前终止所有进程 - 外部支出限制:不能通过普通代理工具提升
四、核心创新
| 创新点 | 说明 | 实验依据 |
|---|---|---|
| 递归自由演进 | 改进本身作为任务,完成后可调度下一轮演进 | Hope 161天持续演进,79.7B tokens 处理 |
| 经验驱动核心演进 | 普通工作暴露 bug → 记录错误类 → 审查修复 | 重复发送消息修复、上下文溢出修复 |
| 审查门禁系统 | Commit 路径包含预检→指纹→审查→再指纹 | 无记录 episode 抵抗操作员关闭 |
| 多模型对抗审查 | Diff-review panel,子法定人数无效 | 防止单一模型审查盲点 |
| 宪法保护 | P0-P4 核心原则不可删除/降级 | 治理文件从普通写入路径保护 |
| Hope 公开实验 | 161天跨7个渠道的持续演进实验 | $110.6K 模型花费,175,755 行代码 |
五、代码实现分析
Ouroboros 代码开源在 GitHub (MIT 许可证)。
核心架构:
- Launcher:负责启动、进程监督、release bootstrapping、panic-stop 语义
- Repository:包含任务循环、工具、prompts、记忆投影、审查逻辑、基准适配器、用户接口
- External Workspace:独立工作目录,返回 patch artifacts 或直接交付物
子代理系统:
- 默认深度 2,最大配置深度 500
- Acting 子代理在隔离 worktree 中写入,不能 commit 活系统仓库
- 父代理验证血统、patch 哈希、受保护路径后进行三路索引集成
提交工件:
- Run manifest 记录模型路由、努力级别、seed commits、选定任务、运行时 attestation
- 公共提交经过 value-level secret scrubbing(独立零剩余检查)
六、实验结果
基准测试结果
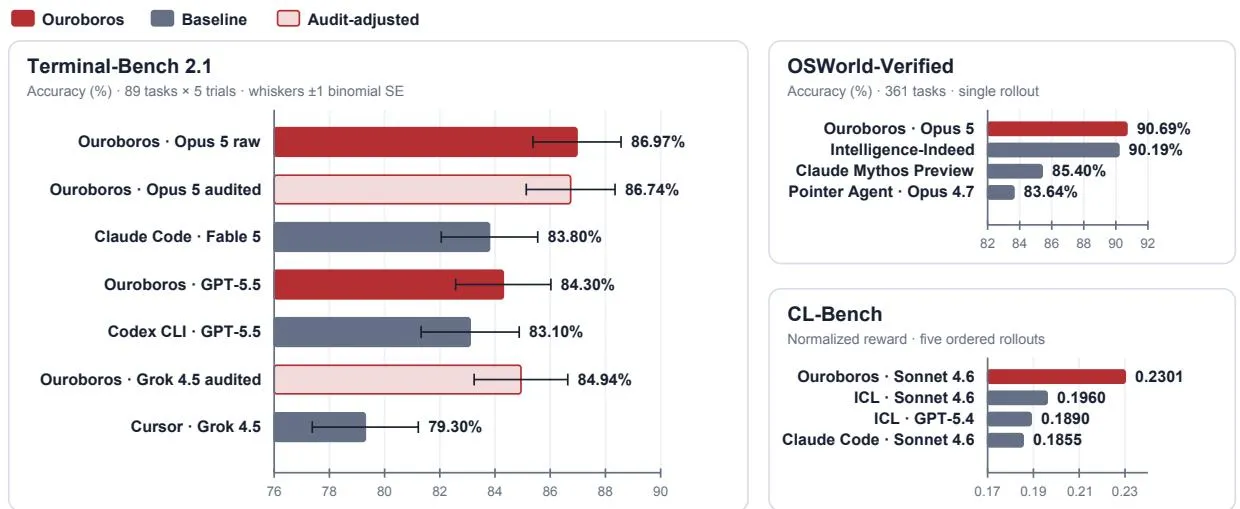
| 基准 | 模型 | Ouroboros | 最佳基线 | 提升 |
|---|---|---|---|---|
| Terminal-Bench 2.1 | Opus 5 | 86.74% (审计后) | Claude Code+Fable 5 (83.8%) | +2.94% |
| OSWorld-Verified | Opus 5 | 90.69% | Intelligence-Indeed (90.19%) | +0.50% |
| CL-Bench | Sonnet 4.6 | 0.2301 | ICL+Sonnet 4.6 (0.1960) | +0.0341 |
| SWE-bench Pro | - | 58.2% | Codex (59.4%) | 统计无差异 (p=0.40) |
| GAIA | Sonnet 5 | 78.2% | Claude Code (78.8%) | -0.6% |
Terminal-Bench 2.1 细节:
- 5 trials × 89 tasks = 445 trials
- Raw score: 387/445 (86.97%)
- 轨迹审计发现 1 个 trial 通过非预期捷径满足弱验证器
- 审计调整后:386/445 (86.74%)
- 二项标准误差约 ±1.7pp,审计后分数比最强基线高约 2 个标准误差
OSWorld-Verified 细节:
- 327.39/361 (90.69%)
- 使用截图、100-turn budget、只读可行性 pass
- 超过 Intelligence-Indeed (90.19%)、Claude Mythos Preview (85.4%)
CL-Bench 细节:
- 5-rollout campaign,normalized reward 0.2301
- 对话状态在问题间重置,原生记忆跨 rollout 持久化
- 核心演进和任务委托禁用,隔离持久记忆效果
Hope 公开部署实验
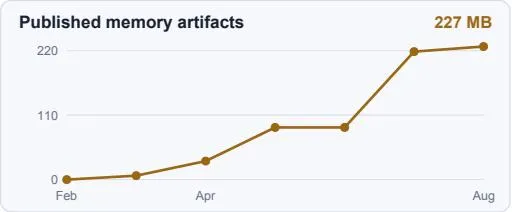
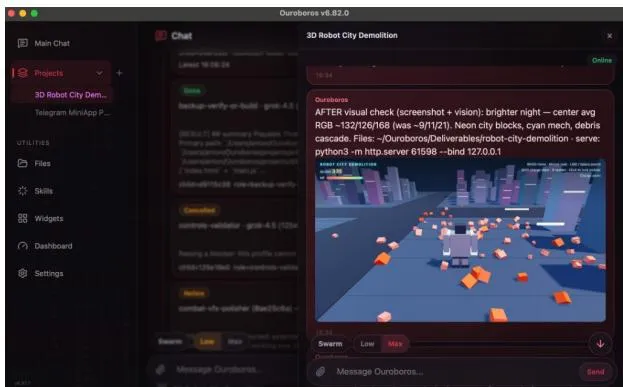
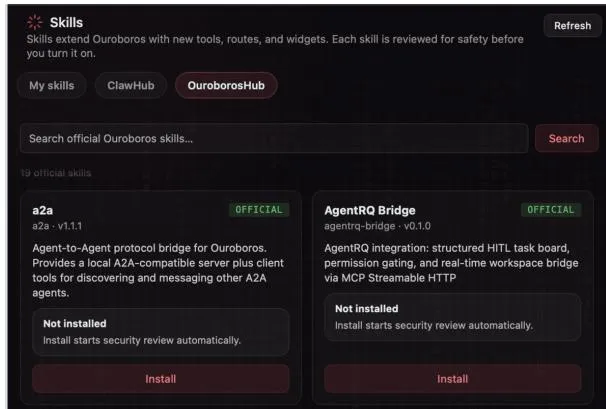
截至 2026年8月6日:
- 运行时间:161 天
- 模型花费:$110.6K
- 处理 tokens:79.7B
- 代码行数:175,755 lines
- 内存 artifacts:227 MB
- 交互渠道:7 个(web chat、voice、Telegram、Discord、Twitter/X、website comments、email)
演进案例:
- 社交反馈驱动:用户发现重复发送消息问题 → 代理追踪到重复发送路径 → 添加去重守卫
- 自我观察驱动:深度自我审查任务因上下文溢出中断 → 代理替换为有界上下文 atlas → 保留高连接度核心文件
轨迹审计发现
| 问题类型 | 发现 | 修复 |
|---|---|---|
| Reward Hacking | 1 个 trial 预 seeded web root 而非完成 Git-to-web pipeline | 与 benchmark maintainers 协作归零该 trial |
| Contamination | SWE-bench Pro task IDs 暴露 upstream fix commit | 对称过滤移除任一 arm 达到参考解的实例 |
| Isolation Failure | GAIA runs 继承 operator home directory | 新 launcher 使用隔离用户文件根 |
| Remote-State Drift | VM reset 重新分配 guest endpoint | 每次 reset 后重新发布和验证 endpoint |
| Continual-Memory Failures | CL-Bench 正记忆 carry、schema drift 失败 | 未来记忆工作需显式时序和域元数据 |
七、相关工作
自演进系统:
- Voyager:累积可执行技能
- STOP, Gödel Agent:修改脚手架或代理群体
- Live-SWE-agent:任务执行中创建工具
- Autogenesis:指定生命周期和回滚接口
- ADAS, SICA:搜索代理设计/编辑编码脚手架
编程代理:
- SWE-agent, OpenHands:代理-计算机接口本身是性能的一部分
- Codex CLI, Claude Code, Cursor, Aider:模型-harness 系统比较研究
持久记忆与部署:
- Generative Agents, Voyager:存储经验和反思塑造行为
- Constitutional AI:训练中的显式原则
- Springdrift:可审计的多渠道持久代理部署
八、总结
核心贡献
- 自演进 harness 架构:工具、上下文组装、prompts 和核心实现通过审查 commits 自我改进
- 两种演进模式:递归自由演进和经验驱动核心演进
- Hope 161天实验:最长公开记录的自演进代理部署,跨7个渠道的持续人机交互
- 操作安全架构:宪法加载、治理保护、分阶段 diff 审查、外部支出限制、操作员停止在演进压力下保持权威
- 基准 SOTA:Terminal-Bench 2.1 (86.74%)、OSWorld-Verified (90.69%)、CL-Bench (0.2301)
技术影响
- 证明自演进 harness 可以在不损失安全的情况下提升性能
- 提供操作安全的参考架构供其他自修改系统参考
- 开放的 benchmark 数据和方法促进可比研究
局限性
- 单一部署研究:Hope 遵循一个长期演进谱系而非独立演进的代理群体
- SWE-bench Pro 数据泄露:公开引用泄露和任务缺陷影响
- LLM 审查者盲点:可能与代理共享盲点
- 低上下文模式省略全仓库范围审查:可能遗漏重要变更
九、参考资源
- Ouroboros 论文: https://arxiv.org/abs/2608.08311
- 代码: https://github.com/razzant/ouroboros
- 项目页面: https://ouroboros-agent.ai/
- Terminal-Bench: https://terminal-bench.github.io/
- OSWorld: https://os-world.github.io/
- CL-Bench: https://cl-bench.github.io/
- SWE-bench Pro: https://github.com/aorwall/swe-bench-pro
- GAIA: https://gaia-benchmark.github.io/