[论文精读] OasisKV: Scaling In-Decode KV Cache
A memory-centric LLM inference system that decouples full KV-cache storage from HBM, using lookahead tokens from speculative decoding to prefetch only the most relevant KV blocks, achieving 1.69×-2.3× throughput gains within 0.7 points of full-attention accuracy.
OasisKV: Scaling In-Decode KV Cache Beyond HBM with Lookahead Sparse Prefetching
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | OasisKV: Scaling In-Decode KV Cache Beyond HBM with Lookahead Sparse Prefetching |
| 作者 | Can Xiao (Imperial College London), Sukmin Cho (KAIST), Junbong We (KAIST), Zhixiong Niu (Microsoft Research), Jianyi Cheng (University of Edinburgh), Yiren Zhao (Imperial College London), Youngjin Kwon (KAIST), Yongqiang Xiong (Microsoft Research), Rui Ma (Microsoft Research, 通讯作者), Junyi Liu (Microsoft Research, 通讯作者) |
| 机构 | Imperial College London, KAIST, Microsoft Research, University of Edinburgh |
| 论文 | arXiv:2608.08097 |
| 代码 | 未提供开源代码仓库 |
| 发布 | 2026年8月8日 |
| 许可 | arXiv预印本 |
二、核心思想
本文提出了 OasisKV,一种面向大语言模型(LLM)推理的内存中心化系统设计,旨在通过将完整的 KV 缓存从 GPU 高带宽内存(HBM)中解耦来缓解 HBM 容量压力。其核心洞察在于:解码阶段的注意力计算天然具有稀疏性,因此只需将最相关 token 的 KV 条目保留在 HBM 中进行注意力计算即可。更重要的是,作者观察到使用投机解码(Speculative Decoding, SD)中 draft 的 lookahead token 可以准确预测未来重要 token,从而可以在下一个解码步之前提前从更高容量存储层(如主机或远程内存)预取这些关键 KV 块。
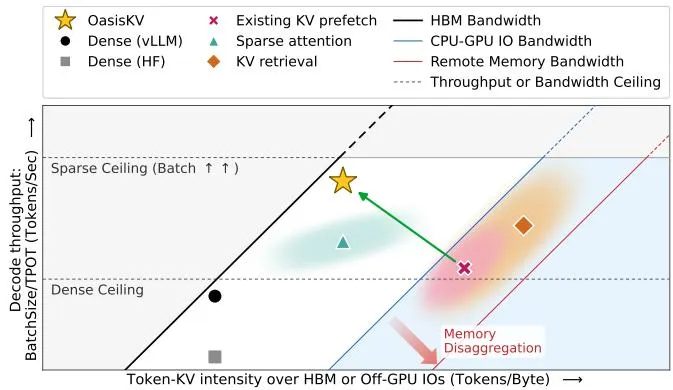
图 1. KV-cache 内存 roofline:展示三种稀疏方法的带宽天花板(dense/sparse ceiling vs. 三层 off-GPU IO roof)
问题定义
现代 LLM 推理服务正从短对话向长上下文、长输出的 agentic 工作负载转变(web-use、computer-use、coding agents)。这种转变导致以下核心矛盾:
- HBM 容量瓶颈:KV 缓存是线性增长的(公式(1)),在 32K context 下单个请求需约 8.6 GB KV 缓存,即使预留 80 GB HBM 给 KV 缓存,最大 batch size 仅为 9 个请求。
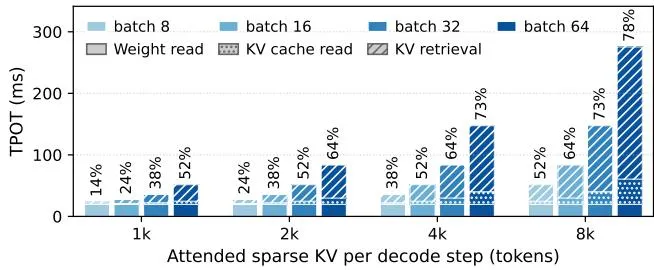
- KV 检索延迟:对 CPU DRAM 上的 KV 进行按需检索会显著增加 TPOT(per-output-token latency),如图 2 所示,仅 10% 的 KV 从 CPU 检索就引入 38%-78% 的额外延迟。
- ** disaggregated 服务限制**:Prefill-decode 分离架构下,完整 KV 缓存传输到 decode 节点会消耗大量主机内存,限制了 batch size。
图 2. TPOT 延迟分解:PCIe 上按需 KV 检索的开销(Qwen3-32B, 单 H100, 32K context, BF16)
解决方案概述
OasisKV 的解决方案包含三个核心组件:
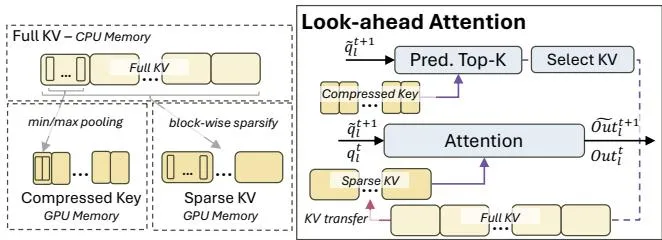
算法层:利用投机解码中 draft token 作为 lookahead 信号,通过 look-ahead attention 在后台异步预测下一步所需的 top-K KV 块。草稿 token 通过正常的稀疏 KV working set 传播,其查询向量用于扫描压缩的 key summary(Quest-style min/max pooling),从而预测下一步最重要的 KV 块。
硬件层:采用 capped eviction policy 限制每步 PCIe 传输量,确保数据传输不超过解码时间预算 。
系统层:设计了头级(head-wise)逻辑映射,支持在 PagedAttention 之上实现稀疏 KV working set,以及远程部分获取(Remote Partial Fetching, RPF)以支持 prefill-decode 分离部署。
三、技术架构
整体框架图
                    +-------------------------------+
                    |       Request Scheduler       |
                    |  (Dense/Sparse request mix)  |
                    +-------------------------------+
                                  |
              +-------------------+-------------------+
              |                   |                   |
    +---------v----------+ +------v------+  +---------v---------+
    |   Foreground       | | Background   |  |   Pool Manager    |
    |   Forward Pass     | | Pipeline     |  |  (Block Tables)   |
    |                    | |              |  +------------------+
    |  - QKV Projection  | | Top-K Pred   |
    |  - Sparse Attn     | | (Layer-wise) |
    |  - FFN             | +------+-------+
    +--------------------+        |
           |                      |
           |          +-----------v-----------+
           |          |   KV Transfer Worker  |
           |          |   (CPU→GPU over PCIe) |
           |          +-----------+-----------+
           |                      |
           v                      v
    +------+------+    +----------v-----------+
    |  GPU HBM    |    |  CPU Host Memory     |
    |  (Sparse    |    |  (Full KV Cache)     |
    |   Working   |    +----------------------+
    |   Set)      |              |
    +-------------+              |
           |              +------v-----------+
           |              |  Compressed Keys  |
           |              |  (Per-block min/  |
           |              |   max summaries)  |
           |              +------------------+
           |
    +------v-------+
    | Draft Query  |
    | → KV Select  |
    | → KV Transfer|
    +--------------+
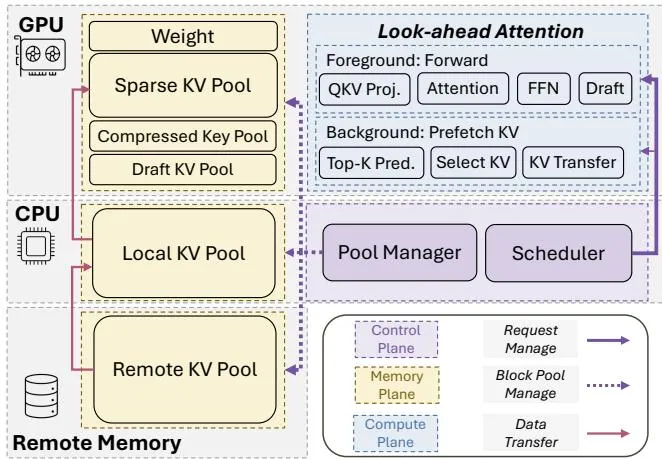
图 5. OasisKV 系统架构总览:Foreground forward pass + Background async pipeline + Pool manager
三大核心组件:
- Look-ahead Attention: 前景 forward pass + 异步背景管道(Top-K 预测 → KV 选择 → KV 传输)
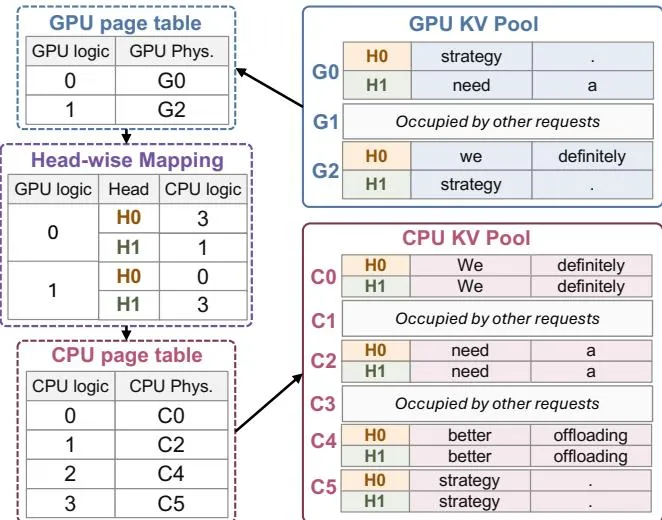
- KV Cache Management: 头级逻辑映射(Head-wise Mapping)在 PagedAttention 之上构建稀疏 working set
- Remote Partial Fetching (RPF): 在 prefill-decode 分离场景下,通过 lookahead 信号过滤网络传输和主机内存需求
核心公式
公式 (1): KV 缓存容量计算
其中 为 batch size, 为 context length, 为模型层数, 为 KV 头数, 为 head 维度, 为每个 KV 元素的字节数(BF16 时为 2)。因子 2 代表 key 和 value 各一份。
公式 (2): HBM 限制的最大 batch size
公式 (3): 每步可隐藏的数据传输预算
其中 为 inter-tier 有效带宽(如 PCIe Gen5 ≈ 64 GB/s), 为单步解码计算时间。超过此预算的传输无法被完全重叠,会阻塞解码。
公式 (4): 异步流水线稳态完成时间
其中 是相邻 layer 间预取任务的最小间隔。流水线由最慢阶段决定。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| Look-ahead Attention | 利用 draft token 预测下一步 top-K KV 块 | EAGLE-3 draft head, top-K=128 blocks/head |
| Compressed Key Cache | 每个 logical block 存储 per-dimension min/max summary | 占用 full KV cache 的 1/16 |
| Capped Eviction Policy | 限制每步每 head 新引入的 block 数量 | Fetch ratio = 0.05(默认) |
| Head-wise Mapping | 在 PagedAttention 之上增加逻辑到逻辑的映射层 | 支持不同 KV head 的不同稀疏集合 |
| Asynchronous Pipeline | 三层后台 worker(预测→选择→传输)各在独立 CUDA stream | 跨 layer 并行,同 layer 串行 |
| Remote Partial Fetching (RPF) | 在 PD disaggregation 下仅传输首步所需的 KV union | 使用 NIXL over UCX |
训练流程
OasisKV 是一个推理时系统,无需额外训练:
- Prefill 阶段:正常 dense 预填充,生成 prompt 的隐藏状态和完整 KV 缓存
- Sparsification 转换:当 context 超过阈值时,将完整 KV 缓存复制到 CPU 内存,GPU 只保留选中的历史 blocks 和 local window
- Decode 阶段:
- 前台:正常 attention forward pass,计算 normal query 和 draft query
- 后台 Layer :draft query 扫描 compressed key summary → 预测 top-K blocks → 与 resident set 比较 → 构建 transfer plan → PCIe 异步传输
- RRR 阶段(PD disaggregation):prefill 节点只传输首步所需的 KV union(非完整 cache)到 decode 节点
四、核心创新
图 4. Top-20 KV 块预测精度:previous token proxy vs. lookahead token(draft token),后者优先层间精度更稳定(avg 96.0% vs 83.9%)
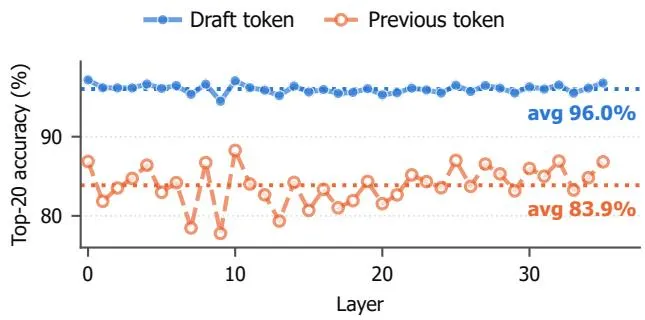
图 6. 逐层 agreement:propagated draft query 预测的 top-K 集 vs. true next-token query 的实际 top-K 集
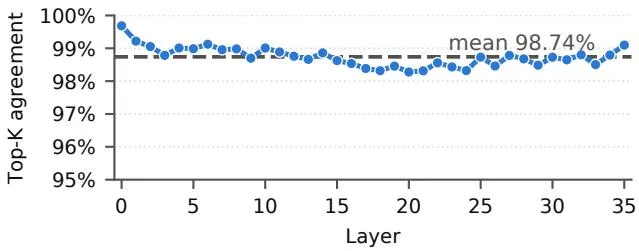
图 7. Look-ahead attention 机制:压缩 key cache(min/max summaries)+ 稀疏 working set 选择
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| Look-ahead Attention | 首次利用 SD 的 draft token 作为 lookahead 预测信号,精度达 98.74%(平均每层) | Figure 6 显示 propagated draft query 与 true next-token query 的 top-K 集合同意率 >98.2% |
| Async Prefetch Pipeline | 三层异步流水线(预测→选择→传输)隐藏在 foreground 之后,每 layer 独立调度 | 公式(4)证明稳态完成时间受最慢阶段限制,不超过 |
| Capped Eviction Policy | 限制每步每 head 最多引入 C 个新 block,防止 PCIe 带宽超限 | Table 2 显示 fetch ratio 0.05 时通过率达 2,083 tok/s,fetch-all 仅 824 tok/s |
| Head-wise Mapping | 在 PagedAttention 之上增加逻辑到逻辑的映射,支持不同 KV head 维护不同稀疏 block 集合 | 保持原 page table 不变,仅修改 head-wise mapping entries |
| Remote Partial Fetching (RPF) | PD disaggregation 下仅传输首步需要的 KV union(非完整 cache),大幅降低 admission 流量 | Admission 减少 6.5-9.7×,host memory 减少 2.2-2.6× |
五、代码实现分析
未找到公开的代码仓库。该论文在 vLLM v0.12.0 的基础上进行了扩展实现,使用 C++ 和 CUDA 编写了 sparse-attention backend、GPU model runner、KV-cache manager 和 scheduler。实现了 compressed-key 更新、head-wise top-K prediction、sparse page mapping 和 KV transfer。持久化的 C++ workers 在独立后台 CUDA streams 上执行 Top-K 预测、KV 选择和 KV 传输。Model execution 使用 foreground stream,CUDA events 强制执行每层四个 stream 之间的依赖关系。
对于 PD disaggregation,使用 NIXL 1.3.0 over UCX 1.21.0 进行节点间 KV 缓存传输。
六、实验结果
基准测试
硬件配置与测试模型:
- 测试平台:8× NVIDIA H100 (80GB HBM3), 2× Intel Xeon Platinum 8480C (112 cores), 2TB host memory
- GPU 互联:NVLink + NVSwitch;PCIe Gen5 ×16
- PD disaggregation:两个相同节点,400 Gbps Ethernet + RoCE
- 测试模型:Qwen3-8B(dense)、Qwen3-235B-A22B(MoE)、Llama-3.1-8B-Instruct
- Draft 模型:EAGLE-3 (Tengyunw/qwen3_8b_eagle3 等)
- 默认参数:block size B=16, K=128 blocks (2,048 tokens) per KV head
- Baselines:Dense vLLM (FlashAttention-3)、ShadowKV、InfiniGen、FreeKV、Quest
单 GPU 性能(Qwen3-8B, 单 H100):
| 配置 | 吞吐量 (tok/s) | vs Dense vLLM | TPOT (ms) |
|---|---|---|---|
| 16K context, batch=16 | 836 | 1.29× | 17.7 vs 23.5 |
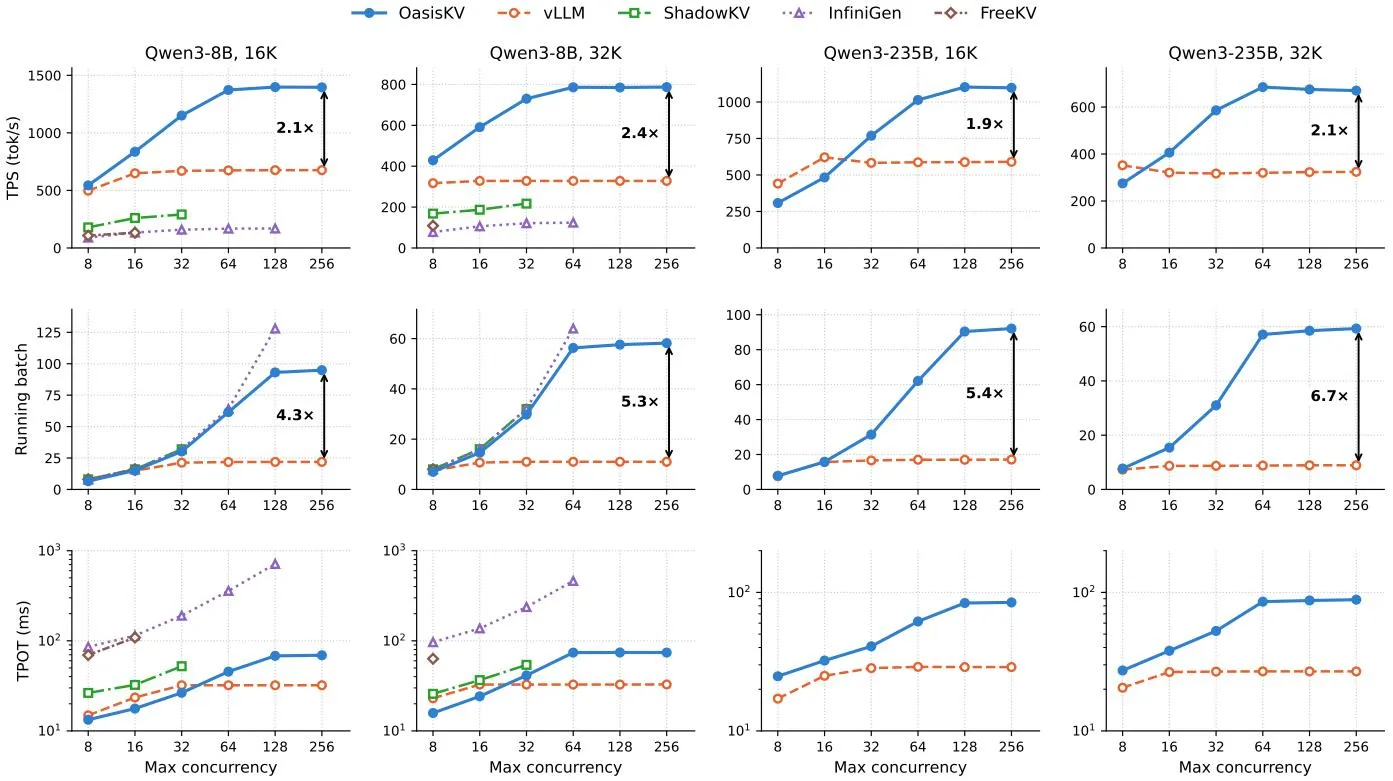
| 16K context, batch=128 | 1,398 | 2.1× | - |
| 32K context | 缩放至更高 concurrency | 2.1× | - |
| AIME24 推理 (Qwen3-8B) | 2,083 | 1.69× | -0.1 点精度损失 |
MoE 模型性能(Qwen3-235B, TP=8):
图 11. 合成 decode sweep:单 GPU (Qwen3-8B) 和多 GPU (Qwen3-235B) 在不同 context 长度下的吞吐量
| 配置 | 吞吐量 (tok/s) | vs Dense vLLM |
|---|---|---|
| 16K context, batch=32 | 1,102 | 1.9× |
| 32K context, batch=16 | 1,546 | 1.20× (83.85 vs 84.69 accuracy) |
PD Disaggregation 性能(Qwen3-8B):
图 12. PD disaggregation 性能:吞吐量 vs 请求到达率,不同 context 长度(24K/32K)下 host 内存使用对比
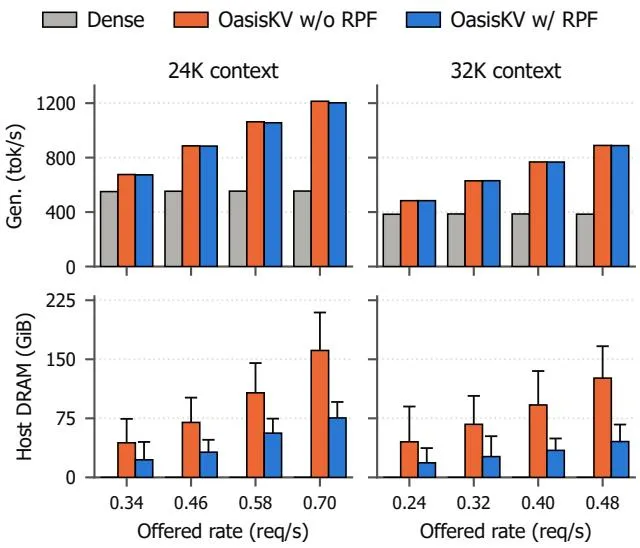
图 14. disaggregation 下网络传输:full transfer vs RPF(32K context, 2,048 output tokens)
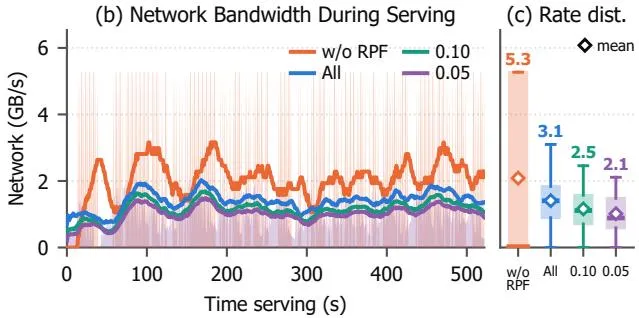
| 配置 | 吞吐量 (tok/s) | vs Dense vLLM | Decode-host 内存减少 |
|---|---|---|---|
| 24K context | 1,204 | 2.1× | 2.2× |
| 32K context | 1,210 / 888 | 2.1-2.3× | 2.2-2.6× |
图 13. 端到端 decode 吞吐量(柱状,左轴)与 AIME24 精度(avg@32,右轴),从 dense 到不同 K 值的稀疏配置
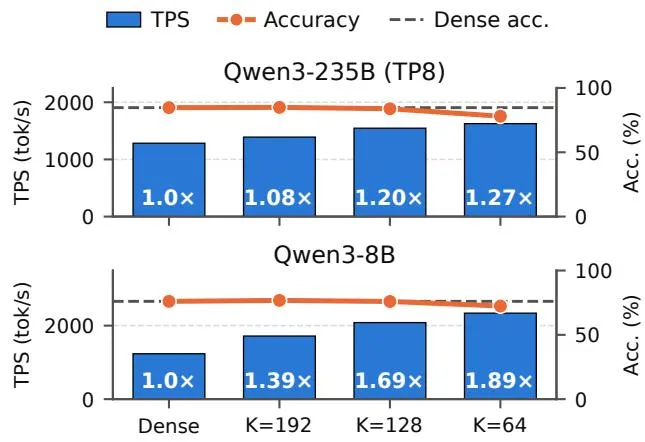
Accuracy 对比(2,048-token KV budget):
| 数据集 | Full (vLLM) | OasisKV | Δ | Quest Δ | FreeKV Δ |
|---|---|---|---|---|---|
| LongBench v2 (Qwen3-8B) | 33.60 | 33.20 | -0.40 | -0.60 | -1.20 |
| LongBench v2 (Llama-3.1-8B) | 30.23 | 29.62 | -0.61 | -0.20 | -0.59 |
| AIME24 pass@8 | 83.33 | 83.33 | 0.00 | 0.00 | -6.67 |
| AIME25 pass@8 | 80.00 | 80.00 | 0.00 | -6.66 | -3.33 |
| GPQA-Diamond pass@4 | 73.20 | 71.21 | -1.99 | -1.01 | -0.50 |
消融实验
Fetch Cap Ablation(Table 2):
| Fetch Ratio | Fetch (GB/step) | BW (GB/s) | TPS (tok/s) | AIME24 avg@32 | pass@32 |
|---|---|---|---|---|---|
| 0.01 | 0.30 | 5.0 | 2,178 | 74.90 | 90.00 |
| 0.02 | 0.60 | 9.8 | 2,066 | 75.10 | 90.00 |
| 0.05 | 1.49 | 23.8 | 2,083 | 75.94 | 86.67 |
| 0.10 | 2.87 | 31.4 | 1,421 | 76.77 | 86.67 |
| 0.20 | 4.34 | 34.0 | 1,035 | 77.40 | 93.33 |
| Fetch All | 5.05 | 33.5 | 824 | 76.46 | 86.67 |
关键发现:吞吐量受 PCIe 带宽约束而非计算。fetch-all 反而最差(824 tok/s),因为传输阻塞了解码。最佳点是 0.05 ratio(2,083 tok/s,精度损失 < 0.1 点)。
Top-K Sensitivity:
- K=192:精度超越 full attention(76.77 vs 76.04),速度比 1.39×
- K=128(默认):精度 75.94,速度比 1.69×
- K=64:精度下降 4.4 点(72.40),但速度比达 1.89×
RPF 效果(Figure 14):
图 10. 远程部分获取:admission 时的部分传输(top)+ decode 时的网络预取(bottom),数字表示步骤号
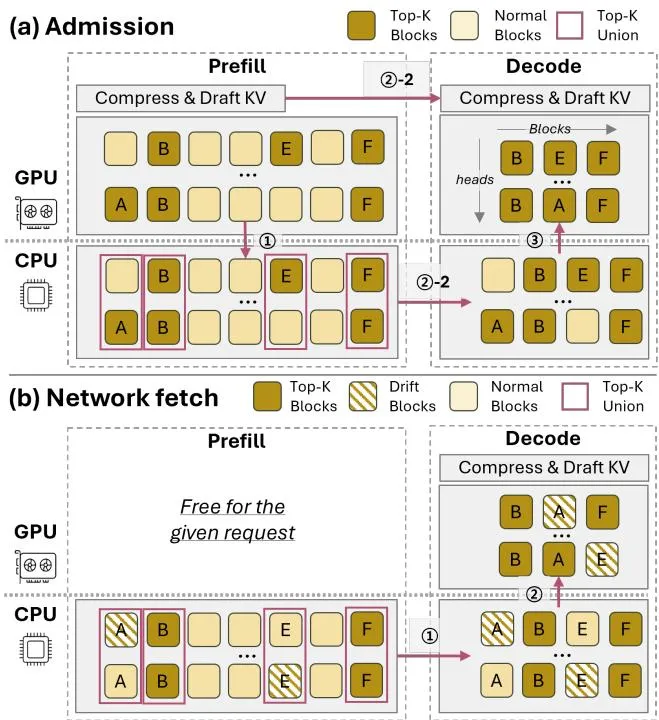
- Admission 阶段传输减少 6.5-9.7×
- Decode 阶段 drift 可控(fetch ratio 0.05 下仅 1.61 GiB)
- 总传输减少 2.2× vs full transfer
TTFT 提升(Figure 15):
图 15. TTFT 加速比分析:prefix-cache hit rate 与链路速率(100 Gbps vs 400 Gbps)的影响
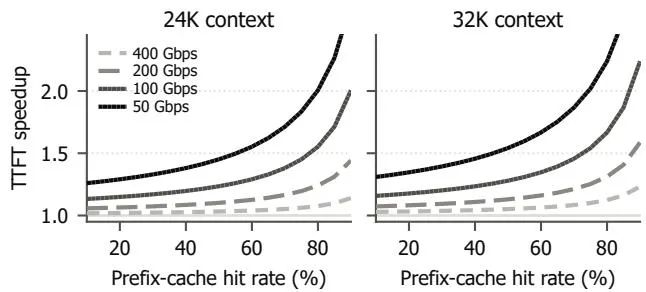
- 90% prefix-cache hit rate 下,TTFT 减少 2.0-2.2×(100 Gbps link)
- 即使 400 Gbps link 也有 1.14-1.23× 提升
与现有方法对比
图 8. 异步预取流水线:跨两个解码步的 layer 级 chain(红色箭头追踪单 layer 流程:draft query → KV selection → KV transfer)
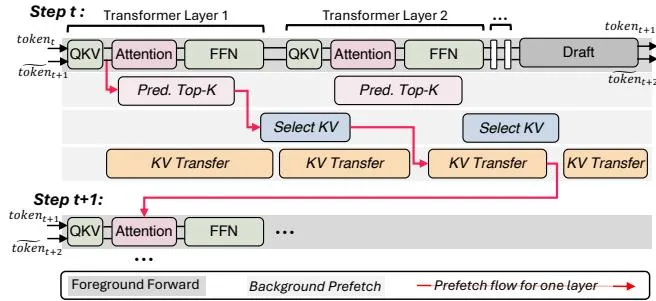
图 9. Head-wise mapping:GPU 稀疏 working set 与 CPU 完整 KV cache 的逻辑到逻辑映射
vs ShadowKV/InfiniGen/FreeKV:OasisKV 在全部测试场景中超越这三者。原因是它们的系统设计不支持大 batch 场景和 cross-GPU 实验。
vs Quest(Sparse Attention):Quest 在 LongBench v2 上精度损失更大(-0.60 to -2.32 vs OasisKV 的 -0.40 to +1.40)。
vs FreeKV(KV Retrieval):FreeKV 需要 corrective on-demand fetch 处理 miss,而 OasisKV 的 lookahead 精度更高(98.74% vs previous-token proxy 的 83.9%)。
七、相关工作
KV Retrieval:ArkVale、RetroInfer、HiSparse、SPIN 将非驻留 KV 放在 CPU 内存;ShadowKV 在 GPU 上保留 low-rank keys 并 offload values;KVDrive 扩展到 SSD。这些方法都将选择+传输放在解码关键路径上。
KV Prefetch:FlashMemory-DeepSeek-V4 和 SparDA 训练专用 predictor;ECHO 复用 native sparse-attention 模型的 indexer;SpeCache 使用低精度 KV 副本;InfiniGen 使用 partial next-layer rehearsal;FreeKV 使用 previous-step query similarity。OasisKV 的独特之处在于直接利用 SD draft tokens,无需额外训练 predictor。
Disaggregated Serving:Splitwise、DistServe 等工作将 prefill 和 decode 分离,但通常要求完整 KV 缓存传输。OasisKV 的 RPF 仅传输必要的 KV union。
八、总结
核心贡献
- 设计了基于 lookahead 的 KV 缓存预取框架,通过 off-GPU 内存扩展有效 in-decode 内存容量,以极小精度损失换取吞吐量和每请求解码速度的显著提升。
- 在 vLLM 上实现了 OasisKV 原型,支持多 GPU 部署和 PD 分离,使用投机解码的 draft tokens 进行 lookahead 稀疏 KV 缓存预取。
- 在 dense/MoE 模型、多样 benchmark、单 GPU/多 GPU/PD disaggregation 设置下全面评估,相比 vLLM 基线实现 1.69×-2.3× 吞吐提升,精度保持在 full attention 的 0.7 点以内。
技术影响
OasisKV 为 LLM 推理中的内存瓶颈问题提供了新的解决思路——不追求更 aggressive 的稀疏化,而是利用已有的 SD draft tokens 实现高精度的 lookahead,从而在保持精度的同时充分利用 off-GPU 存储层级。这对于 agentic 工作负载的规模化部署具有重要意义。
局限性
- Draft token 被强制拒绝:当前实现中 draft token 仅用于 lookahead 预测,不被接受为输出。联合 speculative decoding 可进一步摊销 overhead。
- Fetch cap 的固定比例:0.05 的默认 fetch ratio 在所有场景下使用,可能不是最优自适应策略。
- 未支持 prefix caching:RPF 的原型未实现 prefix caching,实际收益可能更大。
- 仅验证了有限模型:主要在 Qwen3 系列和 Llama-3.1 上验证,对其他架构(如 MLA)的泛化需进一步研究。
- 无开源代码:实现基于 vLLM 修改,但未公开。
九、参考资源
- 论文链接: https://arxiv.org/abs/2608.08097
- arXiv HTML: https://arxiv.org/html/2608.08097v1
- PDF: https://arxiv.org/pdf/2608.08097
- figures 目录:
/Users/ewalker/Downloads/mydev/vibe-coding/ai-paper-skill/docs/figures/oasis-kv/ - MinerU 原始输出:
docs/mineru_output/oasis-kv/