TensorCast: The Missing Tensor Management Layer in Large Language Model Infrastructure
首个将张量生命周期管理从计算栈中解耦的分布式服务层,通过 Artifact/Operation/Plan/Signal 四抽象实现 TaaS 范式,集成 vLLM/SGLang 后权重物化加速 60×、KV 缓存共享 TTFT 降低 87.5%
TensorCast: The Missing Tensor Management Layer in Large Language Model Infrastructure
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | TensorCast: The Missing Tensor Management Layer in Large Language Model Infrastructure |
| 作者 | Yuhan Zhou*, Yuchu Luo*, Hao Nie, Wangrunze Lv*, Yu Zhou, Yibo Zhu, Daxin Jiang, Chenren Xu |
| 机构 | 北京大学 (Peking University), Stepfun(阶跃星辰), 北京邮电大学 |
| 论文 | arXiv:2608.06007 |
| 代码 | github.com/tensorcast-ai/tensorcast |
| 发布 | 2026-08-06 (cs.DC) |
| 许可 | arXiv.org perpetual non-exclusive license |
| 实现规模 | 约 16 万行 C++ 运行时 + 9.5 万行 Python SDK |
二、核心思想
问题定义
现代 LLM 基础设施中,张量已不仅仅是计算中间结果,更成为跨分布式组件持久共享的状态:
- 模型权重:在弹性扩缩容实例间分发(常超过 100 GB)
- KV 缓存:跨请求、跨节点复用(随着上下文长度增长变得庞大且碎片化)
- Checkpoint:在训练和推理流水线间同步(需重分片适配不同并行配置)
然而,现有系统(Mooncake、InstantTensor、LMCache 等)将张量生命周期管理深度嵌入各任务专用栈,形成孤立竖井:
- 重复实现:每个工作负载都重新实现类似的生命周期原语(识别、放置、移动、变换、物化)
- 不可组合:跨组件优化(如同时平衡实例负载与 KV 缓存亲和性)难以表达
- 策略硬编码:各系统的优化策略硬编码在内部,无法复用和组合
解决方案:Tensor-as-a-Service (TaaS)
TensorCast 提出 TaaS 范式,将张量生命周期管理从计算逻辑中解耦,提供三个核心设计原则:
- 张量原生抽象:将张量表示为具有显式身份、所有权和生命周期语义的一等系统对象
- 可编程生命周期:暴露可组合的生命周期原语,允许开发者定义工作负载特定策略
- 策略-机制分离:开发者使用 TensorCast API 编写管理程序,运行时透明地在分布式集群上执行
关键数据
| 指标 | 数值 |
|---|---|
| 实现规模 | 160K C++ 行 + 95K Python 行 |
| 集成引擎 | vLLM、SGLang |
| 测试模型 | Qwen3-14B、Qwen3-32B、Qwen3-30B-A3B、Qwen3-235B-A22B |
| 权重物化加速 | 60.7×(冷启动)、228.6×(热启动) |
| 权重同步加速 | 2.63×(Qwen3-32B, TP=8) |
| KV 缓存 TTFT 降低 | 87.5%(RDMA 场景) |
| 可编程路由 TTFT 降低 | 93.2%(256 sessions, medium 负载) |
三、技术架构
3.1 系统整体架构
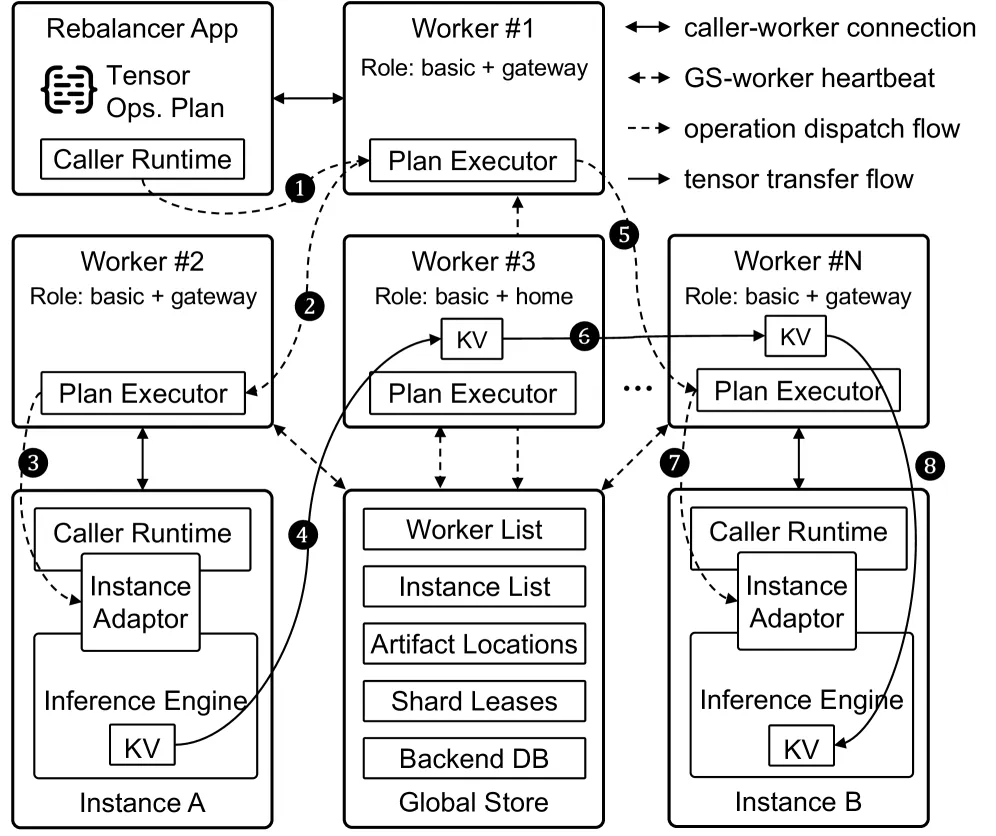
TensorCast 采用 caller-worker 编程模型:
┌─────────────────────────────────────────────────────────────────────┐
│                        TensorCast Cluster                           │
│                                                                     │
│  ┌──────────────┐    ┌──────────────┐    ┌──────────────┐         │
│  │  Basic Worker │    │ Gateway Worker│    │ Shard Home   │         │
│  │              │    │              │    │ Worker       │         │
│  │ - Memory     │    │ - Caller     │    │ - Shard      │         │
│  │ - Disk       │    │   Connection │    │   Ownership  │         │
│  │ - Plan Exec  │    │ - Dependency │    │ - Consistency│         │
│  └──────────────┘    │ Resolution   │    └──────────────┘         │
│                      └──────────────┘                              │
│                                                                     │
│  ┌──────────────┐    ┌──────────────┐                             │
│  │ Instance     │    │ Global Store │                             │
│  │ Caller       │    │ (DuckDB)     │                             │
│  │ (SGLang/     │    │ - Metadata   │                             │
│  │  vLLM)       │    │ - Worker     │                             │
│  └──────────────┘    │   Status     │                             │
│                       └──────────────┘                             │
└─────────────────────────────────────────────────────────────────────┘
         ↑                    ↑                    ↑
    Application Caller   Instance Caller    (Internal)
    (Router, Auto-       (SGLang/vLLM
     scaler, Orchestr.)  integration)
3.2 Caller 类型
| Caller 类型 | 职责 | 典型应用 |
|---|---|---|
| Application Caller | 实现工作负载级张量管理策略 | 请求路由器、自动扩缩管理器、多实例推理编排器 |
| Instance Caller | 提供 TensorCast 与执行引擎的机制边界 | SGLang/vLLM 集成,暴露引擎 resident 张量状态 |
3.3 Worker 角色
| 角色 | 职责 |
|---|---|
| Basic Worker | 维护张量状态,执行本地计划步骤 |
| Gateway Worker | 接收调用者连接,解析计划依赖,分发操作 |
| Shard Home Worker | 维护高基数张量分片的所有权和一致性 |
3.4 核心 API 抽象
TensorCast 提供四大编程抽象(Figure 3):
Artifact — 张量身份与所有权
# 注册调用者持有的张量
artifact = register(tensor, art_id) -> Artifact

# 注册系统持有的张量
artifact = put(tensor, art_id) -> Artifact

# 获取已有张量的句柄
artifact = artifact(art_id) -> Artifact

# 获取张量元数据
meta = artifact.tensor_meta() -> TensorMeta

# 物化张量(阻塞)
tensor_dict = artifact.tensor_dict() -> Tensor

# 从现有张量派生视图
new_artifact = artifact.view(slice, name) -> Artifact所有权模式:
- System-Owned:TensorCast 管理整个生命周期,适用于持久全局张量(如模型权重)
- Caller-Leased:调用者保留所有权,TensorCast 获得临时管理权,适用于瞬态但可共享的张量(如迁移中的 KV 缓存)
Operation — 生命周期操作
# 预取张量(异步准备)
worker.prefetch(artifact, device)

# 发布版本化张量
worker.publish(artifact, version)

# 获取最新版本的张量
artifact = worker.latest(art_id) -> Artifact

# 复制张量
worker.replicate(src_artifact, dst_worker)

# 迁移张量
worker.migrate(src_worker, dst_worker, artifact)

# 销毁张量
worker.destroy(artifact)
Plan — 分布式工作流编排
# 创建调用上下文
ctx = context(id, ddl, key) -> CallContext

# 创建可执行计划
plan = plan(ctx) -> Plan

# 在 TensorCast Worker 上构建计划步骤
builder = plan.on_worker(worker) -> PlanStepBuilder

# 在 Instance 上构建计划步骤
builder = plan.on_instance(inst) -> PlanStepBuilder

# 执行计划(阻塞)
result = plan.run(concurrency) -> PlanResult
Signal — 运行时反馈
Signal 暴露运行时信息,供调用者进行策略决策(如负载均衡、故障恢复)。
3.5 张量生命周期原语
| 工作负载/任务 | 张量状态 | 生命周期挑战 | 公共生命周期原语 |
|---|---|---|---|
| MaaS 服务 | 模型权重 | 分发不可变权重到新实例 | identify, place, transform, materialize |
| KV 缓存管理 | KV 缓存块 | 跨请求/实例共享可复用上下文 | identify, place, materialize |
| RL 后训练 | 模型权重 | 从训练器同步更新权重到 Rollout Worker | identify, transform, materialize |
| Agentic 推理 | 推理状态 | 跨实例分支、卸载和恢复状态 | identify, materialize, coordinate |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| TaaS 抽象层 | 首个将张量生命周期从计算栈中解耦的服务层 | 理论:统一 Artifact/Operation/Plan/Signal 四抽象;实验:与 Mooncake/InstantTensor 性能相当 |
| 可编程生命周期 | 开发者可组合生命周期原语实现自定义策略 | Algorithm 1:基于 EWMA 的负载均衡 + KV 亲和性路由策略 |
| 策略-机制分离 | 管理策略(Application Caller)与执行机制(Worker/Instance)完全解耦 | 架构:Worker 分 Basic/Gateway/Shard Home 三种角色 |
| 高基数张量管理 | 通过 Shard Home 角色支持 KV 缓存等百万级 Artifact | 实验:Qwen3-32B TTFT 降低 60-87.5%(RDMA) |
五、实验结果
5.1 模型权重物化(Table 5/6)
实验设置:单节点 64 CPU + 500GB DRAM + 8×H800 GPU,vLLM 集成,TP=8
| 模型 | 存储类型 | 基线 | TensorCast Cold | TensorCast Warm |
|---|---|---|---|---|
| Qwen3-30B-A3B | JFS | Default: 60s | 1.0s (60.7×) | <1s (228.6×) |
| Qwen3-30B-A3B | JFS | InstantTensor: 6.0s | 1.0s (10.2×) | <1s (40.7×) |
| Qwen3-235B-A22B | JFS | Default: 600s | ~3s | <1s |
| Qwen3-235B-A22B | Local SSD | Default: 120s | ~10s | <1s |
关键洞察:
- TensorCast Cold:并发读取每个 rank 的权重切片,并行分发到各 GPU,同时 H2D 拷贝流水线化
- TensorCast Warm:预物化权重到本地 GPU 内存,vLLM 通过 CUDA IPC 零拷贝访问,启动时间仅受运行时初始化开销支配
5.2 模型权重同步(Table 7)
实验设置:两节点集群,每节点 64 CPU + 500GB DRAM + 4×H800 GPU,SGLang 集成,禁用 RDMA
| 模型 | TP 大小 | TensorCast 加速比 |
|---|---|---|
| Qwen3-14B | 2 | 1.14× |
| Qwen3-14B | 4 | 1.32× |
| Qwen3-32B | 2 | 1.85× |
| Qwen3-32B | 4 | 2.12× |
| Qwen3-32B | 8 | 2.63× |
关键洞察:
- 小模型(14B)中,TP 增加引入额外的张量切片开销,成为主要瓶颈
- 大模型(32B)中,并发传输多个张量视图更好地利用网络带宽,TP 越大加速越显著
5.3 高基数张量管理(KV 缓存,Table 8/9)
实验设置:4 节点集群,每节点 64 CPU + 1TB DRAM + 8×H800 GPU + 200Gbps RDMA,SGLang HiCache 集成
Qwen3-32B (TP=2) 相对于首次请求的 TTFT 降低率(Figure 8):
| 场景 | 节点数 | RDMA | TensorCast vs Mooncake |
|---|---|---|---|
| 16K prompt | 4 | ✓ | 60%~75%(相当) |
| 16K prompt | 4 | ✗ | TensorCast 显著优于 Mooncake |
| 35K prompt | 4 | ✓ | 70%~87.5%(相当) |
| 35K prompt | 4 | ✗ | TensorCast 显著优于 Mooncake |
Qwen3-235B-A22B (TP=8)(Figure 9):
- TP=8 引入 4× 并发 KV 页面检索请求,竞争增加,TTFT 改善降低
- 无 RDMA 场景下,TensorCast 的 userspace mTCP + 多路径传输显著优于 Mooncake
5.4 可编程请求路由(Table 10/11)
实验设置:4 节点集群,每节点 2×H20 GPU,Qwen3-32B,SGLang 集成
工作负载:SWE-Gym 真实 agent 轨迹,LogNormal 间隔采样(Table 3):
| 预设 | μ | σ | 中位 TTFT | 平均 TTFT | P5 | P95 | 场景 |
|---|---|---|---|---|---|---|---|
| fast | 2.1 | 0.6 | 8.2s | 9.8s | 3.0s | 22.0s | 快速编码 agent 循环 |
| medium | 3.0 | 0.8 | 20.1s | 27.7s | 5.4s | 75.0s | 典型 SWE agent |
| slow | 4.1 | 1.0 | 60.3s | 99.5s | 11.6s | 311s | 长工具工作流 |
TTFT 降低率(Figure 10),相比 load-aware + Mooncake 基线:
| 负载 | fast | medium | slow |
|---|---|---|---|
| 128 sessions | 71.4% | — | — |
| 256 sessions | — | 93.2% | 70.4% |
缓存命中率(Figure 11):
- 随着并发 session 增加,所有方法的缓存命中率下降
- TensorCast 路由保持更稳定的缓存命中率,因为迁移决策同时考虑负载和 KV 亲和性
Algorithm 1: Router Request Rebalancing Policy
# Algorithm 1: 路由器请求再平衡策略
For Each Rebalance Tick:
    foreach instance i do
        L_i ← α · Load(i) + (1 - α) · L_i    # EWMA 负载估计
    src ← argmax_i L_i                          # 最负载实例
    dst ← argmin_{i≠src} L_i                    # 最空闲实例
    gap ← L_src - L_dst
    ratio ← L_src / max(L_dst, 1)

    if gap < θ_abs or ratio < θ_rel then
        return ∅                                # 无需再平衡

    R ← EligibleRequests(src)                   # 排除运行中/迁移中的请求
    if R = ∅ then return ∅

    foreach req r ∈ R do
        active_r ← exp(-(now - last_active_r) / H)
        penalty_r ← 1 / (1 + λ · migrations_r)
        score_r ← token_r · active_r · penalty_r

    r* ← argmax_{r∈R} score_r
    return (r*, src, dst)                       # 迁移一个 session
六、系统设计细节
6.1 系统组件
| 组件 | 职责 |
|---|---|
| Worker(Basic 角色) | 维护张量状态,执行本地计划步骤 |
| Worker(Gateway 角色) | 接收调用者连接,解析计划依赖,分发操作 |
| Worker(Shard Home 角色) | 维护高基数张量分片的所有权和一致性 |
| Instance Caller | 执行引擎集成层,暴露引擎 resident 张量状态 |
| Global Store | 轻量级控制平面元数据(DuckDB 后端) |
6.2 统一张量池
TensorCast 将集群中所有可用内存、磁盘、GPU 显存整合为统一张量池:
- 张量副本分布在多个 Worker 上
- 支持不同存储层次(CPU 内存、GPU 显存、本地磁盘)
- 通过
tensor_dict()接口暴露给调用者物化
6.3 分布式计划执行
计划执行流程(Figure 4, Steps 1-8):
- 调用者提交 Plan 到 Gateway Worker
- Gateway 解析计划依赖图
- 将 Plan Step 分发到对应的 Worker 或 Instance
- Worker 执行生命周期操作(prefetch/publish/replicate/migrate)
- 返回执行结果和 Signal 给调用者
6.4 生命周期一致性与容错
- 心跳与 reconcile:Worker 通过 heartbeat RPC 维持存活状态,全局存储协调一致性
- 计划重试:计划步骤失败时自动重试,支持幂等操作语义
- 分片所有权:Shard Home Worker 维护分片的所有权 leases,确保一致性
6.5 张量物化与传输
- GPU 间传输:同主机 GPU 通过 CUDA IPC 零拷贝
- 跨 Worker 传输:RDMA(首选)→ userspace mTCP 多连接 TCP(备选)
- GPU 传输优化:pinned streaming buffers + 异步 CUDA streams 实现传输与计算重叠
七、实现细节
| 组件 | 实现 |
|---|---|
| 运行时 | 分布式 C++ 服务,Worker 间通过 gRPC 通信 |
| 全局存储 | Python gRPC 服务,DuckDB 后端 |
| 数据传输 | RDMA(首选)→ userspace mTCP 多连接 TCP(备选) |
| GPU 传输 | pinned streaming buffers + 异步 CUDA streams |
| 零拷贝 | 同主机 GPU 间通过 CUDA IPC 避免不必要的数据拷贝 |
| SDK | PyTorch 兼容接口,protobuf-generated gRPC stubs |
| 代码规模 | 160K C++ 行(运行时)+ 95K Python 行(SDK) |
八、相关工作
| 系统 | 关注点 | 与 TensorCast 的区别 |
|---|---|---|
| Mooncake [9] | KV 缓存专属后端 | 任务特定,不可组合其他张量管理策略 |
| InstantTensor [62] | 快速权重加载 | 仅优化冷启动加载,无法管理运行时张量 |
| LMCache [11] | KV 缓存共享 | 专用于 prefix cache,不可用于权重/Checkpoint |
| Ray-Plasma [24] | 通用对象存储 | 无张量语义,不感知并行配置和 device layout |
| DVC [40] | 训练 Checkpoint | 仅优化训练侧,不支持推理侧动态管理 |
| SGLang [19] | LLM 推理引擎 | 计算引擎,不包含张量生命周期管理抽象 |
| vLLM [18] | LLM 推理引擎 | 计算引擎,不支持跨实例张量复用 |
九、讨论
9.1 超出推理工作负载的适用性
虽然 §6 的集成和评估聚焦于推理工作负载,TensorCast 也可表达训练工作负载中的张量生命周期:
- Checkpoint 可映射为版本化、系统拥有的 Artifact
view()和transform_into()可表达 rank 特定的重分片- 梯度、优化器状态和长生命周期激活值可暴露为 caller-leased 张量
与 Megatron-LM [70]、DeepSpeed [71] 等训练框架的集成留待未来工作。
9.2 集成成本与抽象开销
解耦张量管理并不消除引擎特定的集成:TensorCast 将引擎 resident 张量状态的导出、导入或变换限制在 instance adaptor 中,使得自定义程序可以在不调用引擎、传输或存储后端的情况下演进。
十、总结
核心贡献
- 识别抽象层缺失:首次将张量生命周期管理识别为 LLM 基础设施中的缺失抽象层
- Tensor-as-a-Service 范式:提出 TaaS 架构,解耦张量状态管理与计算逻辑
- TensorCast 系统实现:实现 16 万行 C++ 分布式运行时 + 9.5 万行 Python SDK
- 四抽象 API 设计:Artifact、Operation、Plan、Signal 分离策略与机制
- 全面实验评估:在权重物化(60×加速)、权重同步(2.6×加速)、KV 缓存(87.5% TTFT 降低)、可编程路由(93.2% TTFT 降低)四个场景验证
技术影响
TensorCast 将张量管理从任务专用竖井提升为可编程服务层,使开发者能够:
- 跨工作负载复用张量管理机制
- 组合生命周期原语实现自定义策略
- 在不修改执行引擎的情况下优化跨组件性能
局限性
- 当前主要验证了 vLLM/SGLang 集成,未评估与 Triton、TensorRT-LLM 等其他引擎的集成
- 高基数场景下的全局存储一致性开销需进一步研究
- 未评估跨数据中心部署场景(除无 RDMA 实验外)
- 未与 Megatron-LM、DeepSpeed 等训练框架集成
十一、参考资源
- 论文:https://arxiv.org/abs/2608.06007
- 代码:https://github.com/tensorcast-ai/tensorcast
- HuggingFace:https://huggingface.co/papers/2608.06007
- Figure 目录:
docs/figures/tensorcast/(20 张 JPG)