JoyAI-Video-Edit: Real-Time Open-Ended Video Editing with Autoregressive Diffusion
16B 参数自回归扩散模型,通过分块因果适配、源锚定蒸馏和长时序自回归蒸馏,实现单张 B200 GPU 上720p@30FPS 的实时流式视频编辑
JoyAI-Video-Edit: Real-Time Open-Ended Video Editing with Autoregressive Diffusion
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | JoyAI-Video-Edit: Real-Time Open-Ended Video Editing with Autoregressive Diffusion |
| 作者 | Yicheng Xiao, Wenxun Dai, Xinran Qin, Lin Song, Maoquan Zhang, Hang Xu, Yukang Chen, Yitong Li, Guohui Zhang, Yuan Zhang, Xuying Zhang, Tommy Zhang, Jianlong Yuan, Peihao Li, Shuai Lu, Siming Fu, Chuyang Zhao, Xin Han, Jie Huang, Wenbo Li, Guoqing Ma, Wei Huang, Xiaojuan Qi, Haoyang Huang, Nan Duan |
| 机构 | Joy Future Academy, JD(京东) |
| 论文 | arXiv:2608.03974 |
| 代码 | github.com/jd-opensource/JoyAI-Video-Edit |
| 发布 | 2026-08-04(cs.CV) |
| 许可 | arXiv.org perpetual non-exclusive license |
二、核心思想
问题定义
实时视频编辑需要在不确定视频时长的条件下,以低延迟因果方式逐帧生成编辑结果,同时维持源视频保真度和长时序时序一致性。传统离线编辑器依赖双向时序交互和全局上下文,无法满足流式部署需求;简单的因果化又会引入训练-推理不匹配(train–inference mismatch)——训练时使用干净历史,推理时消费自身有噪声的预测,导致误差逐步累积、外观漂移。此外,实时吞吐量要求将扩散去噪压缩至极少步(2步),这在自回归框架下进一步加大了质量退化风险。
核心挑战有三:
- 因果适配:将双向编辑器转换为流式生成器,同时最小化质量损失
- 源漂移抑制:两步蒸馏生成中,自回归历史中的误差累积导致输出逐渐偏离源视频
- 长时序稳定性:开放时长流式推理下,时间漂移持续累积
解决方案概述
JoyAI-Video-Edit 提出三项互补技术协同解决上述挑战:
-
分块自回归适配(Chunk-wise Autoregressive Adaptation):块内双向注意力 + 块间因果注意力 + 滑动窗口全局锚点;结合 Resampling Forcing 将干净历史替换为模型自身的单步重采样估计,缩小训练-推理分布差距。
-
源锚定分布匹配蒸馏(SA-DMD):在 DMD 蒸馏目标中引入源锚定——教师沿文本条件和源保真度两个正交轴进行分类器自由引导(CFG),锚定到时间对齐的源块,防止生成历史中的源漂移传导到蒸馏目标。关键设计:源锚定仅施加于蒸馏目标,不进入学生前向传播,因此部署时仍为单条件分支。
-
长时序自回归蒸馏(LHAD):在长 rollout 上进行分段优化——将长序列切为短片段,逐段计算 SA-DMD 反向传播后清空计算图再生成下一段,梯度跨段累积后统一更新,以有限内存暴露模型于长时序误差累积状态。
三者形成统一训练流程:分块因果适配 → SA-DMD 两步蒸馏 → LHAD 长时序优化。
三、技术架构
整体框架图
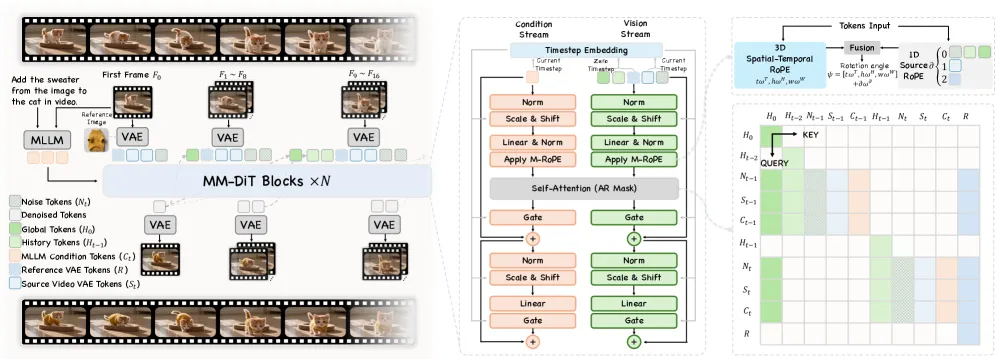
JoyAI-Video-Edit 由三个核心组件组成:
源视频 + 编辑指令 + [参考图]
        ↓
┌─────────────────────┐
│   MLLM 条件编码器     │  ← 处理首帧 + 指令 → condition tokens C_t
└─────────────────────┘
        ↓
┌─────────────────────┐
│   Causal Video VAE   │  ← 编码源视频/参考图 → latent z_s, z_r
│   8×24×24 压缩比      │     每个 latent 帧 = 8个视频帧
└─────────────────────┘
        ↓
┌─────────────────────────────────────────────┐
│   MM-DiT 扩散骨干(16B 参数)                   │
│   ┌─────────────────────────────────────┐   │
│   │ 活跃块: 双向自注意力                   │   │
│   │ 历史块: 因果注意力(滑动窗口+全局sink) │   │
│   │ 源/条件tokens: 全局可见                │   │
│   │ 参考tokens R: 全局可见                 │   │
│   └─────────────────────────────────────┘   │
│   2步去噪生成 edited latent                   │
└─────────────────────────────────────────────┘
        ↓
┌─────────────────────┐
│   VAE 解码           │  ← 输出编辑后视频
└─────────────────────┘
支持两种输入模式:
- V2V:源视频 + 编辑指令 → 编辑后视频
- IV2V:源视频 + 编辑指令 + 参考图 → 编辑后视频(参考图传播外观/身份线索)
核心公式
加噪与流匹配目标:
其中 为目标 latent, 为采样噪声水平, 为高斯噪声。
双向编辑器训练损失:
其中 为 MLLM 提取的条件 tokens, 为源 latent, 为参考 latent(V2V 模式下省略)。
源锚定 CFG 引导教师得分:
其中 为完整条件教师预测, 为去除文本条件的预测, 为去除源 latent 的预测; 和 分别控制文本引导强度和源保真度锚定强度。此公式将教师塑造成”源锐化后验”, 平衡历史连续性与源保真度。
关键设计洞察:源锚定仅施加于蒸馏目标(教师/目标分布),不进入学生(生成器)的前向路径。生成器通过最小化自身预测与源锚定目标之间的差异来吸收源保真度控制,部署时只需单条件分支。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| MLLM 条件编码器 | 处理首帧 + 编辑指令,提取条件 tokens | 视觉+文本联合编码 |
| Causal Video VAE | 时空压缩编码,共享 latent 空间 | 压缩比 8×24×24(时8×空24×24) |
| MM-DiT 扩散骨干 | 块内双向+块间因果的扩散 Transformer | 16B 参数 |
| Causal KV Cache | 滑动窗口 + 全局 sink 的键值缓存 | 首块为全局锚点 |
| Fake-Score Model | DMD 中可训练的伪分数模型 | 与生成器共享骨干+LoRA |
| Real-Score Model | DMD 中冻结的真实分数模型 | 来自前一阶段权重 |
训练流程
JoyAI-Video-Edit 采用四阶段渐进式训练课程:
阶段1:T2I 预训练(建立文本-视觉对齐与高分辨率外观先验)
- 256×256 T2I 预训练:4.3B 样本,
- 512×512 T2I 预训练:793M 样本,
阶段2:T2V 训练(引入时序建模,保留T2I目标防止退化)
- 260p T2V/T2I 预训练:370M 样本,12/24 fps,
- 360p T2V/T2I 预训练:108M 样本,24 fps,
- 480p T2V/T2I SFT:30M 样本,24 fps,
- 480p T2V/T2I CT:6.5M 样本,24 fps,
阶段3:图像编辑训练(学习指令条件变换与内容保持)
- 720p I2I/T2V/T2I SFT:3.2M 样本,
阶段4:双向视频编辑训练(联合优化 V2V/IV2V/I2I/T2V/T2I)
- 720p SFT:5.3M 样本,24 fps,
- 720p CT:1.1M 样本,24 fps,
分块自回归适配
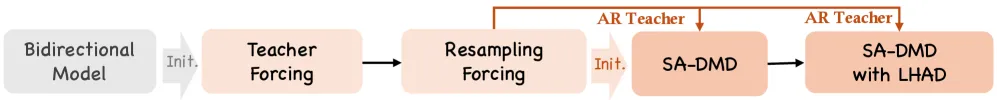
从双向编辑器转换为流式生成器:
- 注意力掩码:活跃块内双向注意力;活跃块对历史块、源 tokens、条件 tokens 因果可见;未来块完全遮蔽;参考 tokens 全局可见
- 滑动窗口:限制跨块注意力为固定数量的近期历史块 + 首块(全局 sink),使注意力上下文与视频长度无关
- Resampling Forcing:每个历史块通过单步去噪重采样估计替代干净目标,从模型自身分布采样并断开梯度,逼近推理时的真实历史分布
SA-DMD 蒸馏
系统由三部分组成(共享骨干 LoRA 配置,均从前一阶段初始化):
- 因果生成器
- 可训练伪分数模型
- 冻结真实分数模型
在标准 DMD 目标(模式搜索 reverse-KL 散度 + 真实/伪分数差异引导)基础上,引入公式 (3) 的源锚定 CFG。训练时,对 rollout 加噪到 ,将引导后的真实/伪速度转换为干净数据预测,生成器最小化两者归一化差异;同时伪分数模型在断开梯度的生成器样本上进行 flow-matching 回归。
LHAD 长时序蒸馏
- 将长序列切为连续短片段,逐段计算 SA-DMD 反向传播后清空计算图,梯度跨段累积统一更新
- 目标 rollout 超过源视频长度时,采用动态镜像循环策略(交替正向+反向序列),保持时序连续性避免简单循环重复的语义突变
- 有界窗口因果注意力确保 KV-cache 使用和逐块计算量在部署时保持恒定
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 分块自回归适配 + Resampling Forcing | 块内双向+块间因果的注意力掩码设计;用模型自身重采样估计替代教师强迫的干净历史 | 消除训练-推理分布漂移;Resampling Forcing [11] 的流式扩展 |
| 源锚定 DMD(SA-DMD) | 在 DMD 蒸馏中沿文本和源两个正交轴施加源锚定 CFG,仅修改蒸馏目标不进入学生前向 | Table 5: SA-DMD 单独将 overall 从2.81提升到3.23(+0.42),全局风格从3.61到4.24 |
| 长时序自回归蒸馏(LHAD) | 分段优化+梯度跨段累积+动态镜像循环,有限内存暴露长时序误差累积状态 | Table 5: LHAD 互补提升 overall 到3.06;与 SA-DMD 组合达3.30(+0.49) |
| 动态镜像循环 | 目标 rollout 超过源长度时交替正向/反向序列扩展条件,避免简单循环的语义突变 | 定性分析:维持长时序编辑一致性 |
| 全栈部署优化 | FP8 量化 + 算子融合 + 编译图优化 + 滑动窗口 KV-cache + pipeline 执行 | 单张 B200 达到 30.19 FPS @720×1280 |
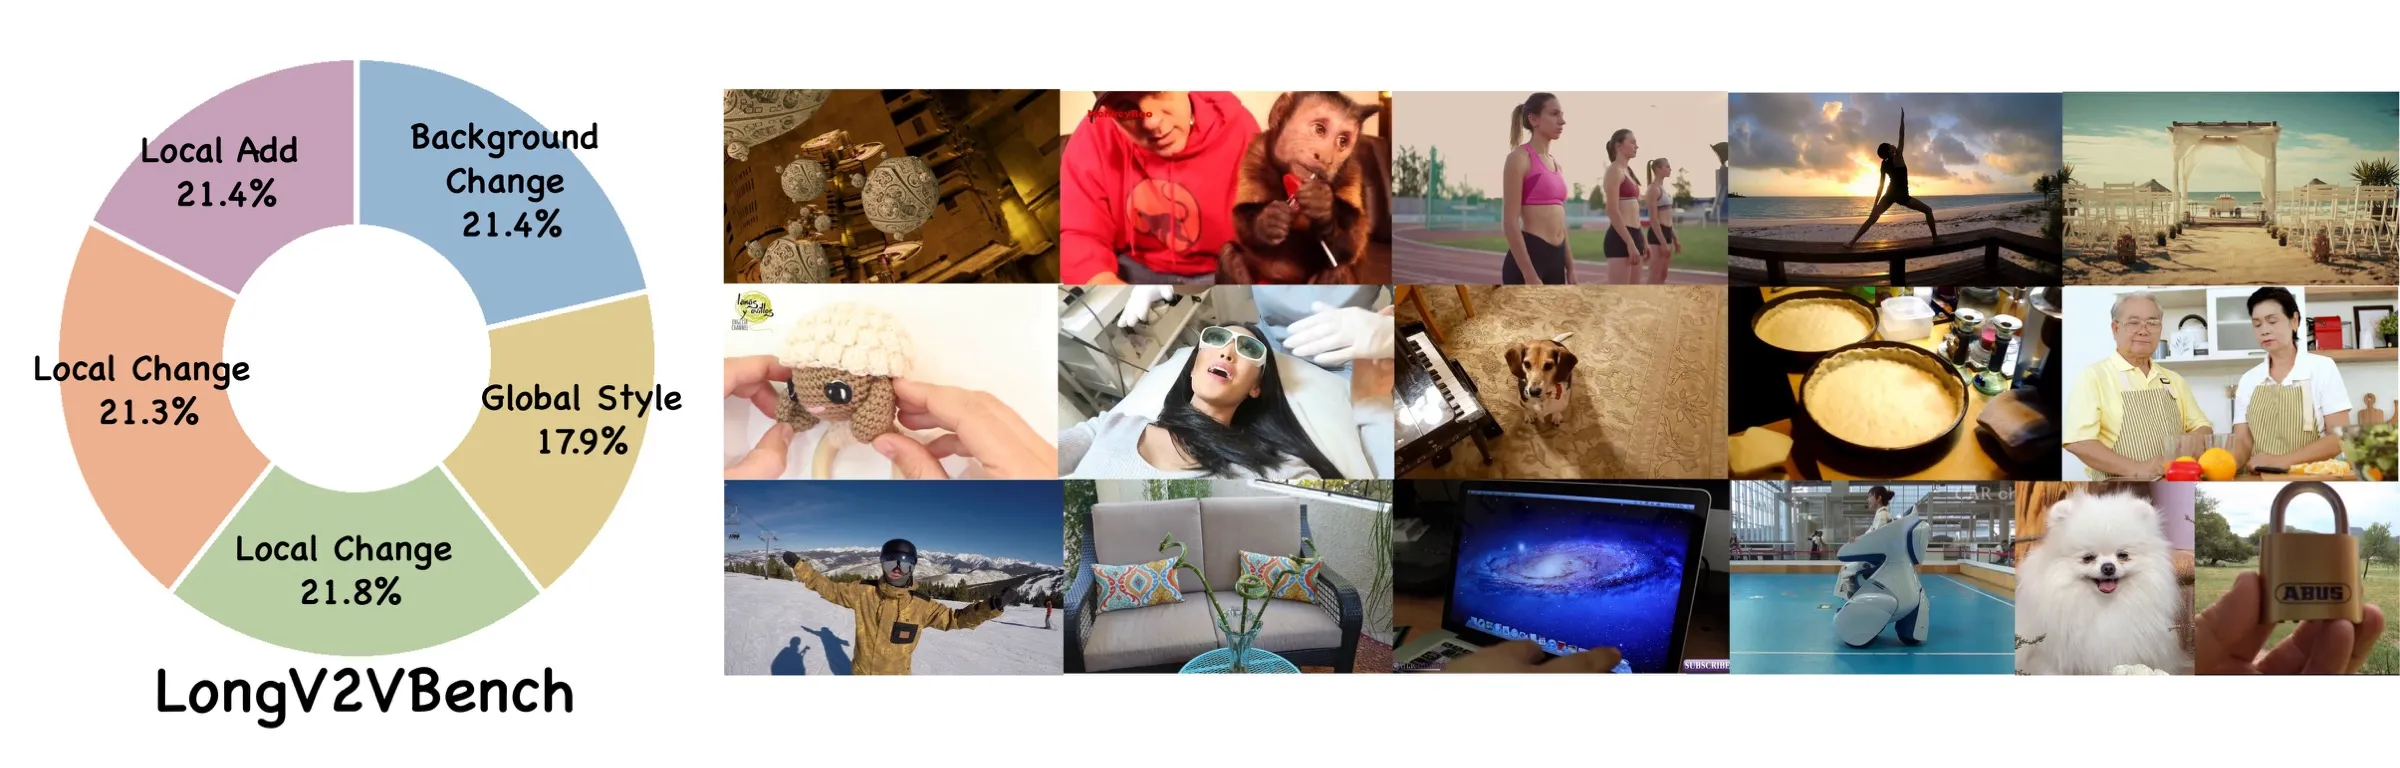
| LongV2VBench | 229 个一分钟长视频编辑评测项,覆盖5类代表性任务 | 填补现有基准(<10s短片)对误差累积评估的空白 |
五、代码实现分析
GitHub 仓库:jd-opensource/JoyAI-Video-Edit
代码已开源(论文发布时),具体实现细节待仓库完善后补充。从论文描述的关键实现要点:
- 16B 参数 MM-DiT,配合 MLLM 条件编码器和因果 VAE
- 共享骨干 LoRA 配置用于 DMD 三模型(, , )
- Diffusion Forcing 框架(每块独立噪声水平 + masked flow-matching 目标)
- 推理:FP8 量化 + 编译优化的 VAE 路径 + warm-up + 内存池复用
六、实验结果
短视频编辑(OpenVE-Bench)
| 方法 | 参数 | 分辨率 | Overall | Global Style | Local Change | Background Change | Local Remove | Local Add |
|---|---|---|---|---|---|---|---|---|
| 闭源方法 | ||||||||
| PixVerse V6 | — | 720×1280 | 3.05 | 3.02 | 4.10 | 2.23 | 2.82 | 3.09 |
| Runway-Aleph | — | 720×1280 | 3.45 | 2.62 | 4.18 | 4.16 | 2.78 | 3.49 |
| Kling-3.0 Omni | — | 1080×1920 | 3.64 | 4.03 | 4.15 | 3.20 | 3.46 | 3.36 |
| Kling-O1 | — | 1080×1920 | 3.62 | 3.38 | 4.44 | 3.23 | 3.32 | 3.74 |
| 开源离线方法 | ||||||||
| VACE | 14B | 720×1280 | 1.57 | 1.49 | 1.55 | 2.07 | 1.46 | 1.26 |
| Bernini-R | 27B | 480×848 | 3.72 | 4.16 | 4.47 | 3.25 | 3.88 | 2.89 |
| VInO | 8B | 480×848 | 3.32 | 4.34 | 2.54 | 3.73 | 3.22 | 2.77 |
| 流式方法 | ||||||||
| StreamDiffusionV2 | 1.3B | 480×832 | 1.23 | 1.48 | 1.35 | 1.01 | 1.27 | 1.05 |
| SANA-Streaming | 2B | 704×1280 | 2.62 | 3.48 | 2.29 | 3.20 | 2.27 | 1.88 |
| LiveEdit | 1.3B | 480×832 | 2.00 | 2.18 | 2.73 | 2.05 | 1.55 | 1.51 |
| XMax-X2.0 | — | 832×1440 | 1.87 | 2.47 | 2.09 | 1.63 | 1.73 | 1.41 |
| JoyAI-Video-Edit | 16B | 720×1280 | 3.60 | 3.62 | 4.47 | 2.90 | 4.06 | 2.97 |
JoyAI-Video-Edit 以3.60分在流式方法中排名第一(5类中4类最佳),大幅领先 SANA-Streaming(+0.98)和 XMax-X2.0(+1.73)。Local Remove 项(4.06)为所有方法(含离线)最高分;Local Change(4.47)与 Bernini-R 并列最高。
长视频编辑(LongV2VBench)
| 方法 | 分辨率 | FPS ↑ | Overall ↑ | Bg Change ↑ | Global Style ↑ | Local Add ↑ | Local Change ↑ | Local Remove ↑ |
|---|---|---|---|---|---|---|---|---|
| StreamDiffusionV2 | 480×832 | 18.07 | 1.21 | 1.08 | 1.71 | 1.18 | 1.11 | 1.03 |
| SANA-Streaming | 704×1280 | 14.51 | 1.64 | 1.19 | 2.02 | 1.50 | 1.72 | 1.85 |
| LiveEdit | 480×832 | 15.45 | 1.23 | 1.10 | 1.34 | 1.33 | 1.34 | 1.04 |
| XMax-X2.0 | 832×1440 | 20.90 | 1.71 | 1.36 | 2.07 | 1.64 | 2.08 | 1.40 |
| JoyAI-Video-Edit | 720×1280 | 30.19 | 3.30 | 2.49 | 3.85 | 3.10 | 4.09 | 2.99 |
JoyAI-Video-Edit 在 LongV2VBench 五个类别中全部排名第一,overall 3.30 超越最强基线 XMax-X2.0 达1.59分,同时吞吐量达30.19 FPS(XMax-X2.0 的1.44倍,SANA-Streaming 的2.08倍)。
人类评估
JoyAI-Video-Edit 对比流式方法获得压倒性偏好:
- vs LiveEdit:90% 偏好
- vs SANA-Streaming:87%
- vs StreamDiffusionV2:87%
- vs XMax-X2.0:81%
对比离线强方法接近持平:
- vs Bernini-R:48% vs 44%(JoyAI 微弱领先)
- vs Kling-3.0 Omni / Seedance 2.0:44% vs 56%(离线方法略优)
部署效率
| 方法 | 分辨率 | 全流水线延迟 | FPS | DiT延迟 | DiT FPS | VAE延迟 | VAE FPS |
|---|---|---|---|---|---|---|---|
| StreamDiffusionV2 | 480×832 | 4.48s | 18.07 | 1.99s | 40.64 | 2.19s | 37.06 |
| LiveEdit | 480×832 | 5.24s | 15.45 | 2.98s | 27.16 | 2.17s | 37.26 |
| SANA-Streaming | 704×1280 | 5.58s | 14.51 | 1.49s | 54.36 | 2.99s | 27.12 |
| JoyAI-Video-Edit | 720×1280 | 2.68s | 30.19 | 2.18s | 37.21 | 0.405s | 200.00 |
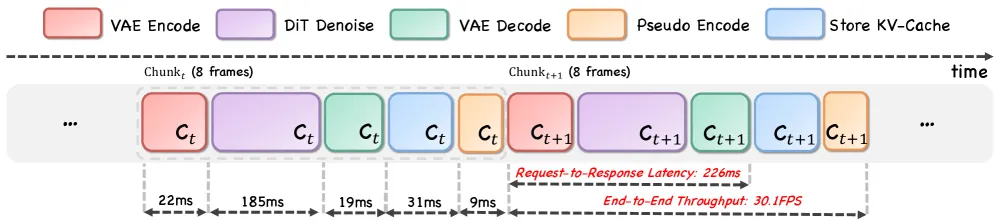
逐 chunk 耗时分解(B200 单卡):
- VAE 编码:22ms/chunk
- DiT 去噪:185ms/chunk(2步)
- VAE 解码:19ms/chunk
- 请求到响应延迟:226ms
- KV-cache 构建+伪编码:31ms+9ms
- 完整周期:266ms = 30.1 FPS
VAE 处理达到200 FPS,大幅缓解自编码瓶颈。
消融实验
| SA-DMD | LHAD | Overall | Bg Change | Global Style | Local Add | Local Change | Local Remove |
|---|---|---|---|---|---|---|---|
| 2.81 | 2.45 | 3.61 | 1.97 | 3.43 | 2.58 | ||
| ✓ | 3.23 | 2.49 | 4.24 | 2.74 | 4.00 | 2.67 | |
| ✓ | 3.06 | 2.60 | 3.56 | 2.49 | 3.94 | 2.70 | |
| ✓ | ✓ | 3.30 | 2.49 | 3.85 | 3.10 | 4.09 | 2.99 |
关键发现:
- SA-DMD 贡献最大:overall +0.42(2.81→3.23),全局风格 +0.63,局部变化 +0.57——源锚定有效遏制源漂移
- LHAD 互补:单独 overall +0.25(2.81→3.06),主要改善背景变化和局部移除——稳定长 rollout 末段误差累积状态
- 两者组合:overall 3.30(+0.49),局部编辑三项全面最优,证明源锚定和长时序优化高度互补
七、相关工作
视频编辑
- 图像编辑基础:CamEdit(相机参数连续控制)、HP-Edit(偏好导向后训练)——增强空间可控性和感知质量,但不涉及时序因果建模
- 离线视频编辑:VACE、Kiwi-Edit、VInO、Bernini-R 等——固定长度片段 + 双向/全局时序交互,质量高但无法流式部署
- 高效视频编辑:Turbo2K(高压缩 latent 空间)、YOSE(选择性 token 处理)——解决计算瓶颈但非通用流式框架
- 流式视频编辑:StreamDiffusionV2、SANA-Streaming、LiveEdit、XMax-X2.0——已有方法质量有限,与离线系统差距显著
长视频生成
- 动态分辨率策略(LongLive)、3D 压缩(X3)、chunk-wise 注意力(Loong、LongStory)——处理长视频生成中的记忆和计算约束,但与编辑任务关注点不同
- 本文定位:首个面向开放式实时视频编辑的统一系统,同时解决因果生成、源保真度、少步加速和长时序稳定性
八、总结
核心贡献
- 首个实时开放式流视频编辑系统:16B 参数自回归扩散框架,支持 V2V 和 IV2V 编辑,无需预定义视频长度,在单张 B200 GPU 上实现720p@30FPS
- 三项互补的训练技术创新:分块自回归适配(解决因果化)、SA-DMD(解决源漂移+少步蒸馏)、LHAD(解决长时序稳定性),形成统一训练框架
- LongV2VBench 长视频编辑基准:229 个一分钟视频编辑任务,填补现有基准对误差累积评估的空白
- 显著的性能优势:流式方法中全面领先(OpenVE-Bench 3.60、LongV2VBench 3.30、人类偏好81-90%),同时与离线强方法持平
技术影响
JoyAI-Video-Edit 将视频编辑从固定片段后处理转变为连续交互式工作流——用户可在播放过程中实时应用或修改编辑指令,无需等待完整视频处理。这对直播、视频通话、互动娱乐、实时内容创作等场景具有变革意义。SA-DMD 的源锚定思想对其他需要源保真度的自回归生成任务(如语音增强、实时翻译)也有参考价值。
局限性
- 硬件要求:单张 B200 GPU,16B 参数模型的部署门槛较高
- 2步蒸馏的质量天花板:虽大幅缩小了与离线系统的差距,但在 Kling-3.0 Omni / Seedance 2.0 等顶级离线系统面前仍存在人类评估差距(44% vs 56%)
- V2V 数据依赖合成:训练数据通过关键帧编辑传播或 latent-shared I2V 生成合成,真实配对编辑数据的稀缺可能限制模型在某些边缘场景的泛化
- LongV2VBench 局限:229 个一分钟视频虽填补空白,但仍无法覆盖极长时序(数分钟到数十分钟)下的漂移行为
九、参考资源
- 论文:arXiv:2608.03974
- 代码:github.com/jd-opensource/JoyAI-Video-Edit
- 关键引用:
- Diffusion Forcing [5]:每块独立噪声水平 + masked flow-matching 框架
- Resampling Forcing [11]:用模型自身重采样估计替代教师强迫历史
- DMD [35]:Distribution Matching Distillation 蒸馏框架
- VACE [15]:统一视频编辑框架,联合 V2V/IV2V/I2I/T2V/T2I 目标
- OpenVE-Bench [12]:开源视频编辑评测基准