UniWorld-Design: From Pixel Generation to Layer-Native Design
基于语义 RGBA 图层的原生视觉设计框架:T2RGBA 文本生成 RGBA 资产 + I2L 指令驱动的图像分层解构
UniWorld-Design:从像素生成到图层原生设计
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | UniWorld-Design: From Pixel Generation to Layer-Native Design |
| 作者 | UniWorld Team(Zongjian Li, Zhiyuan Yan, Chenxu Bai, Chen Chen, Haoxiang Sun, Shaodong Wang, Feize Wu, Shenghai Yuan, Bin Lin, Zheyuan Liu, Yuwei Niu, Li Yuan) |
| 机构 | Peking University [1]、Rabbitpre AI [2](通讯作者:Zhiyuan Yan、Li Yuan) |
| 论文 | arXiv:2608.03971 |
| 项目页 | rabbitvis.rabbitpre.com/blog |
| 发布 | 2026-08-04 投稿(cs.CV) |
| 许可 | CC BY 4.0 |
二、核心思想
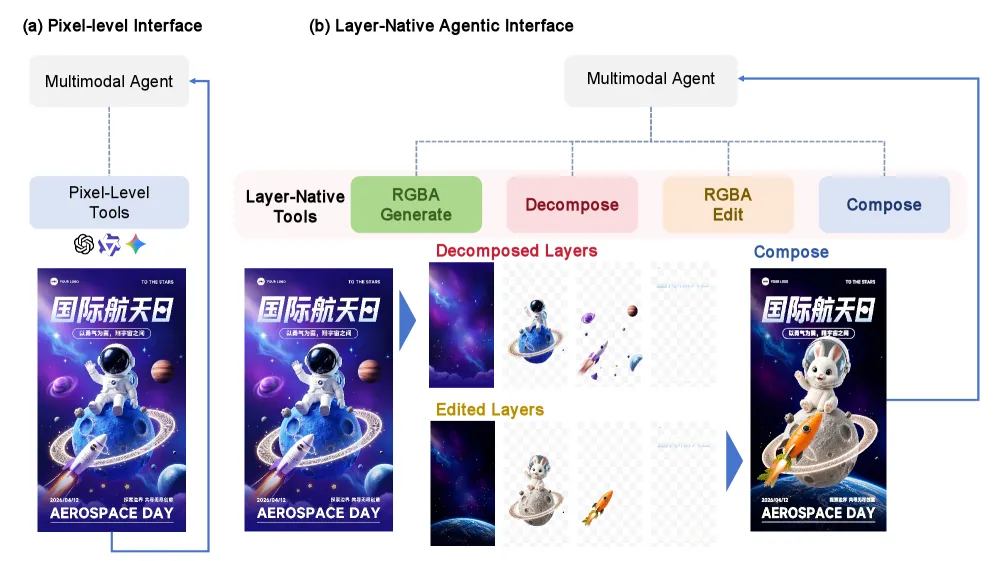
现有文生图模型(如 SD3、UniWorld、SenseNova 等)能生成视觉上令人惊艳的图片,但它们本质是在合成一张扁平的 RGB 画布。像素决定了图像如何被渲染,却不描述图像如何被构成、包含哪些语义元素、以及这些元素应如何被操作。人类设计师则是以有序的图层(背景、主体、装饰、文字)来构建海报、插画与社交媒体图形,每个图层可独立选择、移动、换色、替换或删除。扁平输出的局限不仅在于编辑困难,更在于可编辑结构本身从输出空间中缺失——一旦分层设计被栅格化,对象、层级顺序与层级关系、被遮挡的内容都不再显式存在。
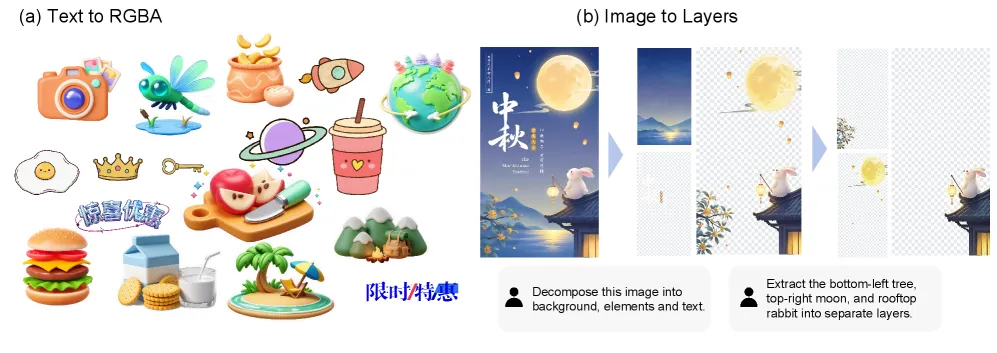
UniWorld-Design 的核心洞察是:像素定义图像如何被渲染,而图层定义图像如何被创建、理解和编辑。据此,作者将语义 RGBA 图层作为生成、理解与编辑的原子单元,为多模态生成模型配备一个图层原生的设计空间。框架包含两个模型:
- Text-to-RGBA (T2RGBA):直接从文本生成可复用的独立 RGBA 资产(透明素材)。
- Image-to-Layer (I2L):以一张成品图像、一个全局指令和逐层提示为条件,联合产出有序、完整、语义化的 RGBA 图层栈。
问题定义
- 纹理层/输出不携带可编辑结构:像素输出难以直接编辑、移动、删除对象。
- 从栅格重建图层结构是不完整的:现有方法(整图指令编辑、掩码编辑、前景分割)无法恢复原始图层栈、层级顺序或被遮挡的内容。
解决方案概述
将生成与解构统一到同一套图层原生表示中——图层是可持久化、可通过语言寻址的对象状态。I2L 把分层暴露为可寻址的指令操作,支持三种模式:顶层分解(将完整图拆成指定语义层)、递归分解(对选中的图层进一步细化)、定向提取(把目标内容与未选中的剩余部分分离)。外部智能体可以决定什么应成为独立图层、调整已有分解的粒度、或在编辑重排前抽取目标。
三、技术架构
整体框架图
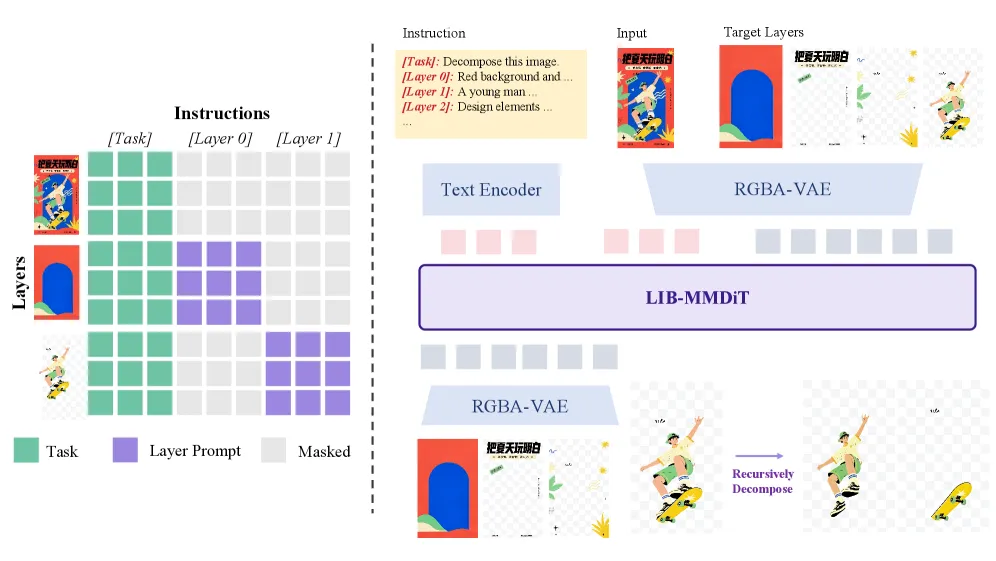
I2L 的核心架构是 LIB-MMDiT(Layer–Instruction Binding MMDiT),它用两种机制分别解决指令控制分层带来的两个对应问题:(1) 每个语义描述必须控制对应的输出图层而非整层堆叠 → 图层-指令绑定注意力;(2) 不同图层的 token 必须保持在同一画布上对齐,同时保留独立的图层身份与顺序 → 图层索引 3D 旋转位置。
预备知识
Rectified Flow(整流流):设 为来自数据分布的干净样本,对应条件 (对 T2RGBA 为文本;对 I2L 为文本加合成潜变量), 为高斯噪声,整流流在两者之间线性插值:
其中 为干净数据、 为噪声。模型通过均方回归学习速度场 ,推理时从噪声积分到数据。文中所有 均表示自编码器潜变量; 表示图层索引, 为目标图层数, 表示第 层, 表示合成图像条件。
DiffusionNFT:在相同条件 下对采样输出进行奖励驱动的后训练。设 为候选 的组归一化最优性得分, 为对应目标速度, 为 EMA 更新数据收集策略预测的速度。采用 DiffusionNFT 隐式策略参数化且 时,核心目标为:
高 通过 把模型拉向采样目标;低 通过反射速度 推离。两条分支由同一流场参数化,故采样器不变。
RGBA 自编码器与 RGB 潜对齐
通道扩展:沿用近期 RGBA 自编码器的做法,仅将编码器第一层卷积与解码器最后一层卷积从三通道扩展到四通道。预训练 RGB 权重被复制,两个新 alpha 滤波器零初始化,解码器 alpha 偏置设为 1,因此扩展模型以”不透明 alpha”的原始 RGB 自编码器为起点。
训练:在透明 RGBA 图像与不透明 RGB 图像(alpha 置 1)的混合上训练,目标为 RGB/alpha 重建、感知、KL、对抗与 RGB 潜对齐项的组合:
其中 为优化步数、 为对抗损失起始步、 为自适应梯度范数比。RGBA 编码器 对 RGB 样本 接收不透明 alpha 通道,而冻结的教师 接收其三通道 RGB。仅对源自 RGB 的样本应用此对齐,使它们的编码保持接近预训练潜空间且不把教师项直接用于透明样本。自编码器训练用直 alpha 以保留透明下的颜色,而扩散训练在白底合成后表示 RGB。
T2RGBA 生成
训练数据为内部整理、文本配对透明 RGBA 图像的语料,包含设计资产、抠图主体与矢量派生插画。透明 RGBA 图像占训练混合的大多数,同时也含不透明图像。微调先在 512² 等价面积下进行,再在 1024² 继续。T2RGBA 与 I2L 均采用 §3.6 的两阶段流程(渐进蒸馏 + DiffusionNFT 后训练),任务特定奖励见式 (6)。I2L 分层模型从后训练后的 T2RGBA 而非基础模型出发。
指令控制的图像到图层生成(I2L)
图层-指令绑定注意力:给全局指令与合成条件赋标签 ,给目标图层 的提示与图像 token 赋标签 。图像 query 读取全局文本及其对应提示,但不读其他图层的提示。图像-图像注意力不受限(允许条件与所有目标联合解决遮挡与堆叠),文本-文本注意力也不受限;绑定掩码仅作用于图像 query 对文本 key 的注意力,使全局指令广播到整栈、每层描述仅绑定到其目标输出。
图层索引 3D 旋转位置:基础 Transformer 给每个图像 token 分配三个旋转坐标 (首坐标恒定 + 空间行列)。沿用 Qwen-Image-Layered 的图层索引定位,复用该恒定坐标表示图层身份而不另加位置轴。合成图用索引 ,目标层 用索引 ( 为最底层)。相等的 保证整个栈对齐到同一画布位置,首坐标区分图层顺序。文本保持基础模型的位置方案,其图层绑定由掩码 处理。
条件与训练:全局指令、逐层提示、编码合成、目标层潜变量组成一条 LIB-MMDiT 序列。合成图在 保持干净、在每个去噪步重新注入且不计入损失;仅目标层被加噪并监督,每个样本共享一个时间步。图层绑定与图层索引机制贯穿微调、蒸馏和后训练全程。
由 PSD 文档构建语义图层树
训练 I2L 需要”被移走或删除后仍可用”的图层栈。用生成资产合成这类栈存在循环问题(图层统计继承生成器偏差,且被遮挡内容必须自行生成)。作者改用设计师亲制的 PSD 文档,其合成图中被隐藏的图层内容在源文件中仍然可用。
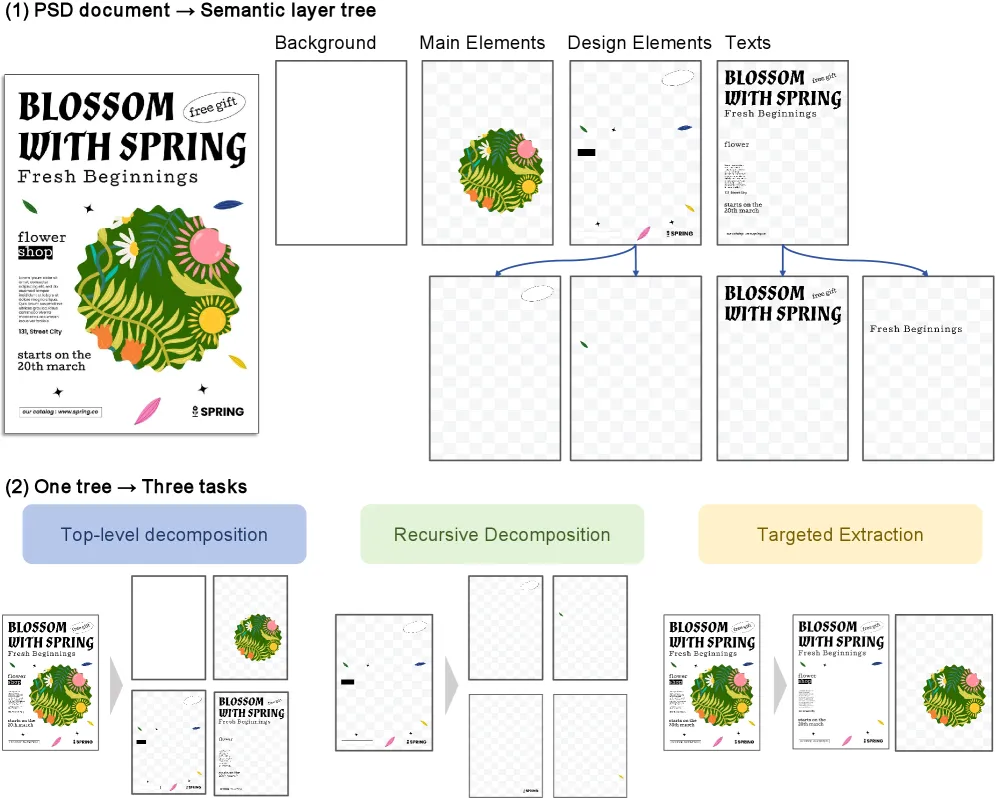
- 保留被遮挡内容:构建目标图层时即使像素被上方图层隐藏也保留其源像素。移动或移除遮挡层时露出的底层内容而不是透明空洞。可见像素切分不用作训练目标。
- 树衍生监督:每个树节点定义一幅合成及其语义子节点。根节点提供顶层分解样本,内部节点提供递归分解样本,选中节点连同未选中剩余部分提供定向提取样本。树的重组作为图像条件,以与保留的目标保持一致。三种任务在微调中混合。
渐进蒸馏与后训练
一次序列发射多个全分辨率图层会使序列长度倍增,采样成本主导推理。监督微调后用渐进蒸馏降低采样开销,再用 DiffusionNFT 后训练优化图层级输出质量。
轨迹监督的经验选择:作者也尝试过分布匹配蒸馏(DMD/DMD2),但在分层 RGBA 生成中发现 alpha 预测倾向全不透明、RGB 内容与 alpha 掩码错位、条件跟随与跨层一致性变弱,故改用渐进对抗蒸馏。
渐进对抗蒸馏:让 student 预测一个方向,直接到达 teacher 多步后的流位置。从较粗的 student 调度采样区间 (),对真实目标潜变量加噪得起始态 ,冻结 teacher 走 步 Euler,student 一步直达:
表示 teacher 的多步更新;干净条件层与文本构成 ,条件层永不加噪、不计入对 个目标层的求和。端点 项把 student 预测锚定到 teacher 的下一个流位置。在交替对抗更新中,由 Transformer 骨干初始化的判别器在同一目标时间步 与相同条件下把 teacher 端点视为真、student 端点视为假。蒸馏得到八步 student,这也是后训练后的评估调度。
任务特定奖励:DiffusionNFT 后训练两种模型用不同奖励管线。
T2RGBA 的每个解码 RGBA 样本由三个奖励头评估。设 为 alpha-跟随得分(读取生成 alpha 与提示的透明/不透明标签:请求抠图时奖励透明、请求不透明图时奖励全覆盖); 为用 Qwen3-VL 嵌入计算的 CLIP 式提示-图像余弦相似度; 为来自 Qwen3.5-9B 的 logit 得分。冷冻 MLLM 在 0–5 尺度评分白底合成资产与文本条件,对六个得分 token 的输出 logits 施加 softmax,取归一化期望值 。
I2L 的每个解码图层 按有序槽位与同画布真值图层 配对。第一奖励头为四通道 RGBA 全像素平均绝对误差;第二为只在 RGB 三通道上(无 alpha 掩码)的冻结 AlexNet LPIPS:
奖励为:
外部 alpha-跟随项是一个门控:样本不能仅靠获得高嵌入/MLLM 分数来弥补不正确的透明度。对 I2L,两个显式重建距离先在每层内合并、再对目标层等权平均;稳定配置用相等的 与 LPIPS 权重。不跨层乘奖励、不对合成图施加奖励。因此 alpha 误差只影响 RGBA 头、绝不进入感知网络。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 图层原生表示 | 将语义 RGBA 图层作为生成、分解与编辑的原子单元,暴露持久、可独立操作的对象状态 | 通过定义”像素=渲染、图层=创作/理解/编辑”的用户空间,为外部设计代理提供结构化接口 |
| LIB-MMDiT 架构 | 图层-指令绑定注意力 + 图层索引 3D 旋转位置,解决”描述绑定对应层”与”跨层画布对齐”两大对应问题 | RGB L1 -37%、Alpha Soft IoU +34%(vs Qwen-Image-Layered) |
| 可寻址的指令分层 | 在同一接口内统一顶层分解、递归分解与定向提取,使分层成为可寻址操作 | 递归分解定性演示(Figure 6) |
| 完整语义对象而非可见像素分块 | 保留被遮挡内容,移动/删除遮挡层后底层仍可用;由真实 PSD 文档构建语义图层树监督,避免生成资产的循环偏差 | 背景修复 +0.56(VLM 评估) |
| 渐进对抗蒸馏 + DiffusionNFT 后训练 | 8 步 student 降采样成本;奖励后训练优化图层级质量 | 不同任务定制的奖励头(T2RGBA 文本对齐,I2L 重建保真) |
五、代码实现分析
论文未直接提供开源代码链接(超链接指向项目页)。系统默认采用业界成熟的组件栈:基于 MMDiT(Multimodal Diffusion Transformer) 架构(与 SD3/Qwen-Image 同源,隐含可复用其预训练权重),自编码器遵循 RGBA 自编码器家族(AlphaVAE/Qwen-Image-Layered/OmniPSD)的四通道扩展方案。关键实现要点:
- 序列打包(附录 C):token 按图层主序打包——第 0 层所有 token、第 1 层所有 token……而非在每个空间位置交错各层。配合样本内共享裁剪与缩放,使同一 在每层都指向同一画布位置。文本打包为全局指令后,对每个目标层 接
Layer i: <short> --- <detailed>;显式索引绑定描述到图层槽位,并允许推理时设定图层数。 - 评估管线:LayerD 动态时间规整做栈对齐与逐层 RGB/alpha 度量;Stable-Layers 提供无参考可编辑性与结构准则;GPT-5.6-terra 做 VLM 判定。
六、实验结果
设置
Image-to-Layer:用 512 个固定种子的 Crello 设计(每个设计与其源栈配对;Crello 数据未参与训练),最终 checkpoint 在 512² 等价图像面积、八步、无 CFG 下运行,请求四层以匹配 Qwen-Image-Layered(官方脚本、640 px、可选全局字幕输入)。LayerD 提供栈对齐与逐层 RGB/alpha 度量,Stable-Layers 提供无参考可编辑性与结构准则。
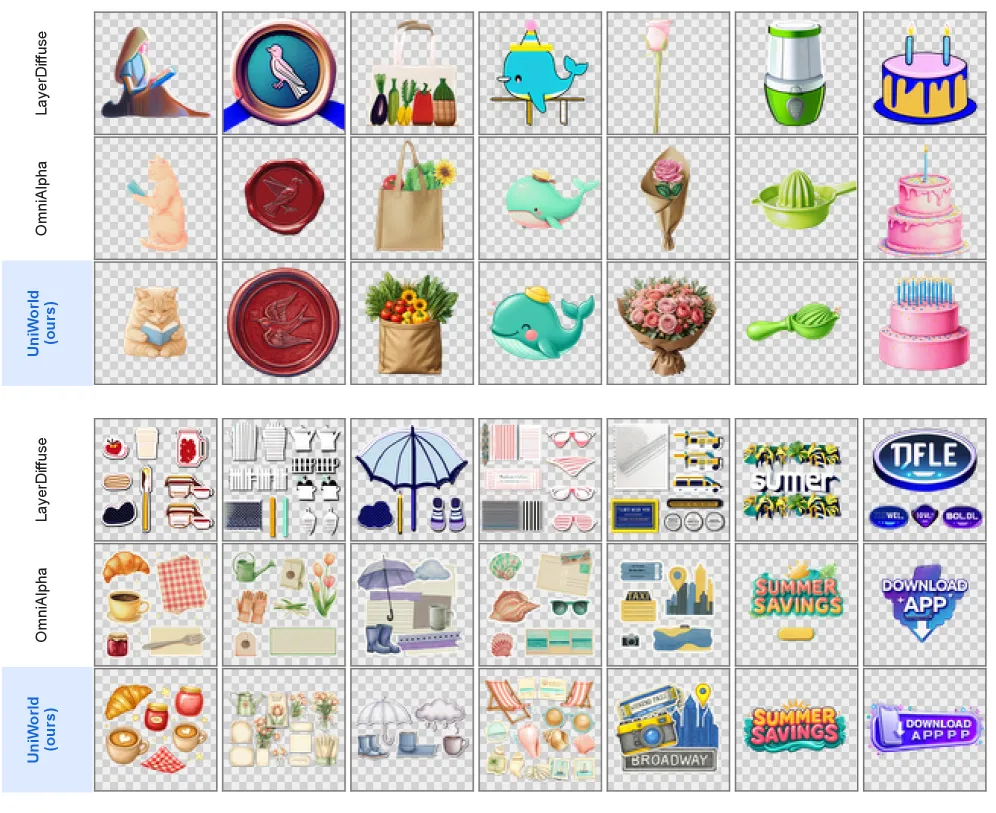
Text-to-RGBA:从内部保留集采样 512 个带字幕图层(seed 42),每字幕生成一张 512×512 资产。CLIP Score 用全部输出;FID 与 1000 张真实图层的白底合成比较;Alpha MSE、SAD、白底 LPIPS 用 479 张可定位源图层在其原始分辨率评估。对比 LayerDiffuse 与 OmniAlpha。
图层分解质量
表 1:512 张 Crello 设计的逐层质量(LayerD DTW 对齐;RGB L1 用二元参考 alpha 支撑加权):
| 方法 | RGB L1 ↓ | Alpha Soft IoU ↑ |
|---|---|---|
| Qwen-Image-Layered(4 层) | 0.2014 ± 0.0937 | 0.5454 ± 0.1577 |
| UniWorld-I2L(4 层) | 0.1264 ± 0.0980 | 0.7325 ± 0.1622 |
在匹配层数下,逐层 RGB L1 相对降低 37%(0.2014→0.1264),Alpha Soft IoU 相对提升 34%(0.5454→0.7325)。栈对齐后我们的图层在 RGB 内容与 alpha 支撑上都更贴合参考。
表 2:512 张 Crello 设计的可编辑性(Stable-Layers 无参考度量;Bad Layers 统计每样本空白层与釉层数量,百分比按发射槽位计):
| 方法 | Bad Layers ↓ | Blank ↓ | Glaze ↓ | Feat. Dist. ↑ |
|---|---|---|---|---|
| Qwen-Image-Layered(4 层) | 1.69(42.3%) | 0.35 | 1.34 | 0.658 |
| UniWorld-I2L(4 层) | 1.32(33.0%) | 0.13 | 1.19 | 0.690 |
无参考指标与逐层保真一致:空白输出降低 63%(0.35→0.13),Feature Distribution 从 0.658 升至 0.690(层间冗余更少),釉层从 1.34 降至 1.19,Bad Layers 从 1.69 降至 1.32。
表 3:VLM 评估——四层分解,GPT-5.6-terra 从输入图、预测栈的 alpha 合成与带标签接触表对预测层评分,五个维度 0–5(总分 /25,括号内为归一化):
| 方法 | 语义分离 | Alpha 洁净 | 背景修复 | 内容分布 | 内容有效 | 总分(归一化) |
|---|---|---|---|---|---|---|
| Qwen-Image-Layered | 3.00 ± 0.99 | 3.33 ± 1.59 | 3.88 ± 1.64 | 3.60 ± 1.17 | 3.78 ± 1.39 | 17.60 ± 4.97(0.704) |
| UniWorld-I2L | 3.83 ± 0.86 | 2.90 ± 1.11 | 4.44 ± 1.08 | 4.55 ± 0.67 | 4.71 ± 0.70 | 20.43 ± 2.91(0.817) |
VLM 评估在四个维度提升、Alpha 洁净度下降。内容分布(+0.95)、内容有效(+0.93)、语义分离(+0.83)贡献了总分 2.83 分提升的大部分;背景修复加 0.56(与在真实文档中监督”完整对象”的预期效果一致,作者未单独隔离该效应)。Alpha 洁净是唯一下降维度(2.90 vs 3.33),在 §5 讨论。
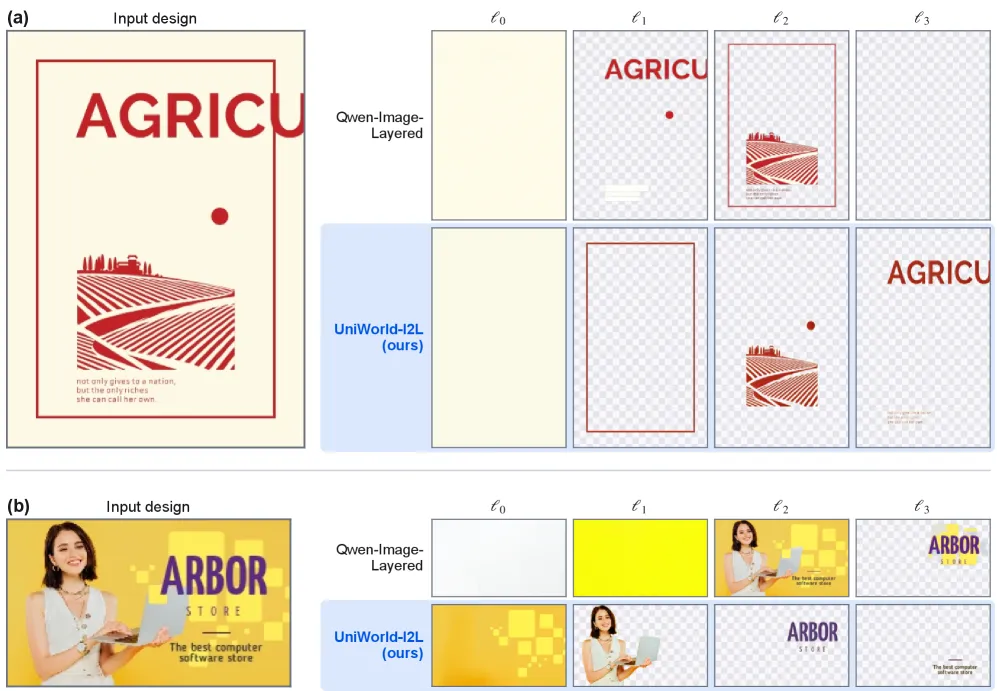
图 5:在两个 Crello 设计上与 Qwen-Image-Layered 的逐层分解定性对比。每个设计上方为 Qwen-Image-Layered、下方为本方法;每行展示四个预测 RGBA 层 –,由后到前排列。棋盘格表示透明。
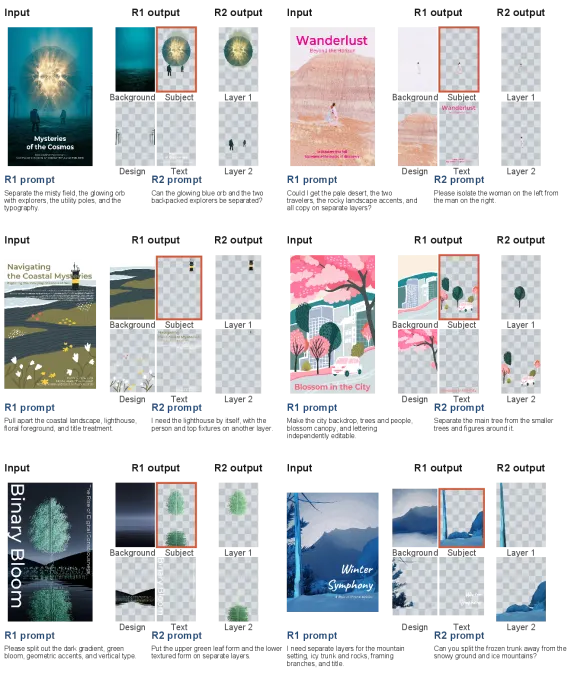
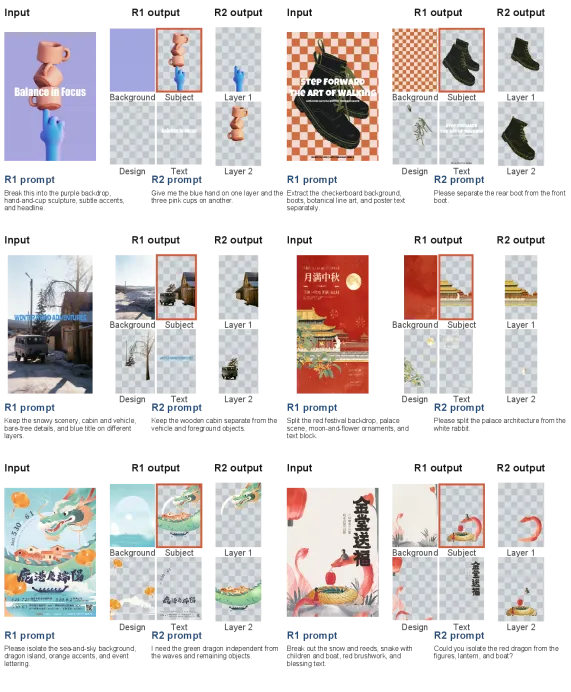
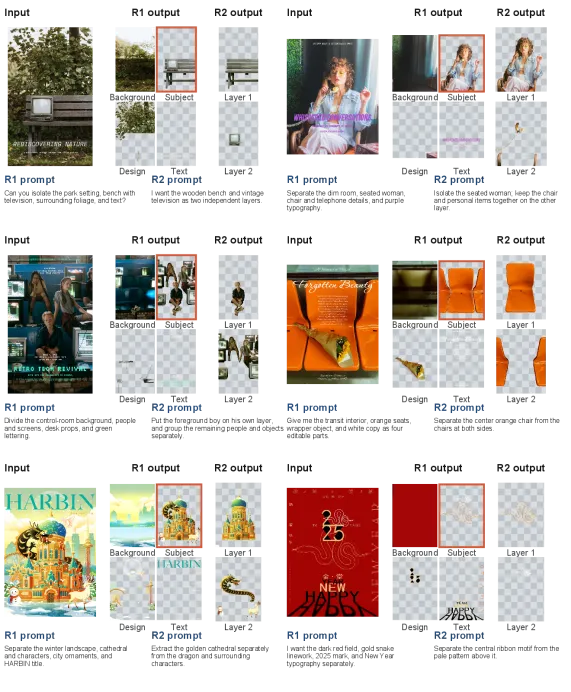
图 6:指令控制的 I2L 分解定性分析。对每张输入海报,第一轮(R1)按示例下方的用户提示把图像分解为四个语义、位置对齐的 RGBA 层:背景、主体、设计、文字。被勾出的主体层成为第二轮(R2)的输入图像,R2 再按其自身的用户提示把该选中层分解为两个更细粒度的层,同样保留位置与 alpha。
文本到 RGBA 生成
表 4:512 个设计元素提示上的文本到 RGBA 生成(FID/CLIP 用全部 512 张,FID 对 1000 张真实图层;Alpha MSE、SAD、LPIPS 用 479 个有匹配参考图层的提示、在参考分辨率评估。OmniAlpha 使用其发布 RL-LoRA、1024²、50 步、真引导 4.0):
| 方法 | FID ↓ | CLIP Score ↑ | Alpha MSE ↓ | SAD ↓ | LPIPS(白) ↓ |
|---|---|---|---|---|---|
| LayerDiffuse (SDXL) | 214.47 | 29.22 ± 4.51 | 0.495 ± 0.322 | 1,281,170 | 0.724 ± 0.205 |
| OmniAlpha | 87.86 | 31.00 ± 7.02 | 0.406 ± 0.305 | 1,049,631 | 0.462 ± 0.244 |
| UniWorld-T2RGBA | 117.14 | 33.03 ± 5.29 | 0.413 ± 0.382 | 1,083,441 | 0.537 ± 0.245 |
相对 LayerDiffuse,改进一致:FID 降 45%,CLIP Score 升 13%,三个配对度量各改善 15–26%。CLIP Score 最高(33.03 vs 31.00,+6.5%);OmniAlpha 在 FID(87.86 vs 117.14)与白底 LPIPS(0.462 vs 0.537)领先,Alpha MSE 与 SAD 也略低(0.406 vs 0.413;1,049,631 vs 1,083,441)。
这些度量回答不同问题:CLIP Score 作为对齐代理,FID/LPIPS 分别在分布与实例层面比较输出与参考资产。在该协议下 OmniAlpha 更贴合参考外观分布且 alpha 略准,而我们的模型在文本跟随上平均更紧。
度量定义要点(附录 B)
- 逐层指标(LayerD):预测与参考图层栈按 LayerD 动态时间规整编辑协议对齐(可合并相邻层以容纳粒度差异),对齐后每对在较小分辨率(仅下采样)比较。RGB L1 用二元参考支撑加权——图层只在参考 alpha 非零处被评判;Alpha Soft IoU 用连续 alpha(对半透明区域敏感)。
- 可编辑性指标(Stable-Layers):空白层 = 平均 alpha < 0.01;釉层 = 平均 alpha ∈ (0.1,0.9) 且 RGB 标准差 > 0.05(含残余颜色的漫反射半透明层,限制独立可编辑性);Bad Layers = 二者之和。Feature Distribution 对每层取 DINOv2-base 特征(最后隐藏态空间均值),报告 ,越高表示单输出各层越不相似。
- VLM 判定:GPT-5.6-terra 接收输入设计、预测栈 alpha 合成与预测层标签接触表,返回五个 0–5 整数。
- T2RGBA 指标:FID 用 Inception-v3(299²、白底合成后),512 生成样本 vs 1000 真实图层分布;CLIP Score 用 CLIP ViT-B/32;Alpha MSE、SAD、白底 LPIPS 在 479 个匹配提示的参考原生分辨率计算。
七、相关工作
- RGBA 生成:两条路线——(a) 保留预训练 RGB 表示、通过潜偏移/辅助分支/注意力线索/独立解码器附加 alpha(LayerDiffuse、ART);(b) 学习原生 RGBA 表示用于重建、分层生成或多任务(AlphaVAE、OmniPSD、OmniAlpha)。本文沿后者,但把 RGBA 赋予两种模型的两种角色(T2RGBA 独立资产、I2L 多有序语义层)。
- 图层分解:Qwen-Image-Layered(联合生成语义解缠 RGBA 层 + 递归再分解)、OmniPSD(文本到 PSD / 图像到 PSD)、LayerD(从栅格设计顺序提取元素)。Qwen-Image-Layered 不暴露逐层语义提示或受文本指令控制的定向提取;I2L 通过绑定全局指令与逐层提示到有序输出,统一顶层分解、递归分解与定向提取,并针对完整语义层而非可见像素分块。
- 智能体图像编辑:GenArtist(多模态规划器)、Agent Banana(掩码定位高分辨率裁剪、编辑、融合——“图层”是局部执行补丁)、ReDesign(可编辑 JSON 层级 + 多工具)。本文原生 RGBA 分解模型把完整语义层暴露为持久、语言可寻址的对象状态。
八、总结
核心贡献
- 图层原生表述——把语义 RGBA 图层作为生成、分解与编辑的原子单位;通过暴露持久、可独立操作的对象状态,为外部设计代理提供可规划与执行的生成/分解/精炼/编辑/重组的结构化接口。
- 两个模型——T2RGBA 生成可复用 RGBA 资产;I2L 提供可寻址指令接口,把成品图像按可控粒度分解为有序、完整的语义层。
- 系统评估——覆盖逐层保真、透明度、可编辑性与 RGBA 资产生成。相比 Qwen-Image-Layered,I2L 将逐层 RGB L1 降 37%、Alpha Soft IoU 提升 34%、空白层生成降 63%、VLM 得分 20.43 vs 17.60;T2RGBA 在对比模型中取得最高 CLIP Score(33.03)。
技术影响
UniWorld-Design 把图像生成从”扁平像素合成”推进到”结构化视觉组合”,使可编辑结构回到输出空间本身。它为面向设计的代理系统提供了持久、语言可寻址的视觉对象状态接口,连接语言、成品图与可编辑结构三者,使”生成→分解→递归精炼→编辑→重排”成为闭环。设计原则(RGBA 原生、共享视觉条件 + 逐层绑定、学习完整语义对象而非可见分块)可迁移到更通用、面向布局与多轮编辑的视觉生成中。
局限性
- Alpha 边缘:UniWorld-I2L 的 alpha 洁净度低于 Qwen-Image-Layered(2.90 vs 3.33),改善精细 alpha 边界是未来工作。
- 稠密排版,尤其中文:复杂字形与较长段落会产生缺笔画、错字与不稳定布局。排版密集的设计需要底层模型更强的文本生成能力。
未来工作
扩大数据、模型容量与算力,预训练一个统一模型进行原生 RGBA 生成与理解,把范围从 RGBA 资产生成与图像分解扩展到图层插入与替换、布局约束组合、迭代多轮编辑。
九、参考资源
- arXiv: https://arxiv.org/abs/2608.03971(PDF: https://arxiv.org/pdf/2608.03971)
- HuggingFace 论文页: https://huggingface.co/papers/2608.03971
- 项目页: https://rabbitvis.rabbitpre.com/blog
- 相关前作(文中引用):UniWorld / UniWorld-v2(
li2025uniworld)、Qwen-Image-Layered、OmniPSD、LayerD、OmniAlpha、Stable-Layers、AlphaVAE