OmniPack: Unified Token Compression for Efficient Omni-modal Large Language Models
免训练的两阶段渐进式 token 压缩框架:LLM 前的模态特异结构压缩 + LLM 内的查询条件音视协同精炼
OmniPack:面向高效全模态大语言模型的统一 Token 压缩
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | OmniPack: Unified Token Compression for Efficient Omni-modal Large Language Models |
| 作者 | Wanshun Su¹*、Yang Shi²*、Feihu Liu³、Ziwen Yu³、Yan Min³、Zhuoran Zhang²、Qixun Wang²、Haotian Wang⁴、Shixuan Liu⁴、Yuanxing Zhang²、Peng Wu¹‡、Chengfu Huo³、Liang Ding³‡(* 同等贡献,‡ 通讯作者) |
| 机构 | ¹西北工业大学、²北京大学、³阿里巴巴集团、⁴清华大学 |
| 论文 | arXiv:2608.03812 |
| 代码 | github.com/RowanSu/OmniPack |
| 发布 | 2026-08-04 投稿(cs.CV) |
| 规模 | 16 页、5 图、15 表 |
| 许可 | CC BY 4.0 |
二、核心思想
全模态大语言模型(Omni-LLMs,如 Qwen2.5-Omni、MiniCPM-o、GPT-4o、Gemini 3.1 Pro)能在统一框架内联合建模文本、图像、视频与音频,在音视理解任务上表现优异。但密集 token 化的视觉与音频输入产生远长于文本的序列,推理时带来巨大的计算与显存开销。高效部署因此要求激进的 token 压缩——在去除冗余的同时不丢失任务相关的多模态证据。
论文的核心洞察是:压缩策略应与”多模态表征的语义成熟度”相匹配,实施阶段特化(stage-specialized)的渐进策略:
LLM 之前应利用模态特异的时空结构(此时跨模态语义尚未充分涌现); LLM 之内应利用已在 LLM 中建立的查询条件音视交互。
问题定义
现有 Omni-LLM 压缩方法在激进 token 预算下存在两个局限:
局限一:长程音视结构建模不足。 任务相关证据可能稀疏地分布在遥远的时间段、突变的视觉变化与瞬态声学事件中。仅基于局部重要性或 token 相似度的压缩因此可能忽略全局分布的证据(长视频尤甚)。此外,直接丢弃低分 token 会造成不可逆的信息损失——单独看不显著的 token 仍可能提供互补上下文。
局限二:音视协同与语义成熟度未对齐。 部分方法(OmniZip、OmniSIFT)在 LLM 之前用一个模态引导另一个模态的压缩;但此阶段独立编码的音频与视觉表征只经历了有限的语义交互,跨模态引导可能建立在对齐不充分的特征之上。而渐进式方法(OmniDrop、SEATS)虽在 LLM 内进一步压缩,其内部阶段主要依赖文本引导,未显式建模音频与视觉 token 之间的协同交互。
解决方案概述
OmniPack 是一个**免训练(training-free)**的两阶段框架,在 LLM 之前与之内渐进地压缩 token:
- 阶段一(Pre-LLM,模态特异结构压缩):通过重要性选择 + 覆盖度选择 + 相似度感知合并去除大规模结构冗余,同时保留重要证据与全局覆盖,提供早期计算节省。
- 阶段二(Inner-LLM,查询条件音视协同压缩):在充分的多模态交互之后,用文本引导 + 音视协同 + 模态内代表性进一步精炼保留的表征。
两阶段协调了结构压缩与语义精炼,使激进压缩下仍能维持多模态理解性能。关键设计还包括:不直接丢弃未选中 token,而是将其信息**合并(merge)**到保留的代表 token 中,缓解信息损失。
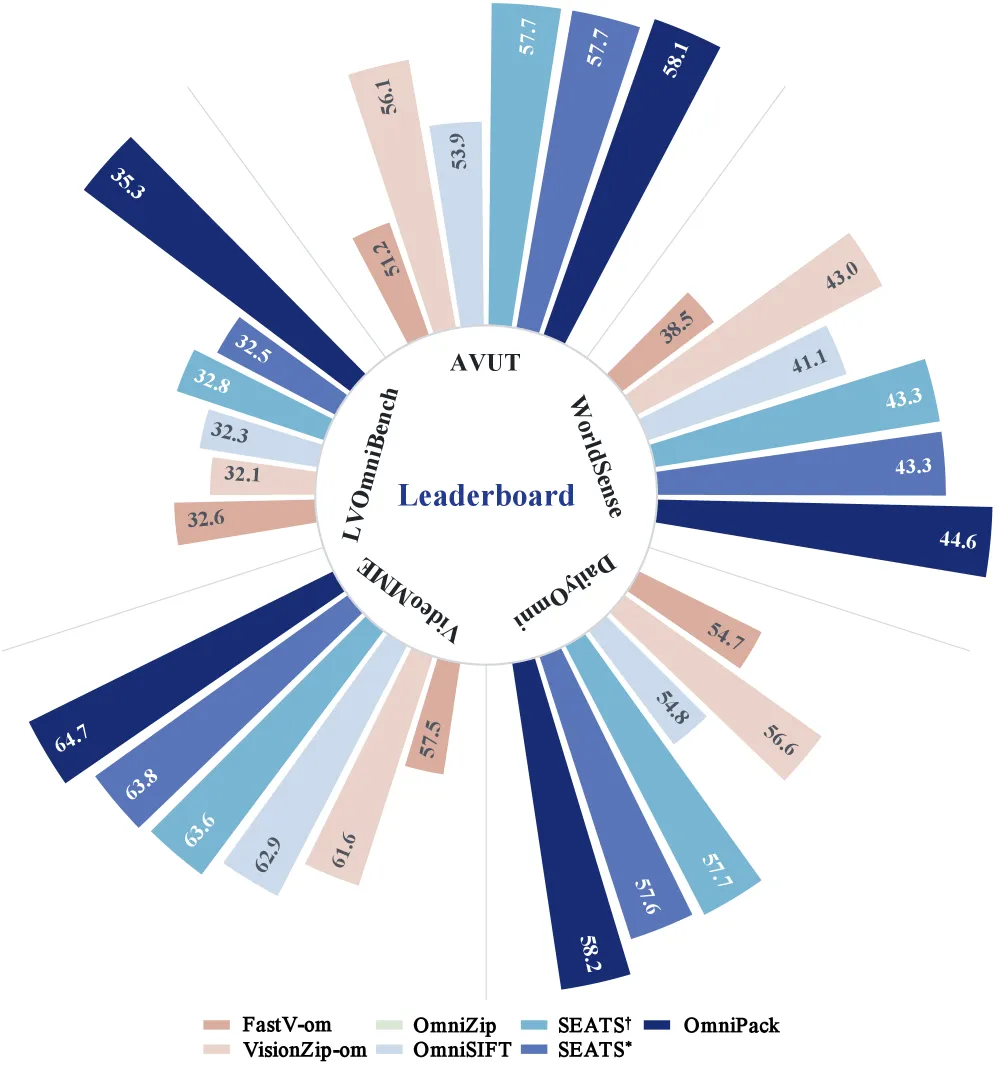
图 1: Qwen2.5-Omni-7B 在五个基准上的性能对比。SEATS 变体与 OmniPack 进一步把 token 从 15% 降到 7.5%,其中 OmniPack 取得最佳整体性能。
三、技术架构
整体框架
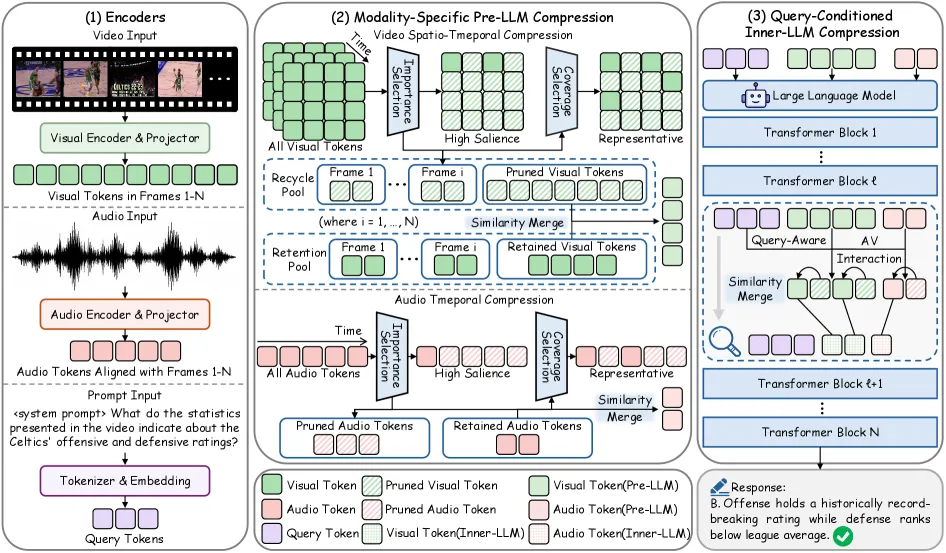
图 2: OmniPack 框架总览。LLM 之前,模态特异压缩执行重要性选择、覆盖度选择与相似度感知 token 合并。LLM 之内,查询条件压缩在第 个 Transformer 块之后应用。recycle pool 与 retention pool 分别表示未选中与已选中的 token。
OmniPack 将压缩从结构线索转向任务条件语义,且信息损失最小。
预备定义
给定视频 及其对齐音频 ,模态特异的编码器–投影器管线将它们映射到 LLM 嵌入空间,产生 个视觉 token 与 个音频 token 。对模态 的编码器 token,LLM 之前保留 个:
其中 为 pre-LLM 保留比。令 为送入 LLM 的模态 token 数。给定 inner-LLM 保留比 ,进一步保留:
所有文本 token 在整个压缩过程中保持不变。
阶段一:模态特异的 Pre-LLM 压缩
由于跨模态语义尚未充分涌现,Pre-LLM 压缩对每个模态独立操作。
1. 重要性选择(Importance Selection)
先用编码器注意力与模态特异的结构变化识别主导 token。最后一层模态编码器的注意力统计提供 token 中心性的基础估计:
测量每个 token 从所有其他模态 token 收到的平均注意力,得到注意力中心性向量 。
但注意力本身可能忽略瞬态结构变化,因此用模态特异的变化线索加以精炼。对视频,令 为第 帧、空间位置 的 token,定义相邻帧变化与空间独特性:
其中 为每帧空间 token 数。两个线索分别刻画帧间变化与空间独特性。对音频,令 为时间索引 的音频 token,相邻 token 变化定义为:
较大的 表示更强的声学边界或瞬态事件。归一化后,模态特异结构线索被加到注意力中心性向量 ,得到最终模态特异重要性向量 ,其归一化得分记为 。
由于仅按重要性选择会过度集中在少数显著区域,只把部分预算分配给主导 token:
按 排名的 top- token 构成主导集 ,其余 个由覆盖度选择决定。
2. 覆盖度选择(Coverage Selection)
为避免遥远内容被欠代表,用特征距离 + 位置距离联合选择额外代表:
其中 为音频的归一化时间距离或视频的时空距离。该联合距离同时捕获表征相似性与结构邻近性,防止特征相似但位置遥远的 token 被视为等价。 控制位置距离的贡献。
基于该联合距离应用 DPC-KNN 识别那些既能代表局部邻域、又与其他代表区域分离的 token。对每个候选 ,令 为其 个最近候选(不含自身,实验中 ),局部密度定义为:
与更高密度候选的分离度定义为:
代表性得分为 (式 16)——高分表示该 token 既代表其局部邻域、又与其他高密度区域分离。top- 候选构成 。最终 pre-LLM 保留集为:
因此重要性选择保留显著证据,覆盖度选择维持广泛的时空覆盖。
3. 相似度感知的 Token 合并(Similarity-Aware Token Merging)
不直接丢弃未选中 token,而是把其信息转移到保留的代表。令 为未选中索引集。对每个未选中 token 与保留 token ,计算亲和度并确定合并目标:
联合考虑特征相似度、位置邻近性与保留 token 的归一化重要性; 控制模态特异的位置约束, 控制代表重要性的贡献。随后每个保留 token 聚合分配给它的未选中 token:
其中 给更重要的 token 更大权重,使每个代表能聚合邻近冗余信息同时缓解信息损失。更新后的表征构成 ,与文本 token 一起送入 LLM。
阶段二:查询条件的 Inner-LLM 压缩
经过前 个 Transformer 块后, 被变换为隐状态 。此时执行查询条件的音视协同压缩。
令 为文本隐状态。将其均值池化为全局查询表征 ,将另一模态状态 池化为原型 。token 的相关性得分为:
其中 为模态内 min–max 归一化,三项分别度量文本相关性、音视协同、模态内代表性。
保留集以最高分 token 初始化:。对每个未选中 token,用 度量其相对保留集的语义多样性,随后迭代选入最佳平衡”相关性与多样性”的 token:
该过程持续到 。每个未选中隐状态被分配到其最余弦相似的保留代表,并通过相关性调制的相似度加权平均并入。压缩后的音视 token 与全部未压缩文本 token 一起通过剩余 Transformer 块。
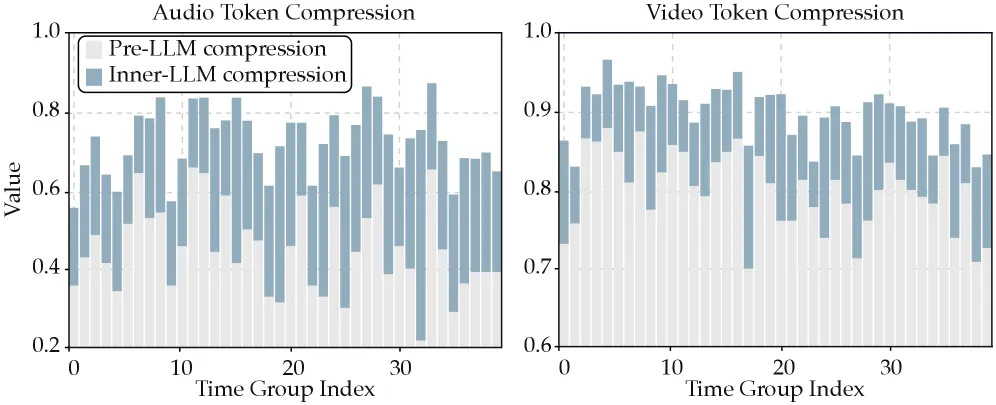
图 4: Pre-LLM 与 Inner-LLM token 压缩过程的可视化。
计算开销建模
令 为视觉与音频 token 总数, 为隐维度, 为 FFN 中间维度。每层近似为 MHA + FFN,一次乘加计为一次 FLOP。预填充每层开销约 ;自回归解码生成 个 token 的开销约 (实验取 )。对 层 LLM 与恒定序列长度 :
对跨层序列长度变化的方法,按各层有效多模态序列长度 逐层应用并求和。视觉/音频编码器、模态投影器、文本 token、token 选择操作与 LM head 被排除在统计外。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 阶段特化的渐进压缩 | LLM 前用模态特异时空结构,LLM 内用查询条件音视交互——把压缩与”表征语义成熟度”对齐 | 兼容性实验(表 7)证明两阶段策略互补且不可互换 |
| 重要性 + 覆盖度双路预算 | 仅按重要性会过集中于少数显著区域;DPC-KNN 覆盖度选择保证全局时空覆盖 | 消融(表 4):覆盖度单项在 WorldSense/LVOmniBench 上分别优于重要性 3.4%/6.1% |
| 相似度感知 Token 合并 | 不丢弃而是把未选中 token 按”特征相似 + 位置邻近 + 代表重要性”合并进保留代表,权重 | 三组件全用时在三个基准均最优;LVOmniBench 较”重要性+覆盖度”再提升 4.8% |
| 音视协同的 Inner-LLM 相关性 | 相关性得分显式含”另一模态原型”项,弥补此前 inner-LLM 方法仅靠文本引导的缺陷 | 消融(表 5):含音视协同一致优于独立压缩 |
| 文本感知引导 | 用全文本查询(全局池化 + 逐 token 最大相似)而非问题无关的通用查询或末 token 注意力 | 消融(表 6):优于 General Query 与 Last-Token Attention |
| 免训练 | 无需任何对齐训练或微调即可插入现有 Omni-LLM | 跨 3 个骨干(Qwen2.5-Omni-3B/7B、MiniCPM-o-2.6)5 个基准验证 |
五、代码实现分析
代码开源于 github.com/RowanSu/OmniPack。关键实现要点:
- 骨干:Qwen2.5-Omni-3B/7B、MiniCPM-o-2.6,NVIDIA H20 GPU;评测用 LMMs-Eval。
- 帧数:AVUT / WorldSense / DailyOmni 最多 128 帧;VideoMME / LVOmniBench 最多 768 帧。每帧最大像素预算 。
- Inner-LLM 压缩层:Qwen2.5-Omni-7B 与 MiniCPM-o-2.6 在第 18 层保留 pre-LLM token 的 50%;Qwen2.5-Omni-3B 在第 26 层。
- 超参数:、、、、DPC-KNN 的 。
- 模态预算分配(表 9):两个模型族的音视 token 化方案不同——Qwen2.5-Omni 每时间窗约产生 50 个音频 token 与 288 个视觉 token,而 MiniCPM-o-2.6 每 4096 个视觉 token 对应约 750 个音频 token。因此按各模型原生 token 化比例分配预算而非套用相同模态保留比:
| Pre-LLM 保留比 | Qwen2.5-Omni-3B/7B(Audio-intact) | Qwen2.5-Omni-3B/7B(Both-selected) | MiniCPM-o-2.6(Audio-intact) | MiniCPM-o-2.6(Both-selected) |
|---|---|---|---|---|
| 25% | 12%–100% | 20%–55% | 11%–100% | 20%–50% |
| 20% | 7%–100% | 15%–50% | 5%–100% | 15%–45% |
| 15% | – | 10%–45% | – | 10%–40% |
| 10% | – | 6%–35% | – | 5%–35% |
(每格为 –,即视觉与音频 token 的保留百分比,其 token 数加权平均近似匹配 。)
六、实验结果
基准与设置
五个音视理解基准(覆盖音频中心与视频中心、短视频与长视频、感知到推理):
| 基准 | #视频 | #QA 对 | 时长(秒) |
|---|---|---|---|
| AVUT | 691 | 1,734 | 69.1 |
| WorldSense | 1,662 | 3,172 | 140.7 |
| DailyOmni | 684 | 1,197 | 43.2 |
| VideoMME | 900 | 2,700 | 1,017.9 |
| LVOmniBench | 275 | 1,014 | 2,069.7 |
对比方法:图像类 FastV、VisionZip;视频类 FastVID、VidCom2;全模态 OmniZip、OmniSIFT∘、SEATS;以及 Random。FastV-om / VisionZip-om 是把原方法扩展到视频与音频 token 的版本;OmniSIFT∘ 仅保留其推理期压缩策略而不做对齐训练;SEATS† 用原始配置,SEATS⋆ 关闭后期层 token 移除(两者只在 28 层的 Qwen2.5-Omni-7B 与 MiniCPM-o-2.6 上评测,因 SEATS 官方仅提供 28 层架构的层选择调度)。
主结果(Qwen2.5-Omni-7B,表 1)
| 方法 | FLOPs (T) | 相对 FLOPs | 保留比 | AVUT | World Sense | Daily Omni | Video MME | LVOmni | 均分 | 相对性能 |
|---|---|---|---|---|---|---|---|---|---|---|
| Qwen2.5-Omni-7B(原始) | 73.2 | 100.0% | 100%/100% | 64.0 | 46.6 | 63.9 | 64.4 | 34.2 | 54.6 | 100.0 |
| Random | 14.9 | 20.4% | 25%/– | 58.7 | 43.1 | 57.1 | 65.1 | 32.1 | 51.2 | 93.8 |
| FastV-om | 19.1 | 26.1% | 100%/25% | 59.3 | 43.3 | 58.6 | 64.0 | 32.6 | 51.6 | 94.5 |
| VisionZip-om | 14.9 | 20.4% | 25%/– | 58.7 | 44.7 | 58.2 | 65.1 | 32.9 | 51.9 | 95.1 |
| FastVID | 13.6 | 18.5% | 25%/– | 58.0 | 42.8 | 58.2 | 60.1 | 33.2 | 50.5 | 92.5 |
| VidCom2 | 14.9 | 20.4% | 25%/– | 58.8 | 43.3 | 57.7 | 63.7 | 33.1 | 51.3 | 94.0 |
| OmniZip | 14.9 | 20.4% | 25%/– | 56.9 | 42.6 | 55.9 | 65.9 | 35.0 | 51.3 | 93.8 |
| OmniSIFT∘ | 14.9 | 20.4% | 25%/– | 58.4 | 42.1 | 58.0 | 65.9 | 32.5 | 51.4 | 94.1 |
| SEATS† | 11.6 | 15.8% | 25%/12.5% | 60.0 | 45.0 | 59.7 | 66.3 | 33.5 | 52.9 | 96.7 |
| SEATS⋆ | 12.5 | 17.1% | 25%/12.5% | 60.1 | 45.0 | 59.8 | 66.4 | 33.9 | 53.0 | 97.1 |
| OmniPack (w/o M) | 14.9 | 20.4% | 25%/– | 60.7 | 45.3 | 60.3 | 66.0 | 35.6 | 53.6 | 98.2 |
| OmniPack | 12.2 | 16.7% | 25%/12.5% | 61.0 | 45.3 | 60.6 | 65.7 | 35.0 | 53.5 | 98.0 |
| OmniPack | 9.8 | 13.3% | 20%/10% | 60.0 | 44.8 | 58.6 | 65.3 | 35.7 | 52.9 | 96.9 |
| OmniPack | 7.3 | 10.0% | 15%/7.5% | 58.1 | 44.6 | 58.2 | 64.7 | 35.3 | 52.2 | 95.6 |
| OmniPack | 5.0 | 6.8% | 10%/5% | 56.4 | 42.7 | 56.1 | 63.6 | 34.8 | 50.7 | 92.9 |
(“w/o M” = 不使用 inner-LLM 压缩;A%/B% 表示 inner-LLM 压缩前/后的保留比。)
关键结论: OmniPack 在所有保留比设置下都取得 SOTA。25% 保留时 OmniPack (w/o M) 保留 98.2% 原始性能;降到 15% 时,VisionZip-om 与 OmniSIFT∘ 分别只保留 91.4% 与 89.7%,而 OmniPack (w/o M) 保留 95.2%。极端压缩(10% 保留)下 OmniPack (w/o M) 仍以 8.2% FLOPs 保留 93.0% 性能,优于两个 SEATS 变体与 VisionZip-om。加入 inner-LLM 压缩后,在 15%/7.5% 与 10%/5% 设置下分别以仅 10.0% 与 6.8% 的原始 FLOPs 保留 95.6% 与 92.9% 的性能。
跨骨干泛化(表 2)
| 方法 | FLOPs (T) | 相对 FLOPs | 保留比 | 均分 | 相对性能 |
|---|---|---|---|---|---|
| Qwen2.5-Omni-3B(原始) | 37.4 | 100.0% | 100%/100% | 53.5 | 100.0 |
| VisionZip-om | 3.9 | 10.5% | 15%/– | 48.6 | 90.8 |
| OmniSIFT∘ | 3.9 | 10.5% | 15%/– | 47.0 | 87.9 |
| OmniPack | 3.4 | 9.0% | 15%/7.5% | 49.6 | 92.7 |
| MiniCPM-o-2.6(原始) | 73.2 | 100.0% | 100%/100% | 47.5 | 100.0 |
| VisionZip-om | 8.9 | 12.1% | 15%/– | 47.2 | 99.4 |
| SEATS† | 6.9 | 9.5% | 15%/7.5% | 46.7 | 98.3 |
| SEATS⋆ | 7.5 | 10.3% | 15%/7.5% | 46.6 | 98.1 |
| OmniPack | 7.3 | 10.0% | 15%/7.5% | 47.9 | 100.8 |
在 Qwen2.5-Omni-3B 上以 9.0% FLOPs 保留 92.7% 性能;在 MiniCPM-o-2.6 上以 10.0% FLOPs 达到 100.8% 原始性能(超过原模型),优于所有现有压缩方法。
效率分析(表 3,NVIDIA H20)
| 方法 | Token 保留(Pre/Final) | FLOPs (T)↓ | 预填充 (秒)↓ | 均分↑ |
|---|---|---|---|---|
| Vanilla | 100% | 73.2 (1.0×) | 1.512 (1.0×) | 54.6 |
| FastV-om | 100%/25% | 19.1 (3.8×) | 0.415 (3.6×) | 51.6 |
| OmniZip | 25%/– | 14.9 (4.9×) | 0.360 (4.2×) | 51.3 |
| VisionZip-om | 25%/– | 14.9 (4.9×) | 0.382 (4.0×) | 51.9 |
| OmniSIFT∘ | 25%/– | 14.9 (4.9×) | 0.434 (3.5×) | 51.4 |
| SEATS† | 25%/12.5% | 11.6 (6.3×) | 0.348 (4.3×) | 52.9 |
| SEATS⋆ | 25%/12.5% | 12.5 (5.9×) | 0.375 (4.0×) | 53.0 |
| OmniPack (w/o M) | 25%/– | 14.9 (4.9×) | 0.396 (3.8×) | 53.6 |
| OmniPack | 25%/12.5% | 12.2 (6.0×) | 0.504 (3.0×) | 53.5 |
| OmniPack | 20%/10% | 9.8 (7.5×) | 0.424 (3.6×) | 52.9 |
| OmniPack | 15%/7.5% | 7.3 (10.0×) | 0.339 (4.5×) | 52.2 |
关键发现:在 15%/7.5% 设置下,OmniPack 保留 95.6% 性能,即使保留的 token 显著更少,仍优于所有 25% 保留比的 pre-LLM 压缩方法——FLOPs 降低 10.0×,预填充加速 4.5×。
消融实验
Pre-LLM 三组件(表 4,15% 保留,无 inner-LLM):
| Importance | Coverage | Merge | WorldSense | VideoMME | LVOmniBench |
|---|---|---|---|---|---|
| ✓ | 41.7 | 62.0 | 32.7 | ||
| ✓ | 43.1 | 63.3 | 34.7 | ||
| ✓ | 41.7 | 63.9 | 33.7 | ||
| ✓ | ✓ | 44.4 | 64.5 | 33.3 | |
| ✓ | ✓ | 41.9 | 62.4 | 32.1 | |
| ✓ | ✓ | 44.2 | 62.7 | 34.1 | |
| ✓ | ✓ | ✓ | 44.6 | 64.7 | 34.9 |
覆盖度选择是单项最强组件(相对重要性在 WorldSense/LVOmniBench 上 +3.4%/+6.1%)。重要性 + 覆盖度较仅覆盖度在 WorldSense/VideoMME 再 +3.0%/+1.9%。三者全用在三基准均最优,LVOmniBench 较”重要性+覆盖度”再 +4.8%,证明三组件角色互补。
音视协同(表 5)与文本引导机制(表 6):
| 配置 | AVUT | WorldSense | DailyOmni |
|---|---|---|---|
| w/o 音视协同 | 57.8 | 44.5 | 57.8 |
| w/ 音视协同 | 58.1 | 44.6 | 58.2 |
| General Query | 57.7 | 44.6 | 58.1 |
| Last-Token Attention | 57.9 | 44.5 | 58.2 |
| OmniPack(文本感知引导) | 58.1 | 44.6 | 58.2 |
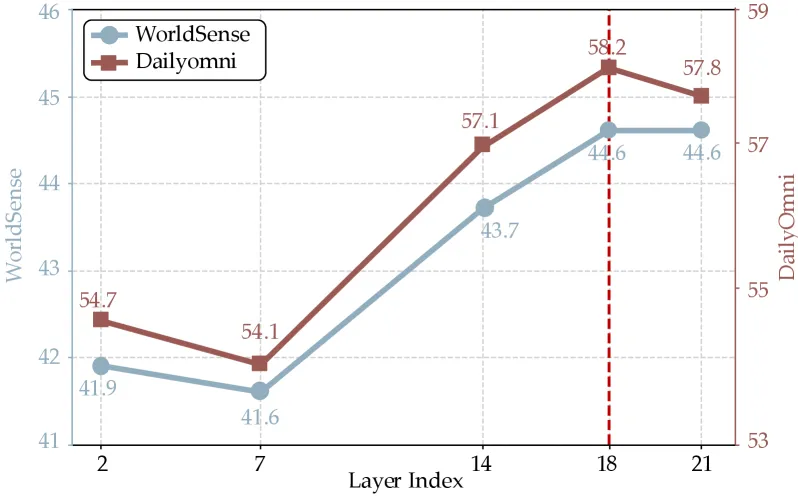
图 3: Inner-LLM 压缩层的影响。过早应用会限制任务条件多模态交互,过晚则削减计算收益。第 18 层取得最佳整体性能,故设为默认。
音视协同一致优于独立压缩(更好地保留互补跨模态信息)。相比问题无关的通用查询与末 token 引导,文本感知引导从完整文本查询聚合更丰富的语义线索,取得最佳整体性能。
两阶段策略兼容性(表 7):
| ID | Pre-LLM | Inner-LLM | AVUT | WorldSense | DailyOmni | VideoMME | LVOmniBench | 均分 |
|---|---|---|---|---|---|---|---|---|
| – | Vanilla | – | 64.0 | 46.6 | 63.9 | 64.4 | 34.2 | 54.6 |
| 1 | VisionZip-om | Ours | 56.2 | 42.9 | 56.6 | 61.7 | 31.1 | 49.7 |
| 2 | OmniSIFT∘ | Ours | 53.5 | 41.0 | 53.7 | 64.0 | 32.3 | 48.9 |
| 3 | SEATS† | Ours | 57.4 | 43.1 | 57.4 | 63.7 | 33.1 | 50.9 |
| 4 | Ours | SEATS⋆ | 58.0 | 44.7 | 57.8 | 64.7 | 33.9 | 51.8 |
| – | Ours | Ours | 58.1 | 44.6 | 58.2 | 64.7 | 35.3 | 52.2 |
把本文 inner-LLM 压缩与 VisionZip-om / OmniSIFT∘ / SEATS† 配对都一致不如完整 OmniPack;把本文 inner-LLM 换成 SEATS⋆ 也降低均分并使五基准中三个退化。两个阶段特化策略互补且需协同工作。
参数敏感性(图 6、表 15): 在两模态间取得良好平衡。跨三基准, 变化最多带来 1.0 分差异, 与 引起的变化分别在 0.5 与 0.2 分以内。所有测试配置都一致优于现有方法,说明增益不依赖精细调参。
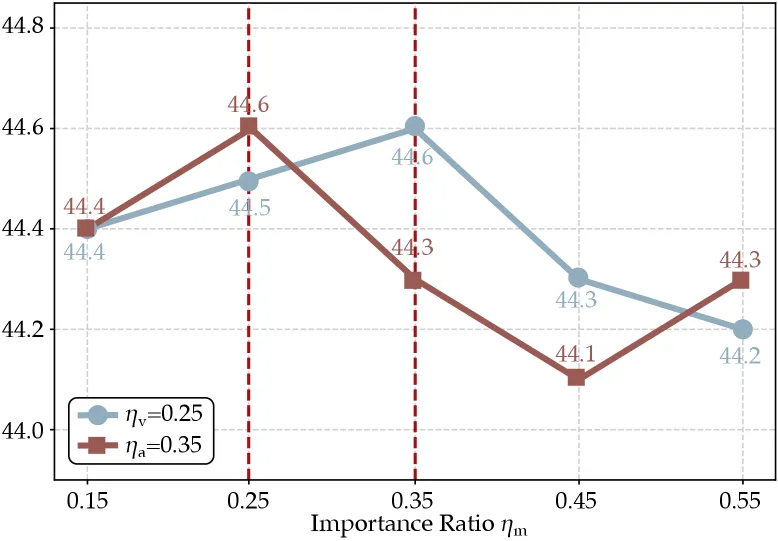
图 6: 重要性比例 的敏感性分析。
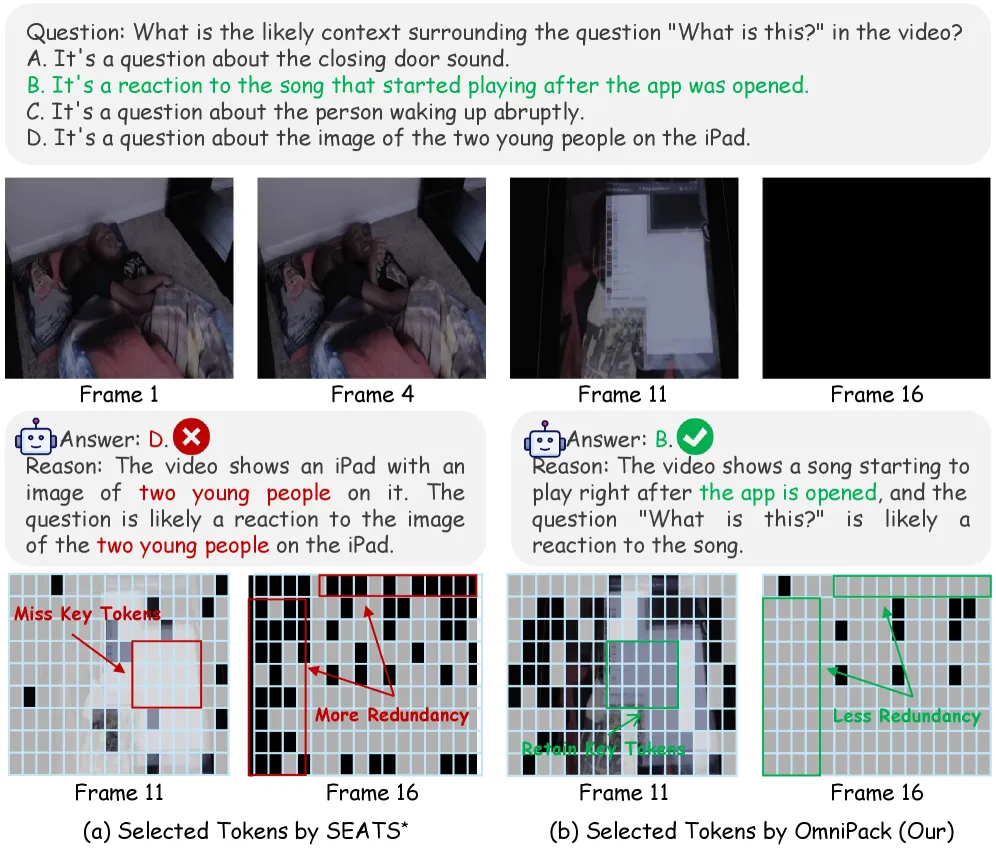
图 5: 25% pre-LLM 保留比下的定性对比。(a)SEATS⋆ 漏掉关键证据等失败模式。
七、相关工作
Omni-LLMs。 多模态大模型正从 VLM 快速演进到 Omni-LLM。相较早期视觉中心模型,Omni-LLM 能在统一框架内无缝处理文本、图像、视频与音频,支撑音视理解、实时对话助手与多模态 agent。代表模型包括 Gemini 3.1 Pro、GPT-4o、Qwen2.5-Omni 与 MiniCPM-o。但密集音视输入引入巨大 token 与算力开销,高效推理是实际部署的必要条件。
Omni-LLM 中的 Token 压缩。 token 压缩在图像、视频、音频输入上已被广泛研究。随 Omni-LLM 发展,近期工作扩展到联合音视输入:OmniZip 提出音频引导的视频 token 压缩;OmniSIFT 结合时空视频压缩与视觉引导的音频选择;EchoingPixels、ContextGuard、OmniRefine 分别研究联合音视上下文化、跨模态可恢复性与对齐压缩单元;OmniDrop、SEATS 探索 LLM 内的渐进式查询引导剪枝。
本文差异。 现有方法要么在充分音视交互建立之前引入跨模态引导,要么在 LLM 内剪枝时缺乏显式音视协同。结果是难以同时保留模态特异结构与利用任务相关语义,激进压缩下尤为明显。这一空白促成了本文”结构感知 pre-LLM 压缩 + 查询条件音视 inner-LLM 压缩”的统一框架。
八、总结
核心贡献
- 识别现有 Omni-LLM 压缩在激进 token 预算下的局限:长程音视结构建模不足、查询条件跨模态证据利用不充分。
- 提出 OmniPack:免训练的渐进框架,结合模态特异 pre-LLM 压缩与查询条件 inner-LLM 压缩,并把被移除的信息合并进保留代表而非直接丢弃。
- 跨多个 Omni-LLM 与基准的实验:在大幅降低计算与加速推理的同时保持强多模态理解能力。
技术影响
OmniPack 的核心贡献在于提出了**“压缩阶段应与表征语义成熟度匹配”这一设计原则,并给出了可操作的实现:编码器输出侧用结构线索(时间/空间变化 + DPC-KNN 覆盖),LLM 中层用语义线索(文本相关 + 跨模态原型 + 模态内代表性)。这一”阶段特化”思路可推广到更广泛的多模态高效推理场景。作为免训练**方法,它可直接插入现有 Omni-LLM 部署栈,在 6.8%–16.7% FLOPs 区间提供 92.9%–98.0% 的性能保持,实用价值明确。相似度感知合并(而非丢弃)也为”压缩即信息重分配”提供了简洁范式。
局限性与讨论
- 推理开销的权衡:从表 3 可见,OmniPack 在 25%/12.5% 设置下预填充耗时 0.504 秒,反而高于 SEATS†(0.348 秒)甚至 Vanilla 之外的多数基线——尽管 FLOPs 更低(12.2T vs 11.6T 相近)。这说明 DPC-KNN、迭代式多样性选择等选择操作本身的实际耗时并未计入 FLOPs 统计(论文明确排除了 token 选择操作),在较高保留比下可能抵消部分理论收益。只有到 15%/7.5%(0.339 秒)才实现最佳墙钟加速。
- 超参数数量:引入 、、、、、压缩层 等多个超参数,尽管敏感性分析显示鲁健(变化在 0.2–1.0 分内),但需按骨干与模态 token 化比例分别配置(表 9)。
- inner-LLM 压缩层依赖架构深度:Qwen2.5-Omni-7B/MiniCPM-o-2.6(28 层)用第 18 层,Qwen2.5-Omni-3B(36 层)用第 26 层,需按模型手工确定。
- 比较公平性说明:SEATS 变体只在 28 层骨干上评测(官方配置未覆盖 36 层);OmniSIFT∘ 去掉了原方法的对齐训练以便与免训练方法比较——这些取舍在附录 C 已透明说明,但意味着与原始 OmniSIFT 的完整能力并非直接对比。
- 论文未讨论:解码阶段(decoding)的实际加速、KV cache 显存节省的实测数据、以及在流式/实时全双工场景下的适用性。
九、参考资源
- arXiv:https://arxiv.org/abs/2608.03812 (PDF:https://arxiv.org/pdf/2608.03812)
- HTML 版:https://arxiv.org/html/2608.03812v1
- HuggingFace Papers:https://huggingface.co/papers/2608.03812
- 代码:https://github.com/RowanSu/OmniPack
- 骨干模型:Qwen2.5-Omni(arXiv:2503.20215)、MiniCPM-o-2.6
- 关键对比方法:FastV(ECCV 2024)、VisionZip(CVPR 2025)、FastVID(NeurIPS 2025)、VidCom²(EMNLP 2025)、OmniZip(CVPR 2026)、OmniSIFT(ICML 2026)、SEATS
- 基准:AVUT、WorldSense、DailyOmni、VideoMME、LVOmniBench;评测框架 LMMs-Eval