Bole: Efficient Tree Speculation for Hybrid-Attention Language Models
内核-运行时协同设计:通过闭式树验证、值域分块GPU核和因子化推测状态,将混合注意力LLM的树投机解码吞吐量提升至自回归解码的4.72×
Bole: Efficient Tree Speculation for Hybrid-Attention Language Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Bole: Efficient Tree Speculation for Hybrid-Attention Language Models |
| 作者 | Li Wang, Yi Su, Xiabao Wu, Chiran You, Yongchao Liu, Zhan Qiu, Juelu Zhang, Jiajun Zheng, Fangxin Liu, Jie Zhang, Chen Tian, Chengying Huan |
| 机构 | 蚂蚁集团(推测,基于作者背景) |
| 论文 | arXiv:2608.01651 |
| 代码 | 基于 SGLang 集成(约6.2k 行 Python/Triton 代码) |
| 发布 | 2026-08-03(cs.DC / cs.CL / cs.LG) |
| 许可 | arXiv.org perpetual non-exclusive license |
二、核心思想
问题定义
混合注意力大语言模型(如 Qwen3.5)通过交替使用全注意力层和递归线性注意力层(Gated DeltaNet, GDN)来降低长上下文推理成本。然而,这类模型的自回归解码仍然是内存受限的——每次调用一次前向传播只生成一个 token,GPU 的大部分算力闲置。
树投机解码(Tree Speculative Decoding)通过轻量级起草器(如 MTP 或 EAGLE)构建树形提案,再由目标模型一次性评分所有节点,从而在硬件高效区间内”近乎免费”地获得额外 token。但现有树投机系统是为全注意力模型的 KV-cache 设计的,在混合模型上存在三个根本性缺陷:
-
L1(串行递推):线性注意力验证时间随树大小快速增长。现有引擎必须逐个节点遍历树并应用递推,即使所有提案 token 都已就绪,仍造成 个串行递归步。树从8增长到64节点时,线性层的目标前向占比从4%飙升到27%。
-
L2(状态快照爆炸):采样前不知接受路径,现有引擎必须为每个树节点物化完整的 post-update GDN 状态。这些快照随批大小 和树大小 线性增长—— 时, 消耗 72 GiB 快照,而 Bole 的因子仅 1 GiB 以下。Bole 将每节点瞬态开销降低 82–99×。
-
L3(硬件依赖的效率天花板):roofline 模型表明,在硬件特定的阈值之后,额外树 token 不再”免费”——A100 约 128 行、GB10 约 256 行。固定或平台无关的容量设置不可靠。
解决方案概述
Bole 提出内核-运行时协同设计,通过三大技术互补解决上述缺陷:
- 闭式树验证(解决 L1):将线性注意力递推转化为全节点闭式表达(定理1),用值域分块 GPU 核并行验证所有提案节点
- 因子化推测状态(解决 L2):将推测状态更新无损编码为 token 级因子(),仅重建采样后接受路径的精确状态,瞬态状态内存降低 82–99×
- 硬件感知的批级验证预算(解决 L3):离线校准完整混合前向的批级容量,运行时按累计起草概率在全局范围内分配
三者集成到 SGLang 生产推理引擎,实现端到端 4.72× 离线吞吐提升(vs AR),2.03×(vs 最强基线),在线 Agent 负载 TTFT 和 TPOT 分别降低 67.6% 和 49.9%。
三、技术架构
整体框架图
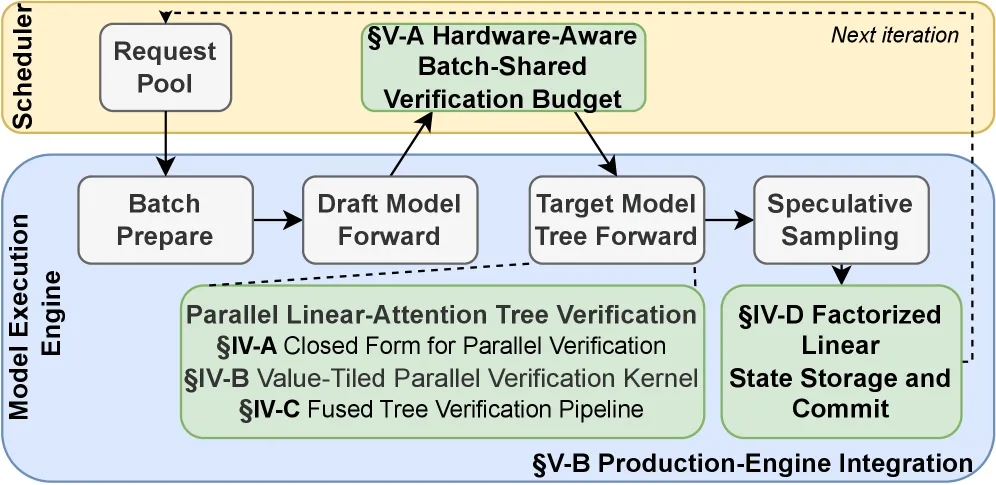
Bole 的工作流程分为一次性校准和循环服务:
一次性校准阶段
┌──────────────────────────────────────┐
│ 离线 Profiler                         │
│ 对每个配置 c(模型/GPU/批大小/KV桶)   │
│ 扫描总节点数 N ∈ G                   │
│ 记录 T_ver(N|c),选取 B_ver(c)       │
│   使 T_ver(N|c) ≤ (1+ε)·T_dec(c)     │
└──────────────────────────────────────┘
                    ↓
循环服务(每目标迭代)
(1) 调度器批处理活跃请求 + 读取预校准容量
(2) 起草器为每请求生成候选树,调度器裁剪不超过批预算
(3) 目标验证所选树:全注意用树掩码,GDN 用 Bole 并行路径
(4) 采样后保留接受 KV 并提交匹配的线性注意力状态
Gated DeltaNet 递归核心
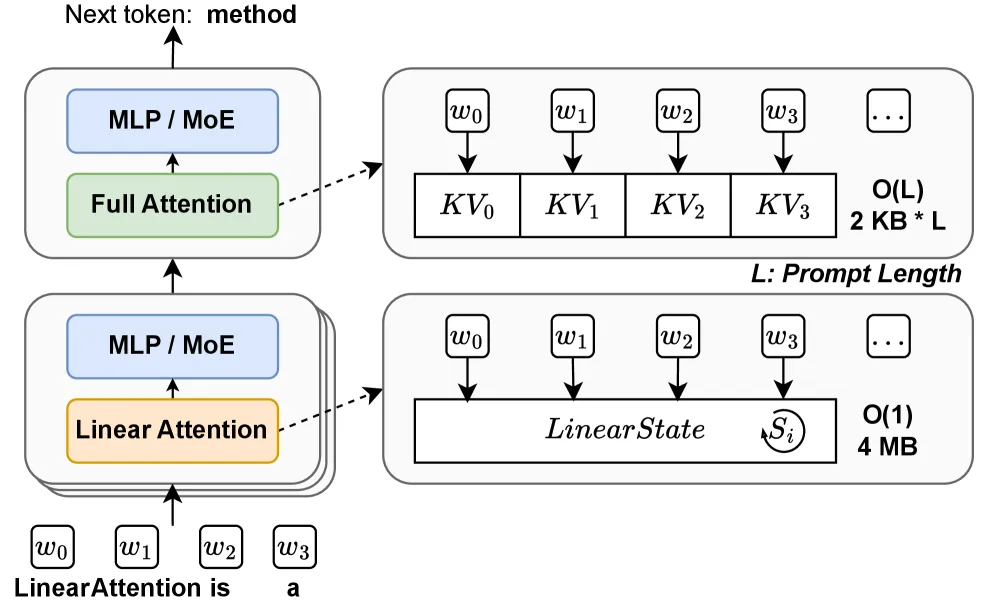
一个 GDN 状态头的递推规则():
其中 ,, 和 为衰减和写入门。关键问题: 依赖 ,普通解码必须按 token 顺序执行。
树投机解码
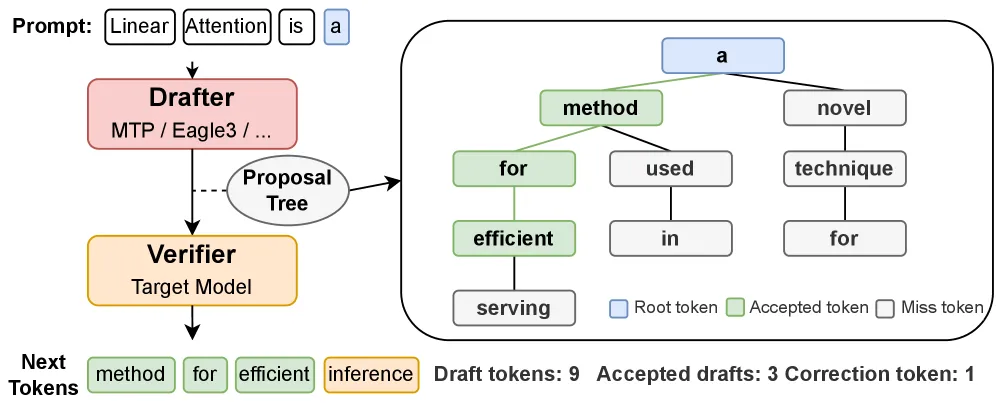
每个提案节点是一个起草 token,每条根到节点路径是一条候选延续,分支复用共享前缀。祖先掩码限制每节点只能看到已提交前缀和自身提案祖先。采样提交一条接受路径和一个目标采样的校正 token,丢弃其余分支。**平均接受 token 数(MAT)**是衡量每轮进度的关键指标。
核心创新公式:闭式树验证(定理 1)
Bole 的核心数学贡献是将序列递推转化为代数上精确的全节点闭式。证明分三步:
引理 1(路径因子化状态):对每节点 ,令 为从根到 的衰减累积积。则:
其中 为共享的树前状态, 为 的严格提案祖先集合。
引理 2(祖先掩码校正系统):堆叠所有节点得到线性系统:
其中 为堆叠的 , 由祖先掩码、衰减比和门构成, 为局部 delta。 是严格下三角矩阵(父节点在子节点之前排序)。
引理 3(深度有界幂零性): 是深度有界幂零的——( 为最大严格祖先数),因此:
逆矩阵精确地是一个有限多项式(Neumann 级数),无截断误差。
定理 1(Bole 闭式树验证):
该恒等式代数上精确,等价于序列执行,但完全不需要逐节点状态或逐节点遍历。 是共享状态的衰减读出, 形成局部 delta, 沿祖先传播, 执行全部读出。
值域分块 GPU 核
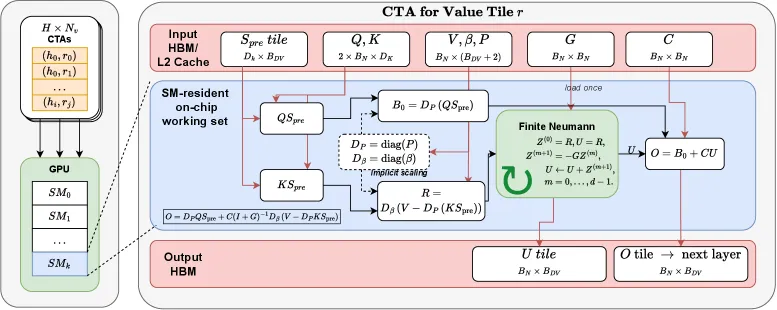
将 列划分为 个值域块,每个 CTA 处理一个值块:
片上有限 Neumann 计算(每 CTA,固定步骤):
所有 轮在片上完成, 原地更新,无需节点遍历或 HBM 中间流量。因子 仅依赖树拓扑和 门,与值通道无关,在 个 CTA 间共享,摊销 的 Gram 构造。
两维资源平铺:值块宽 (平衡每 CTA 效率 vs CTA 并发度),键块宽 (单阶段软件流水)。一个 CTA 的工作集被约束为 。
因子化推测状态
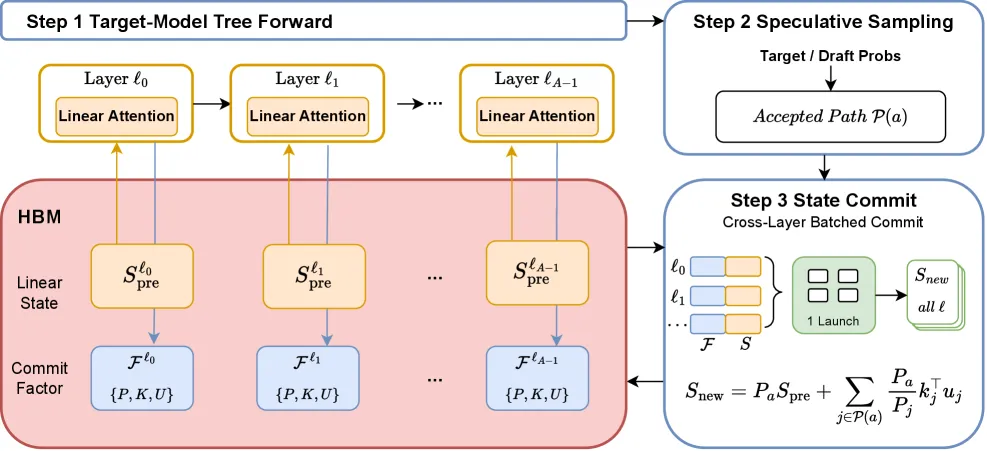
Bole 维持每个活跃请求每层的单一不可变规范状态 ,用 token 级因子 表示候选分支,空间复杂度降为:
对比全状态方案 。当 时,每分支全状态成本 ,因子化节点仅 ,优势随状态维度增长而非依赖树形状。
采样后,接受路径 的精确状态由一次张量核矩阵乘法重建(Lemma 1):
拒绝的分支不消耗状态缓存槽位, 在层间复用为短寿命 scratch,不参与持久序列状态。
融合树验证流水线
Bole 组织为一个轮级拓扑预处理 + 三个每层 GPU 阶段:
- 树并行卷积与门准备:每节点沿父节点链接融合卷积、bias、SiLU 和门准备,所有节点并发执行
- 因子构造:每层每头一个 producer 构建 , 个 CTA 共享
- 值域分块求解与读出:CTA 计算 和有限 Neumann 递推产出 和紧凑 提交因子
硬件感知的批级验证调度
完整混合前向延迟可分解为:
其中 依赖节点数和 KV 长度, 依赖节点数和树深, 和 依赖总节点数 。离线校准选取:
运行时,每节点评分 (路径累计起草概率),在全局范围内选择最高分节点填充校准容量。单调性保证:子节点累计概率不超过父节点,因此每个请求所选节点天然前缀连通,无需额外修复。
SGLang 生产集成
- 约 6.2k 行 Python/Triton 代码
- CUDA Graph-native 打包森林:变长树拓扑打包为一个 flat-ragged forest,固定地址和核形状,容量桶化的 CUDA Graphs 跨轮次复用
- 统一跨层状态提交:每递归层将 因子写入预分配连续 GPU 缓冲区,单次 batched launch 计算公式 (10)
- 无气泡 GPU 执行:选择→森林构建→目标执行→采样→路径压缩→KV/GDN 状态提交全在 GPU 端,CPU 调度器准备后续工作
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 定理1:闭式树验证 | 将 GDN 序列递推转化为精确全节点闭式,证明依赖三个引理:路径因子化、祖先掩码线性系统、深度有界幂零性 | 代数上精确等价于序列执行,彻底消除父→子关键路径 |
| 值域分块 GPU 核 | 沿 分块,每 CTA 处理一个值块,共享树因子 ,片上完成有限 Neumann 递推 | Table VII: 3.4–7.7× 加速,占用率提升 3.6–7.9×,L1/shared 吞吐提升 1.8–4.1× |
| 因子化推测状态 | 单一不可变规范状态 + token 级因子 ,空间复杂度从 降为 | Table I: 82–99× 瞬态内存降低(4.7–14.1 GB→57–151 MB),Table VI: 额外开销降低 74–88.5% |
| 硬件感知验证预算 | 离线校准完整混合前向的批级容量(公式12),运行时全局累计概率分配 | 单固定预算在跨 GPU 架构下次优(A100峰值128 vs GB10峰值256) |
| 累计概率前缀连通性 | 子节点概率不超过父节点→所选节点天然前缀连通,无需修复 pass | 保证每请求所选树连通,简化调度 |
五、代码实现分析
代码规模:约 6.2k 行 Python/Triton 代码集成到 SGLang,包含:
- 并行验证核(Triton,可移植到其他推理引擎)
- SGLang GDN 后端、EAGLE 循环、CUDA Graph runners、线性状态池的深度优化
- 设备端打包森林构建器(flat-ragged forest)
- 统一跨层状态提交缓冲区
关键实现选择:
- 最大深度固定为 8,top- = 4
- 使用各模型原生 MTP 头作为起草器
- 未量化权重
- 仅 Qwen3.5-122B-A10B 使用 NVLink 连接张量并行(TP4)
- CUDA Graph 在每容量桶内跨树拓扑复用固定地址和核形状
六、实验结果
实验设置
| 平台 | 配置 |
|---|---|
| A100 | 4× NVLink A100 80 GB SXM4,312 TFLOP/s,2.04 TB/s HBM2e |
| GB10 | DGX Spark,GB10 Grace Blackwell,256 TFLOP/s,128 GB LPDDR5x @273 GB/s |
模型:Qwen3.5-4B/9B/27B/122B-A10B(从4B到122B,覆盖单卡到 TP4)
基线:SGLang-AR(自回归)、SGLang-Tree(原生树投机)、AdaServe(移植优化的 SOTA 树投机系统)
任务:MBPP(代码)、ShareGPT(对话)、GSM8K(数学推理)、CNN/DailyMail(摘要)、Open-SWE-Traces(在线 Agent)
端到端解码吞吐量
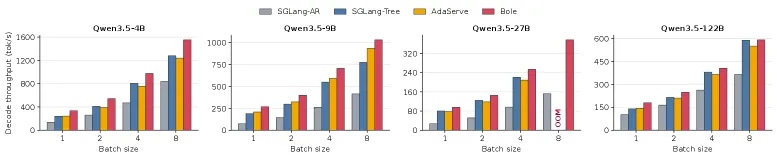
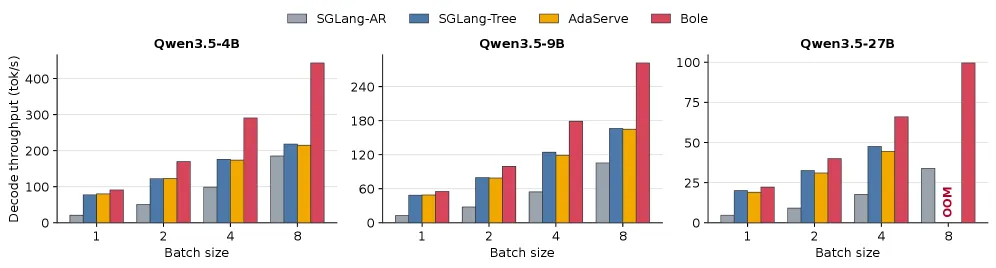
| 指标 | 数值 |
|---|---|
| vs SGLang-AR 几何平均加速 | 2.74× |
| vs 最强投机基线几何平均加速 | 1.26× |
| A100 峰值 vs AR/Tree/AdaServe | 3.62× / 1.41× / 1.39× |
| GB10 峰值 vs AR/Tree/AdaServe | 4.72× / 2.03× / 2.06× |
| GB10 加速在 → | 1.11–1.14× → 1.70–2.03×(越大批加速越显著) |
跨任务泛化性
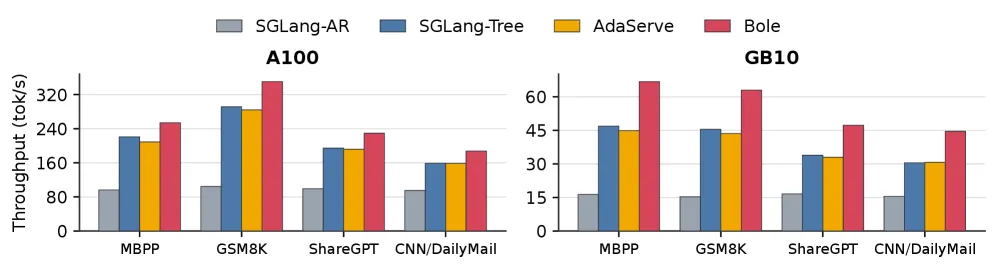
| 数据集 | MAT (Bole) | vs SGLang-AR A100 | vs SGLang-AR GB10 | vs 基线 A100 | vs 基线 GB10 |
|---|---|---|---|---|---|
| MBPP | 6.70 | — | — | — | — |
| GSM8K | 7.08 | — | — | — | — |
| ShareGPT | 5.51 | 1.98–3.36× | 2.85–4.12× | 1.15–1.20× | 1.38–1.45× |
| CNN/DailyMail | 4.98 | — | — | — | — |
Bole 在所有四个模型上持续获得高于两个基线的 MAT(Table V),跨 A100/GB10 双平台稳定加速。
在线 Agent 推理(Open-SWE-Traces)
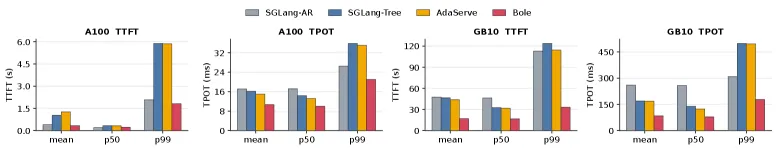
| 对比 | 平均 TTFT 降低 | 平均 TPOT 降低 |
|---|---|---|
| vs SGLang-AR | 15.8%–64.3% | 37.6%–67.6% |
| vs SGLang-Tree | 63.5%–67.6% | 33.8%–50.3% |
| vs AdaServe | 61.3%–73.3% | 28.9%–49.9% |
前缀缓存命中率(关键指标):
| 系统 | A100 命中率 | GB10 命中率 |
|---|---|---|
| SGLang-AR | 89.8% | 93.3% |
| SGLang-Tree | 69.7% | 58.3% |
| AdaServe | 69.3% | 59.8% |
| Bole | 90.8% | 92.6% |
Bole 回收了 21.1–34.3 个百分点的缓存命中,几乎追平 SGLang-AR 的水平——尽管仍在验证提案树。因子化状态释放了大量内存供 KV 缓存复用,避免重复 prefill,同时通过因子化降低 TPOT 又缩短队列等待时间,形成 TTFT 和 TPOT 的正向互馈。
并行验证核效率
| 平台 | 串行延迟 | Bole 延迟 | 加速 | 占用率提升 | L1/shared 提升 | |
|---|---|---|---|---|---|---|
| A100 | 1 | 174 μs | 50.6 μs | 3.4× | 1.9%→15.0% | 14.7%→60.8% |
| A100 | 16 | 822 μs | 110 μs | 7.5× | 11.4%→41.4% | 51.3%→93.5% |
| GB10 | 1 | 333 μs | 66.6 μs | 5.0× | 6.6%→43.1% | 10.1%→34.6% |
| GB10 | 16 | 3420 μs | 443 μs | 7.7× | 16.4%→58.9% | 12.5%→36.8% |
时,每层写入 9.8 MB vs 824 MB(84× 减少)。状态物化消耗串行验证时间的 38%(A100)和 86%(GB10),解释为何在 GB10 的低带宽统一内存上收益更大。因子化提交运行一次/前向,占延迟不到 0.5%。
预算敏感性
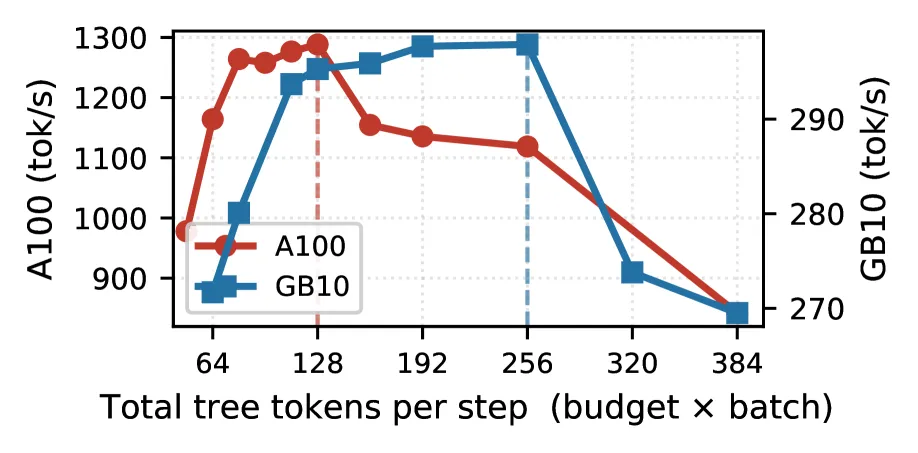
在 Qwen3.5-9B/MBPP 上:A100 峰值在 128 总树 token,GB10 在 256 token——单一固定预算在跨架构下必然次优,验证了硬件感知调度的必要性。
组件消融
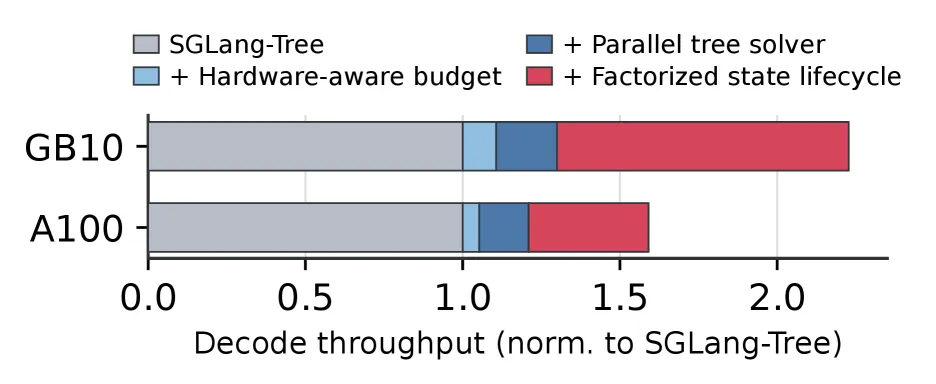
在线 Agent 负载上对 SGLang-Tree 的累计增益:
- + 硬件感知预算:A100 +5.3%,GB10 +10.7%(不改变验证器或状态表示)
- + 并行递归验证:A100 1.21×,GB10 1.30×(消除父→子执行链)
- + 因子化状态管理:A100 1.59×,GB10 2.23×(GB10 更大收益来自更紧的内存容量和缓存命中改善)
三组件协同:预算选择有用提案→并行验证高效执行→因子化保留可复用 Agent 状态。
七、相关工作
- 树投机解码:EAGLE [19] 和 MTP [8] 起草器构建提案树,多 token 预测利用自回归解码的内存受限 headroom
- 全注意力树验证:SGLang-Tree [36] 和 AdaServe [21] 基于 KV-cache 设计,在混合模型上面临三大缺陷
- 混合注意力模型:Qwen3.5 [34] 等交替全注意和 GDN 层,结合长程检索与有界递归状态
- Roofline 模型:解释了从权重带宽受限到计算受限的过渡阈值(A100 ~128行, GB10 ~256行)
- 本文定位:首个面向混合注意力 LLM 的高效树推测系统,内核-运行时协同设计
八、总结
核心贡献
- 定理1闭式树验证:严格的数学框架将 GDN 序列递推转化为代数精确的全节点闭式,证明依赖路径因子化、祖先掩码系统和深度有界幂零性三个结构步骤,完全消除父→子关键路径
- 值域分块 GPU 核:沿值维度分块 + 片上有限 Neumann 递推 + 共享树因子,实现 3.4–7.7× 验证加速、84× 中间状态减少
- 因子化推测状态:从 降为 ,瞬态内存降低 82–99×,KV 缓存命中率追平自回归解码
- 硬件感知批级预算:离线校准完整混合前向 + 运行时全局累计概率分配,A100/GB10 峰值预算分别为 128/256 树 token
- 生产级 SGLang 集成:6.2k 行代码,CUDA Graph-native 打包森林,统一跨层状态提交,在线 Agent 负载 TTFT 降低 67.6%、TPOT 降低 49.9%
技术影响
Bole 将树投机解码从全注意力模型专属扩展到混合注意力模型,而混合模型正成为长上下文推理的主流选择(Qwen3.5、GLM 等)。其内核-运行时协同设计理念——通过数学闭式(消除序列依赖)+ 值域分块(资源平铺)+ 状态因子化(内存解耦)+ 硬件感知预算(跨架构自适应)——为混合模型推理优化提供了一套可复用的方法论。
局限性
- 仅支持 Gated DeltaNet:闭式推导依赖 GDN 特定的递归结构(公式1),对其它线性注意力变体(如 Mamba/S6)需要重新推导
- 最大深度固定为 8:闭式中的幂零深度 在执行前固定,限制了更深层提案树的利用
- 起草器依赖 MTP 头:评估仅使用各模型原生 MTP 头作为起草器,未探索 EAGLE 或外部起草器在 Bole 上的增益
- 未量化权重:所有实验使用未量化权重,与真实生产环境中的量化部署存在差距
- 平台覆盖有限:仅 A100 和 GB10 两个平台,GB10 的低带宽统一内存特性放大了 Bole 收益,但结论在更高带宽 GPU(如 B200)上的泛化性未验证
- 因子化 commit 的 0.5% 开销假设:在极大批次或极深树情况下,因子化 commit 的累积开销可能不再可忽略
九、参考资源
- 论文:arXiv:2608.01651
- SGLang:github.com/sgl-project/sglang
- 关键引用:
- Qwen3.5 [34]:混合注意力模型,3× GDN + 1× 全注意力层
- EAGLE [19] / MTP [8]:树投机起草器
- AdaServe [21]:SOTA 树投机服务系统
- SGLang [36/53]:广泛部署的生产 LLM 服务引擎
- Roofline 模型 [43/50]:硬件性能分析框架
- OpenHands [42] / Open-SWE-Traces [2]:在线 Agent 评测