MiniWorld: Democratizing the Training of Video World Models from Scratch
MiniWorld 提出轻量级可复现的视频世界模型训练框架,基于块因果 Video DiT + Flow Matching + 块级非递减噪声调度 + 滚动 KV Cache 流水线异步去噪,可在单台 8-GPU 服务器上数天内完成训练
MiniWorld: Democratizing the Training of Video World Models from Scratch
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | MiniWorld: Democratizing the Training of Video World Models from Scratch |
| 作者 | Yian Zhao, Ruochong Zheng, Hongcan Guo, Yu Yan, Jian Zhang, Jie Chen |
| 论文 | arXiv:2608.01127 |
| 发布 | 2026-08-02 |
| 代码 | 完整训练/推理代码 + 预训练 checkpoint 开源 |
二、核心思想
问题定义
视频世界模型(Video World Models)通过自回归状态转移预测未来观测,是 embodied AI 和交互式仿真的基础模块。当前主流方法存在两大痛点:
- 训练成本高:依赖大规模双向视频生成模型(如 Wan),通过后训练或蒸馏改造为自回归世界模型
- 训练-推理不一致:双向预训练与因果流式推理之间存在结构性失配,导致暴露偏差和长程退化
- 缺乏可复现基线:现有系统需要复杂流水线和大量算力,普通研究者难以复现
解决方案概述
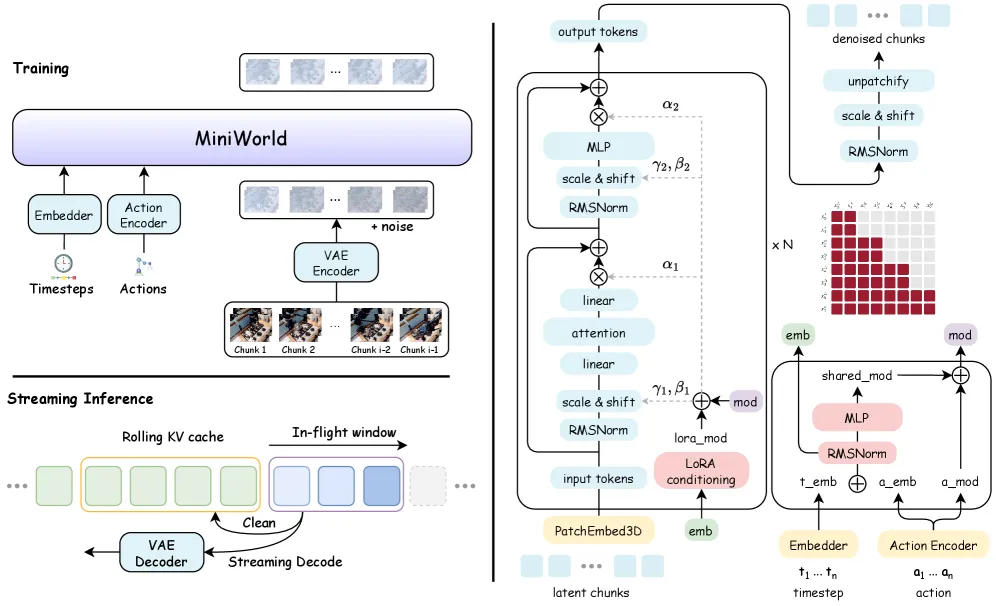
MiniWorld 提出轻量级、可复现的从头训练框架:
- 块因果 Video DiT + Rectified Flow:在 Wan2.2 VAE 潜空间训练
- 块级非递减噪声调度(CoPP):避免显式展开下一块预测,支持异步去噪
- 两阶段继续训练:21/46 帧 → 125/253 帧长上下文训练
- 滚动 KV Cache + 流水线异步去噪:流式推理下保持有界计算
关键指标:单台 8-GPU 服务器数天内完成完整训练。
三、技术架构
整体框架
核心公式
Rectified Flow 潜空间插值:
模型预测速度场 ,从高斯噪声逐步积分恢复目标潜空间序列。
Action 条件编码(AdaLN-based):
Action embedding 与扩散时间步嵌入相加,action modulation 向量残差叠加到 AdaLN 参数上。
块级非递减噪声调度(CoPP):
强制因果去噪顺序:早期块比后期块更干净,匹配流式推理的实际情况。
时间步重参数化:
长程训练阶段通过 shift factor 重新分配采样密度。
Action 归一化:
模型架构
MiniWorld 采用统一的块因果 Transformer 架构族,所有变体使用相同的块因果设计、条件接口、patch 大小和 MLP 比例,仅在深度、宽度、注意力头数和参数量上不同。
基础设计:
- 视频 VAE:Wan2.2 预训练,4× 时间压缩、16× 空间压缩,48 通道
- 3D Patch Embedding:时空联合嵌入
- Block-Causal Video DiT:块内双向注意力 + 块间因果注意力
- Action Encoder:7D 机器人动作 → AdaLN 条件(与扩散时间步嵌入相加)
- Camera Pose Encoder:相机内外参编码为 15 频率 sin/cos → 720 通道
- 滚动 KV Cache:持久化历史状态,有界计算窗口
模型配置(Table 1):
| 变体 | 深度 | 宽度 | 注意力头数 | 参数量 |
|---|---|---|---|---|
| MiniWorld-0.5B | - | - | - | 0.5B |
| MiniWorld-1B | - | - | - | 1B |
| MiniWorld-3B | - | - | - | 3B |
训练配置
- 优化器: Muon optimizer, global learning rate 1e-4
- 混合精度: bf16
- 数据增强: action condition 以 10% 概率随机丢弃(用于 CFG)
- 噪声调度: 50 个离散化训练时间分箱,单调 CoPP 时间步组合
- 时间步重参数化: SD3-style reparameterization,shift factor 由 latent tokens 数量自动确定
- 时间步采样: logit-normal distribution (Pmean=0, Pstd=1)
- 硬件: 单台 8-GPU 服务器
四、核心创新
| 创新点 | 说明 | 实验依据 |
|---|---|---|
| 块因果 Video DiT | 块内双向 + 块间因果注意力 | 消除双向预训练与因果推理的失配 |
| 块级非递减噪声调度(CoPP) | Chunk-oriented Probability Propagation | 稳定优化、加速收敛 |
| 两阶段继续训练 | 21/46 → 125/253 帧 | 平衡效率与长程能力 |
| 滚动 KV Cache | 持久化历史状态 | 保持有界计算 |
| 异步流水线去噪 | 未来块并行处理 | 流式生成效率提升 |
| 可复现基线 | 单台 8-GPU 数天训练 | 降低研究门槛 |
五、实验结果
评估协议
- 比较基线: Bidirectional short-video baseline(固定 29 帧滑动窗口 + 相同控制序列)
- 评估输入: 单帧观测 + 控制序列
- 质量评估: CFG scale=2,50 个 held-out 视频,253 帧流式 rollout
- 指标: PSNR/SSIM/LPIPS + WorldArena 风格指标(外观、动力学、几何、VLM 功能性、保真度)
- 误差指标反转: LPIPS 和深度误差取倒数,使大值表示更好性能
主要结果(DROID + RE10K)
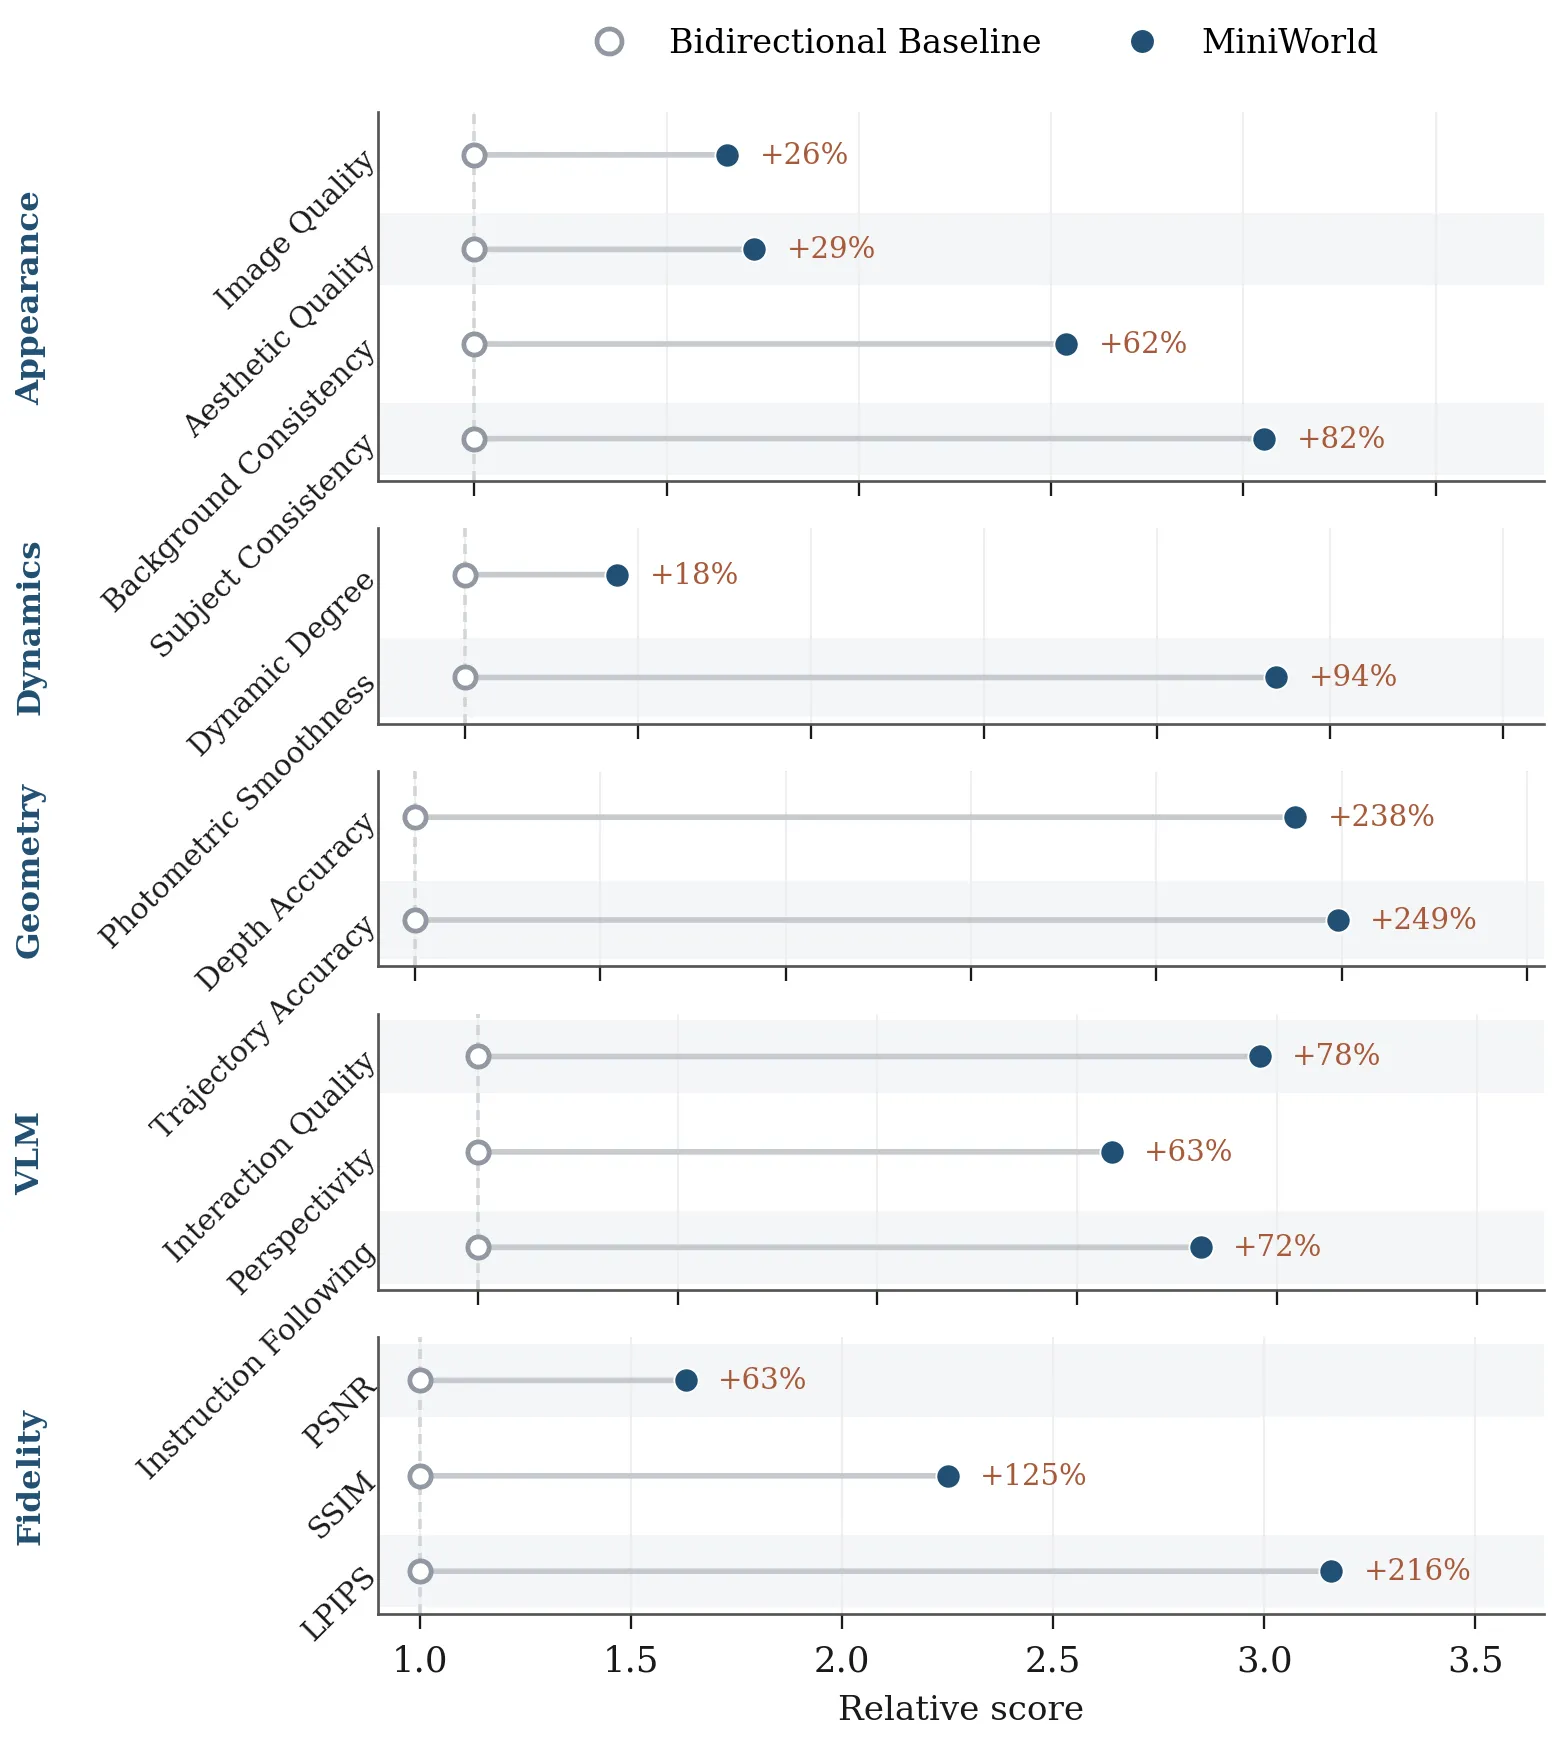
DROID(机器人动作条件,MiniWorld-1B):
| 指标 | 相对基线提升 |
|---|---|
| 轨迹准确率 (Trajectory Accuracy) | +249% |
| 深度准确率 (Depth Accuracy) | +238% |
| LPIPS | +216% |
| SSIM | +125% |
| 外观指标 (Appearance) | +26% ~ +82% |
| VLM 评分 (VLM Judge) | +63% ~ +78% |
关键洞察:MiniWorld 不仅改善单帧质量,更保留了机器人-物体几何关系,维持时间连贯的操控动力学,并产生与条件信号更一致的行为。
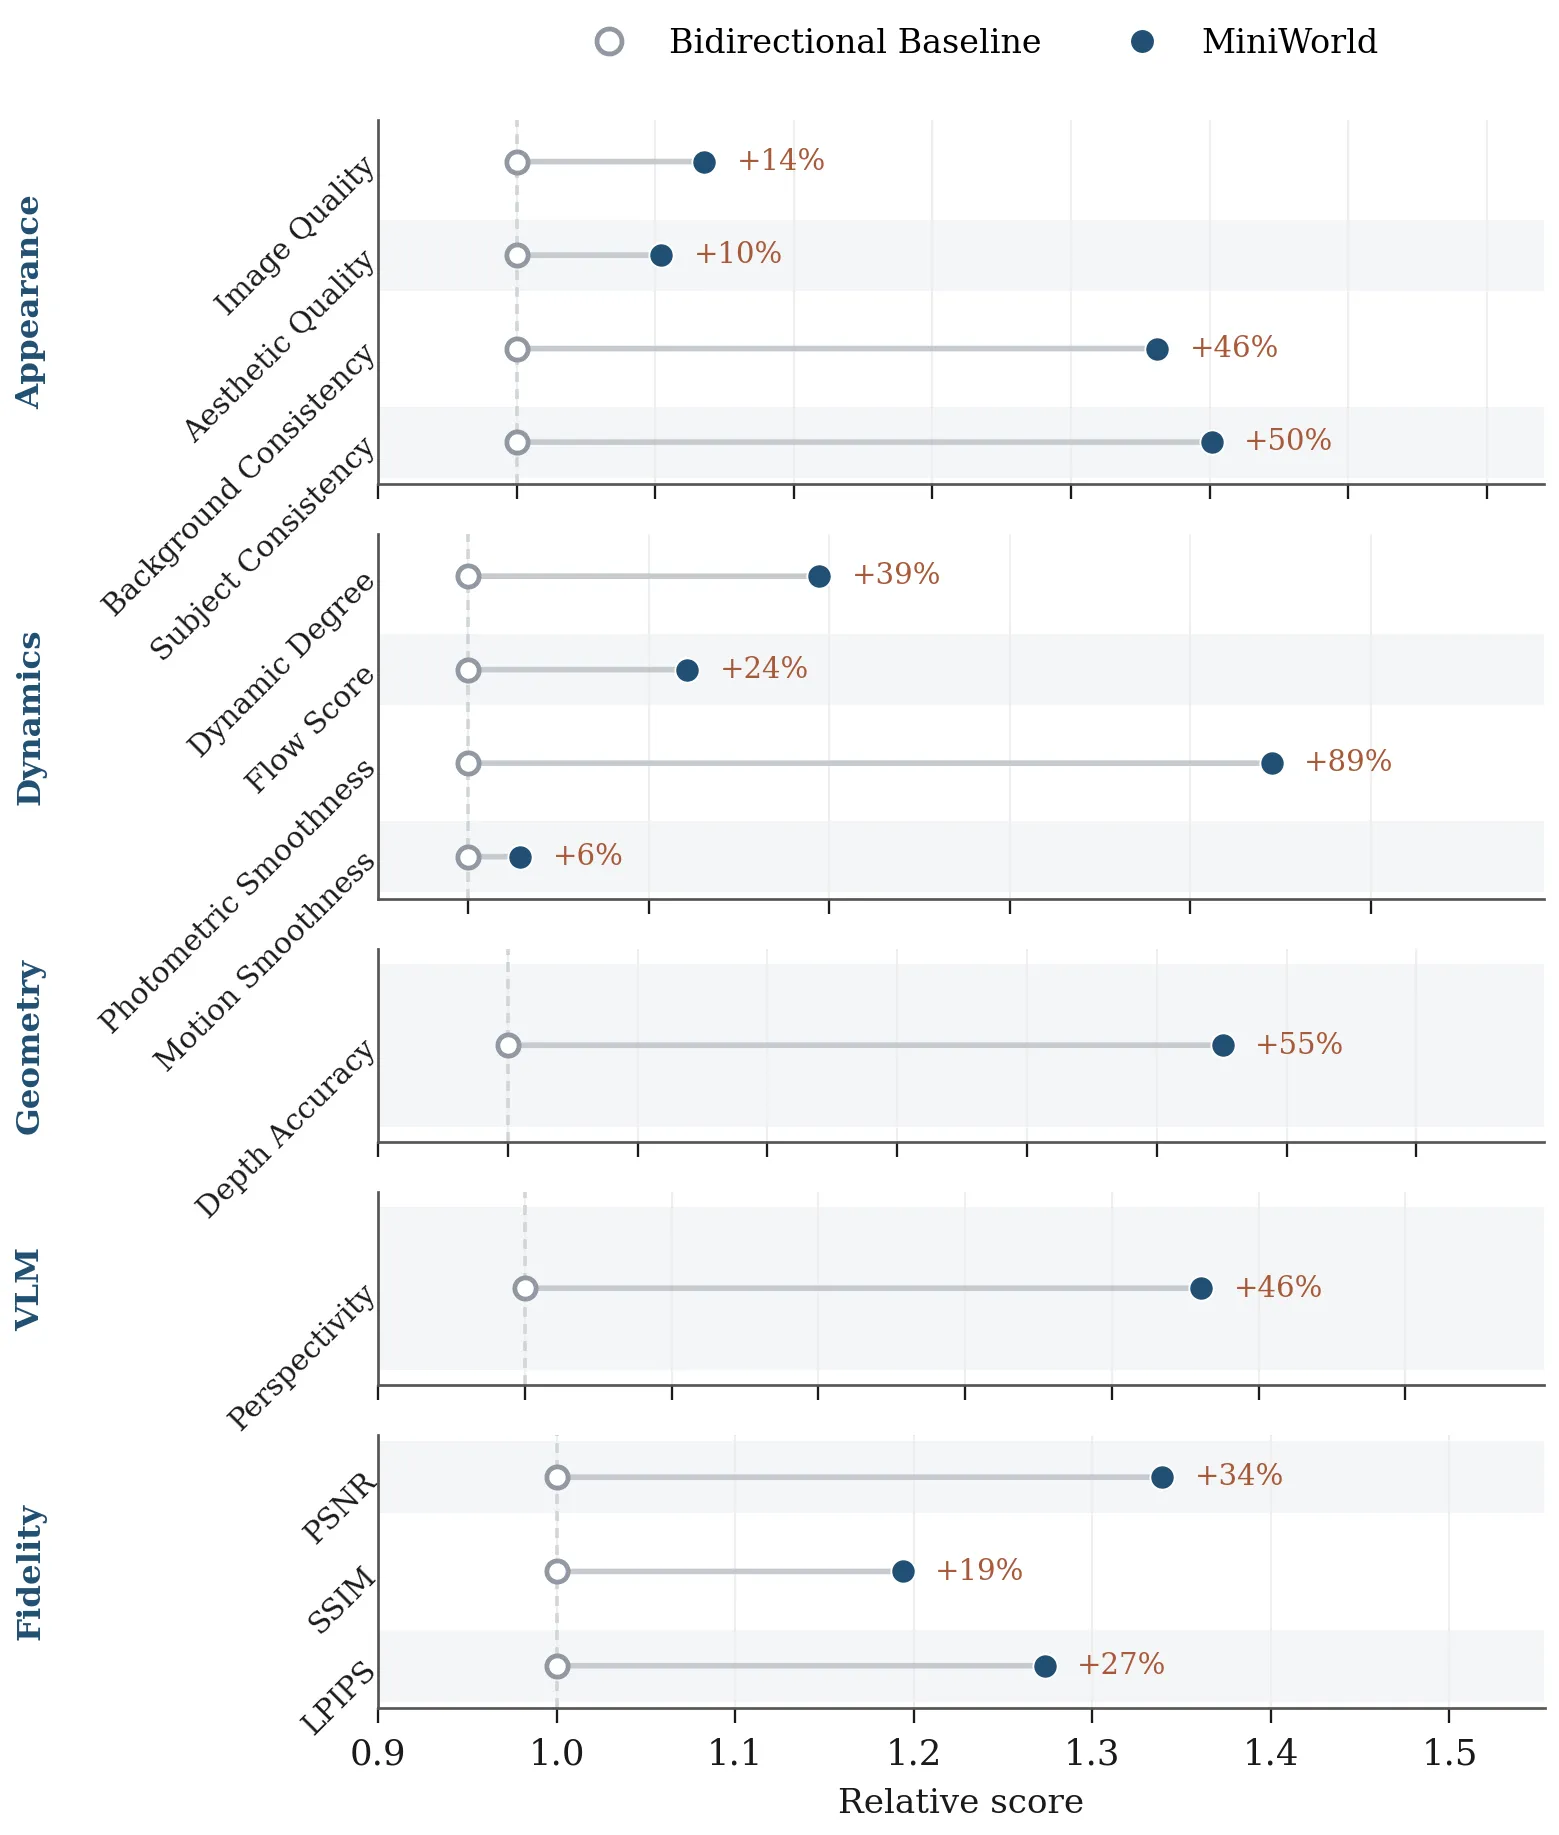
RE10K(相机控制条件):
| 指标 | 相对基线提升 |
|---|---|
| Photometric Smoothness | +89% |
| Depth Accuracy | +55% |
| Subject Consistency | +50% |
| Background Consistency | +46% |
| Perspectivity | +46% |
| PSNR / SSIM / LPIPS | +34% / +19% / +27% |
跨域迁移验证:同一架构从 action-conditioned 操作域成功迁移到 camera-controlled 场景预测,无需 dataset-specific 评估 artifact。
消融实验
CFG 影响:平均 +5.5%,外观 +9.9%、动力学 +11.8%,保真度基本不变 → CFG 作为质量调节旋钮而非效率来源。
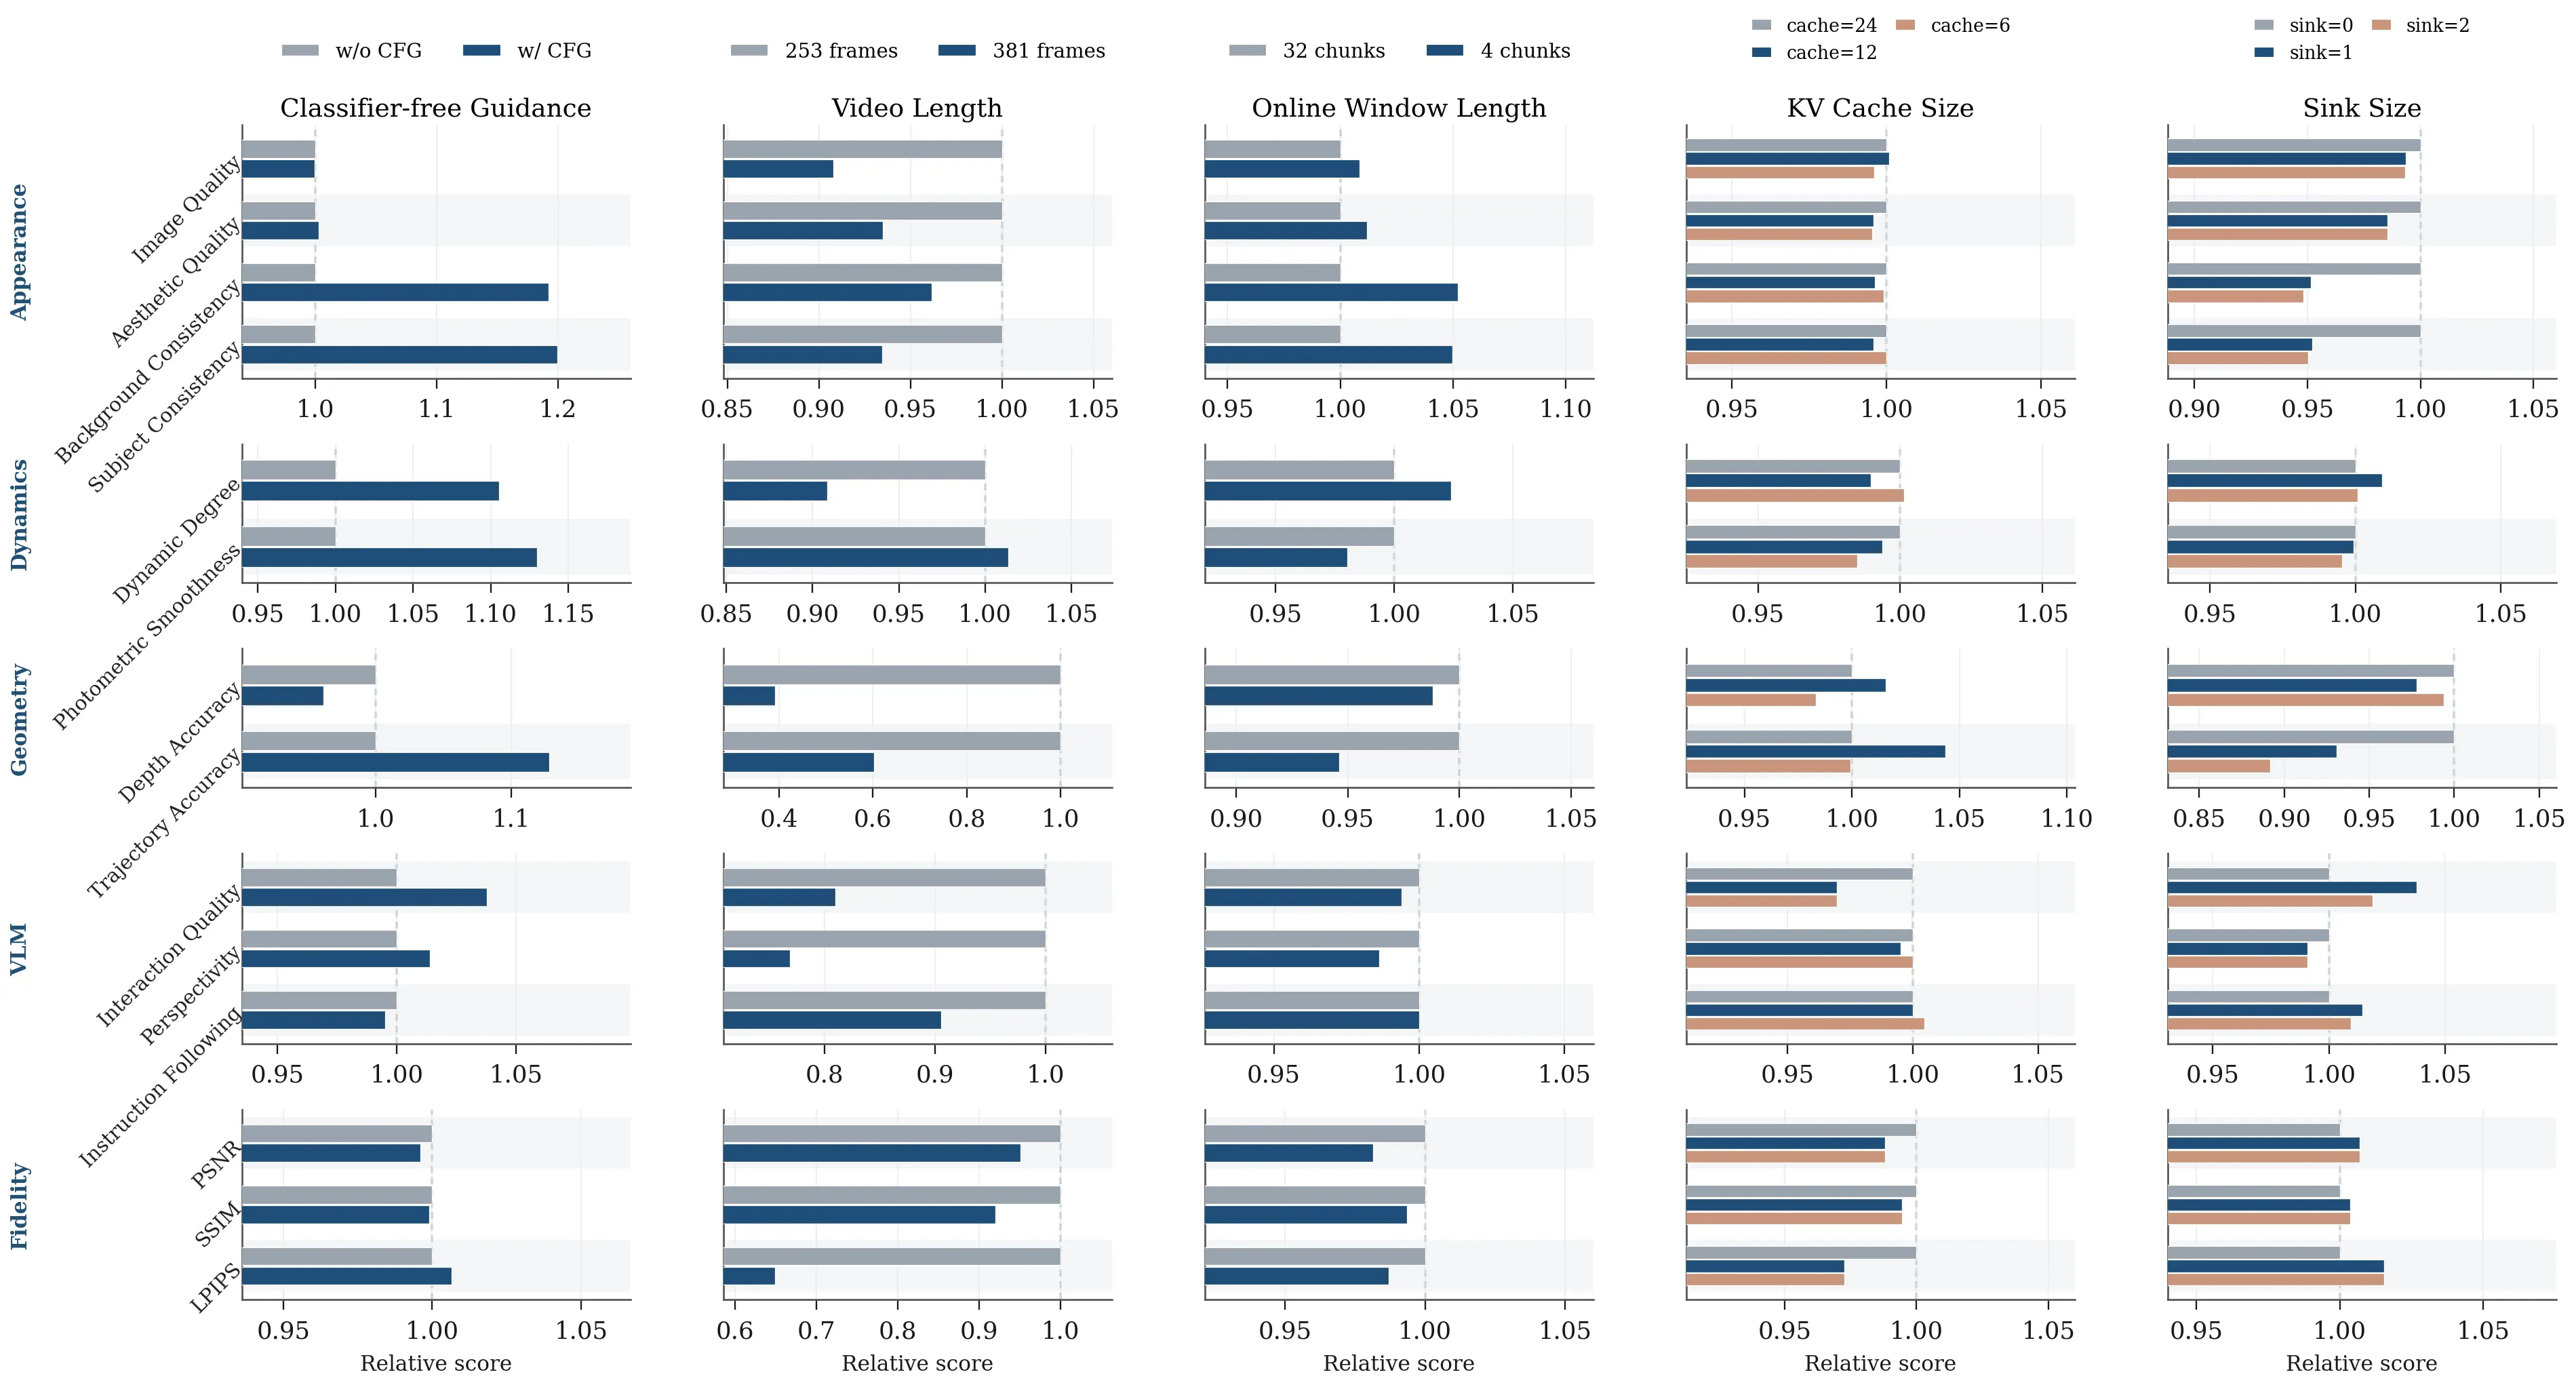
长 Rollout(253→381 帧):
- 外观保持 94%、动力学 96%
- 几何、VLM、保真度退化更明显 → 预测误差累积敏感维度
有界窗口(32→8 in-flight 块 + KV Cache):
- 外观略升、动力学稳定
- 几何/VLM/保真度保持几百分点内 → 滚动 KV Cache 可替代完整窗口
KV Cache 大小(T=64,in-flight=8):
- 24 chunks vs 12 chunks:几乎无差异
- 6 chunks:小幅退化
- 结论:一旦有界窗口和 sink anchor 固定,不需要保留完整 24 chunk 历史
Sink Frames 消融:
- 1-2 sink frames:主要是记忆稳定机制,非质量主要来源
- 核心改进来自 KV-cache 流式设计本身
扩展性分析
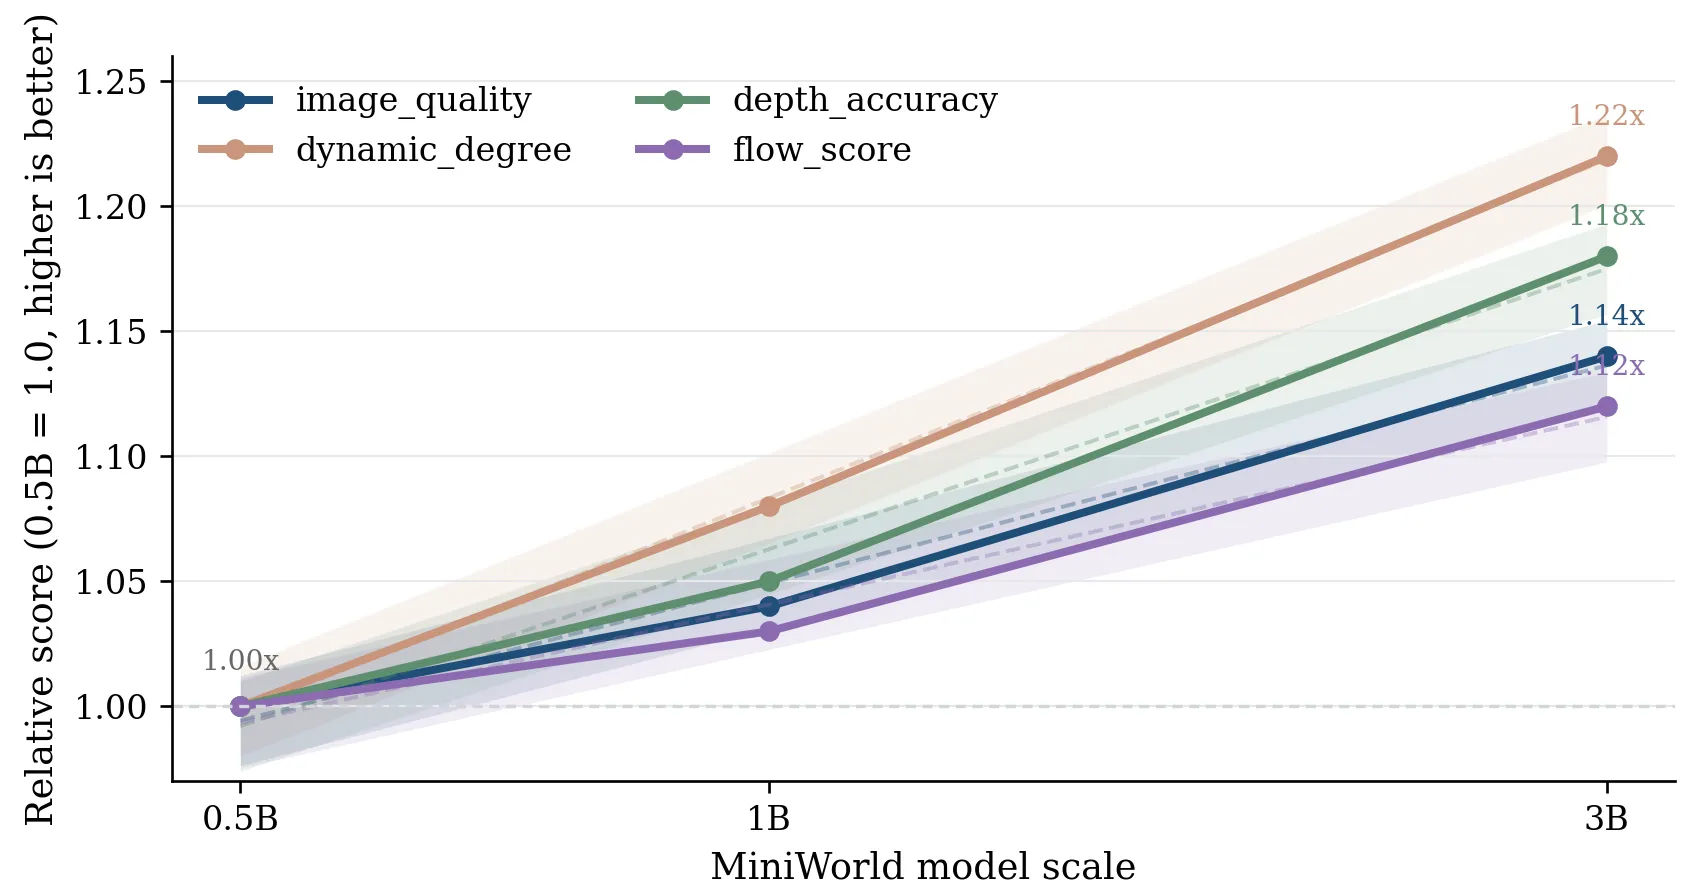
MiniWorld 变体(0.5B → 1B → 3B)在 RE10K 上单调提升:
| 变体 | 动力学 ↑ | 深度准确 ↑ | 图像质量 ↑ | Flow Score ↑ |
|---|---|---|---|---|
| 0.5B (baseline) | - | - | - | - |
| 1B | +18% | +15% | +10% | +9% |
| 3B | +22% | +18% | +14% | +12% |
核心发现:扩展主要增强运动建模和 3D 一致性,同时仍带来清晰的外观和流质量提升。
吞吐量分析
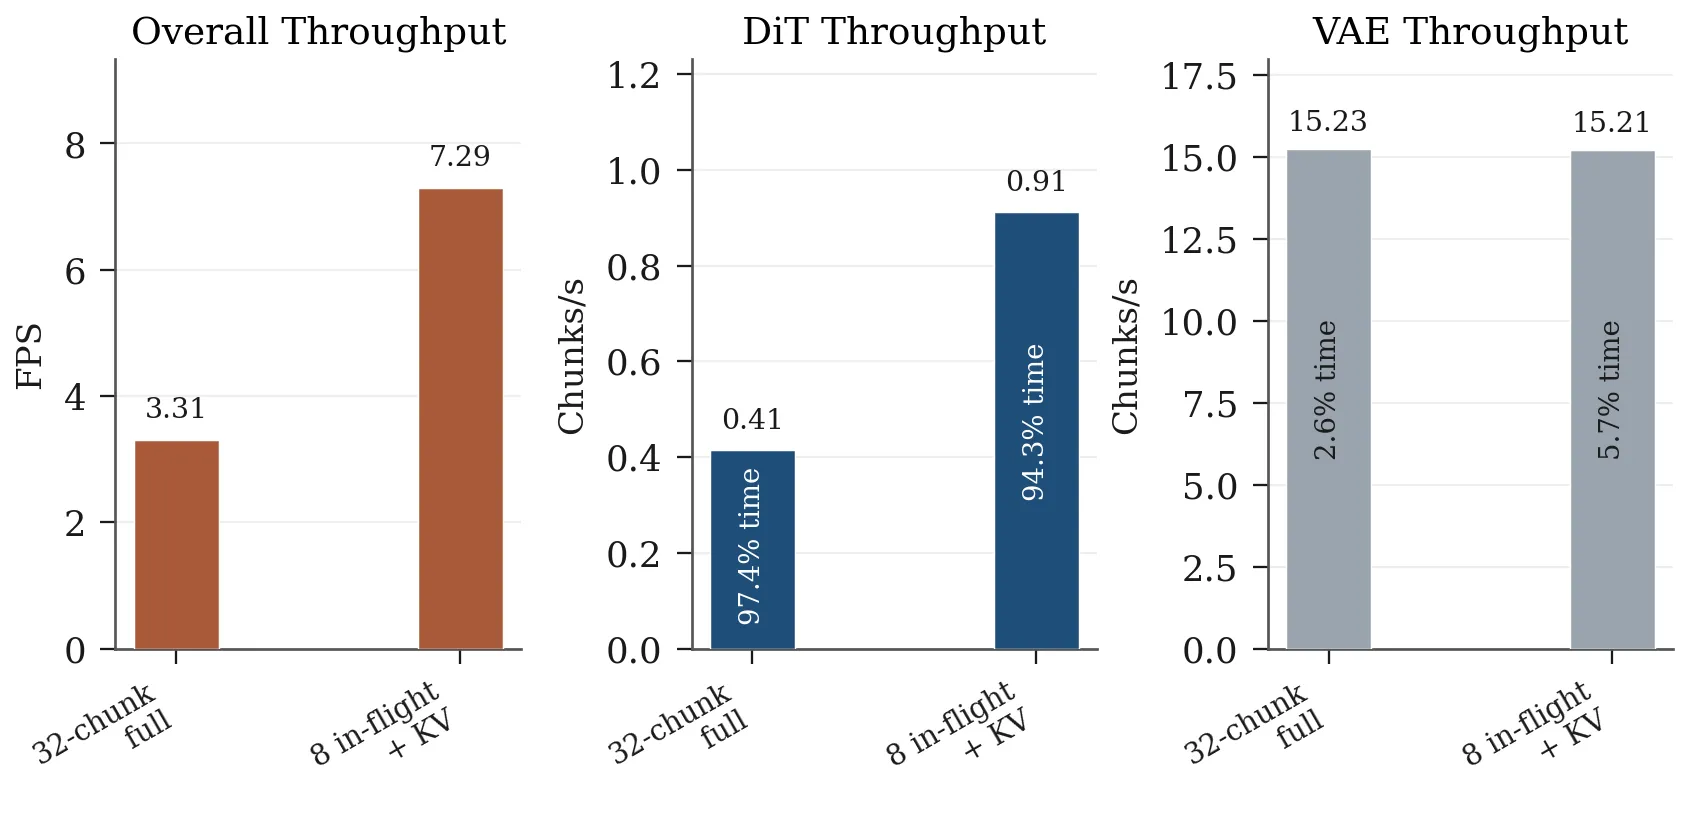
DROID 流式推理基准(MiniWorld-1B,CFG=1):
| 指标 | 全窗口 (32 chunks) | KV Cache (8 chunks) | 加速 |
|---|---|---|---|
| 稳态吞吐量 | 3.31 FPS | 7.29 FPS | 2.20× |
| DiT 吞吐 | 0.41 chunks/s | 0.91 chunks/s | 2.22× |
| VAE 吞吐 | ~15.2 chunks/s | ~15.2 chunks/s | - |
| 首块延迟 | 74.0s | 4.86s | 15.2× |
DiT 占每块计算的 97.4%(全窗口)→ 94.3%(KV Cache),VAE 仅 2.6% → VAE 非瓶颈,效率提升来自限制在线 DiT 注意力窗口。
六、相关工作
大规模视频世界模型
- Genie, Cosmos, LingBot-World, DreamDojo:依赖大规模双向视频模型
- MAGI-1:分块自回归预训练的可扩展性
- SkyReels-V2:Diffusion Forcing 应用于视频世界模型
- HappyOyster, MAGI-1, Dreamx-world, Matrix-game:闭源或大规模系统
Diffusion Forcing 与 AR-Diffusion
- Diffusion Forcing (DF):块独立噪声时间步
- AR-Diffusion:单调调度约束 + 概率传播
- MiniWorld 扩展:FoPP 帧级 → CoPP 块级
视频 VAE
- Wan2.2 VAE:4× 时间压缩、16× 空间压缩
七、总结
核心贡献
- 轻量级可复现基线:单台 8-GPU 服务器数天内可训练
- 块因果 + CoPP 调度:稳定流式训练,避免暴露偏差
- 跨域泛化验证:机器人动作 + 相机控制两种控制模态均有效
- 完整开源:训练代码、推理代码、预训练 checkpoint 全部发布
技术影响
- 降低视频世界模型研究门槛
- 提供可比较的标准化基线
- 块因果 + 异步去噪架构可推广到其他流式生成任务
局限性
- 模型和数据规模相对较小(相比 Wan 等大规模模型)
- 长 rollout 在几何精度和感知保真度上仍有退化
- 当前 VAE 选择(Wan2.2)可能限制潜空间质量
八、参考资源
- MiniWorld 论文: https://arxiv.org/abs/2608.01127
- Diffusion Forcing: https://arxiv.org/abs/2407.01392
- AR-Diffusion: https://arxiv.org/abs/2502.16967
- Rectified Flow: https://arxiv.org/abs/2209.03003
- Wan2.2 VAE: https://github.com/Wan-Video/Wan2.2
- DROID 数据集: https://droid-dataset.github.io
- RealEstate10K: https://google.github.io/realestate10k/