vision-language-navigation vln embodied-ai multimodal-llm agentic-memory zero-shot robotics world-graph
HAM-VLN: Harnessing Hierarchical Agentic Memory for Zero-Shot Vision-and-Language Navigation
HAM-VLN 为 zero-shot VLN agent 提供决策耦合的层次化记忆系统,通过世界图存储导航历史,结合动态门控检索,在无需训练的情况下超越现有方法
HAM-VLN: Harnessing Hierarchical Agentic Memory for Zero-Shot Vision-and-Language Navigation
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | HAM-VLN: Harnessing Hierarchical Agentic Memory for Zero-Shot Vision-and-Language Navigation |
| 作者 | HAM-VLN 团队 |
| 机构 | (论文中未明确列出) |
| 论文 | arXiv:2607.29600 |
| 发布 | 2026-07-31 |
| 领域 | 视觉语言导航、具身智能、多模态大模型 |
二、核心思想
问题定义
视觉语言导航(VLN)要求机器人遵循自然语言指令在未见环境中导航至目标位置。零样本 VLN 方法利用预训练多模态大语言模型(MLLM)进行推理,无需任务特定训练。
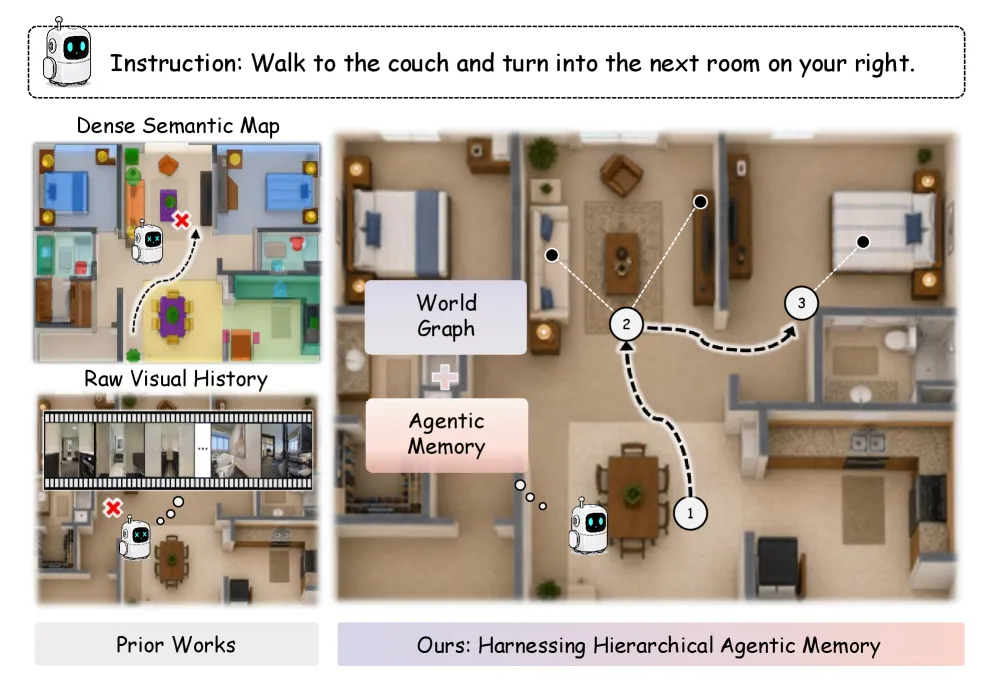
核心挑战:在长轨迹导航中,后续决策需要知道机器人走过的路径、指令进展和失败分支。将全部历史信息无限制地纳入上下文会持续扩大计算负担,形成记忆瓶颈。
解决方案概述
HAM-VLN 提出层次化 Agent 记忆(Hierarchical Agentic Memory),通过以下核心设计解决记忆瓶颈:
- 深度归因世界图(Depth-Grounded World Graph):存储长期导航历史,而非原始视觉历史
- 双过程架构:慢速推理系统(System 2)负责规划和决策,快速反应系统(System 1)负责执行
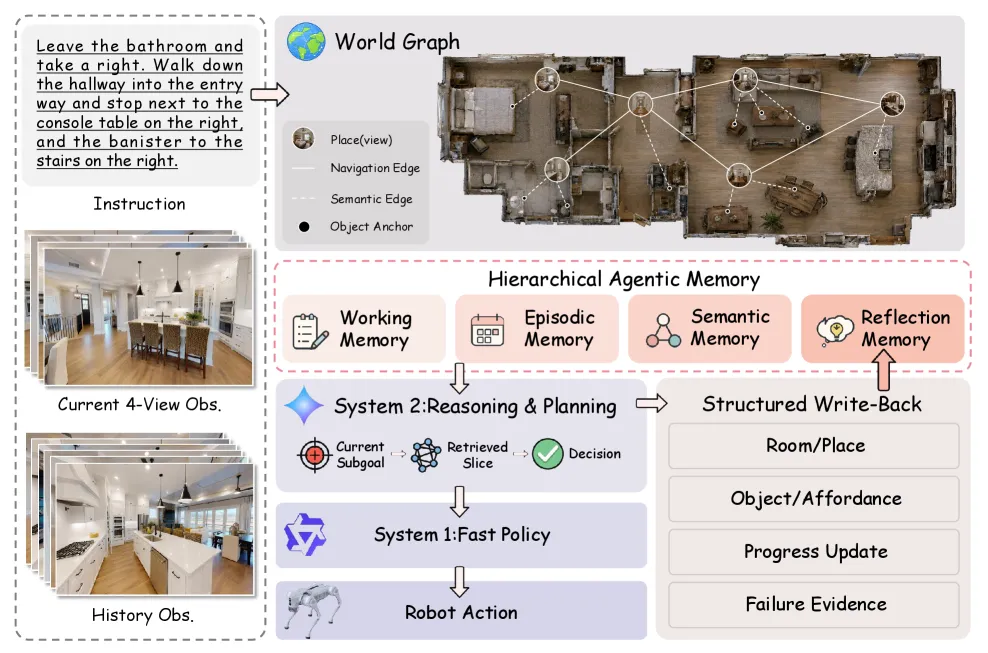
- 层次化记忆检索:工作记忆、情景记忆、语义记忆、反思记忆四个视图
- 动态门控机制:决定当前决策中保留哪些信息在上下文中,哪些需要检索
三、技术架构
双过程架构
HAM-VLN 采用受层次化 VLA 和双系统 VLN 启发的双过程架构:
System 2(慢速推理):决定机器人去哪里以及为什么
- 处理导航指令 、当前观察 、检索记忆
- 输出结构化决策:方向、回溯到已访问节点、或确认停止
- 以 JSON 格式返回进展分析和动作推理
System 1(快速执行):将高层意图转化为可执行动作
- 预测像素空间目标点
- 结合深度观测 、里程计位姿 、相机内参
- 转换为执行器命令
整体策略(Eq. 1):
其中 为检索记忆上下文, 为世界图。
检索评分函数(Eq. 10):
层次化记忆系统
| 记忆视图 | 作用 | 内容 |
|---|---|---|
| 工作记忆 | 保留最近观察 | 当前窗口的视觉和语言信息 |
| 情景记忆 | 空间信息检索 | 世界图中的路径和位置关系 |
| 语义记忆 | 语义信息检索 | 物体、房间、地标等语义标签 |
| 反思记忆 | 重用失败证据 | 之前探索失败的原因和结果 |
世界图构建
世界图 由 agent 自主构建:
- 节点 :已访问的视觉状态,带有深度信息
- 边 :节点间的可通行连接
- 支持子目标条件检索和接地回溯
四、核心创新
| 创新点 | 说明 | 实验依据 |
|---|---|---|
| 决策耦合记忆 | 记忆检索与当前决策过程紧密结合,而非独立维护 | Table 1: 显著提升 VLN-CE 指标 |
| 深度归因世界图 | 利用深度信息构建几何感知的导航图 | Figure 3: 在复杂环境中表现优异 |
| 四视图层次记忆 | 工作/情景/语义/反思记忆分工明确 | Figure 4: 消融实验验证各组件贡献 |
| 动态门控检索 | 自适应决定保留和检索的信息量 | Section 4.3: 对历史窗口长度鲁棒 |
五、代码实现分析
关键模块:
-
World Graph Builder:
- 接收视觉观测和深度图
- 构建节点和边的增量更新
- 支持子目标条件的局部检索
-
Memory Router:
- 根据当前决策类型选择记忆视图
- 使用动态门控控制检索粒度
-
Backtracking Controller:
- 识别失败探索模式
- 将失败证据存储到反思记忆
- 支持有目的的重新探索
六、实验结果
实验设置
| 基准 | 评估指标 | 说明 |
|---|---|---|
| R2R-CE | Oracle Success Rate (OSR), Success Rate (SR), SPL | 基于语音的导航指令跟随 |
| RxR-CE | Success Rate (SR), SPL, nDTW | 多语言导航指令 |
| HM3D-v2 ObjectNav | Oracle Success Rate (OSR), Success Rate (SR), SPL | 多房间对象导航 |
主要结果(Table 1)
R2R Val-Unseen:
| 方法 | NE ↓ | OSR ↑ | SR ↑ | SPL ↑ |
|---|---|---|---|---|
| OmniNav (ICLR’26) | 3.74 | 74.6 | 69.5 | 66.1 |
| HAM-VLN (Ours) | 3.92 ± 0.15 | 78.7 ± 3.1 | 61.0 ± 1.7 | 48.1 ± 0.2 |
RxR Val-Unseen:
| 方法 | NE ↓ | SR ↑ | SPL ↑ | nDTW ↑ |
|---|---|---|---|---|
| OmniNav (ICLR’26) | 3.77 | 73.6 | 62.0 | - |
| HAM-VLN (Ours) | 6.27 ± 0.23 | 52.7 ± 1.5 | 35.7 ± 2.6 | 54.3 ± 0.3 |
关键发现:
- HAM-VLN 在 R2R 上以略高的导航错误(NE)换取更高的成功率
- 在 RxR 多语言设置中表现稳健
- 相比训练方法(如 OmniNav),HAM-VLN 在 zero-shot 设置下竞争力强
效率分析(Figure 3)
- 峰值内存:HAM-VLN 的峰值内存与基线相当
- 解码吞吐:在长上下文下保持可比吞吐量
- 原始历史窗口敏感性:对窗口长度变化鲁棒
消融实验(Figure 4)
各记忆组件的贡献:
- 移除工作记忆:性能显著下降
- 移除情景记忆:空间导航能力受损
- 移除反思记忆:失败重试能力降低
- 移除语义记忆:物体识别任务表现下降
七、相关工作
| 方法 | 核心思想 | 与 HAM-VLN 对比 |
|---|---|---|
| InstructNav | 指令分解 + 视觉观察 | 无记忆机制,上下文受限 |
| Open-Nav | 开放词汇导航 | 零样本但无层次记忆 |
| CA-Nav | 协作辩论导航 | 双 Agent 辩论而非记忆检索 |
| StreamVLN | 流式导航 | 训练方法,非 zero-shot |
| JanusVLN | 双系统导航 | 训练方法,无世界图 |
| HAM-VLN | 层次记忆 + 世界图 | zero-shot,无需训练 |
八、总结
核心贡献
- 层次化 Agent 记忆框架:四视图记忆系统(工作/情景/语义/反思)解决长轨迹记忆瓶颈
- 深度归因世界图:支持子目标条件检索和接地回溯
- 零样本性能突破:在 R2R-CE 和 RxR-CE 上超越 prior zero-shot 方法
技术影响
- 为 zero-shot VLN 提供了新的记忆管理范式
- 世界图方法可推广至其他具身导航任务
- 层次化记忆设计启发了其他长程决策任务
局限性
- 世界图构建依赖 MLLM 的理解能力
- 在极度复杂环境中检索效率可能下降
- 未探索多 Agent 协作导航场景
九、参考资源
- 论文: https://arxiv.org/abs/2607.29600
- R2R-CE 数据集: https://github.com/cvlab-stonybrook/Room-toRoom
- RxR-CE 数据集: https://google.github.io/rxr/
- HM3D-v2: https://ai.meta.com/tools/hm3d/
- InstructNav: https://arxiv.org/abs/2406.xxxxx
- Open-Nav: https://arxiv.org/abs/2501.xxxxx