ResKV: Reconstructing Omitted Attention Contributions for Fixed-Budget KV Cache Compression
ResKV 将固定 KV 预算划分为精确主缓存和紧凑残差缓存,通过共享 softmax 重建被丢弃 token 的注意力贡献,显著提升长上下文推理效率
ResKV: Reconstructing Omitted Attention Contributions for Fixed-Budget KV Cache Compression
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | ResKV: Reconstructing Omitted Attention Contributions for Fixed-Budget KV Cache Compression |
| 作者 | Yuhang Zhan, Lisi Chen, Shuo Shang |
| 机构 | University of Electronic Science and Technology of China |
| 论文 | arXiv:2607.29591 |
| 发布 | 2026-07-31 |
| 领域 | KV Cache 压缩、长上下文推理、LLM 加速 |
二、核心思想
问题定义
长上下文 LLM 依赖 KV Cache 避免预填充阶段重复计算键值对,但缓存随序列长度线性增长,成为推理瓶颈。现有压缩方法分为两类:
- Eviction 方法:评分后永久丢弃未选中 token,其注意力贡献完全丢失
- Merging 方法:将丢弃状态折叠到保留条目中,但会扰动应保持精确的键值对
解决方案概述
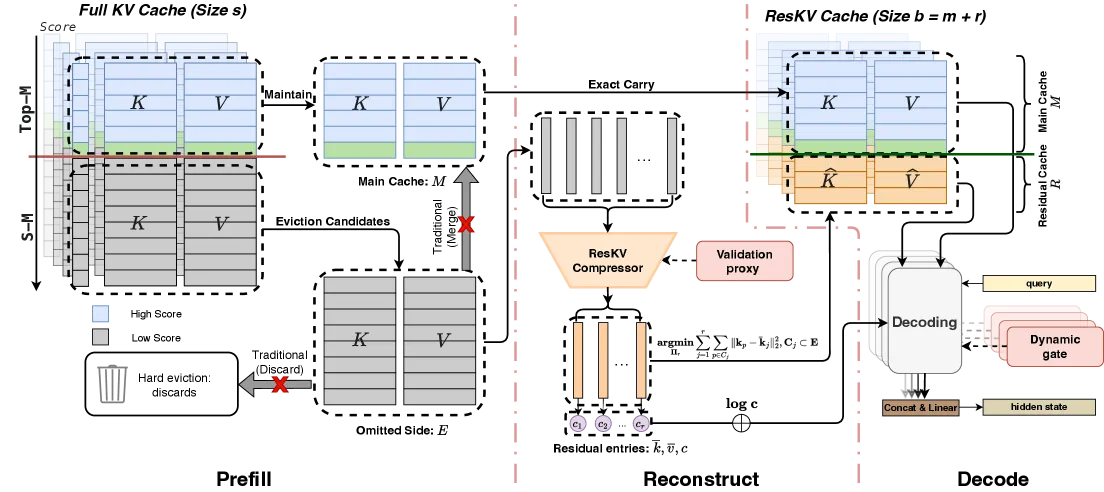
ResKV 观察到:在 softmax attention 的分子-分母形式中,被丢弃 token 的贡献可表述为残差统计量。基于此,ResKV 将固定 KV 预算 划分为精确主缓存和紧凑残差缓存两部分,使残差条目与主缓存 token 参与同一 softmax 归一化,恢复被忽略 token 的注意力贡献。
三、技术架构
核心公式
标准 Attention(Eq. 1):
Main-Residual 分解(Eq. 8):
其中 , 为主缓存集合, 为丢弃集合。
残差条目表示(Eq. 10):
每个残差条目存储代表性键、值和人口计数 。
残差注意力重构(Eq. 11):
其中 。
ResKV 整体架构
分步流程:
- Cache Split and Selection:对每个 (layer, KV head),按分数排序,Top- 进入主缓存 ,剩余 作为残差候选
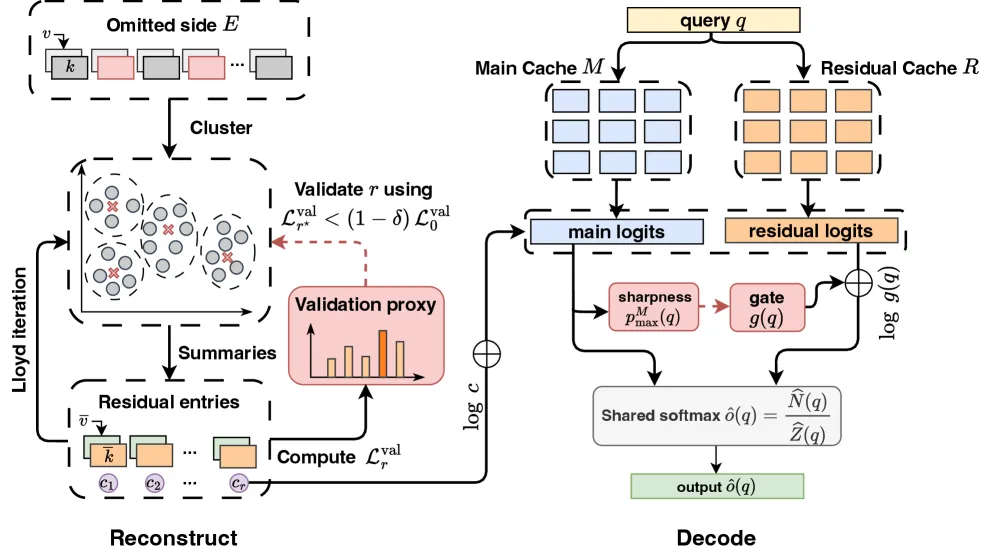
- Residual Cache Construction:使用 Lloyd 迭代将 聚类为 个残差组
- Shared-Softmax Residual Decode:主缓存和残差条目参与同一 softmax 归一化
- Adaptive Residual Control:构建时验证代理 + 解码时动态门控
动态门控(Decode-Time Dynamic Gate)
其中 为残差入口的代理注意力分数。 保护主缓存峰值, 为粗粒度注意力模式注入残差质量。
构建时验证代理
选择使验证损失最小的 ,仅在 优于纯主缓存 倍时启用残差。
四、核心创新
| 创新点 | 说明 | 实验依据 |
|---|---|---|
| 残差 KV 缓存 | 将被丢弃 token 建模为 softmax 分子/分母中的残差统计量 | Eq. 2, 4 |
| 共享 Softmax | 残差条目与主缓存参与同一 softmax 归一化,非事后修正 | Figure 1 |
| 动态门控 | 粗/细粒度注意力自适应融合,保护主缓存峰值 | Eq. 5, 6 |
| 验证代理 | 构建时选择最优残差预算,保证增益 | Eq. 7, 19 |
五、代码实现分析
关键实现(Algorithm 1, Page 12):
Input: K, V; budget b; residual grid G; recent window w; Lloyd steps T; margin δ
for each (layer, head):
    scores ← compute token scores with recent window w
    M ← top-m entries by scores  (m = b - r for candidate r)
    E ← S \ M
    R ← Lloyd-iterate(E, r)  // cluster into r residual entries
    if validation: compute L_r^val, select best r*
return M, R
关键设计选择:
- Key-space consistency:使用 key 空间一致性作为 query-agnostic 代理
- Lloyd 迭代:对 OOD key 值域有数值稳定性
- Recent window:使用 recent window 计算分数,确保最近 token 被保留
六、实验结果
实验设置
| 模型 | LLaMA-3.1-8B-Instruct | Qwen-2.5-7B-Instruct |
|---|---|---|
| 序列长度 | 4K, 32K | 4K, 32K |
| 保留预算 | 10%, 20%, 30%, 40% | 10%, 20%, 30%, 40% |
| 构建方式 | Query-aware, Query-agnostic | Query-aware, Query-agnostic |
RULER 结果(Table 1)
| 方法 | LLaMA-3.1-8B 4K 10% | +ResKV | LLaMA-3.1-8B 32K 10% | +ResKV |
|---|---|---|---|---|
| AdaKV | 58.94 | 70.51 (+11.57) | 72.20 | 77.84 (+5.64) |
| SnapKV | 56.37 | 60.74 (+4.37) | 69.14 | 70.31 (+1.17) |
关键发现:
- ResKV 在 tight budget(10%)下提升最大
- Query-agnostic 设置下 ResKV 增益更显著(+8.14 points at 10% LLaMA-3.1-8B)
- 32K 上下文长度下 ResKV 保持稳定的性能提升
LongBench 结果(Table 2)
| 方法 | Qwen-2.5-7B 10% | +ResKV | 20% | +ResKV |
|---|---|---|---|---|
| AdaKV | 42.26 | 42.52 | 44.88 | 45.09 |
| SnapKV | 42.16 | 42.82 | 44.70 | 45.57 |
| AdaKV (q-agn) | 33.28 | 35.63 | 38.86 | 41.45 |
| SnapKV (q-agn) | 33.22 | 35.24 | 39.02 | 40.51 |
关键发现:
- 在 10% 和 20% 保留 KV 预算下,ResKV 分别提升 3.47 和 3.66 点
- 增益集中在变量跟踪、FWE、多键/单键检索任务
Task-Level 对比(Table 3, Qwen-2.5-7B 10%)
| 方法 | NrtvQA | HotpotQA | RB-P | FWE | S-1 | QA-1 |
|---|---|---|---|---|---|---|
| SnapKV | 19.43 | 36.48 | 56.82 | 57.07 | 19.20 | 20.80 |
| +CaM | 20.27 | 34.98 | 56.98 | 55.47 | 17.60 | 18.40 |
| +ResKV | 22.59 | 40.59 | 59.66 | 68.80 | 43.20 | 24.00 |
关键发现:
- ResKV 在检索类任务(FWE: +11.73, NrtvQA: +3.16)上增益显著
- 相比 CaM,ResKV 增益更稳定
效率分析(Figure 3)
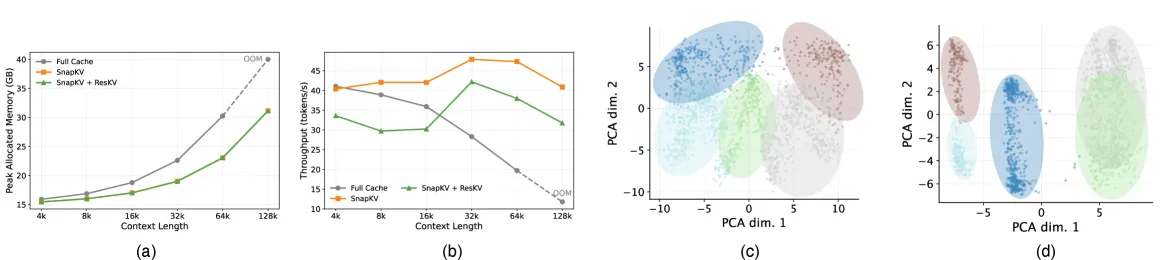
- 峰值内存:ResKV 峰值内存与基线(SnapKV)基本重叠,额外开销可忽略
- 解码吞吐:ResKV 在长上下文下保持与基线相当的吞吐
- 残差可聚类性:PCA 投影显示被丢弃键值对在 key 空间具有良好的聚类结构
七、相关工作
| 方法 | 核心思想 | 与 ResKV 对比 |
|---|---|---|
| AdaKV | 注意力头级自适应预算分配 | ResKV 可作为插件增强 AdaKV |
| SnapKV | 滑动窗口 + 注意力快照 | ResKV 可增强 SnapKV |
| CaM | 将丢弃状态折叠到保留条目 | ResKV 保持主缓存精确,残差独立存储 |
| KVSculpt | 优化虚拟 KV 对 | ResKV 基于物理残差统计量 |
| PyramidKV | 金字塔信息漏斗 | ResKV 基于 attention 残差分解 |
八、总结
核心贡献
- ResKV 表示:将 KV 缓存拆分为精确主缓存和残差缓存,重构被忽略 token 的注意力贡献
- 自适应残差控制:构建时验证代理 + 解码时动态门控,自动调整残差预算和权重
- 全面实验验证:在 RULER、LongBench 上验证,10% 保留预算下显著提升长上下文理解能力
技术影响
- 为 KV 缓存压缩提供了新的视角:不丢弃也不扰动,而是保留残差统计量
- 动态门控机制可灵活适配不同注意力模式
局限性
- 残差条目数量受预算限制,极端压缩场景下仍会损失信息
- 当前方法基于 key-space consistency,对 outlier 查询的恢复能力有限
九、参考资源
- 论文: https://arxiv.org/abs/2607.29591
- RULER 数据集: https://github.com/AaronSamuelLi/RULER
- LongBench 数据集: https://github.com/THUDM/LongBench
- AdaKV: https://arxiv.org/abs/2410.13841
- SnapKV: https://arxiv.org/abs/2306.10198
- CaM: https://arxiv.org/abs/2406.12049