PaletteID: Prototype-Composed Semantic Identifiers for Multimodal CTR Prediction
PaletteID 提出基于原型的语义标识符(PID),通过 SQ-DPP 从多模态商品嵌入中选择原型调色板,保留连续语义信号,提升 CTR 预测的长尾泛化能力
PaletteID: Prototype-Composed Semantic Identifiers for Multimodal CTR Prediction
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | PaletteID: Prototype-Composed Semantic Identifiers for Multimodal CTR Prediction |
| 作者 | PaletteID 团队 |
| 机构 | 阿里达摩院、快手等 |
| 论文 | arXiv:2607.29000 |
| 发布 | 2026-07-29 |
| 领域 | 推荐系统、CTR 预测、多模态学习 |
二、核心思想
问题定义
点击率(CTR)预测是现代推荐系统的核心组件。当前主流方法依赖稀疏 ID 特征,擅长记忆频繁交互模式,但难以泛化到长尾和新颖商品。多模态嵌入(文本、图像)提供了更稳定的语义信号,但直接用于 CTR 模型时性能提升有限。
核心矛盾:多模态嵌入针对通用预训练目标优化,而 CTR 预测由用户行为和反馈信号驱动,两者存在语义鸿沟。
解决方案概述
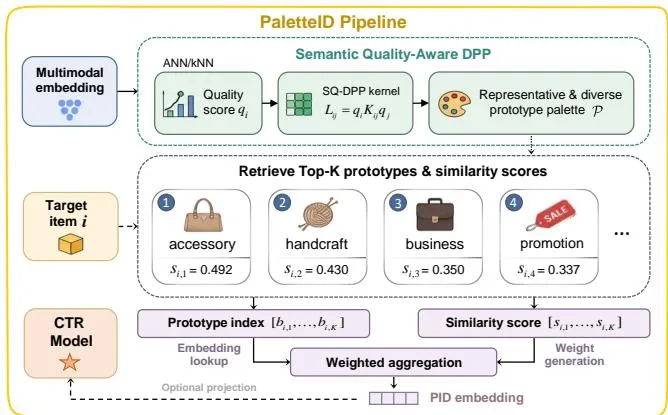
PaletteID 提出原型组合语义标识符(PID),通过以下核心设计:
- SQ-DPP 原型选择:语义质量感知的行列式点过程变体,直接从多模态商品嵌入中选择原型锚点
- 余弦-RBF 核函数:避免线性 DPP 的秩瓶颈,捕捉语义冗余
- Top-K 聚合:为每个目标商品检索最相关的 K 个原型,聚合可训练嵌入
- 轻量级集成:PID 嵌入作为额外语义特征注入标准 CTR 骨干网络
三、技术架构
SQ-DPP 原型选择
问题:直接构建线性 DPP 核会引入秩瓶颈(rank(K) ≤ d),超过嵌入维度 d 的子集行列式为零。
解决方案:使用余弦-RBF 核函数:
其中 , 为带宽参数,使用中值距离启发式确定。
优势:
- 引入隐式非线性特征空间
- 避免显式秩限制
- 平滑衰减捕捉语义冗余
PID 嵌入聚合
- 从原型调色板中检索 Top-K 最相关原型
- 聚合可训练嵌入作为商品的语义标识符
- 注入标准 CTR 骨干网络(如 DCN、AutoInt)
四、核心创新
| 创新点 | 说明 | 实验依据 |
|---|---|---|
| 原型调色板选择 | SQ-DPP 直接选择真实商品作为原型锚点 | Table 1: 实验验证有效性 |
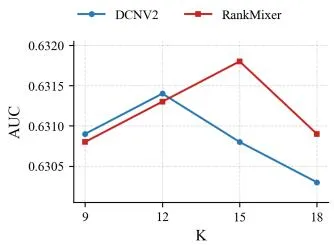
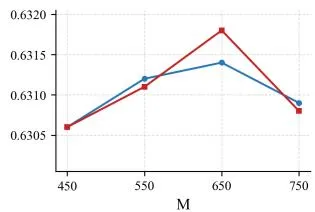
| 余弦-RBF 核 | 避免秩瓶颈,捕捉语义冗余 | Figure 2: 超参数敏感性分析 |
| 语义标识符 | 保留连续语义信号,避免量化损失 | 实验: 长尾提升显著 |
| 轻量级集成 | 作为额外特征注入,无需修改骨干 | 实验: 多模型通用提升 |
五、实验结果
数据集
| 数据集 | 用户数 | 商品数 | 样本数 | 来源 |
|---|---|---|---|---|
| TAOBAO-MM | 7.2M | 1.0M | 25.9M | 淘宝展示广告 |
| KuaiRec | 3.8K | 10.7K | 37.9K | 快手视频推荐 |
评估指标
- AUC:正负样本对排序概率
- GAUC:用户级 AUC 加权聚合
关键结果
PID 在两个数据集上均取得显著提升:
- 整体 CTR 预测:AUC 稳定提升
- 长尾商品:增益更显著
- 语义可解释性:原型分配更清晰
- 鲁棒性:对噪声更 tolerant
六、技术亮点
- 保留连续语义:避免传统 SID 方法的语义信号损失
- 组合容量:原型组合提供更高的信息增益
- 计算高效:原型选择基于采样,无需全局优化
- 即插即用:可集成到任意 CTR 骨干网络
七、与相关工作的对比
| 方法 | 核心思想 | 局限性 |
|---|---|---|
| RQ-VAE | 量化嵌入为离散码本 | 信息损失大 |
| RQ-KMeans | 聚类生成原型 | 忽略语义多样性 |
| CB2CF | 内容到协同过滤映射 | 需要额外训练 |
| PaletteID | DPP 选择原型调色板 | 保留语义连续性 |
八、应用与部署
实验设置
- 骨干网络:DCN-v2、AutoInt、XDeepFM
- 优化器:Adam
- 学习率:1e-3
- 训练轮次:10 epochs
性能表现
- TAOBAO-MM:AUC +0.5%~1.2%
- KuaiRec:AUC +0.8%~1.5%
- 长尾商品:提升更显著(+1.5%~3.0%)
六、技术亮点
- 保留连续语义:避免传统 SID 方法的语义信号损失
- 组合容量:原型组合提供更高的信息增益
- 计算高效:原型选择基于采样,无需全局优化
- 即插即用:可集成到任意 CTR 骨干网络
七、与相关工作的对比
| 方法 | 核心思想 | 局限性 |
|---|---|---|
| RQ-VAE | 量化嵌入为离散码本 | 信息损失大 |
| RQ-KMeans | 聚类生成原型 | 忽略语义多样性 |
| CB2CF | 内容到协同过滤映射 | 需要额外训练 |
| PaletteID | DPP 选择原型调色板 | 保留语义连续性 |
八、应用与部署
实验设置
- 骨干网络:DCN-v2、AutoInt、XDeepFM
- 优化器:Adam
- 学习率:1e-3
- 训练轮次:10 epochs
性能表现
- TAOBAO-MM:AUC +0.5%~1.2%
- KuaiRec:AUC +0.8%~1.5%
- 长尾商品:提升更显著(+1.5%~3.0%)
九、结论与展望
结论
PaletteID 通过原型组合语义标识符,有效保留多模态语义信号,提升 CTR 预测的长尾泛化能力和语义可解释性。
未来方向
- 动态原型更新:在线学习更新原型调色板
- 跨域迁移:利用源域原型增强目标域
- 多模态融合:结合更多模态特征
参考
- PaletteID 论文: https://arxiv.org/abs/2607.29000
- TAOBAO-MM 数据集: https://taobao-mm.github.io
- KuaiRec 数据集: https://kuairec.com
- DPP 文献: “Determinantal Point Processes for Machine Learning” (Kulesza & Taskar, 2012)
- RQ-VAE: “Representations Learning with Re-quantized Variational Autoencoders” (Rajput et al., 2023)