Topology-Aware Data Movement for Disaggregated GPU Inference
TopKV — 拓扑感知的KV缓存传输编排器,利用GPU互连层次结构将KV缓存传输延迟降低3-18倍
Topology-Aware Data Movement for Disaggregated GPU Inference: 拓扑感知的KV缓存传输编排器
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Topology-Aware Data Movement for Disaggregated GPU Inference |
| 作者 | Sanjeev Rao Ganjihal (独立研究者) |
| 机构 | Independent Researcher |
| 论文 | arXiv:2607.28633 |
| 代码 | 未在GitHub找到独立开源仓库 |
| 发布 | 2026-04-19 (v1), 2026-08-07 (v2) |
| 许可 | arXiv.org perpetual non-exclusive license |
| 页数 | 8 pages, 4 tables, 1 algorithm |
二、核心思想
问题定义
离散化LLM推理创造了一个数据中心网络问题,现有系统均未正确解决。
当预填充(prefill)和解码(decode)在独立的GPU池上运行时,KV缓存必须在它们之间传输。对于一个70B模型,这相当于每请求1.3GB数据,在生产规模下超过100GB/s的聚合带宽需求。
然而,现有的离散化系统(DistServe、Splitwise、Mooncake)都使用统一的RDMA传输,忽略了两个GPU之间的带宽会根据其物理关系变化72倍:
- 同一NVLink域内:900 GB/s (NVLink 4.0),1.8 TB/s (NVLink 5)
- 跨节点InfiniBand:50 GB/s
- 跨数据中心TCP:12.5 GB/s
解决方案概述
TopKV 是一个拓扑感知的KV缓存传输编排器,在启动时 discovery 互连层次结构,并为每次传输选择最优传输方式。三个机制协同工作:
- 流水线层间传输:将传输与进行中的预填充重叠,隐藏76%到100%的传输延迟(NVLink和PCIe传输完全隐藏)
- NVLink域感知的MoE路由:为混合专家模型联合优化专家分发与KV缓存局部性
- CXL 3.0内存扩展器:作为共享溢出层,提供6倍容量,延迟比NVMe低86倍
三、技术架构
整体框架
TopKV是一个编排层,管理离散化推理的生命周期:请求路由、预填充执行、KV缓存传输、解码执行。
设计三原则:
- 每次传输决策都考虑源和目标GPU之间的物理互连
- 工作人员根据需求动态承担预填充或解码角色
- 对于MoE模型,专家分发和KV缓存放置联合优化
核心组件
| 组件 | 说明 |
|---|---|
| KV Relay Orchestrator | 管理预填充→传输→解码生命周期,维护活跃传输注册表,处理重试(2次尝试,100ms指数退避),强制执行并发限制(默认:100并发传输)。传输异步完成:预填充工作节点立即释放以接受下一个请求 |
| KV Cache Transfer Manager | 执行数据传输,通过TransferSink接口实现五种传输模式(NVLink、NVSwitch、PCIe、RDMA、TCP),使用BandwidthThrottledSink包装器模拟实际传输带宽 |
| Topology Manager | 在启动时发现和缓存GPU互连拓扑,包括NVLink域成员资格、NVSwitchfab连通性、PCIe层次结构和RDMA可用性 |
| Adaptive Decoder Pool | 使用token速度跟踪和高峰期检测管理预填充和解码工作者之间的动态角色转换 |
核心公式
KV缓存大小计算(Equation 1):
其中 为层数, 为KV头数, 为头维度, 为序列长度, 为每元素字节数(FP16时为2)。
传输延迟模型(Equation 2):
其中 为缓存大小(字节), 为传输模式 的带宽, 为每次传输的_SETUP延迟(连接建立、内存注册)。
公式 (3): 流水线重叠有效时间(Equation 3)
其中 为最后一层的预填充计算时间, 为原始传输时间, 为第一层传输完成后的剩余计算时间。
互连层次结构
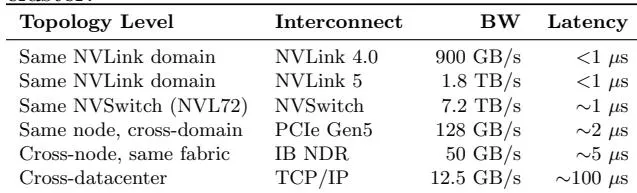
| 拓扑层级 | 互连方式 | 带宽 | 延迟 |
|---|---|---|---|
| 同NVLink域 | NVLink 4.0 | 900 GB/s | <1 μs |
| 同NVLink域 | NVLink 5 | 1.8 TB/s | <1 μs |
| 同NVSwitch (NVL72) | NVSwitch | 7.2 TB/s | ~1 μs |
| 同节点,跨域 | PCIe Gen5 | 128 GB/s | ~2 μs |
| 跨节点,同fabric | IB NDR | 50 GB/s | ~5 μs |
| 跨数据中心 | TCP/IP | 12.5 GB/s | ~100 μs |
关键洞察:带宽从NVLink到TCP跨越72倍,而现有系统都使用统一RDMA传输。
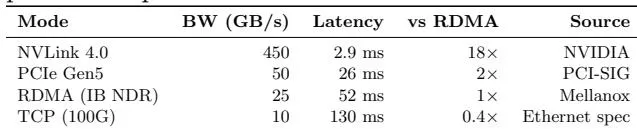
KV缓存传输延迟(Llama-3-70B, 1.3GB)
| 传输模式 | 带宽 (GB/s) | 延迟 | 相对RDMA提升 |
|---|---|---|---|
| NVLink 4.0 | 450 | 2.9 ms | 18× |
| PCIe Gen5 | 50 | 26 ms | 2× |
| RDMA (IB NDR) | 25 | 52 ms | 1× (基准) |
| TCP (100G) | 10 | 130 ms | 0.4× |
传输选择算法
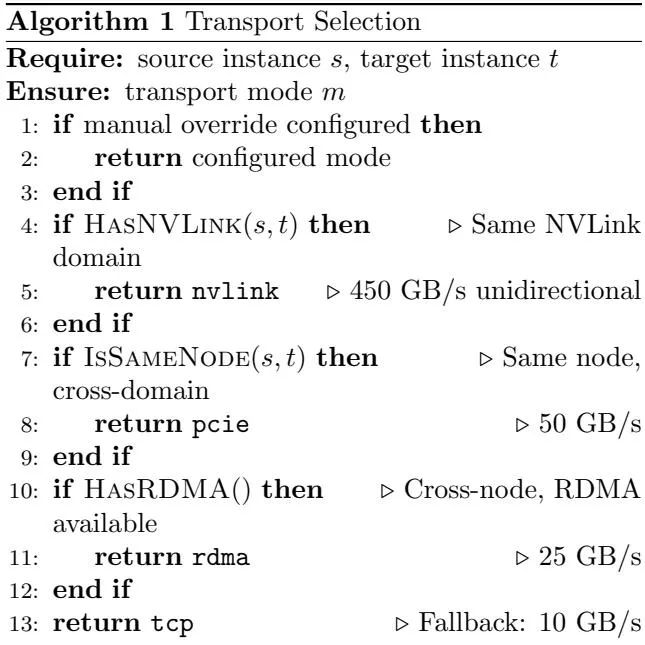
Algorithm 1: Transport Selection
1: input: source instance s, target instance t
2: output: transport mode m
3: if manual override configured then
4:     return configured mode
5: end if
6: if HasNVLink(s, t) then     ▷ 同一NVLink域
7:     return nvlink            ▷ 450 GB/s 单向
8: end if
9: if IsSameNode(s, t) then    ▷ 同节点,跨域
10:    return pcie              ▷ 50 GB/s
11: end if
12: if HasRDMA() then          ▷ 跨节点,RDMA可用
13:    return rdma              ▷ 25 GB/s
14: end if
15: return tcp ▷ 回退:10 GB/s可达带宽约定(用于编排器规划):
- NVLink: 450 GB/s 单向 (NVLink 4.0, 18链路)
- PCIe: 50 GB/s (Gen5 x16 实际吞吐量)
- RDMA: 25 GB/s (400 Gbps InfiniBand NDR,考虑协议开销)
- TCP: 10 GB/s (100 Gbps以太网 + gRPC framing)
KV缓存序列化格式
使用固定128字节头部:
- 8字节魔数 (KVCACHE1)
- 请求ID、模型ID
- 张量维度(序列长度、层数、KV头数、头维度)
- 张量大小、CRC-64校验和
张量布局:[layers][seq_len][kv_heads][head_dim],支持RDMA和NVLink路径上的单次DMA传输。校验失败触发自动重试。
自适应解码器池 (ADP)
Token速度跟踪:使用滑动窗口的指数移动平均(EMA)跟踪token到达率,平滑因子平衡对流量突发的响应能力和稳态操作的稳定性。
高峰期检测:使用三个信号检测持续高需求:
- 预填充队列深度增长率
- token速度尖峰幅度
- P99 TTFT相对于目标的偏差
至少两个信号同时超过阈值时触发高峰期。
角色转换:当检测到高峰期时,ADP识别空闲的解码工作者并将其转换为预填充角色。目标转换时间为10秒(相比冷启动新GPU容器需5分钟)。支持分块预填充(512-token块,保留30%解码槽位)。
MoE路由策略
TopKV维护按专家ID、Pod IP、NVLink域ID三重索引的专家注册表。
| 路由策略 | 说明 | 优化目标 |
|---|---|---|
| Cache-affinity | 路由到已有KV缓存的GPU | 最小化KV传输 |
| Expert-locality | 路由到最频繁激活专家所在的NVLink域 | 最小化all-to-all分发延迟 |
| Load-balance | 基于每专家负载因子分发(激活率+归一化计算延迟+队列深度) | 负载均衡 |
路由器根据成本模型选择策略,权衡估计的KV传输时间、专家分发时间和目标队列深度。
CXL 3.0溢出层
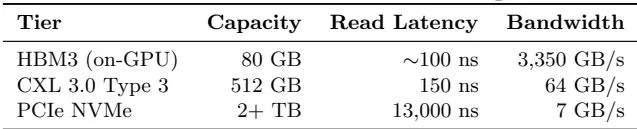
GPU HBM容量限制并发解码序列。TopKV将CXL 3.0 Type 3内存扩展器建模为KV缓存溢出层:
| 层级 | 容量 | 读取延迟 | 带宽 |
|---|---|---|---|
| HBM3 (GPU内) | 80 GB | ~100 ns | 3,350 GB/s |
| CXL 3.0 Type 3 | 512 GB | 150 ns | 64 GB/s |
| PCIe NVMe | 2+ TB | 13,000 ns | 7 GB/s |
每个端点提供128 GB DDR5,每节点四个端点提供512 GB额外容量(6倍于80 GB HBM),延迟比NVMe低86倍。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 拓扑感知传输选择 | 首次将GPU互连层次结构(72倍带宽差异)引入离散化推理的传输决策 | 分析模型显示3-18倍延迟降低 |
| 层间流水线传输 | 在预填充期间重叠层间传输,隐藏76-100%传输延迟 | 计算-传输重叠分析,NVLink/PCIe传输完全隐藏 |
| MoE路由与KV缓存联合优化 | 首次联合优化专家分发与KV缓存局部性 | 三种路由策略的成本模型 |
| CXL 3.0作为KV缓存溢出层 | 首次将CXL建模为推理KV缓存溢出层 | 性能模型:86倍延迟优势 vs NVMe |
五、代码实现分析
实现架构
TopKV以Go实现为控制器,包含以下组件:
Orchestrator:
- KVRelayOrchestrator作为每命名空间单例运行
- 两个后台goroutine:完成处理器(1000条目的缓冲通道)和指标导出器(Prometheus计数器)
Transfer Manager:
- KVCacheTransferManager通过TransferSink接口实现五种传输模式
- selectTransferMode()实现算法1的传输选择逻辑
Topology Detection:
- NVLinkDetector:解析nvidia-smi topo -m输出为带宽邻接矩阵
- PCIeDetector:解析lspci -tv提取交换机层次结构和GPU BDF地址
- InfiniBandDetector:枚举RDMA设备和fabric类型
- NUMADetector:映射GPU到NUMA节点亲和性
MoE Router:
- MoEAwareRouter维护三索引专家注册表
- 实现三种路由策略和每专家负载因子计算用于straggler检测
Adaptive Decoder Pool:
- ConvertibleDecoderPool实现token速度跟踪、高峰期检测和工作者角色转换
- 分块预填充支持(512-token块,30%解码槽位保留)
当前实现限制
- 传输模式通过节流sink模拟带宽,而非调用实际的CUDA IPC或ibverbs系统调用
- CXL层是性能模型,非硬件驱动
- 流水线层间传输是分析建模(计算与传输时间重叠估算),未实现为实际并发执行
- 这些限制与Frontiers Track一致:系统设计完整且实现验证了编排逻辑,但硬件集成等待多节点GPU集群访问
六、实验结果
传输延迟分析
对于Llama-3-70B(1.3GB KV缓存)的投影传输延迟:
| 模式 | 带宽 | 延迟 | vs RDMA |
|---|---|---|---|
| NVLink 4.0 | 450 GB/s | 2.9 ms | 18× |
| PCIe Gen5 | 50 GB/s | 26 ms | 2× |
| RDMA (IB NDR) | 25 GB/s | 52 ms | 1× |
| TCP (100G) | 10 GB/s | 130 ms | 0.4× |
拓扑感知选择根据源和目标的物理关系,比统一RDMA提供3-18倍延迟降低。
流水线重叠分析
对于Llama-3-70B(80层),每层预填充计算约0.5ms(batch size=1):
- RDMA传输(52ms):流水线隐藏39.5/52 = 76% 传输延迟
- NVLink传输(2.9ms):整个传输被计算隐藏
- PCIe传输(26ms):剩余计算超过传输,流水线完全隐藏
聚合带宽需求
请求速率 下,平均KV缓存大小 ,聚合传输需求为 :
- 100 req/s服务Llama-3-70B:100 × 2.6 GB = 260 GB/s
- 单IB NDR链路(25 GB/s可用)饱和于19.2 req/s
- NVLink(450 GB/s)每域处理173 req/s
18倍可持续请求速率差异是拓扑感知传输的核心动机。
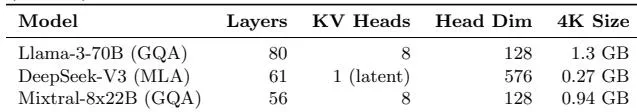
不同架构的KV缓存大小
| 模型 | 架构 | 4K缓存大小 |
|---|---|---|
| Llama-3-70B | GQA (8 KV heads) | 1.3 GB |
| DeepSeek-V3 | MLA (1 latent, 576 dim) | 0.27 GB |
| Mixtral-8x22B | GQA (8 KV heads) | 0.94 GB |
| Kimi K2 | MLA | 0.27 GB |
| gpt-oss-120b | Windowed-GQA | 0.15 GB |
| Qwen3.5-397B | Hybrid | 0.12 GB |
关键洞察:即使更小的缓存(如DeepSeek-V3的270MB)在高并发下聚合需求仍超过100 GB/s,传输选择变得更为关键。
当前无法验证的方面
- 端到端离散化吞吐(实际工作负载混合下)
- ADP转换延迟的生产验证
- MoE专家跨NVLink域动态负载均衡
- CXL 3.0解码阶段访问模式
- KV缓存传输与推理计算共享互连fabric的干扰
七、相关工作
离散化推理
- DistServe [1]:分离预填充和解码,实现4.5倍吞吐提升,使用固定RDMA传输
- Splitwise [2]:同机放置两阶段,避免传输但限制调度灵活性
- Mooncake [3]:分布式KV缓存存储,基于容量而非拓扑进行放置决策
- NVIDIA Dynamo [4]:生产级离散化框架;其NIXL传输库[5]独立验证了方向,但未联合优化传输与专家分发
KV缓存管理
- vLLM [6]:PagedAttention高效KV缓存内存管理
- SGLang [7]:RadixAttention前缀共享
- Infinite-LLM [8]:分布式KV缓存
GPU互连优化
- NCCL [9]:训练工作负载的全reduce通信优化
- TopoOpt [10]:分布式DNN训练的网络拓扑优化
- BLINK [11]:分布式ML的快速通用通信
CXL for ML
- Pond [12]:CXL内存池化系统
- TPP [13]:CXL启用分层内存的透明页面放置
八、总结
核心贡献
-
拓扑感知传输选择:TopKV在启动时通过硬件查询(discovery GPU互连图),为每次KV缓存传输选择最高带宽传输(NVLink同域、PCIe同节点跨域、RDMA跨节点、TCP回退)
-
NVLink域感知MoE路由:首次联合优化MoE专家分发与KV缓存放置,三种路由策略(缓存亲和、专家局部性、负载均衡)最小化跨域流量
-
CXL 3.0溢出层建模:将CXL 3.0 Type 3内存扩展器建模为KV缓存溢出层,提供6倍容量,延迟比NVMe低86倍
技术影响
- 揭示了现有离散化系统忽略的72倍带宽层次结构问题
- 提出层间流水线传输,可隐藏76-100%传输延迟
- 为MoE模型的KV缓存传输与专家路由联合优化奠定基础
- 首次建模CXL作为推理KV缓存溢出层的可行性
局限性
- 当前为系统设计论文(Frontiers Track),端到端评估需要多节点GPU集群
- 8节点DGX H100集群月租金超$200K,超出学术资源
- GPU云提供商不向租户暴露NVLink拓扑
- CXL 3.0 Type 3内存扩展器(Samsung CMM-D, Micron CZ120)处于早期采样,无云可用性
- 系统实现验证了编排逻辑,但硬件集成等待实际集群访问
关键数据总结
| 指标 | 值 |
|---|---|
| 带宽层次差异 | 72× (NVLink 4.0) → 144× (NVLink 5) |
| KV缓存传输延迟降低 | 3-18× vs 统一RDMA |
| 流水线隐藏传输延迟 | 76-100% |
| NVLink传输完全隐藏 | 是 |
| PCIe传输完全隐藏 | 是 |
| CXL vs NVMe延迟优势 | 86× |
| CXL容量扩展倍数 | 6× HBM |
| 可持续请求速率提升 | 18× (NVLink vs RDMA) |
九、参考资源
- 论文: https://arxiv.org/abs/2607.28633
- DOI: https://doi.org/10.48550/arXiv.2607.28633
- 版本历史:
- v1: 2026-04-19
- v2: 2026-08-07 (修正MLA压缩比、GQA sizing因子、流水线百分比、PCIe Gen5、NIXL定位等)
- 相关系统:
- DistServe: OSDI 2024
- Splitwise: ISCA 2024
- Mooncake: arXiv:2407.00079
- NVIDIA Dynamo/NIXL: 2025-2026