llm-inference p-d-disaggregation kv-cache network-optimization selective-transfer self-hosted cloud-gpu rdma
SmartGen: Seamless Disaggregated LLM Inference with Selective KV Cache Transfer
SmartGen 解决自托管 LLM 推理中 P/D 分离架构的网络瓶颈问题,通过三种 KV 缓存传输路径(Profile-based Proactive、Parallel On-demand、Speculative Transfer)实现无缝分离推理
SmartGen: Seamless Disaggregated LLM Inference with Selective KV Cache Transfer
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | SmartGen: Seamless Disaggregated LLM Inference with Selective KV Cache Transfer |
| 作者 | Xuchuan Luo, Jiacheng Shen, Xin Wang, Yangfan Zhou |
| 机构 | Shanghai Jiao Tong University(推测) |
| 论文 | arXiv:2607.28150 |
| 发布 | 2026-07-30 |
| 领域 | LLM 推理系统、P/D 分离、KV 缓存优化 |
二、核心思想
问题定义
LLM 推理中的 P/D 分离架构(Prefill/Decoding Disaggregation)通过将两个阶段分配到独立节点实现灵活的资资源配。然而,自托管(self-hosted)部署场景面临严峻的网络瓶颈:
- KV 缓存传输时间开销巨大:48K token 上下文传输耗时是 prefill 计算的 6.5×
- 云 GPU 实例网络带宽有限:L4、L40S 等实例仅提供 15–25 Gbps
- 现有方案逐层传输 KV 缓存,无法缓解网络饱和问题
解决方案概述
SmartGen 提出选择性 KV 缓存传输,通过三种传输路径协同工作:
- Profile-based Proactive Transfer:基于位置相似性识别通用重要 KV 条目,在 prefill 阶段主动推送
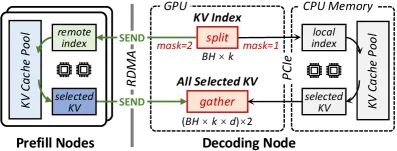
- Parallel On-demand Transfer:将 KV 索引拆分为本地/远程两部分,双车道并行加载
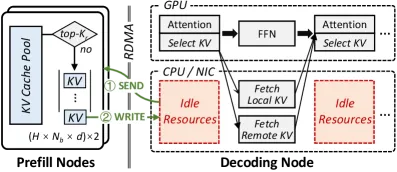
- Speculative Transfer:利用注意力计算期间的空闲资源,在后台传输剩余 KV 条目
三、技术架构
整体框架
SmartGen 将 KV 缓存条目分为三类,对应三条传输路径:
| KV 类型 | 传输路径 | 时机 | 目标 |
|---|---|---|---|
| 通用重要条目 | Profile-based Proactive | Prefill 阶段 | 提前推送 |
| 上下文相关条目 | Parallel On-demand | Decoding 阶段 | 按需获取 |
| 次要条目 | Speculative | 解码后台 | 投机传输 |
核心机制
0. 位置相似性观察
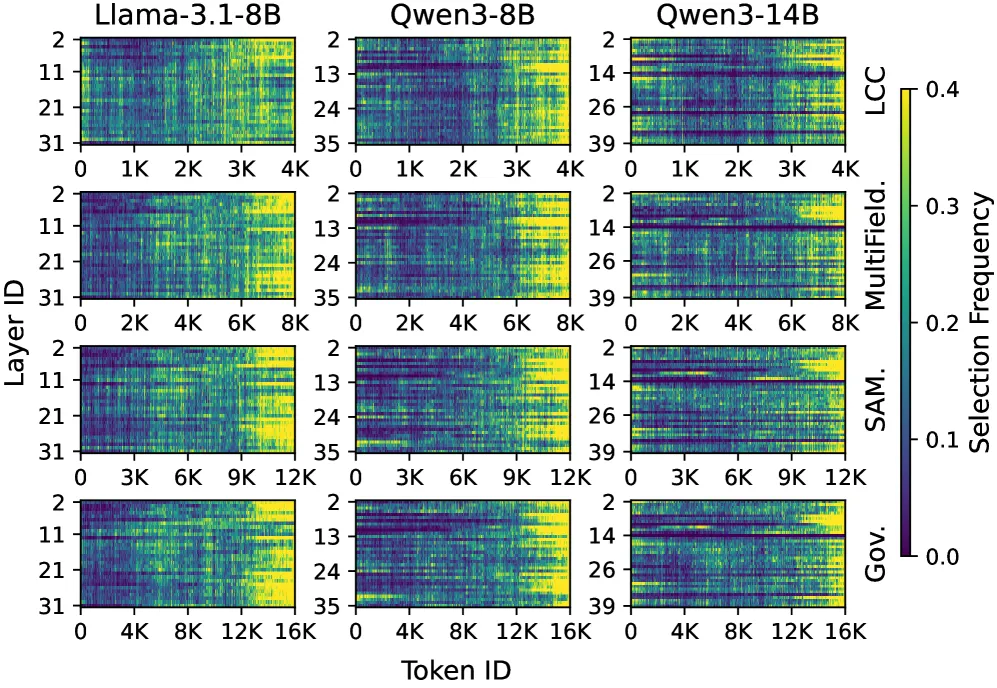
1. 位置相似性(Positional Similarity)
重要 KV 条目在输入序列中倾向于出现在相似位置。论文通过分析发现,InfiniGen 选择的 KV 条目在不同模型和数据集上呈现高度一致的位置分布。
2. 双车道并行获取
将 KV 索引拆分为本地索引和远程索引:
- 本地车道:从 host memory 加载已缓存的 KV 条目
- 远程车道:通过 RDMA RPC 从 prefill 节点获取缺失条目
- 两个车道并行执行,消除网络往返的关键路径延迟
3. 投机传输
利用注意力计算期间暴露的空闲 CPU 和 RDMA NIC 资源:
- 在当前层执行注意力计算时,后台传输下一层所需的远程 KV 条目
- 避免与 on-demand 传输竞争网络和计算资源
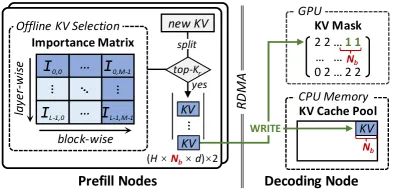
四、核心创新
| 创新点 | 说明 | 实验依据 |
|---|---|---|
| 选择性 KV 传输 | 通过 KV 选择算法减少传输量 | 传输时间减少 60%+ |
| 位置相似性观察 | 重要 KV 条目具有跨样本位置一致性 | Figure 5 验证 |
| 双车道并行 | 本地/远程 KV 并行加载 | 消除网络往返延迟 |
| 投机传输 | 利用空闲网络资源后台传输 | TBT 开销最小化 |
| 通用性设计 | 兼容 InfiniGen 和 HATA 等选择算法 | 与两种基线集成均有效 |
五、代码实现分析
实验设置
测试平台:阿里云 GPU 实例
| 实例类型 | GPU | vCPU | DRAM | 网络 |
|---|---|---|---|---|
| ecs.gn8is-2x.8xlarge | 2× L20 (2×48GB) | 32 | 256GB | 32 Gbps |
| ecs.gn8is.4xlarge | 1× L20 (48GB) | 16 | 128GB | 25 Gbps |
| ecs.gn8is.2xlarge | 1× L20 (48GB) | 8 | 64GB | 15 Gbps |
模型:Qwen3、Llama-3.1、Gemma-3、Phi-4
工作负载:LongBench 基准(MultiFieldQA、GovReport、SAMSum、LCC)
参数配置
- KV 块数 :1K
- DP 程度:6
- 输出长度:64 tokens
- 投机比例:10%
- prefix cache 命中率:75%
六、实验结果
主要性能对比
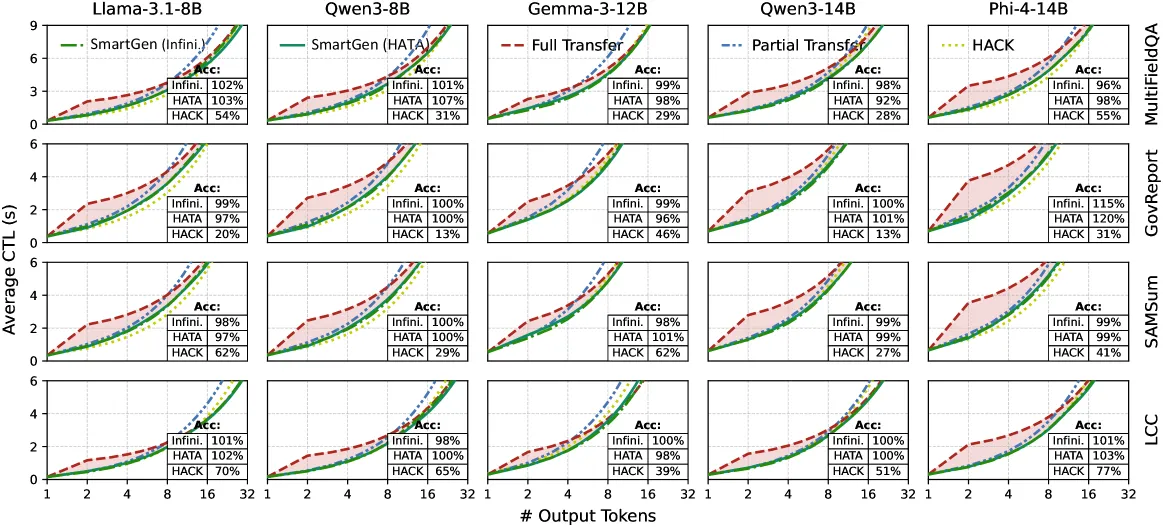
关键指标:
- CTL(Cumulative Per-Token Latency):平均每请求累计延迟
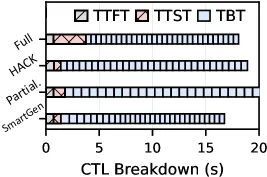
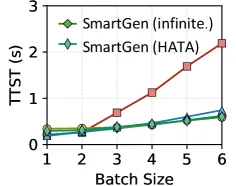
- TTST(Time-to-Second-Token):KV 传输性能
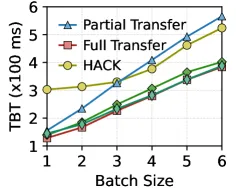
- TBT(Time-Between-Tokens):解码开销
性能提升
相比 Full Transfer 基线,SmartGen 实现:
- TTST 降低 60%+:消除 stage-transition stall
- CTL 显著改善:平均延迟大幅下降
- 精度保持:在 LongBench 上保持与 full-cache 相当的准确率
批量大小影响
带宽敏感性
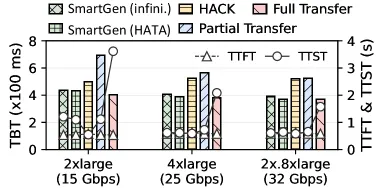
在不同网络带宽下(15 Gbps / 25 Gbps / 32 Gbps),SmartGen 均显著优于 Full Transfer 和 HACK 量化方案。
消融研究
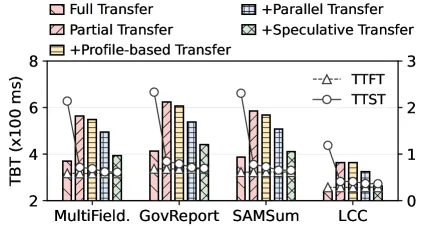
各技术组件的贡献:
- Profile-based Proactive Transfer:消除 prefill 阶段传输阻塞
- Parallel On-demand Transfer:消除解码阶段网络往返
- Speculative Transfer:进一步降低 TBT 开销
七、相关工作
LLM 推理系统
- vLLM, TGI, SGLang:单体推理引擎
- DistServe, Splitwise, TetriInfer:P/D 分离架构
- Mooncake, Dynamo:商业级分离推理系统
KV 缓存管理
- InfiniGen, HATA:KV 选择算法
- Quest, H2O:基于注意力分数的缓存压缩
- RetroInfer:检索增强的 KV 缓存管理
量化方案
- HACK:同态量化压缩 KV 缓存到 int2
八、总结
核心贡献
- 识别并量化了自托管 P/D 分离推理的网络瓶颈:48K 上下文传输耗时是 prefill 的 6.5×
- 提出位置相似性观察:重要 KV 条目具有跨样本位置一致性
- 设计三种传输路径协同的 SmartGen 引擎:Proactive + On-demand + Speculative
- 实验验证显著性能提升:在多种模型和云实例配置下均有效
技术影响
- 为自托管 LLM 部署提供了实用的 P/D 分离解决方案
- 位置相似性观察可启发其他 KV 缓存优化研究
- 三路径架构可推广到其他受限网络场景的推理系统
局限性
- 依赖 KV 选择算法的准确性
- 投机传输可能受网络波动影响
- 当前评估主要在阿里云平台,需更多云厂商验证
九、参考资源
- SmartGen 论文: https://arxiv.org/abs/2607.28150
- InfiniGen: OSDI 2024
- HATA: ACL 2025
- HACK: SIGCOMM 2025
- Mooncake: FAST 2025
- DistServe: OSDI 2024
- Splitwise: ISCA 2024
- LongBench: ACL 2024