A Photonic-CXL Memory Appliance for Scalable KV Cache Management in LLM Inference
Marvell Photonic Fabric Memory Appliance — 用无源光纤全互连拓扑替代电交换机,实现32TB共享DDR5内存的CXL内存池化
A Photonic-CXL Memory Appliance for Scalable KV Cache Management in LLM Inference
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | A Photonic-CXL Memory Appliance for Scalable KV Cache Management in LLM Inference |
| 作者 | Jing Ding, Yash Nishant, Chandrish Ambati, Jyothsna Kamati, Trung Diep |
| 机构 | Marvell Technology, Santa Clara, USA |
| 论文 | arXiv:2607.27187 |
| 发布 | 2026-07-29 (cs.PF) |
| 许可 | 未明确 |
| 平台 | Siemens Veloce Strato-M 仿真 + LLMServingSim |
二、核心思想
问题定义
LLM推理面临内存墙(Memory Wall):KV缓存需要数十TB容量和数百GB/s带宽,但当前没有任何内存层能同时满足这两个需求。
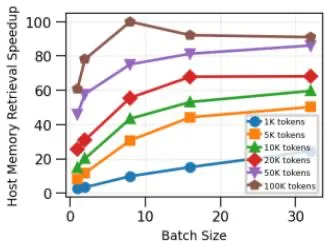
论文对跨代GPU系统(A100/H100/H200)和多种LLaMA模型(8B~405B,上下文至4M tokens)的系统性表征揭示了这一差距:
- 主机内存(Host DRAM):检索KV缓存比GPU重计算最高快100×,但容量受限(2TB),仅能支持数十个并发长上下文用户
- SSD存储:容量大但带宽受限,最高仅**9.7×**加速
- 电气CXL池化:理论上可桥接容量-带宽差距,但交换机延迟(70–500 ns/跳)、线缆距离限制(≤2m铜缆)、功耗超线性扩展等问题阻碍了实用化TB级部署
解决方案概述
Marvell Photonic Fabric (PF) Memory Appliance 是一种光子-CXL混合架构,用**无源光纤shuffle(passive fiber shuffle)**替代电气交换机,通过16×16全互连拓扑(full-mesh)提供32TB共享DDR5内存,跨16个主机,每主机128 GB/s单向带宽。
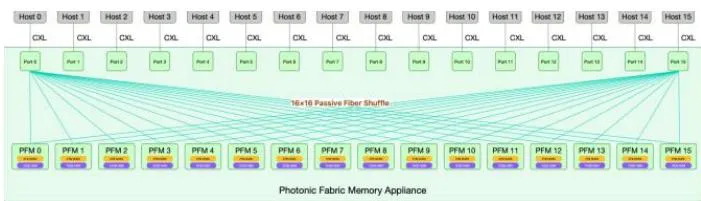
核心创新:256条专用光路径构成全网格拓扑,消除交换机仲裁延迟,所有16个主机可同时访问不同内存模块而无争用。仿真结果展示:
- 对比电气CXL池,延迟降低超过50%(350 ns vs 800–900 ns)
- 多轮对话工作负载TTFT改善6.6×
- 消除缓存驱逐悬崖(eviction cliffs)
三、技术架构
KV缓存传输路径演进
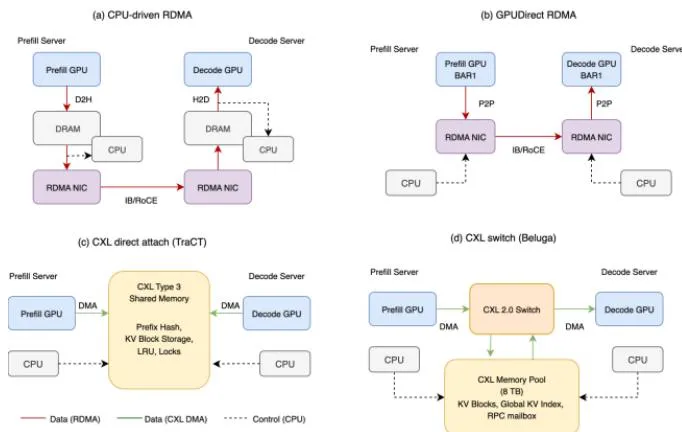
论文梳理了分离式推理中KV传输路径的四个阶段:
| 阶段 | 机制 | PCIe穿越次数 | 延迟 | 局限 |
|---|---|---|---|---|
| (a) CPU驱动RDMA | GPU→DRAM→NIC→网络→NIC→DRAM→GPU | 4次 | 高 | DRAM bounce开销 |
| (b) GPUDirect RDMA | GPU→NIC→网络→NIC→GPU (P2P) | 2次 | 2–15 µs | BAR读3.4–7 GB/s;点对点无复用 |
| (c) CXL共享内存 | GPU→CXL设备 (load/store) | 1次 | ~200 ns | 电气交换机限制 |
| (d) PF Memory Appliance | GPU→PF-NIC→光纤→PF内存模块 | 1次 | ~350 ns | 无交换机,100+米距离 |
每代演进从关键路径上移除组件:(a)→(b)消除DRAM bounce;(b)→(c,d)消除网络栈。CXL模式额外实现写一次读多次的KV复用,并消除KV位置感知调度。
PF Memory Appliance系统架构
整体规格:
| 参数 | 值 |
|---|---|
| 共享DDR5容量 | 32 TB |
| HBM3E容量 | 1.125 TB(可配置为write-through缓存或额外池化内存) |
| PF Memory Module数 | 16 |
| 光路径数 | 256(16×16全网格) |
| 每端口双向带宽 | 7.2 Tbps |
| 总光交换带宽 | 115 Tbps |
| 每主机单向带宽 | 128 GB/s(PCIe Gen6限制) |
| 主机接口 | CXL 3.1 Type 3 / PCIe Gen6 |
| 每PF Memory Module | 2×HBM3E (36GB) + 8×DDR5 (至2TB) |
PF Memory Module设计
2.5D电光多芯片模块(MCM),包含:
- 7.2 Tbps光子结构光互连
- 两个HBM3E堆叠(每36GB)
- 八个DDR5接口(至2TB DDR5内存)
- 光子集成电路(PIC)中介层
- 光纤阵列单元(FAU)
光子技术选择:采用GeSi电吸收调制器(EAM),而非微环谐振器(MRR)或马赫-曾德调制器(MZM):
- MRR:高调制效率但需主动波长调谐(热敏感性增加功耗)
- MZM:热稳定但需毫米级器件长度
- EAM:热稳定 + 亚100μm尺寸,可与ASIC紧密集成无光学链路退化
PIC与ASIC分离制造:电子部分使用4nm/5nm CMOS,PIC优化光学性能。2.5D/3D封装消除长距离SerDes所需的DSP,功耗显著低于传统可插拔光模块或电气CXL方案。
PF-NIC主机连接
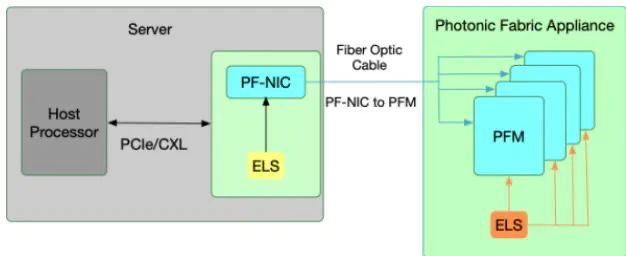
PF-NIC是PCIe Gen6/CXL 3.1适配卡,桥接主机CXL接口到光子结构互连。PF-NIC包含PF Memory Module的简化版(仅PF ASIC + 光连接,无DDR5/HBM)。PF-NIC在主机接口端终止CXL链路,从传入flit中提取CXL.mem事务字段,转发为光子结构包到目标PF Memory Module。外部激光源(ELS)为PF Memory Module和PF-NIC提供光照明。
无源光纤shuffle的优势
对比电气CXL交换机架构的三大根本限制:
| 电气CXL限制 | PF Memory Appliance解决方案 |
|---|---|
| 交换机延迟 70–500 ns/跳 + 仲裁延迟 | 256专用光路径消除交换仲裁,确定性延迟无争用 |
| 线缆距离 ≤2m铜缆,需retimer扩展 | 光纤传输100+米,距离无关功耗 |
| 功耗超线性扩展 随端口数和距离 | 全互连带宽线性扩展,每主机维持128 GB/s |
四、核心创新
| 创新点 | 说明 | 实验依据 |
|---|---|---|
| 无源光纤全网格拓扑 | 256条专用光路径替代电气交换机,消除交换仲裁延迟 | 仿真显示350 ns vs Beluga 800–900 ns(>50%降低) |
| PF Memory Module电光集成 | GeSi EAM + PIC/ASIC分离制造 + 2.5D封装 | 100%带宽利用率跨所有16端口,25.6 GB/s每端口 |
| HBM3E + DDR5混合内存 | HBM作为write-through缓存,DDR5提供大容量 | HBM带宽余量确保PF链路满利用率 |
| CXL 3.1协议兼容 | 主机端标准CXL.mem语义,无需修改软件栈 | 支持vLLM/SGLang/Dynamo现有可插拔接口 |
| Rendezvous一致性协议 | 跨主机共享内存的会合式一致性,避免逐行flush/fence | GPU DMA完成事件确保数据到达, rendezvous信号发布后可见 |
五、代码实现分析
仿真验证平台
Siemens Veloce Strato-M仿真平台:
- 全Strato-M机箱,4个容量模块 + 64个ABV
- 仿真两个SoC实例:PF-NIC和PF Memory Module,通过16条PF链路互连
- PF-NIC集成CXL内存控制器,连接Siemens VirtuaLab transactor(仿真PCIe/CXL Root Complex)
- QEMU建模CPU运行guest Linux作为PCIe/CXL主机
- C/C++基准程序在guest中生成内存读写请求
软件集成架构
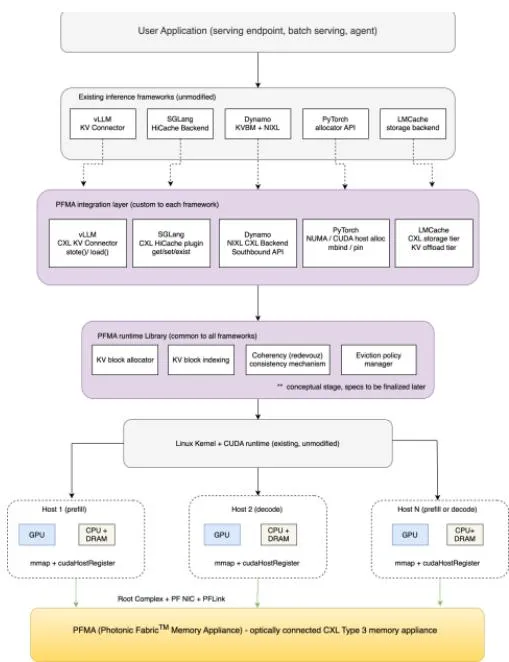
OS级设备发现:
- 启动时平台固件通过PCIe链路训练发现设备
- DVSEC标识CXL能力,HDM寄存器确定容量和交叉粒度
- CEDT包含CHBS和CFMWS描述主机物理地址范围
- Linux CXL子系统验证CEDT,配置HDM解码器,暴露为Device-DAX设备(
/dev/daxN.M)
多主机共享内存:
- 每主机通过
mmap()映射DAX设备,cudaHostRegister()注册CUDA页锁定 - 共享数据结构使用偏移地址(offset-based addressing)而非虚拟指针
- Rendezvous一致性:生产者写KV块后发rendezvous信号,消费者观察rendezvous后访问
推理框架集成(无需修改引擎内部):
| 框架 | 集成方式 |
|---|---|
| vLLM | CXL KV connector — store()/load()通过cudaMemcpyAsync实现GPU↔PF DMA |
| SGLang | HiCache storage backend — get/exist/set接口,注册为HiCache层级树中的新层 |
| Dynamo | NIXL backend plugin — 实现South-Bound API(registerMem, connect, prepXfer, postXfer),自动路由到所有NIXL集成引擎 |
| PyTorch | NUMA-aware CPU allocator(mbind)或CUDAHost allocator;未来PyTorch RFC支持原生内存类型标注 |
六、实验结果
KV缓存检索效率表征(Table I)
跨多代GPU + LLaMA模型的系统性测量,batch sizes {1, 2, 8, 16, 32}:
| 模型 | 平台 | 主机内存加速 | 磁盘存储加速 |
|---|---|---|---|
| LLaMA-8B | 1×A100 | 3.3×–27.5× | 0.53×–1.72× |
| LLaMA-8B | 1×H100 | 1.9×–11.8× | — |
| LLaMA-8B | 1×H200 | 1.5×–17.2× | 0.38×–1.27× |
| LLaMA-70B | 2×H200 | 2.7×–51.4× | — |
| LLaMA-405B | 8×H200 | 2.7×–100.0× | 2.1×–9.7× |
| Maverick | 8×H200 | 2.7×–23.1× | — |
| Scout | 8×H200 | 2.6×–54.6× | — |
关键发现:
- 405B模型在8×H200上达100×加速:KV缓存需求大(48GB/100K tokens vs 8B的12GB),8 GPU聚合带宽达165 GB/s
- 主机内存加速随模型大小和上下文长度显著增长
- 磁盘存储加速有限(最高9.7×),受带宽瓶颈制约
带宽表征(仿真)
PF Memory Module在16个端口上实现100%带宽利用率,每端口25.6 GB/s(扣除协议和元数据开销后)。该吞吐在32B–1KB传输大小和线性/随机访问模式下均保持,确认HBM缓存提供充足带宽余量。
延迟表征(仿真)
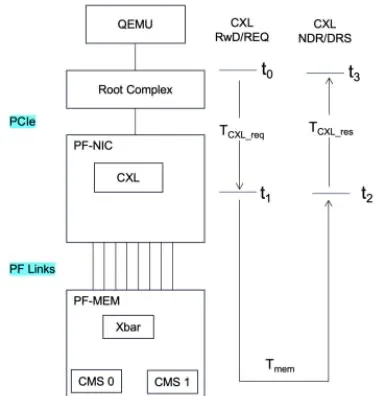
延迟分解公式:
其中 为CXL控制器请求处理时间, 为从CXL协议接口到内存子系统的传播时间, 为CXL控制器响应处理时间。
空闲延迟(Idle):
| 操作 | 总延迟 | |||
|---|---|---|---|---|
| Write | 24 ns | 153 ns | 47 ns | 224 ns |
| Read | 24 ns | 212 ns | 47 ns | 283 ns |
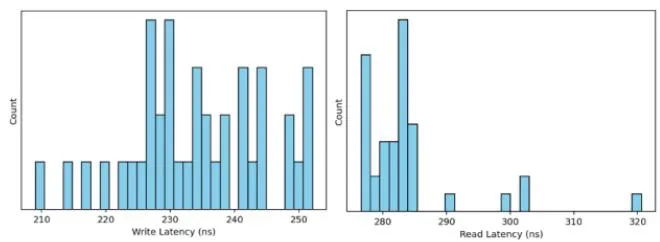
负载延迟(Loaded):
- Write:集中在210–250 ns范围,中等负载敏感性
- Read:275–290 ns为主,尾部延伸至320 ns(数据返回依赖增加排队延迟)
对比电气CXL:Beluga(CXL 2.0交换内存池)平均CPU-to-pool延迟800–900 ns(64字节访问)。PF Memory Appliance平均350 ns,降低超过50%。
服务性能评估(LLMServingSim仿真)
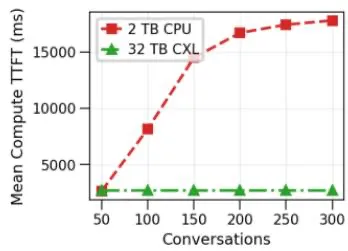
配置:LLaMA 405B,8×H200 DGX,2TB主机DRAM
| 配置 | 32TB PF Appliance | 2TB Baseline |
|---|---|---|
| 50会话 | TTFT 2,690 ms | TTFT 2,690 ms |
| 100会话 | TTFT 2,690 ms | TTFT 8,156 ms(3×劣化) |
| 300会话 | TTFT 2,690 ms | TTFT 17,754 ms(6.6×劣化) |
| 缓存命中率 | 82% | 100会话起下降,300会话时6.35% |
工作负载:多轮对话,每对话10轮,每轮5,120输入token + 500输出token,512 token共享系统前缀。
关键发现:
- PF Appliance的32TB容量使TTFT保持平坦(2,690 ms),不受会话数影响
- 2TB baseline在100会话时LRU驱逐开始强制重计算,TTFT急剧上升
- 300会话时差距达6.6×,前缀命中率从82%崩溃至6.35%
- 单8×H200系统可服务64×更多并发多轮对话
七、相关工作
KV缓存管理系统
- PagedAttention (vLLM):块式KV管理,碎片从60-80%降至<4%
- RadixAttention (SGLang):基数树自动前缀复用
- HiCache (SGLang):GPU/CPU DRAM/分布式存储分层,6×吞吐 + 80% TTFT降低
- Dynamo KVBM (NVIDIA):最完整的分层层次 + KV感知路由 + NIXL跨节点传输
- LMCache:中间件抽象异构后端 + 内容哈希去重
- Mooncake:集群级KV缓存分离,但受RDMA带宽限制(~15 GB/s/NIC)
- CacheBlend:选择性地重计算5-18% token实现非前缀复用
- CacheGen:KV缓存压缩3.5-4.3×
- InfiniGen:投机预取关键KV条目
- KVQuant:亚4-bit量化支持10M+ token上下文
- FlashAttention:最小化GPU SRAM↔HBM数据移动
CXL内存分解
- Pond:8-16 socket CXL池,70-90 ns开销,机架级>180 ns
- DirectCXL:8.3×低于RDMA的延迟
- TPP:透明页放置(已并入Linux内核)
- Melody:商业CXL设备延迟不稳定,p99.99 > 700 ns–1 μs
- COAXIAL:用CXL替代所有DDR,1.39×平均加速
- TraCT:CXL机架级KV缓存共享
- Beluga:CXL作为KV传输基底和前缀缓存
光子互连
- Broadcom Tomahawk 6:集成光引擎,~5 pJ/bit
- Intel OCI:4 Tbps at 5 pJ/bit,100m距离
- GeSi EAM:>100 GHz带宽,亚100μm长度;400 Gb/s每通道
- Lightmatter Passage M1000:34芯片,114 Tbps光带宽
- Ayar Labs TeraPHY:8 Tbps UCIe光学芯片,支持CXL协议
- NVIDIA SN6800:集成光纤shuffle验证了无源光shuffle概念
PF Memory Appliance的独特定位:结合CXL load/store语义 + 无源16×16光纤shuffle,实现无交换机机架级内存池化,直接解决电气CXL三大限制(距离、延迟、功耗)。
八、总结
核心贡献
- 系统性表征:跨A100/H100/H200 + LLaMA 8B-405B + 上下文至4M tokens的KV缓存检索效率测量,量化容量-带宽差距
- PF Memory Appliance架构:无源光纤shuffle替代电气交换机,32TB共享DDR5 + 1.125TB HBM3E,16主机全网格拓扑
- 仿真验证:Siemens Veloce Strato-M仿真显示>50%延迟降低 + 100%带宽利用率;LLMServingSim显示6.6× TTFT改善
- 软件集成方案:vLLM/SGLang/Dynamo/PyTorch现有可插拔接口集成,无需修改引擎内部
局限性
- 磁盘存储实验仅覆盖8B和405B模型,MoE变体(DeepSeek/Qwen)待评估
- 服务性能来自仿真参数输入LLMServingSim,物理硬件端到端验证待完成
- 当前仅评估单主机到PF Appliance,多主机共享KV复用场景待扩展
- 成本效益分析(对比CXL交换机层次、主动光互连、增加服务器)待补充
- 物理PF Memory Appliance硬件预计”今年晚些”可用
技术影响
PF Memory Appliance展示了光子互连在解决CXL电气限制方面的潜力:无交换机全网格拓扑提供确定性低延迟,光纤距离无关性实现真正的机架级内存分解。若物理验证成功,该架构可能成为未来LLM推理基础设施的关键组件,尤其适用于多轮对话和长上下文工作负载的KV缓存管理。
九、参考资源
- arXiv: https://arxiv.org/abs/2607.27187
- Marvell Photonic Fabric: https://www.marvell.com/
- CXL Consortium: https://www.computeexpresslink.org/
- vLLM: https://github.com/vllm-project/vllm
- SGLang: https://github.com/sgl-project/sglang
- NVIDIA Dynamo: https://github.com/nvidia/dynamo
- NIXL: https://github.com/ai-dynamo/nixl
- LMCache: https://github.com/LMCache/LMCache
- Mooncake: https://github.com/mooncake-labs/mooncake