Kaleido: Algorithm-Hardware Co-Design for Video Diffusion Transformers
Kaleido 通过挖掘视频潜在空间通道级时空相关性,提出通道级复用算法与可重构 PE 阵列加速器,最高 6.6× 加速、18.4× 能耗节省,PSNR 提升 >17 dB
Kaleido: 基于通道级时空相关性的视频扩散 Transformer 算法-硬件协同设计
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Kaleido: Algorithm-Hardware Co-Design for Video Diffusion Transformers by Exploiting Latent Space Correlations |
| 作者 | Wenxuan Miao, Haosong Liu, Weiming Hu, Zihan Liu, Aiyue Chen, Jianlin Yu, Yiwu Yao, Yiming Gan, Jieru Zhao, Jingwen Leng, Minyi Guo, Yu Feng |
| 机构 | Shanghai Jiao Tong University, Shanghai Qi Zhi Institute, Huawei Technologies, ICT CAS |
| 论文 | arXiv:2607.13770 |
| 发布 | 2026-07-15 (v1) |
| 许可 | CC BY 4.0 |
| 关键词 | Video Diffusion Acceleration, Algorithm-Hardware Co-Design |
二、核心思想
Video Diffusion Transformers (vDiTs) 生成高质量视频但计算成本极高,主要由两个因素决定:
- 去噪时间步数量(30-100 步)
- 自注意力的二次复杂度()
随着蒸馏(TurboDiffusion)、缓存(PAB、Δ-DiT)等技术大幅减少时间步,自注意力已成为主要瓶颈(占 vDiT 总执行时间 ~68%)。
现有加速方法多从 LLM 借鉴稀疏注意力技术(SVG、MInference、Radial Attention 等),但这些方法直接迁移到视频生成存在根本性问题:
- LLM token 离散、分层语义,可安全剪枝长程无关依赖
- 视频 token 密集且承载连续视觉语义,每个 token 都对空间连贯性和时间一致性至关重要
- 早期去噪步需要全局信息,简单稀疏化导致运动不连续和闪烁伪影
Kaleido 提出算法-硬件协同设计,利用潜在空间中通道级时空相关性来加速 vDiTs 的所有操作:
核心洞察:vDiT 注意力模式的多样性根源是 RoPE 编码——不同通道组(t、x、y)编码不同方向的位置频率信息。主导通道决定了注意力图呈现”空间模式”(重复 tiles)还是”时间模式”(强对角相关)。
三、技术架构
整体框架
Kaleido 由两大部分组成:
- 通道级复用算法(算法层):识别可复用的计算并跳过冗余
- 可重构 PE 阵列 + 数据分发器(硬件层):高效支持复用算法
核心公式
扩散过程(预备知识):
自注意力:
其中 为注意力图,计算复杂度 。
RoPE 编码:
其中 。vDiT 将 通道分成三组:t-dim、x-dim、y-dim。
自注意力的相似性度量(沿预定义方向):
其中 和 是两个相邻 token 的单通道值。
其他操作的窗口式相似性度量:
其中 为沿一个通道的激活窗口, 为窗口大小。
通道分组机制(Table 1)
| 模型 | T-dim | X-dim | Y-dim |
|---|---|---|---|
| HunyuanVideo | 16 | 56 | 56 |
| Wan2.1 | 44 | 42 | 42 |
| TurboDiffusion | 44 | 42 | 42 |
| CogVideoX | 32 | 48 | 48 |
| LongCat | 44 | 42 | 42 |
| OpenSoraPlan | 32 | 32 | 32 |
设计决策:为简化调度和硬件映射,每个通道组限制沿一个固定方向复用(t→x, x→y, y→t)。
通道级复用算法(四步流程)
Step 1:计算相似性
沿预定义方向计算相邻 token 对之间的
Step 2:两级阈值检测
- 若 :标记为”完全复用”
- 若 :标记为”部分复用”
- 默认设置: 保留前 5 bit 精度, 保留前 3 bit 精度(8-bit 定点)
Step 3:部分注意力分数计算
- 完全复用:直接复用前一个 token 的部分注意力分数
- 部分复用:仅计算后续 4 bit(half-colored blocks)
- 不复用:执行完整 8-bit 乘法
Step 4:结果聚合
聚合所有通道组的部分注意力分数,计算最终注意力分数
复用算法总览
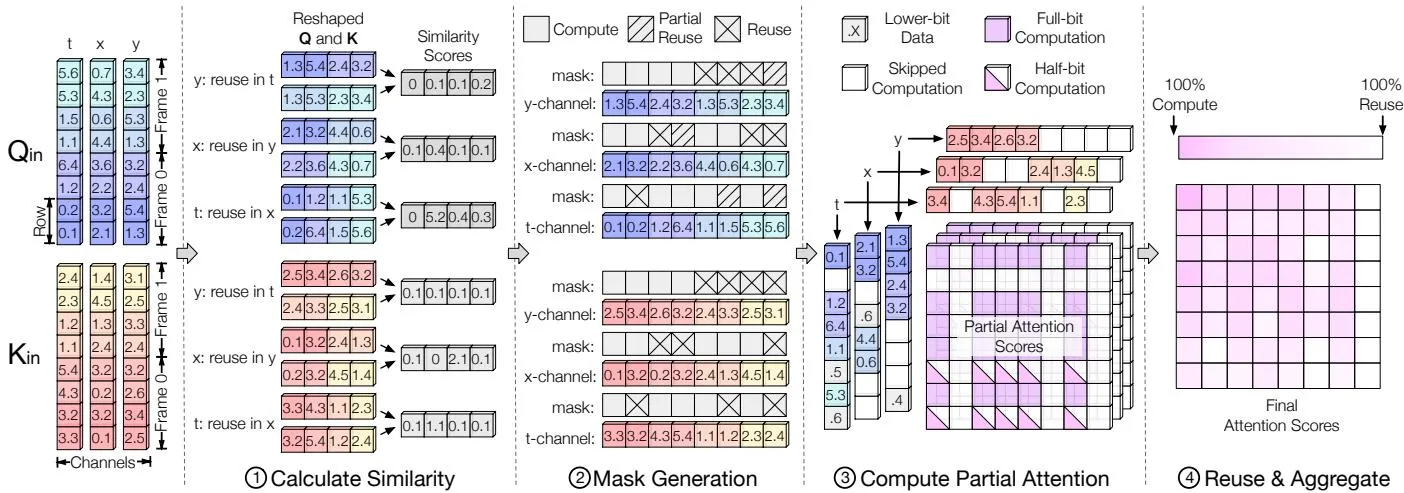
图 8. 通道级复用算法四步流程:(1) 计算相邻 token 沿选定轴的相似性,(2) 基于相似性识别可复用 token,(3) 计算部分注意力分数(可复用的 token 跳过显式计算),(4) 聚合结果。, 为示例值。
关键设计决策
为什么选择”复用”而非”跳过”?
- 稀疏注意力直接跳过低值 计算
- Kaleido 复用前一个 token 的部分结果,保留被利用的注意力信息
- Fig. 9 显示:在相同 token 节省率(85%)下,Kaleido 的 MSE 比两种跳过方法低一个数量级
为什么选择”通道级”而非”token 级”?
- 视频生成需要保持像素级的密集平滑内容
- Token 级合并(如 Token Merging、AdapTiV)丢失关键细节
- 不同通道组编码不同方向信息,通道级复用更精确
为什么选择”离线阈值”?
- Fig. 10 显示阈值对最终输出质量对 prompt 不敏感
- 可离线预设并应用于所有输入
vDiT 通道复用机制验证
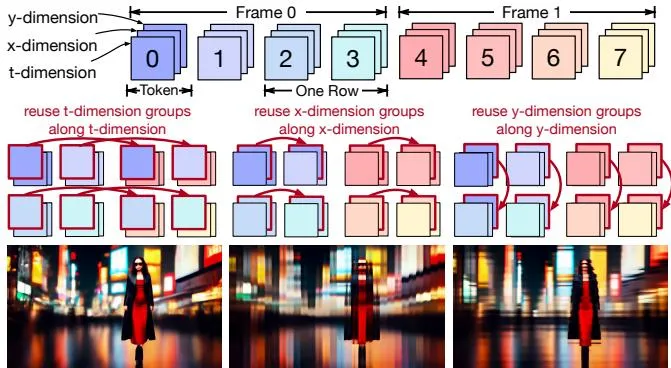
图 6. 不同通道组如何决定最终生成质量:上部分说明如何通过红色箭头复用不同通道组(T、X、Y),下部分展示复用后的结果。
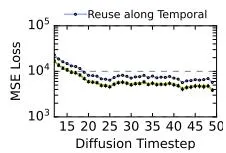
图 7a. T 通道组在不同去噪步复用不同方向的 MSE 损失
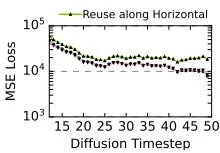
图 7b. X 通道组在不同去噪步复用不同方向的 MSE 损失
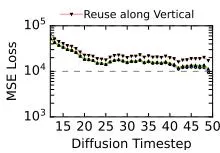
图 7c. Y 通道组在不同去噪步复用不同方向的 MSE 损失
图 7. 复用不同方向对不同通道组引入的 MSE 损失。对于给定通道组,沿其他两个方向复用比沿其自身方向复用产生更低的 MSE 损失——验证每个通道组主要捕获其对应维度的信息。
注意力模式分析
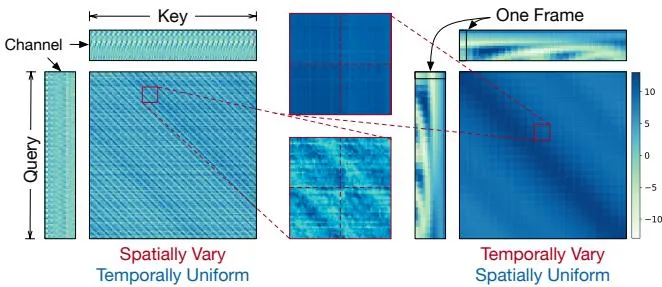
图 5. vDiT 中各种注意力模式示例,可分为空间模式(重复”tiles”捕获单帧内空间相关性)和时间模式(强对角相关捕获跨帧时间相关性)。两种模式均由 RoPE 编码和 Q/K 中的主导通道驱动。
四、硬件架构设计
整体架构
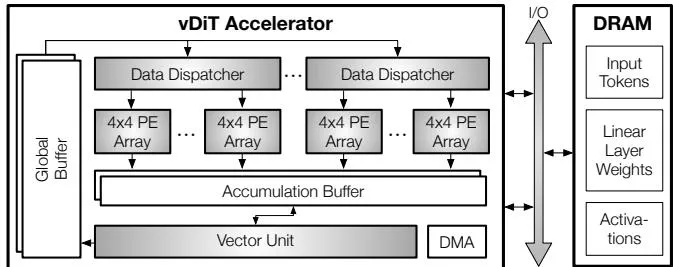
图 11. Kaleido 加速器整体架构:包含一组数据分发器、多个 PE 阵列和一个向量单元。PE 阵列负责 vDiTs 中计算密集型矩阵运算(自注意力),向量单元处理 Softmax 等逐元素操作。全局缓冲区和累加缓冲区均采用双缓冲设计。
主要组件:
- PE 阵列:128×128,每阵列 4×4 PEs,基于 1 GHz 经典 systolic array
- 向量单元:512 lane 并行,处理 Softmax 等
- 全局缓冲区:64 MB(输入数据 + 模型权重)
- 累加缓冲区:32 MB(输出数据)
- 数据分发器:调度器 + 匹配器,缓解 PE 利用不均
面积分析(Table 2):
| 组件 | 配置 | 面积 (mm²) |
|---|---|---|
| 4×4 PE 阵列 | 128×128 | 25.1 |
| 数据分发器 | 64×32 | 1.3 |
| 片上缓冲区 | 64 MB + 32 MB | 68.4 |
| 总计 | - | 94.8 |
- 相比基线 systolic array(96 MB 缓冲区),PE 增强增加 6.6% 面积,数据分发器增加 1.3% 面积
- TSMC 16nm FinFET 工艺
- 8-bit 定点数表示
通道分区与 PE 映射
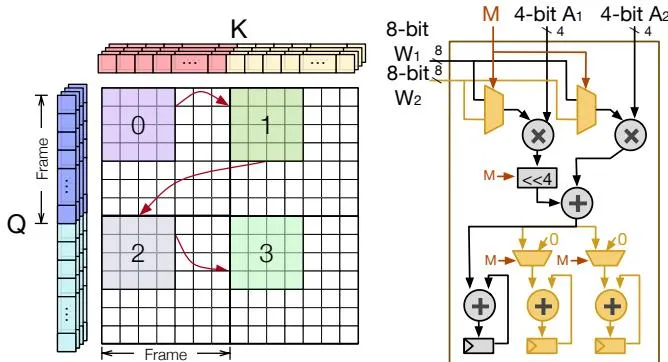
图 12. 沿 t 轴复用时的自注意力计算顺序:每 2×2 帧组成一个组,同一 N×N tile 跨 2×2 帧映射到单个 PE 阵列。N=4 时,先处理帧 0 的 4×4 注意力元素,然后依次计算帧 1、2、3 的相同元素。
PE 工作流(output-stationary 改进):
- 每 2×2 帧组映射到 PE 阵列
- 相同 N×N tile 跨 2×2 帧由同一 PE 阵列处理
- 以通道组为单位计算部分累加
- 完成一个通道组后存储到累加缓冲区
PE 单元设计
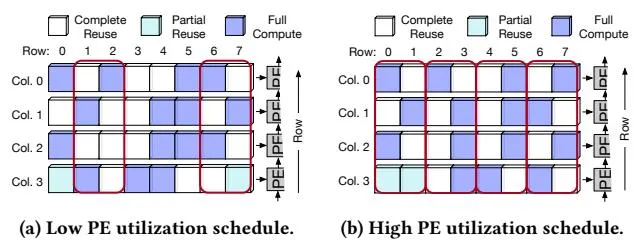
图 13. 单个 PE 单元设计:基于标准 8-bit MAC 单元增强。黄色部分为新增逻辑(两个额外寄存器 R1/R2 + 多路复用器)。控制信号 M 配置 PE 处于不同执行模式。
复用感知数据流(4 种模式)
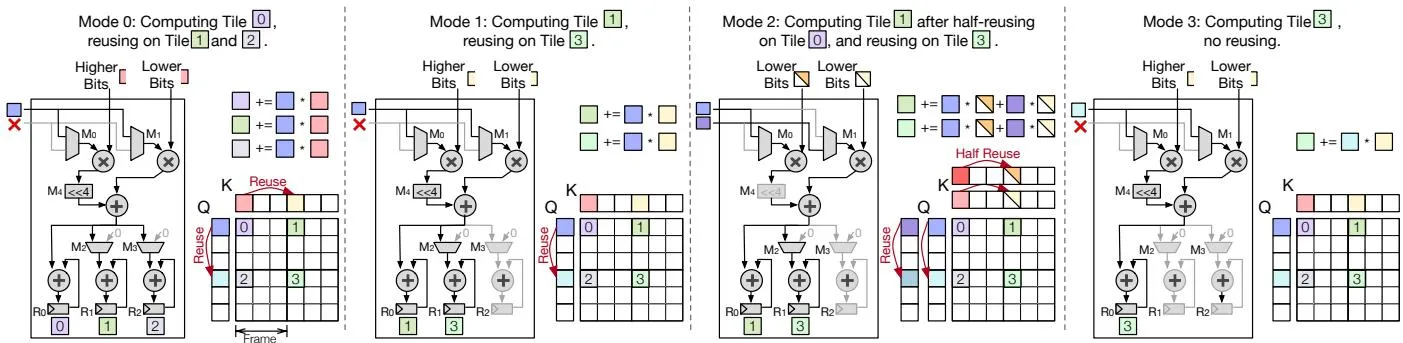
图 14. 单个 PE 的复用感知数据流:每帧 3×3 tiles 构成注意力图。展示沿 t 维复用的 4 种代表性执行模式,灰色表示计算中禁用的部分。
Mode 0:处理 Tile 0,三个寄存器存储 Tile 0/1/2 的累加值。K 从列端口读,Q 从行端口读,M2/M3 控制累加到 R1/R2。
Mode 1:处理 Tile 1 或 Tile 2,可被 Tile 3 复用。R2 存储 Tile 2 中间结果,R0/R1 存储 Tile 1/Tile 3 累加值。
Mode 2:Tile 1/Tile 2 部分复用 Tile 0 的前 h bit。两个 4-bit K 值通过列端口并行处理,结果分别累加到 R0/R1。
Mode 3:处理最后一个 tile(Tile 3),R1/R2 禁用,结果累加到 R0。
数据分发器设计
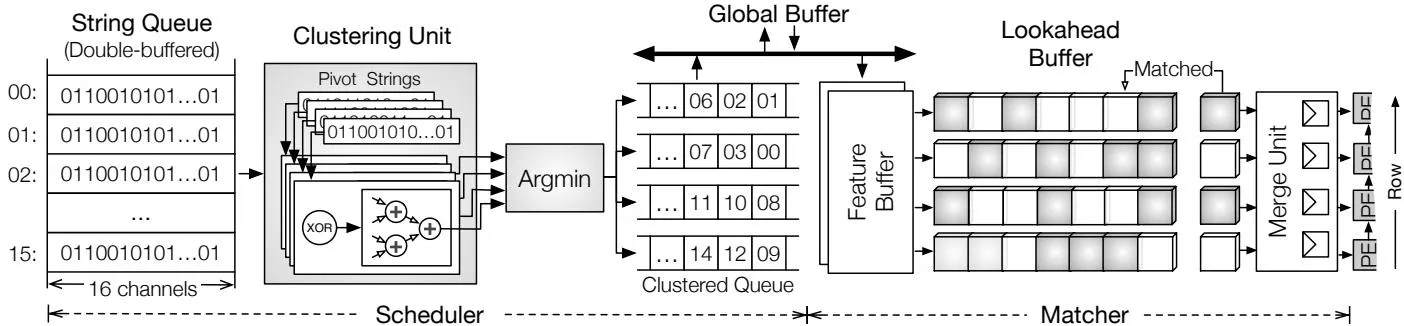
图 16. 数据分发器设计:由调度器和匹配器组成。调度器将具有相似复用模式的 token 分组以提高 PE 利用率;匹配器将每个 token 组内的通道配对以组合兼容的输入对。
调度器(Scheduler):
- 64 entry string queue,每个 entry 16-bit 字符串
- 随机选 4 个 pivot,计算 Hamming 距离,分配到最近 cluster
- 每个 cluster 容量 16 strings
- 可流水化,与后续矩阵计算重叠
匹配器(Matcher):
- 每个 PE 阵列配一个 matcher
- 每个 cycle 检查 4 个 token 的一个通道值
- 找到匹配则合并两个输入值;否则单独输入
能耗占比:仅占总能耗 0.1%
五、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| 首次系统表征 vDiT 通道级时空相关性 | 揭示注意力模式多样性根源是 RoPE 编码的通道分组 | Sec. 3 理论分析 + Fig. 7 MSE 验证 |
| 通道级复用算法 | 基于两级阈值识别完全/部分可复用 token,复用前一个 token 的部分结果 | 式(4)(5),>17 dB PSNR 提升 |
| 可重构 PE 设计 | 基于 8-bit MAC 增强 4 种执行模式,灵活适配不同复用模式 | Fig. 13-14 |
| 数据分发器(调度器+匹配器) | 解决不规则稀疏性导致的 PE 利用不均,PE 利用率从 69.4% 提升至 85.2% | Fig. 16,Sec. 7.3 消融 |
| 端到端算法-硬件协同设计 | 算法发现的通道级相关性直接指导硬件数据流设计 | 4 个主流 vDiT 模型验证 |
六、代码实现分析
- 硬件实现:基于经典 systolic DNN 加速器,16nm 工艺
- RTL 验证:使用 Synopsys 工具综合,Cadence 布局布线
- 功耗仿真:Synopsys PrimeTimePX + 完整 annotated switching activity
- DRAM 模型:16 通道 DDR5-6400,基于 Micron 规格
- 周期级仿真器:各组件延迟和能耗参数化自 post-synthesis 结果
- PE 数量:512×512 PEs @ 1 GHz(所有加速器基线统一)
- 数值精度:8-bit 定点数
七、实验结果
7.1 生成质量
Kaleido 量化结果(vs 三种近似基线 Cambricon-D、AdapTiV、Exion):
| 模型 | Kaleido PSNR (dB) | Cambricon-D PSNR | SSIM 范围 | LPIPS |
|---|---|---|---|---|
| HunyuanVideo | 29.9 | 12.9 | 0.87-0.90 | 最佳 |
| Wan2.1 | 24.5 | — | — | — |
| TurboDiffusion | 24.4 | — | — | — |
| CogVideoX | 26.5 | — | — | — |
- PSNR 提升 >17 dB(vs Cambricon-D)
- 所有模型 PSNR 提升 >6 dB(vs 所有先前的加速器方法)
- SSIM 达到 0.87-0.90,基线仅 0.50-0.78
- VBench 分数 ~0.81(与基线持平),优于所有近似方法
图像质量对比:
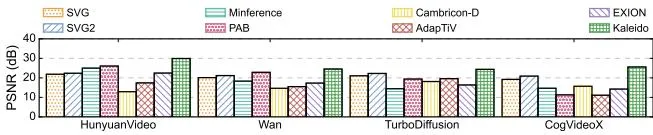
图 17a. PSNR 对比(越高越好)
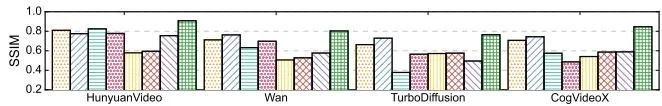
图 17b. SSIM 对比(越高越好)
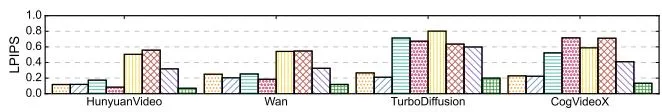
图 17c. LPIPS 对比(越低越好)
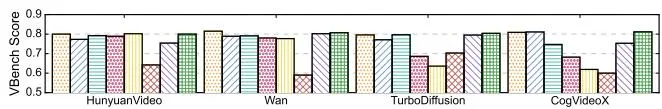
图 17d. VBench 分数对比(越高越好)
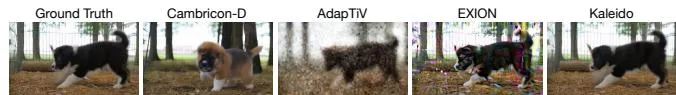
图 17e. HunyuanVideo 上的定性对比(放大查看细节)
7.2 性能对比
加速比(相对 A100):
| 模型 | Kaleido | AdapTiV | Cambricon-D | Exion | Ditto |
|---|---|---|---|---|---|
| HunyuanVideo | 6.6× | ~5× | 低 | 低 | 低 |
| Wan2.1 | 5.6× | — | — | — | — |
| TurboDiffusion | 5.2× | — | — | — | — |
| CogVideoX | 6.1× | — | — | — | — |
能耗节省(相对 A100):
| 模型 | Kaleido | 备注 |
|---|---|---|
| HunyuanVideo | 14.8× | AdapTiV 略高但质量差 |
| Wan2.1 | 15.6× | — |
| TurboDiffusion | 15.2× | — |
| CogVideoX | 18.4× | 最高 |
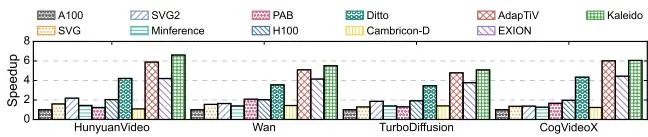
图 18a. 加速比对比
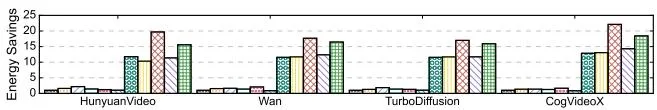
图 18b. 能耗节省对比
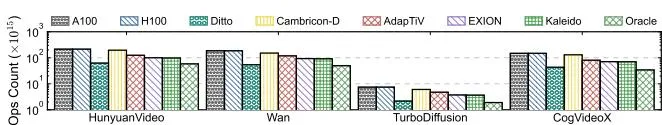
图 18c. 总体操作减少(越低越好):Oracle 达到 85% 理论操作减少;Kaleido 受硬件约束实际达 ~60%
7.3 消融实验
硬件消融(Fig. 19):
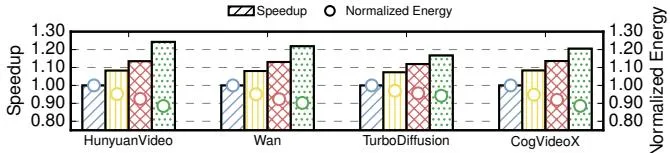
图 19. 硬件组件消融:Kaleido-pe(仅 PE 阵列)vs Kaleido-pe-sh(+调度器)vs Kaleido-pe-m(+匹配器)vs Kaleido(全设计)
- 加入数据分发器后:1.2× 加速、9.0% 能耗减少
- PE 利用率从 69.4% 提升至 85.2%
- 匹配器(matcher)贡献 > 调度器(scheduler)
算法消融(Fig. 20):
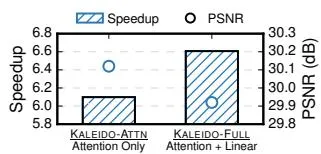
图 20. 在 HunyuanVideo 上应用 Kaleido 到 attention layers only vs all layers 的性能和生成质量对比
- 应用到所有层(包含 linear projections)有更高加速比
- PSNR 几乎不变
MSE 对比(Fig. 9):
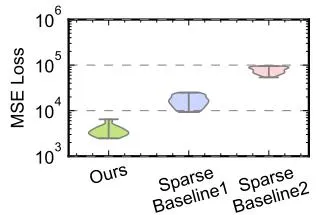
图 9. Kaleido 复用方法 vs 两种跳过技术的 MSE 对比(20 random prompts)
7.4 灵敏度研究
PE Size(Fig. 21):
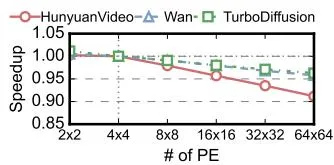
图 21. 速度对每个 PE 阵列 PE 大小的灵敏度(相对于 4×4 配置归一化)
- 更大 PE 阵列降低灵活性,PE 利用率下降
- 4×4 为最优选择
PE 阵列与缓冲区大小(Fig. 22):
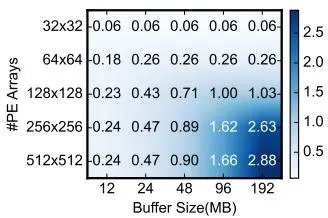
图 22a. 速度对 PE 阵列数量和缓冲区大小的灵敏度
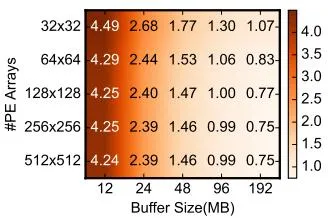
图 22b. 能耗对 PE 阵列数量和缓冲区大小的灵敏度
图 22. 性能和能耗效率对 PE 阵列数量和缓冲区大小的灵敏度(相对于 128×128 PE 阵列 + 96 MB 缓冲区归一化)
阈值灵敏度(Fig. 23):
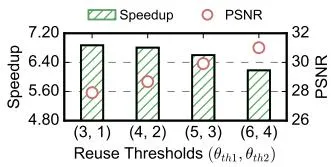
图 23. 速度和生成质量对复用阈值 和 的灵敏度
- 保留更少位:视觉质量显著下降
- 保留更多位:推理变慢
- 5/3 bits 是最佳折中
快速运动 Prompt(Fig. 24):
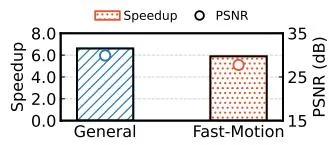
图 24. Kaleido 在 general prompts 和 fast-motion prompts 下的性能和生成质量对比(HunyuanVideo)
- 快速运动 prompt 速度略低(因时间变化减少可复用相关性)
- PSNR 仍保持稳定
Prompt 灵敏度(Fig. 10):
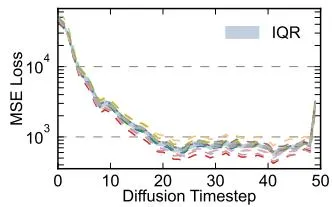
图 10. 复用技术精度对不同 prompt 的灵敏度(20 random prompts)—— 证明阈值可离线预设
7.5 可扩展性
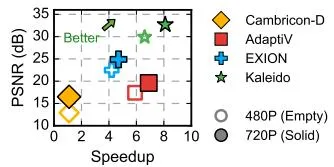
图 25. 生成 720p 高分辨率视频时不同方法的可扩展性
- 480p → 720p:Kaleido 加速比和质量均持续提升
- 因分辨率越高,时空相关性越强
7.6 与 AdapTiV、Exion 的对比
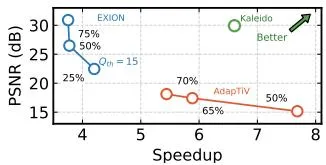
图 26. Kaleido vs AdapTiV vs Exion 在不同配置下的对比
- AdapTiV/Exion 更高压缩比下质量显著下降
- Kaleido 在更高速度下保持更高 PSNR
八、相关工作
| 方向 | 代表方法 | 与 Kaleido 关系 |
|---|---|---|
| 扩散加速算法 | DDIM, DPM-Solver, PAB, Astraea, ToCa | Kaleido 在通道级粒度工作,与时间步缓存方法互补 |
| 稀疏注意力 | MInference, SVG, SVG2, Sparse-vDiT | 丢弃低值注意力计算;Kaleido 复用保留信息 |
| 扩散加速器 | Cambricon-D, AdapTiV, Exion, Ditto | 探索计算稀疏性和时间步相似性;Kaleido 首次利用通道级时空相关性 |
| 稀疏加速 | Eyeriss, SparTen, S2TA, A³, SpAtten, Sanger | 探索矩阵-矩阵稀疏或注意力稀疏;Kaleido 针对 vDiT 独有特性 |
| 时空相似性 | EVA², Euphrates, Dify, ASV, VR-DANN, Deja View, Cicero | 在 CNN/VR 任务中利用时空相关性;Kaleido 首次扩展到 vDiT 通道级 |
九、总结
核心贡献
- 首次系统表征 vDiT 通道级时空相关性:揭示注意力模式多样性根源是 RoPE 通道分组,每个通道组编码特定方向(t/x/y)信息
- 通道级复用算法:基于两级阈值(默认 5/3 bits)识别完全/部分可复用 token,相比稀疏方法 >17 dB PSNR 提升
- 可重构 PE 设计:基于 8-bit MAC 增强 4 种执行模式(Mode 0-3),灵活适配不规则复用模式
- 数据分发器(调度器+匹配器):PE 利用率从 69.4% 提升至 85.2%,能耗占比仅 0.1%
- 端到端 6.6× 加速、18.4× 能耗节省:在 4 个主流 vDiT 模型(HunyuanVideo/Wan/TurboDiffusion/CogVideoX)上验证
局限性与未来方向
- 局限:仅验证 4 个模型、单一工艺(16nm)
- 未来方向:扩展到更新的 vDiT 模型、探索更低工艺节点
资助
- 教育部基础与交叉学科突破计划(JYB2025XDXM113)
- 国家自然科学基金(62532006, 62402312)
- 上海浦江人才计划(24PJA044)
- 上海期智研究院创新计划(SQZ202316)
十、参考资源
- 论文: https://arxiv.org/abs/2607.13770
- ArXiv HTML: https://arxiv.org/html/2607.13770v1
- HunyuanVideo: https://github.com/Tencent/HunyuanVideo
- CogVideoX: https://github.com/THUDM/CogVideo