VisCo: Leveraging Large Language Models as Intrinsic Encoders for Visual Token Compression
训练高效的自压缩框架,利用预训练 VLM 自身作为内在编码器压缩视觉 token
VisCo: Leveraging Large Language Models as Intrinsic Encoders for Visual Token Compression
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | VisCo: Leveraging Large Language Models as Intrinsic Encoders for Visual Token Compression |
| 作者 | Yupeng Zheng (USTC), Kai Zou (USTC), Bin Liu (USTC), Nenghai Yu (USTC) |
| 机构 | University of Science and Technology of China (USTC), Anhui Province Key Laboratory of Digital Security |
| 论文 | arXiv:2607.12756 |
| 代码 | 暂未公开 |
| 发布 | 2026-07-14 |
| 许可 | arXiv 非独占分发许可 |
| CCS | Computer vision |
| Keywords | Token Compression, Vision Language Models, Autoencoder |
二、核心思想
问题定义
Vision-language models (VLMs) 将高分辨率图像编码为大量视觉 token,显著增加了 self-attention 计算成本和 KV cache 存储开销,严重限制了 VLM 在资源受限和实时场景中的部署。
现有视觉 token 压缩方法存在两类主要局限:
- 免训练策略(Training-free):如 FastV、SparseVLM 依赖文本到视觉注意力进行启发式压缩,DART、VisionZip 基于特征相似度剪枝。但前者容易产生 attention shift 导致幻觉,后者无法保留文本引导的全局语义,在高压缩比下性能急剧下降。
- 训练型方法(Training-based):如 PruMerge、ACCM 引入轻量压缩模块但仍有限,QueCC、Matryoshka Query、VoCo-LLaMA、C&C 等方法依赖外部压缩模块或架构修改,需要昂贵的重新训练成本(重对齐、大规模指令微调),且损害了 VLM 的先验知识。
解决方案概述
VisCo 提出了一种训练高效的自压缩框架,核心思想是复用预训练 VLM 自身作为内在压缩器。具体而言:
- VisCo 是一个不对称的参数共享自编码器(Asymmetric Parameter-sharing Autoencoder)
- 在编码阶段引入 LoRA adapter + 少量可学习的 memory tokens,解码阶段移除 LoRA 直接复用冻结的预训练 LLM backbone
- 通过**层级信息传递机制(Hierarchical Information Passing)**从编码器各层提取 memory token 对应的 KV 值存入 memory bank,解码时直接填充到 decoder 的 KV cache 中
- 仅微调 memory tokens 和 LoRA 参数,保持 backbone 完全冻结
动机
有效视觉 token 压缩的关键在于强大的信息编码能力——这一能力已经存在于预训练的 VLM 中,但现有方法未能充分利用。Transformer 语言模型具有层级功能专业化特性:浅层编码表面和局部语法模式,中层关注句法结构,深层捕获语义和语篇级现象。VisCo 直接利用 VLM 自身的注意力先验让 memory tokens 聚合视觉信息,而非引入自定义交互规则。
三、技术架构
整体框架图
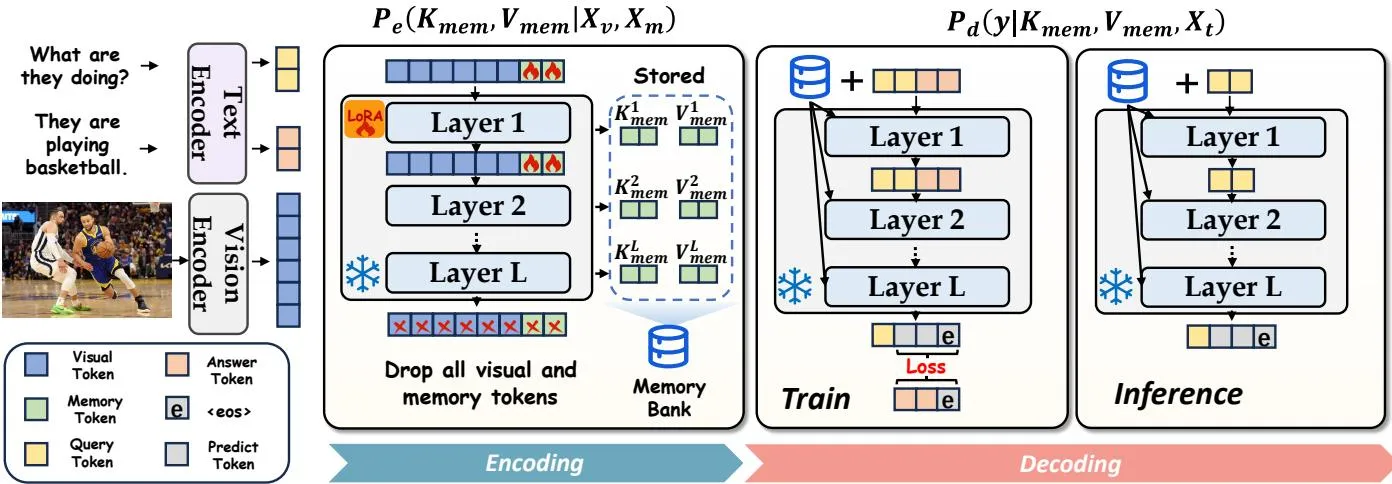
VisCo 是一个不对称的 VLM 自编码器,在编码阶段引入轻量可训练模块,解码阶段保持整个 VLM 冻结。
核心公式
层级 KV 记忆库构建 — 保留 memory token 对应的 key 和 value:
其中 是视觉 token 数量, 是 memory token 数量, 表示 Transformer 层数。
编码阶段建模:
解码阶段建模:
其中 是答案序列, 是文本提示的嵌入序列。
教师强制损失函数:
其中 是答案 token 序列, 是可训练参数(包括 和 )。
与 Prefix-Tuning 不同,VisCo 直接使用编码器侧的 memory KV caches 作为层级 prefix,无需每层的 MLP 投影。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| Memory Tokens () | 一组可学习的压缩 token, | 可学习参数 |
| LoRA Adapter () | 应用于 Q/V 投影的轻量适配器 | , |
| Memory Bank | 每层 memory token 对应的 KV 值集合 | |
| Encoder | 带 LoRA 和 memory tokens 的 VLM | 仅微调 + LoRA |
| Decoder | 冻结的预训练 LLM backbone | 无 LoRA,参数共享 |
训练流程
编码阶段:
- 给定图像 ,缩放至目标分辨率得到
- 视觉编码器 和多模态投影器 编码为视觉 token
- 追加 个 memory tokens ,形成联合序列
- 严格遵循因果掩码机制,memory tokens 位于视觉 token 之后,每个 memory token 自然可以 attend 到所有视觉 token
- 对每层 ,提取 memory token 对应的 KV 值存入 memory bank
- 丢弃最终 encoder hidden states,仅依赖层级 memory KV caches
解码阶段:
- 移除 LoRA adapters,复用共享的预训练 LLM backbone
- 将层级 memory bank 直接填充到 decoder 的 KV cache
- 在此 cache 上执行自回归生成
训练配置:
- 数据集:LLaVA-665K 的 ~10% 子集(每个对话的第一轮)
- LoRA: Q/V projections, ,
- 学习率:
- 训练 epoch: 1
- 评估模型: LLaVA-1.5-7B, Qwen2-VL-2B, Qwen2-VL-7B
现有压缩方法对比
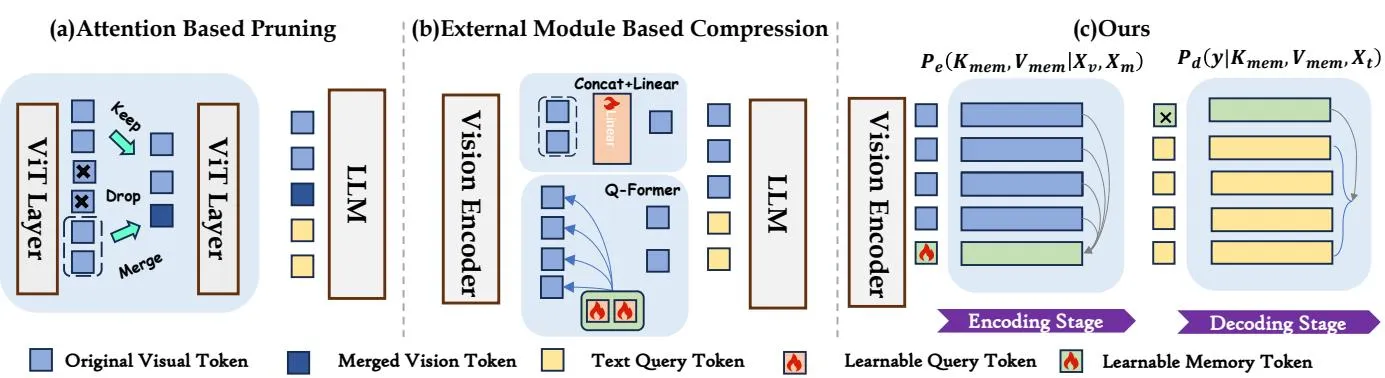
- (a) Training-free: 基于注意力或相似度的启发式剪枝/合并
- (b) External-module: 引入额外压缩模块,需要 VLM 适应
- (c) VisCo: 复用 VLM 自身作为压缩器,仅引入 memory tokens
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 不对称内在自编码器 | 仅微调编码器(LoRA + memory tokens),解码器完全冻结并复用预训练 backbone | 避免重新学习完整的多模态生成过程 |
| 层级 KV 信息传递 | 从编码器每层提取 memory token 对应的 KV 值,直接作为 decoder 的层级 prefix | 保留多层级视觉语义,避免 collapse 为单一摘要 |
| 因果掩码下的自然注意力 | memory tokens 置于视觉 token 之后,利用预训练 backbone 的固有注意力模式聚合信息 | 不引入自定义交互规则 |
| 极端压缩稳定性 | 即使在单 token(1 token)设置下仍保留 85.3% 原始性能 | 超越 PruMerge+ 49.9 分、VisPruner 36.5 分 |
| 互补表示发现 | memory tokens 与原始 token 结合时甚至提升基础模型性能 | 证明了 VisCo+ 设计 |
五、实验结果
基准测试 — LLaVA-1.5-7B
| 方法 | Token | GQA | MMB | MMB-CN | MME | PoPE | MMVet | Avg. |
|---|---|---|---|---|---|---|---|---|
| LLaVA-1.5-7B | 576 | 62.0 | 64.3 | 58.3 | 1510.7 | 85.9 | 31.1 | 100.0% |
| 32 tokens (↓94.4%) | ||||||||
| FastV (ECCV24) | 32 | 41.5 | 37.8 | 33.2 | 884.6 | 32.5 | 20.7 | 57.6% |
| SparseVLM (ICML25) | 32 | 48.3 | 51.4 | 40.6 | 1046.7 | 67.9 | 18.6 | 72.6% |
| PruMerge+ (ICCV25) | 32 | 51.1 | 56.8 | 47.0 | 940.8 | 70.9 | 21.4 | 77.5% |
| DivPrune (CVPR25) | 32 | 54.9 | 57.6 | 49.1 | 1284.9 | 81.5 | 26.3 | 87.2% |
| VisPruner (ICCV25) | 32 | 52.2 | 58.4 | 52.7 | 1271.0 | 72.7 | 28.8 | 87.8% |
| VisCo | 32 | 58.5 | 62.3 | 57.2 | 1152.9 | 81.9 | 27.9 | 91.8% |
| 1 token (↓99.8%) | ||||||||
| PruMerge+ (ICCV25) | 1 | 26.4 | 13.7 | 13.7 | 568.9 | 40.4 | 12.5 | 35.4% |
| VisPruner (ICCV25) | 1 | 41.8 | 22.4 | 25.8 | 764.4 | 49.0 | 12.0 | 48.8% |
| VisCo | 1 | 58.2 | 59.0 | 52.4 | 1191.2 | 78.2 | 20.7 | 85.3% |
基准测试 — Qwen2-VL
| 基线模型 | 方法 | 压缩比 | GQA | MMB | MMB-CN | MME | POPE | MMVet | Avg. |
|---|---|---|---|---|---|---|---|---|---|
| Qwen2-VL-2B | Origin | 144 tokens (100%) | 59.8 | 67.3 | 61.8 | 1465.8 | 81.5 | 42.5 | 100.0% |
| VisCo | 36 tokens (↓66.7%) | 61.1 | 64.0 | 58.9 | 1368.3 | 82.9 | 35.6 | 95.2% | |
| VisCo | 18 tokens (↓88.9%) | 59.7 | 62.9 | 57.8 | 1358.0 | 82.4 | 28.9 | 91.4% | |
| Qwen2-VL-7B | Origin | 144 tokens (100%) | 64.8 | 76.1 | 71.6 | 1664.8 | 82.6 | 56.1 | 100.0% |
| VisCo | 36 tokens (↓66.7%) | 62.6 | 74.0 | 70.0 | 1551.0 | 83.3 | 40.4 | 94.6% | |
| VisCo | 18 tokens (↓88.9%) | 61.8 | 70.0 | 68.8 | 1496.5 | 81.7 | 39.2 | 90.4% |
定性评估
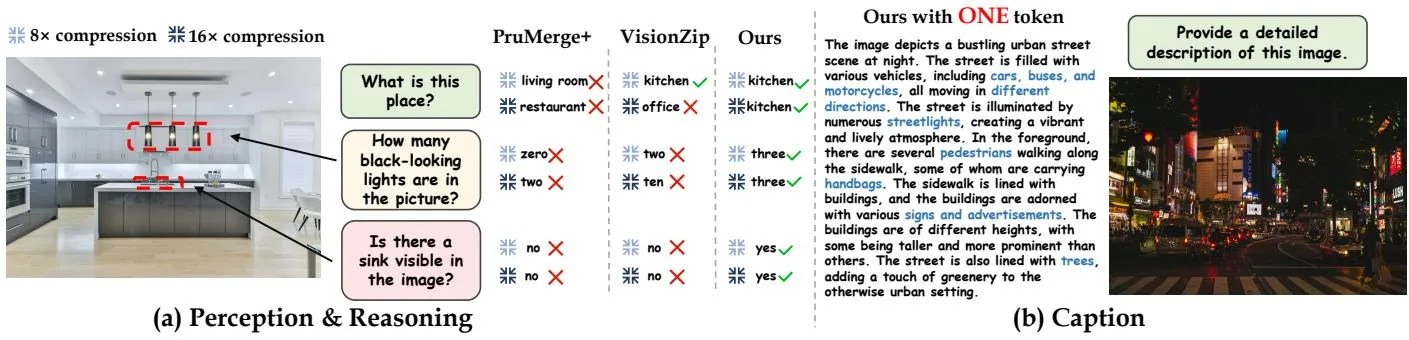
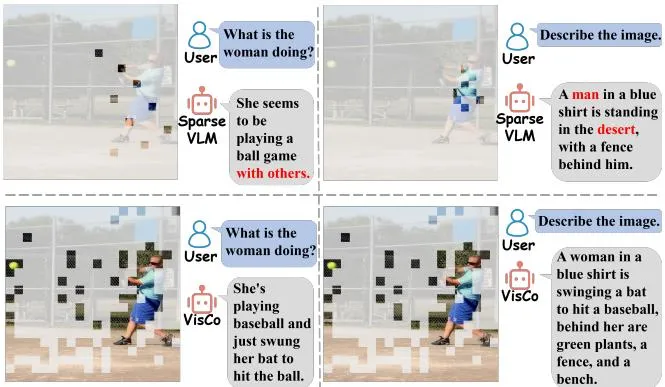
- 在 8× 和 16× 压缩比下,传统方法丢失细粒度细节,复杂推理失败
- VisCo 在感知和推理任务上均正确回答
- 即使仅 1 个 token,VisCo 仍能生成包含详细物体级别描述和连贯全局语义的 caption
消融实验
(1) 层级 KV 传递 vs 值传递
| 压缩率 | 方法 | GQA Acc. | GQA Score | MMB Acc. | MMB Score | PoPE F1 | PoPE Score |
|---|---|---|---|---|---|---|---|
| 36 tokens (↓66.7%) | ValuePass | 51.8 | 86.6% | 59.5 | 88.7% | 79.6 | 97.7% |
| HierKVPass (Ours) | 61.1 | 102.2% | 64.0 | 95.1% | 82.9 | 101.7% | |
| 18 tokens (↓88.9%) | ValuePass | 49.6 | 82.9% | 54.4 | 81.1% | 77.6 | 95.2% |
| HierKVPass (Ours) | 59.7 | 99.8% | 62.9 | 93.5% | 82.4 | 101.1% | |
| 2 tokens (↓98.6%) | ValuePass | 45.8 | 76.6% | 50.1 | 74.7% | 74.9 | 91.9% |
| HierKVPass (Ours) | 50.8 | 84.9% | 53.3 | 79.2% | 79.7 | 97.8% |
层级 KV 传递显著优于直接值传递,证明层级信息传播确实大幅提升了模型性能。
(2) 压缩率消融
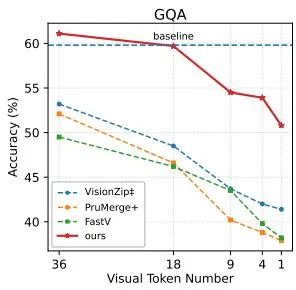
随着压缩率增加(保留 token 减少),VisCo 性能下降平缓,而其他方法急剧恶化。
(3) Memory Token 重要性分析
| 方法 | MMB | MMB-CN | GQA | MME | PoPe |
|---|---|---|---|---|---|
| 36 token (全量) | 64.0 | 58.9 | 60.1 | 1395.4 | 82.9 |
| drop(0,17) 前18个 | 55.7 | 52.9 | 56.8 | 1305.6 | 76.2 |
| drop(18,35) 后18个 | 60.0 | 56.2 | 57.0 | 1375.6 | 81.6 |
前 18 个 memory tokens 更重要,因为它们更密集地 attend 到图像主体对象;后 18 个则关注背景区域和局部细节。
(4) Memory Tokens 作为互补表示 — VisCo+
| 方法 | MMB | MMB-CN | GQA | MME | PoPe | MMVet |
|---|---|---|---|---|---|---|
| Origin | 67.3 | 61.8 | 59.8 | 1465.8 | 81.5 | 42.5 |
| Direct SFT | 66.4 | 62.2 | 57.1 | 1354.5 | 82.6 | 40.3 |
| VisCo+ | 69.6 | 67.8 | 59.9 | 1491.2 | 84.6 | 37.2 |
VisCo+(memory tokens + 原始 token 联合使用)在所有基准上超越原始模型,且增益不是来自额外的 fine-tuning。
效率分析
| Token | 方法 | 压缩时间 (ms) | 解码时间 (ms/token) | 推理时间 (s) | KV Cache (MB) |
|---|---|---|---|---|---|
| 576 | Origin | - | 21.2 | 5.5 | 288.0 |
| 128 | FastV | - | 20.3 | 5.2 | 78.8 |
| VisionZip‡ | - | 19.6 | 5.0 | 72.0 | |
| VisCo | 68.9 | 19.6 | 5.0 | 72.0 | |
| 32 | FastV | - | 19.4 | 5.0 | 26.4 |
| VisionZip‡ | - | 18.6 | 4.8 | 18.0 | |
| VisCo | 63.7 | 18.6 | 4.8 | 18.0 |
多轮对话效率
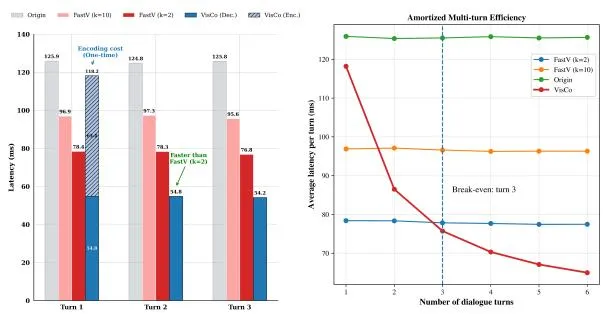
- VisCo 一次性压缩图像并缓存表示,在多轮对话中复用
- FastV/SparseVLM 每次查询需重新压缩视觉 token
- 仅需 3 轮对话,VisCo 的平均响应时间就超过 FastV
六、总结
核心贡献
- 不对称内在自编码器:利用 VLM 自身压缩视觉 token,保持 backbone 冻结,仅需轻量微调(LoRA + memory tokens)
- 层级 KV 信息传递机制:从编码器各层提取 memory token 对应的 KV 值,直接作为 decoder 的层级 prefix,保留多层级视觉语义
- 全面评估与极端压缩下的强性能:在 3 个 VLM backbone 和 6 个 benchmark 上,VisCo 一致超越现有方法,尤其在 1-token 极端设置下表现突出
- 互补表示发现:memory tokens 不仅压缩视觉信息,还捕获与原始 token 互补的表征,联合使用时甚至提升基础模型性能
- 效率优势:显著减少 KV cache 存储,在多轮对话场景中具有明显加速优势
技术影响
VisCo 证明了利用预训练 VLM 的内在先验可以实现鲁棒的视觉 token 压缩,仅需轻量训练即可在紧致的 token 预算下取得竞争性性能。这种方法保留了 VLM 的灵活性和即插即用特性,同时避免了外部模块带来的高昂重新训练成本。
局限性
- 当前评估主要在 LLaVA-1.5-7B 和 Qwen2-VL (2B/7B) 上进行,未来将扩展到更多 VLM 架构
- 单 token 设置在 MMB/MMB-CN 上仍有约 10% 的性能损失
- 压缩阶段引入额外开销(~64ms),但在长回复和多轮对话场景中被解码加速所抵消
七、参考资源
- arXiv: 2607.12756
- MinerU 提取: full.md