FlashAccel: Leveraging High-Bandwidth Flash for High-Throughput LLM Inference
面向 LLM 推理的 HBF(高带宽闪存)与 HBM GPU 软硬件协同设计:通过架构级 SRAM 缓存/预取、专用数据布局与异构存储管理层,将 HBF 的容量优势转化为吞吐与能效。
FlashAccel: Leveraging High-Bandwidth Flash for High-Throughput LLM Inference
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | FlashAccel: Leveraging High-Bandwidth Flash for High-Throughput LLM Inference |
| 作者 | Xinyu Wang, Yalong Xue, Xiaotian Sun, Xiaoyu Zhang, Chunmeng Dou, Xueqi Li, Xiaoming Chen |
| 机构 | (论文未标注,作者姓氏集中于国产体系结构团队;疑似中科院计算所方向) |
| 论文 | https://arxiv.org/abs/2607.10186 |
| 代码 | 未公开(实验基于 LLMCompass + 自建 NAND 仿真器,非开源实现) |
| 发布 | 2026-07-11(提交/在线) |
| 主题 | Hardware Architecture (cs.AR) |
| 许可 | 未声明 |
二、核心思想
问题定义
LLM 推理的内存容量需求随模型规模与长上下文(KV cache)快速增长,而 GPU 的 HBM 容量未能同步增长,形成容量墙。High-Bandwidth Flash(HBF,高带宽闪存)提供比 HBM 更高的容量且带宽相当,本是理想的容量扩展介质;但它存在三大集成障碍:
- 访问延迟高:HBF 读延迟约 (tR),HBM 仅约 ,差距达 40×;
- 带宽利用率低:单 plane 读 4KB 页需 (≈1 GB/s),聚合带宽难以打满;
- 缺乏异构资源管理:无法像 HBM 那样被 GPU 统一调度。
解决方案概述
FlashAccel 提出一套软硬件协同设计,把 HBF 集成进 HBM-based GPU,用于承载”大且读主导”的数据(模型权重、KV cache):
- 架构层:在 HBF 各 die 的空闲硅面积放置 SRAM 缓存,并在系统层提供预取接口,掩盖 Flash 高延迟;
- 数据布局层:为权重与 KV cache 设计专用布局,充分暴露 plane 级并行,逼近峰值带宽;
- 系统软件层:提供 HBF-aware 存储管理层 与 统一虚拟地址编程模型,组织持久化数据并协调异构内存。
实验表明:在 GPU 中集成 6 个 HBF stack,可在 100ms 延迟约束下相对纯 HBM GPU 取得平均每 GPU 吞吐 2.54×、能效 1.93× 的提升。
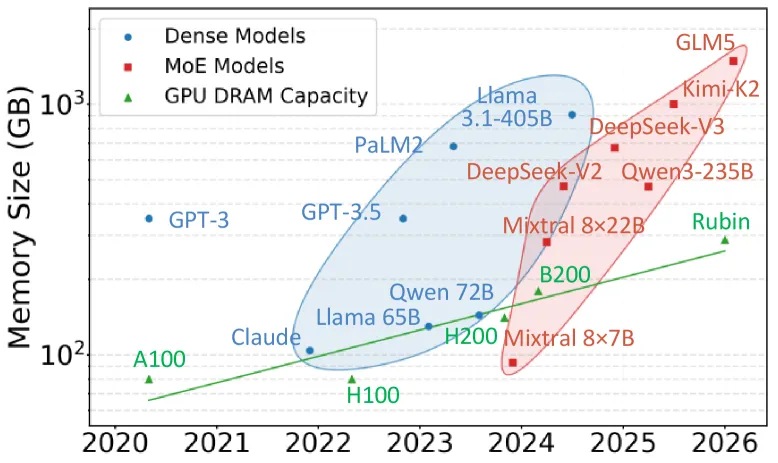
三、技术架构
硬件设计(Architecture)
FlashAccel 将 HBF、HBM 与 GPU core 组合为异构加速器,支持两种集成方式:
- CLI(co-located integration,共置集成):将 HBF 置于 GPU 旁,部分替换 HBM 以提升总容量、降低 HBM 成本;
- CSI(cascaded integration,级联集成):通过 HBM base die 以菊花链方式连接 HBF,保留更多 HBM stack,最大化 HBM 容量与带宽。
在异构内存体系中二者互补:HBM 存放小且频繁更新的中间数据(低延迟),HBF 存放大且读主导的权重与 KV cache。
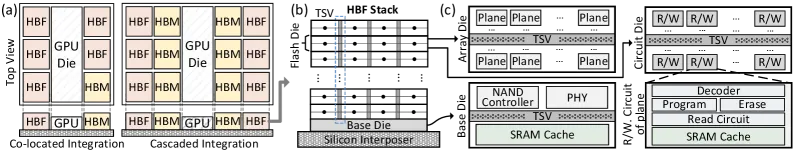
HBF stack 结构:每 stack 含 8 个 Flash die(阵列 die + 电路 die,混合键合)堆叠于 base die 之上,TSV 互连;每个 Flash die 扩至 96 planes(参照 Lincoln/XL-Flash 设计)。电路 die 中存在大量空闲硅面积,FlashAccel 在其中放置 SRAM,为每个 plane 提供 SRAM cache;base die 除 NAND 控制器与 PHY 外也集成 SRAM。
延迟掩盖的关键约束(SRAM 容量设计):
即每个 stack 的总 SRAM 容量需大于 ,以支撑预取机制。
关键延迟/带宽数字:HBF 读延迟 vs HBM ( 差距);CSI 读带宽达 4.6 TB/s,但写带宽峰值仅 245.8 GB/s(写受限,见 §7.4)。
数据布局设计(Data Layout)
数据布局是协同设计的核心:高 HBF 带宽利用率既依赖硬件,也依赖访问是否能匹配 Flash 并行度。
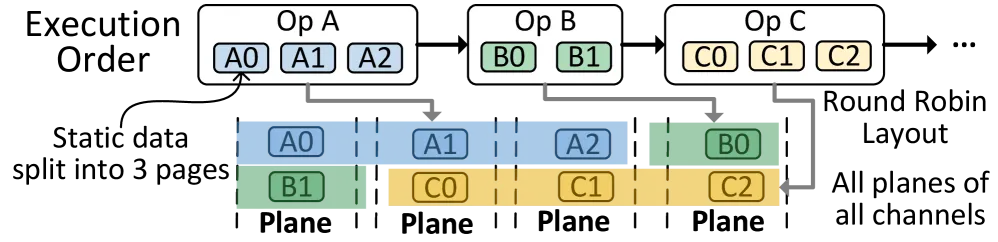
权重布局(Weights in HBF):将每个算子的静态权重切分为 page 大小单元(如 A0/A1/A2),按执行顺序 round-robin 映射到所有 plane 与 channel,使整组权重在全局上对各 plane 负载均衡;配合 §6 的预取机制顺序加载,逼近峰值带宽。
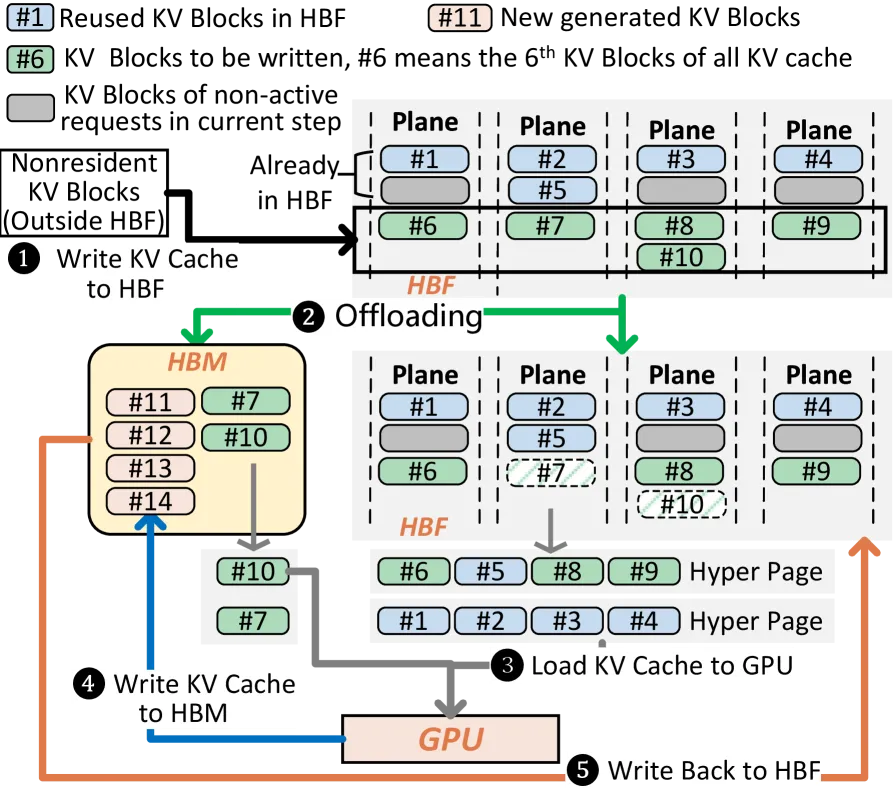
KV cache 布局:KV cache 比静态权重更复杂(活跃请求集合每步变化)。FlashAccel 将每请求 KV block 组织为统一 KV cache 抽象,使写/卸载/读策略能均衡 plane 负载并保持高带宽利用。
系统设计与编程模型
需在两级提供系统支持:① 推理中协调 HBM/HBF/SRAM;② 组织 HBF 中的持久化数据。
- HBF-aware 存储管理层:将模型权重与每请求 KV cache 视为持久化对象,切分为数据单元并维护每对象索引元数据(轻量,避免传统 Flash 栈的厚重软件栈);
- 编程模型:向程序暴露统一虚拟地址空间,存储层维护定位 HBF 中持久对象的元数据;提出 NandMmap / GroupMmap / GroupArrange / Sr 等映射与预取机制(详见论文图 10–12)。
四、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| 架构级 SRAM 缓存 + 预取 | 在 HBF 空闲硅面积放置 per-plane SRAM cache,系统层提供预取接口掩盖 读延迟 | 消融:关闭预取吞吐下降 55% |
| 权重/ KV 专用数据布局 | round-robin 跨 plane 映射 + 统一 KV cache 抽象,暴露 plane 级并行 | 消融:关权重布局 -7%,关 KV 布局 -15% |
| 异构内存编程模型 + 存储层 | 统一虚拟地址 + 轻量 HBF-aware 元数据,协调 HBM/HBF/SRAM | 全优化后延迟仅比 HBM 高 ~4%(含 2% 卸载开销) |
| HBF 集成方案(CLI/CSI) | 两种将 HBF 接入 GPU 的物理方案,互补角色 | 8×CSI 平均吞吐 2.15×;8×CLI 100ms SLO 下 2.04× |
五、代码实现分析
- 论文未发布代码。实验基于 LLMCompass(在其上构建事件驱动仿真器)建模 LLM 推理延迟,并用 ScaleSim 估算 GEMM 延迟;作者扩展了一个 NAND 仿真器,在 plane 粒度建模页访问延迟,并修改 LLMCompass 内存模型以模拟 Flash/SRAM cache 的访问延迟。
- 基线为 DGX-H200 节点(8×H200,每 GPU 6 个 HBM3e stack,141GB / 4.8 TB/s)。HBF stack 按 HBM3e 级带宽、8× 容量设计(详见表 2)。
- 评估配置:8×CSI、8×CLI、4×CSI、4×CLI,并与 8×/16× H200 对比。
六、实验结果
基准测试设置
表 1:评估模型配置(四类代表性模型)
| 模型 | 注意力 | FFN |
|---|---|---|
| Qwen3-235B | GQA / DP @ 188KB/token | MoE / EP |
| Qwen3-Coder-480B | GQA / DP @ 248KB/token | MoE / EP |
| LLaMA3.1-405B | GQA / TP @ 502KB/token | Dense / TP |
| DeepSeekV3-671B | MLA / DP @ 70KB/token | MoE / EP(权重 FP8) |
序列长度:长上下文负载取 LongProc 基准平均(输入 8.11K / 输出 2.53K);智能体负载取输入 15K / 输出 6K。SLO 取 50ms(≈20 tok/s/用户)与 100ms(≈10 tok/s/用户)。
表 2:HBF 配置要点
- 阵列 die:SLC 96 wordline 层,4KB/page;256 pages / 256 blocks / 96 planes,192 Gb/die;plane 面积 1.43 mm²,die 总面积 149 mm²;,
- 电路 die:per-plane 32KB SRAM(0.050 mm²);总面积 143 mm²
- base die:SRAM 8MB
- 单 stack:192GB Flash + 32MB SRAM;CSI 读带宽 4.6 TB/s,写带宽峰值 245.8 GB/s
主要结果
吞吐(decode 阶段,每 GPU 相对基线归一化):
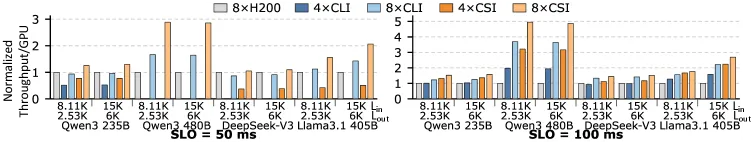
- 8×CSI 在所有模型/序列长度/SLO 下均优于基线,平均吞吐提升 2.15×(依靠更大 batch size 突破 HBM 容量瓶颈);
- 8×CLI 在 100ms SLO 下整体提升 2.04×(仅 5 个 HBF stack,带宽低 16.7%);
- 4×CSI / 4×CLI:HBM 基线 4×H200 甚至放不下权重;放宽到 100ms SLO 后,FlashAccel 在 LLaMA-405B、Qwen3-235B/480B 上仍优于基线(每 GPU 吞吐);
- 扩展性:扩展到 16 GPU 时,基线因 NVLink→RDMA(带宽降约 9×)几乎无提升甚至下降;8× HBF GPU 系统的每 GPU 吞吐高于 16× HBM GPU 系统(更省 GPU 且更高吞吐/能效)。
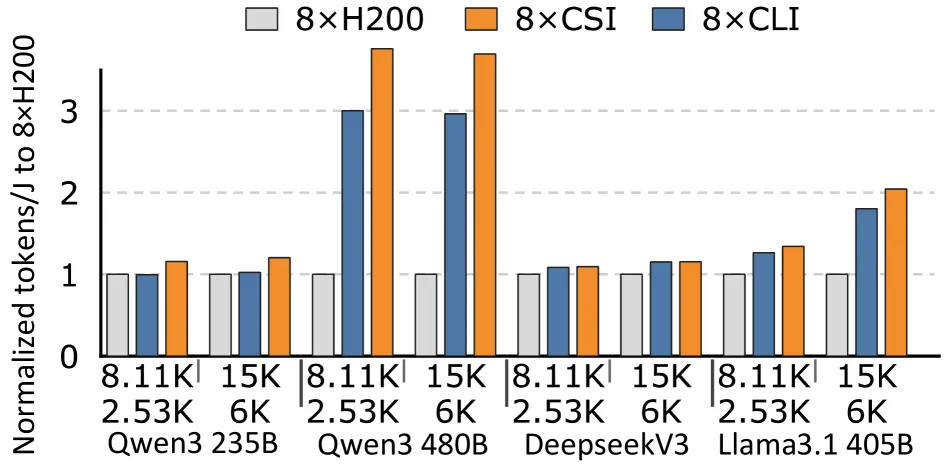
- 摘要级 headline(100ms SLO,6 个 HBF stack):每 GPU 吞吐 2.54×、能效 1.93×(见 §8 结论与摘要)。
能效:
消融实验
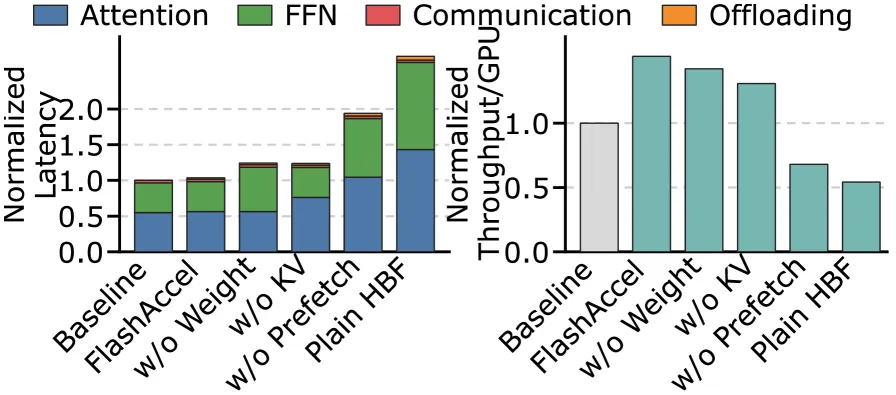
在 Qwen3-235B(batch=256)上逐项关闭优化(100ms SLO 下吞吐):
| 配置 | 相对 FlashAccel 吞吐变化 |
|---|---|
| Plain HBF(无任何优化) | -65%(低于 HBM GPU) |
| 关闭预取(prefetching) | -55% |
| 关闭 KV cache 布局 | -15% |
| 关闭权重布局 | -7% |
| 全优化(FlashAccel) | 基准;延迟仅比 HBM 高 ~4%(含 2% 卸载开销) |
结论:预取对掩盖延迟起主导作用,布局优化进一步提升带宽利用率,三项优化缺一不可。
写瓶颈与寿命(§7.4)
- 写受限:读带宽 4.6 TB/s,峰值写带宽仅 245.8 GB/s;
- 寿命:将保留时间从 3 年降到 3 天可将 P/E 循环提升约 10×(100K→1M);GQA/MLA 等新注意力降低写量,使 KV cache 可放 Flash;
- 实测每 HBF GPU 在 decode 节点最多写 276MB/s KV cache,prefill 节点另写 712MB/s,合计约 1 GB/s,写压力可控。
七、相关工作
- Flash 卸载策略(Sheng et al. 2023; Hu et al. 2025; Alizadeh et al. 2024 等):将权重/KV cache 卸载到 SSD 缓解 DRAM 容量瓶颈,但 SSD 带宽过低导致 decode 延迟极高,难以用于数据中心;
- 存内计算加速器(Lee et al. 2025b; Sun et al. 2025; Yu et al. 2024):在 Flash 内放计算单元利用内部带宽,但 Flash 内硅面积受限、算力不足;
- FlashAccel 的差异化:通过提升 plane 级并行 + 专用布局优化实现高带宽,并以协同设计弥合 HBF 与 GPU 的延迟/管理鸿沟。
八、总结
核心贡献
- 指出阻碍 HBF 将”容量优势”转化为”服务性能”的三大障碍(高延迟、低带宽利用率、缺异构管理),并提出跨架构/数据布局/系统软件的三层协同设计。
- 架构层引入 SRAM 缓存 + 预取接口 掩盖 Flash 延迟;数据布局层以专用布局充分利用 plane 级并行;系统层给出 HBF 存储管理层 + 统一虚拟地址编程模型。
- 实验显示:集成 6 个 HBF stack 的 FlashAccel 在 100ms SLO 下相对纯 HBM GPU 取得每 GPU 吞吐 2.54×、能效 1.93×,且 8× HBF 系统吞吐高于 16× HBM 系统。
技术影响
为”用高容量、低成本闪存扩展 GPU 推理内存”提供了可落地的协同设计范式,对长上下文、智能体、MoE 大模型的服务部署(容量墙)具有直接参考价值。
局限性
- 依赖 HBF 新工艺(96 planes/die、SRAM 空闲面积),属前瞻硬件设计,尚无可量产芯片验证;
- 写带宽/寿命仍是短板(依赖降保留时间延长寿命的假设);
- 评估基于仿真(LLMCompass + NAND 仿真器),非流片/真实板卡实测;
- 代码未开源,结果可复现性受限。
九、参考资源
- 论文:https://arxiv.org/abs/2607.10186
- HTML 全文:https://arxiv.org/html/2607.10186v1
- 基线/工具引用:DGX-H200 (NVIDIA, 2024);LLMCompass (Zhang et al., 2024);ScaleSim (Samajdar et al., 2018);XL-Flash (Kouchi et al., 2020);Lincoln/Sun et al. 2025(HBF 设计)
- 评估模型:Qwen3-235B / Qwen3-Coder-480B (Yang et al., 2025)、LLaMA3.1-405B (Dubey et al., 2024)、DeepSeekV3-671B (DeepSeek-AI et al., 2025)
关键图示索引
| 图 | 文件名 |
|---|---|
| Figure 1 趋势 | trends-hbm-capacity.png |
| Figure 6 架构 | architecture-flashaccel.png |
| Figure 7 权重布局 | weight-layout.png |
| Figure 8 KV 布局 | kv-cache-layout.png |
| Figure 13 吞吐对比 | throughput-comparison.png |
| Figure 15 消融 | ablation-latency-throughput.png |
| Figure 17 能效 | energy-efficiency.png |