TriRoute: Unified Learned Routing for Joint Adaptive Attention, Experts, and KV-Cache Allocation
TriRoute — 单一轻量控制器联合决策注意力分辨率、FFN 专家选择与 KV-Cache 位宽,端到端可训练,单一预算旋钮扫出 Pareto 前沿,缓解跨轴路由坍缩级联
TriRoute: Unified Learned Routing for Joint Adaptive Attention, Experts, and KV-Cache Allocation
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | TriRoute: Unified Learned Routing for Joint Adaptive Attention, Experts, and KV-Cache Allocation |
| 作者 | Andrii Balashov, Olena Ponomarova |
| 机构 | Ukrainian State University of Science and Technologies |
| 论文 | https://arxiv.org/abs/2607.06601 |
| 发布 | 2026-07 |
二、核心思想
现有的条件计算(conditional computation)技术各自作用于 Transformer 块的单一轴,且都被独立地研究和调优:
- Mixture-of-Experts (MoE) 稀疏化前馈网络(FFN),将每个 token 路由到少量专家;
- Mixture-of-Depths (MoD) 让深度按 token 自适应,学习每块门控让 token 跳过整个 attention+FFN 子层;
- KV-cache 量化 压缩主导长上下文服务的注意力内存,将 K/V 以 2–4 bit 存储。
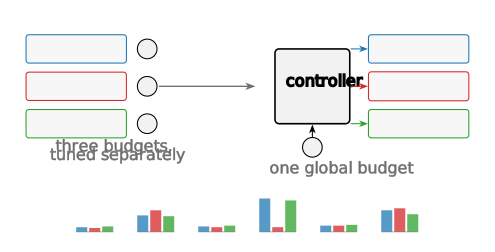
本文的核心论点:这三个决策(注意力分辨率、专家选择、缓存位宽)是强耦合的,应当联合决策。以稀有实体 token(如 “…signed by Nakamura on Tuesday” 中的姓氏)为例——MoD 可能正确判断其 FFN 变换可跳过;但正因为它稀有且信息量大,它很可能需要全注意力分辨率来绑定其共指对象,且其 K/V 应以高精度存储以便后续 query 忠实检索。而像 “the” 这样的功能词在三个维度上恰好相反。因此”正确的计算量”不是每 token 一个标量(MoD 隐含假设),而是跨异构资源的耦合选择向量。
问题定义
统一自适应计算:为每个 token 、每一层 ,在三个耦合轴上联合决策:
- 注意力模式 :控制 token 读取多少序列历史;
- 稀疏专家选择 :从 个 FFN 专家中选择(含 null 专家,特殊情况下恢复 MoD 式跳过);
- KV 位宽 :决定 token 自身 K/V 写入缓存的精度,即未来 token 能多忠实地对其注意。
解决方案概述
TriRoute 用单一轻量共享控制器(shared controller)联合决策三条路径(“三路由”):
- 端到端训练,采用异构松弛方案(Gumbel-Softmax + 直通估计器处理类别决策,负载均衡 top-k 门控处理专家);
- 单一 Lagrangian 预算约束将平均计算与内存成本变成一个可控旋钮;
- 识别并缓解朴素联合训练中的跨轴路由坍缩级联(cross-axis routing-collapse cascade),采用逐轴归一化与耦合感知均衡损失。
在 160M–1.3B 解码器模型上,TriRoute 在匹配推理 FLOPs 与内存的条件下 Pareto 支配最优独立组合(MoD+MoE+KV量化),并更好地保留稀有实体、代码、算术上的尾部鲁棒性。
三、技术架构
整体框架图
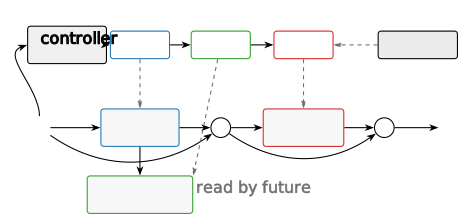
一个 TriRoute 块(Figure 2):共享控制器 trunk 将(归一化的)残差状态加上廉价侧特征映射到三个 head:
- 注意力 head:选择 query 模式(skip/local/full),控制读取多少历史;
- 专家 head:从 个 FFN 专家中选 top- 或选 null 专家(FFN 跳过);
- bit head:设定 token 自身 K/V 写入缓存的精度,供未来 token 读取。
单一预算控制器通过 Lagrange 乘子 塑造全部三轴。
核心公式
1. 分解的 Transformer 块(pre-norm)
TriRoute 在块前插入控制器,为 token 发出策略 ,因分别决策注意力和 FFN,块变成一个小型条件计算图。
2. (A) 注意力分辨率
\text{Attn}_t = \sum_{m \in \mathcal{A}} \mathbf{1}[a_t = m] \text{Attn}_t^{(m)} \tag{2}
其中 ,,。三种模式分别耗费 、、 次 key 交互。注意力路由默认逐 head(heads 已知会专业化)。
3. (B) FFN 专家(含 null 专家)
FFN 由 个专家 加 null 专家 替代。softmax 门控 选出 top- 专家 :
\text{FFN}_t = \sum_{j \in \mathcal{S}_t} \frac{p_{t,j}^e}{\sum_{j' \in \mathcal{S}_t} p_{t,j'}^e} f_j(\text{Norm}(\tilde{x}_t)) \tag{3}
选 null 专家( 且 )复现 MoD 式 FFN 跳过;选真实专家复现 MoE。因注意力和 FFN 独立决策,TriRoute 可跳过 FFN 同时保留全注意力——这正是稀有实体所需、而 MoD(门控整块)无法表达的机制。
4. (C) KV-cache 位宽(非对称逐 token 分组量化)
表示原生精度存储。存储的 是所有 层后续 query 所注意的对象,因此轴 (C) 以当前内存换取未来注意力保真度——这是孤立 KV 量化(固定单一全局 )忽略的跨 token 耦合。
5. 共享控制器
其中 ,(取 ),控制器仅增加 FLOPs。侧特征 包括相对位置、距上一空白/BOS 距离、token 自身预测熵的运行估计、上一层决策。
设计原则 1(读写分离决策):注意力 head 管理 token 读多少(query),bit head 管理它被写多忠实(KV)。token 可以是重要源(高位)但懒惰读者(skip),反之亦然。 设计原则 2(条件于廉价因果特征):侧特征 在块运行前可计算,携带路由所需大部分信号。
6. 异构松弛的路由梯度
专家选择用标准可微 top- softmax;类别注意力和 bit 决策用直通 Gumbel-Softmax:
直通估计器:。各轴温度 从 退火到 。
7. 跨轴梯度均衡(关键)
因估计器尺度差异巨大(跳过注意力比缓存从 8→4 bit 改变损失大得多),用分离的运行逐轴因子重缩放各 head 的直通替代:
到达各 head 的梯度范数 EMA(动量 )。对 bit head 学习至关重要。
8. 可微多资源成本模型
按 dense 模型成本归一化:。
9. 逐轴均衡(Switch 负载均衡 + router z-loss)
10. 修复坍缩级联:逐轴白化 + 熵下限
逐轴白化(分离)防止一轴坍缩缩小另一轴有效输入尺度:
\hat{h}_t^{\text{axis}} = (h_t - \text{sg}(\mu_{\text{axis}})) \oslash \text{sg}(\sigma_{\text{axis}} + \epsilon) \tag{11}
边际熵下限(hinge,仅在接近坍缩时起作用):
\mathcal{L}_{\text{ent}}^{\text{axis}} = [\zeta \log|\mathcal{O}| - H(\bar{p}^{\text{axis}})]_+, \quad H(\bar{p}) = -\sum_o \bar{p}_o \log \bar{p}_o \tag{12}
11. 单一预算旋钮(在线 Lagrangian)
\mathcal{L}(\theta, \phi) = \mathcal{L}_{\text{LM}} + \sum_{\text{axis}}(\alpha \mathcal{L}_{\text{bal}}^{\text{axis}} + \beta \mathcal{L}_z^{\text{axis}} + \gamma \mathcal{L}_{\text{ent}}^{\text{axis}}) + \sum_r \lambda_r (\bar{C}^r - C_\star^r) \tag{13}
\lambda_r \leftarrow [\lambda_r + \rho_\lambda (\bar{C}^r - C_\star^r)]_+ \quad \text{(以 } \bar{C}^r \text{ 的 EMA 更新)} \tag{14}
扫描 即可从单一训练族追踪整条成本-质量前沿。对偶变量自调优:紧内存预算下 bit head 被推向低精度,而 flops 价格保持适中——各轴联合定价,正是孤立方法缺乏的协调。
跨轴坍缩级联(Cross-axis Collapse Cascade)
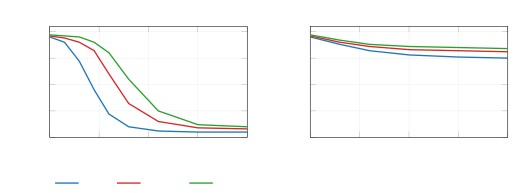
论文识别的关键失败模式(Figure 3):仅用逐轴均衡在共享 trunk 下不够。一旦一轴坍缩(如注意力早期几乎全路由到 skip 以削减成本),进入 FFN 的残差状态变得低方差、跨 token 近乎相同,专家 head 无法区分它们而坍缩到单一专家;bit head 被喂以退化信号,坍缩到最便宜精度,模型陷入无法通过预算压力恢复的差局部最优。耦合让三个路由器一起失败,而非独立失败。修复方法为逐轴白化 (Eq.11) + 边际熵下限 (Eq.12)。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 共享控制器 trunk | 两层 MLP,映射残差态+侧特征 | , FLOPs, 参数 |
| 注意力 head | skip/local/full,逐 head 路由 | ST-Gumbel, |
| 专家 head | top- softmax + null 专家 | ,top-2 |
| bit head | KV 位宽 {2,4,8,16} | ST-Gumbel, |
| 侧特征 | 位置、边界、surprisal、上层决策 | 因果可计算 |
| 成本模型 | FLOPs + mem 可微期望 | 按 dense 归一化 |
| Lagrangian 控制器 | 对偶上升,在线自调 |
训练流程(Algorithm 1)
单层训练步:
- ;逐轴白化 (11)
- ;按梯度均衡 (7) 重缩放
- ST-Gumbel(); TopK-softmax(); ST-Gumbel()
- 以 模式(逐 head)运行注意力;运行专家 ;以 精度写 KV
- 累积成本 (可微)
- 计算 、逐轴 ;组成 (13)
- 反传;步进 ;更新 EMA、温度、对偶
推理:路由器取硬 argmax,仅执行选中计算——跳过的注意力和 null 专家从不物化,每个 token 的 KV 以其选定位宽存储。因决策仅依赖因果特征,推理为单次从左到右传递,静态每 token 计算图,兼容批处理服务和 KV 分页。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 统一三轴路由 | 首个用单一控制器联合学习注意力分辨率、FFN 专家、KV 精度的架构 | Section 3,Table 1 |
| 读写分离 | 注意力 head 管读(query),bit head 管写(KV),可解耦 | 设计原则 1,Observation 2 |
| 异构松弛+梯度均衡 | 逐轴温度退火 ST-Gumbel + 梯度范数 EMA 重缩放 | Eq. 6-7,消融显示对 bit head 学习必需 |
| 跨轴坍缩级联识别与修复 | 逐轴白化 + 边际熵下限阻止级联 | Figure 3,消融显示移除任一重现坍缩 |
| 单一预算旋钮 | 在线 Lagrangian 对偶变量,一个标量扫出整条 Pareto 前沿 | Eq. 13-14 |
| null 专家统一 MoD | 专家轴通过 null 专家复现深度跳过 | Eq. 3 |
| 可解释策略 | 稀有实体获高注意力+高位宽+低 FFN 的签名模式 | Section 6,Figure 5 |
五、实验设置
模型:现代解码器骨干(RoPE、SwiGLU、RMSNorm、GQA ),三个规模匹配 Pythia 配置:
| 规模 | seq len | Tokens | Batch | |||||
|---|---|---|---|---|---|---|---|---|
| 160M | 768 | 12 | 12 | 3 | 2048 | 2048 | 3.2B | 0.5M |
| 410M | 1024 | 24 | 16 | 4 | 2731 | 2048 | 8.2B | 0.5M |
| 1.3B | 2048 | 24 | 16 | 4 | 5461 | 2048 | 26B | 1.0M |
MoE/TriRoute 变体用 专家 top-2,active FFN FLOPs 等于 dense 模型。
数据:Pile + RedPajama 去重混合,文档级 held-out。尾部探针四桶:稀有实体、代码(GitHub)、数学(算术密集)、长上下文(>4k tokens,8k 评估)。
基线(匹配预算协议):(i) Dense(质量上限);(ii) MoD-only;(iii) MoE-only;(iv) KV-quant-only(KIVI 式);(v) 独立组合(MoD+MoE+KV量化,各机制稀疏度/精度网格搜索独立调优——最强非统一基线);(vi) TriRoute。默认目标预算 (约半计算 + ~6-bit 等效缓存)。
训练:AdamW(,wd 0.1),cosine 2k 预热,峰值 LR 3–6×10⁻⁴,梯度裁剪 1.0,bf16。均衡权重 (load),(z-loss),(熵下限,),对偶步 。每配置 3 seed,Pile ppl seed 方差 <0.05。
诚实声明:作者明确指出报告数字”说明设计所针对的趋势,应作为所述协议的结果来解读”;发布代码实现了确切的控制器和成本模型(Appendix C)。
六、实验结果
联合路由支配独立前沿(Table 3,匹配预算 (0.55, 0.40))
| 规模 | 方法 | FLOPs | KV mem | Pile ppl ↓ | Avg acc ↑ |
|---|---|---|---|---|---|
| 160M | Dense | 1.00 | 1.00 | 14.5 | 42.0 |
| MoD + KV-quant | 0.55 | 0.40 | 15.4 | 40.3 | |
| Independent combo | 0.55 | 0.40 | 15.0 | 40.9 | |
| TriRoute | 0.55 | 0.40 | 14.6 | 41.8 | |
| 410M | Dense | 1.00 | 1.00 | 11.6 | 47.2 |
| Independent combo | 0.55 | 0.40 | 12.0 | 46.2 | |
| TriRoute | 0.55 | 0.40 | 11.7 | 47.0 | |
| 1.3B | Dense | 1.00 | 1.00 | 9.8 | 54.8 |
| MoD + KV-quant | 0.55 | 0.40 | 10.5 | 52.5 | |
| Independent combo | 0.55 | 0.40 | 10.1 | 53.5 | |
| TriRoute | 0.55 | 0.40 | 9.7 | 54.5 |
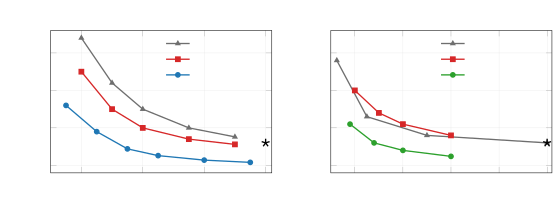
TriRoute 以约半推理成本恢复 96–99% dense 下游准确率,一致比独立组合改善 0.3–0.4 ppl 和 0.7–1.0 准确率点。优势不随规模缩小,表明协调收益是结构性的。差距在激进区间(35–55% FLOPs)最大——协调最重要之处。
实测成本:单 A100 上 1.3B TriRoute 解码吞吐为 dense 的 1.7×(独立组合 1.55×)。实现加速低于 FLOP 比,因路由器开销和混合精度缓存/参差专家批的不完善内核支持。
消融(Table 4,410M)
| 变体 | Pile ppl ↓ | 稀有实体 ppl ↓ |
|---|---|---|
| TriRoute(完整:共享 trunk,逐 head attn) | 11.7 | 15.2 |
| token 级注意力(非逐 head) | 11.9 | 15.8 |
| 逐层组注意力 | 12.1 | 16.3 |
| 三个分离路由器 | 11.85 | 15.6 |
| 单一完全共享 head(过度共享) | 12.0 | 15.9 |
| − 梯度均衡 (7) | 12.4 | 17.1 |
| − 逐轴白化 (11) | 12.6 | 17.6 |
| − 熵下限 | 12.5 | 17.4 |
| REINFORCE 替代 ST-Gumbel | 12.3 | 16.5 |
| − null 专家(无法跳 FFN) | 11.95 | 15.7 |
| 均匀 bits(无 bit 路由) | 11.9 | 16.0 |
三个发现:(1) 均衡配方是承重的——移除梯度均衡使 bit head 无法学习(+0.7 ppl),移除白化或熵下限重现坍缩级联更糟;(2) 粒度——逐 head 注意力优于单一 token 级(−0.2 ppl),FFN/bit 最佳在 token 级;(3) 共享有帮助,过度共享有害——共享 trunk + 分离 head 是甜蜜点。
尾部鲁棒性(Table 5,1.3B)
| 方法 | 稀有实体 ↓ | 代码 ↓ | 数学 ↓ | 长上下文 8k ↓ | GSM8K ↑ |
|---|---|---|---|---|---|
| Dense(全成本) | 18.5 | 4.2 | 12.0 | 10.5 | 4.8 |
| MoD + KV-quant | 21.8 | 4.9 | 14.6 | 12.9 | 3.1 |
| Independent combo | 20.6 | 4.6 | 13.7 | 12.0 | 3.6 |
| TriRoute | 18.9 | 4.3 | 12.4 | 10.9 | 4.5 |
独立组合部分通过欠服务稀有实体(+2.1 ppl)、代码、数学来省算力,掉 1.2 GSM8K 点。TriRoute 因控制器能在这些 token 上保留全注意力+高精度缓存、在别处省算,稀有实体保持在 dense 0.4 ppl 内,仅掉 0.3 GSM8K 点——这是协调三轴改变”哪些输入为节省买单”的最清晰证据。
七、控制器学到了什么(Section 6)
分析训练好的 1.3B 模型,记录 10M-token held-out slice 上每个路由决策,与 token 级语言特征关联:
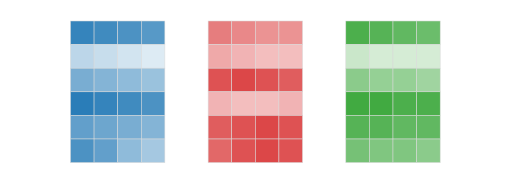
- Observation 1(读写分配给信息性 token):注意力分辨率和缓存精度与 unigram 频率强负相关——稀有子词和命名实体远更常获全注意力和 8-bit 缓存,功能词路由到 skip/local 和 2-bit。
- Observation 2(FFN 计算与注意力解耦):FFN 激活与句法内容和数值性相关,而非注意力分辨率。稀有实体常跳过 FFN 却保留全注意力和高精度缓存——它们需被绑定和记住,而非变换。这正是 MoD(单门控强制注意力与 FFN 同时花或跳)无法表达的。
- Observation 3(深度专业化):早期层跨大多数类别保持高注意力(构建广泛上下文),后期层越发选择性;专家使用相反趋势随深度上升。控制器学到粗粒度”早注意、晚计算”调度。
聚类:k-means 得到可解释组——“功能词/廉价”簇(skip-attn,null-FFN,2-bit)、“实体/锚”簇(full-attn,null-FFN,8-bit)、“计算”簇(local-attn,真实专家,4-bit,用于数字/代码)、“边界/sink”簇(full-attn,混合 FFN,8-bit,句首)。
跨轴耦合真实且非对称:注意力与 bits 强耦合( nats),FFN 更独立( nats)。这解释了为何共享 trunk + 分离 head 是正确归纳偏置——足够共享以耦合注意力和 bits,足够分离以让 FFN 路由专业化。
八、总结
核心贡献
- 统一自适应计算公式化:将三个耦合轴(注意力分辨率、FFN 专家、KV 精度)表述为单一每 token 每层路由问题,实例化为 TriRoute——首个用单一控制器联合学习三轴的架构。
- 异构松弛与均衡配方:逐轴温度退火直通 Gumbel 估计器 + 防跨轴坍缩级联的耦合感知负载均衡损失 + 暴露单一成本旋钮的在线 Lagrangian 预算控制器。
- 设计空间研究:共享 vs 分离路由器(表示共享有帮助,高稀疏时会干扰)、路由粒度(逐 head 注意力 + token 级 FFN/bit 为甜蜜点)。
- 实验验证:160M–1.3B 上 Pareto 支配最强独立组合,更好保留尾部鲁棒性,约半成本匹配 dense 质量。
- 可解释策略:路由模式沿语言学轴聚类(句边界、稀有子词、句法功能),提供机制解释。
技术影响
将”在重要处花算力”从三个手调机制变成单一可训练决策。为长上下文服务的成本-质量权衡提供统一、可控框架。发布 PyTorch 参考实现(Appendix C)。
局限性
- FLOPs 到墙钟时间:实现加速落后于 FLOP 比,三个系统缺口——参差注意力(融合内核不利用)、混合精度缓存(复杂化分页 KV)、路由器开销(每层同步点)。作者视闭合 FLOP-延迟差距为最重要后续。
- 训练成本与稳定性:联合训练比单轴路由更精细,无耦合感知均衡会坍缩;额外损失增加超参();训练墙钟比 dense 高 ~8%。
- 规模:证据跨 160M–1.3B,未在 ≥10B 或极端稀疏(如 8% active FLOPs)验证;坍缩级联在规模上更易或更难控制未知。
- 未测试:固定注意力模式集 {skip,local,full} 和 bit 集 {2,4,8,16};更丰富/连续分辨率、学习组大小、KV 驱逐作为第四轴均为未来工作。尾部桶为代理,需完整公平性研究。
九、参考资源
- 论文: https://arxiv.org/abs/2607.06601
- 相关工作: MoE (Switch/GShard [20,31])、Mixture-of-Depths [38]、KIVI [33]、KVQuant [26]、CoLT5 [2]、SwitchHead [11]、H2O [54]、StreamingLLM [49]
- 评估协议: Chinchilla compute-optimal [25]、Pythia [5]
图表索引(论文图为 TikZ 渲染,已提取为矢量 SVG)
| 图号 | 描述 | 文件 |
|---|---|---|
| Figure 1 | 从三个孤立机制到一个控制器 | figures/triroute/figure-1-overview.svg |
| Figure 2 | 一个 TriRoute 块(共享 trunk + 三 head + 预算控制器) | figures/triroute/figure-2-triroute-block.svg |
| Figure 3 | 跨轴坍缩级联及其修复(whitening + 熵下限) | figures/triroute/figure-3-collapse-cascade.svg |
| Figure 4 | 计算前沿 (a) 与显存前沿 (b) 的 Pareto 支配 | figures/triroute/figure-4-pareto-frontier.svg |
| Figure 5 | 按 token 类别与深度的学习策略热图 | figures/triroute/figure-5-learned-policy.svg |
分析日期: 2026-07-11 分析师: AI Paper Analyzer