Kairos: Towards Load-Aware Prefill Deflection for Disaggregated LLM Serving
面向 PD 分离式 LLM 服务的负载感知 Prefill 偏转调度器 Kairos:让 decode 节点以 chunked-prefill 方式代跑 prefill,消除跨节点 KV 传输,P95 TTFT 最高降低 81%。
Kairos: Towards Load-Aware Prefill Deflection for Disaggregated LLM Serving
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Towards Load-Aware Prefill Deflection for Disaggregated LLM Serving |
| 作者 | Shrikara Arun, Anjaly Parayil, Srikant Bharadwaj, Renee St. Amant, Victor Rühle |
| 机构 | Microsoft |
| 论文 | https://arxiv.org/abs/2607.02043 |
| 发布 | 2026-07-02 |
| 分类 | cs.DC (Distributed, Parallel, and Cluster Computing) |
| 系统名 | Kairos(基于 vLLM 实现) |
摘要
分离式(Disaggregated)LLM 服务将 prefill 和 decode 两阶段运行在独立的 GPU 资源池上,以避免两阶段互相干扰。但这带来了新的不对称性:在突发、重尾(bursty, heavy-tailed)的工作负载下,prefill 节点饱和而 decode 节点算力闲置。在生产级 A100 集群(2 prefill + 2 decode,即 2P2D)上,作者发现 prefill 执行仅占 P95 TTFT 的 2–23%,其余时间被排队等待和跨节点 GPU-GPU KV-cache 传输占据。
Kairos 提出一个主动的 prefill 偏转(prefill-deflecting)调度器:让 decode 节点以 chunked-prefill 步骤的形式,与其正在处理的 decode batch 交错执行、代跑请求的 prefill 阶段。对每个排队请求,Kairos 估计其在 prefill 节点上的 TTFT,并在每个 decode 节点上搜索”在不违反在飞 decode 的 TBT SLO 前提下能承载的最大 chunk 调度”,当 decode 路径更利于尾延迟时才偏转。由于被偏转请求的 prefill 在 decode 节点本地执行,跨节点 KV 传输被彻底消除。在 vLLM 上实现、以 DeepSeek-V2-Lite 在生产级 trace 上评测,相比 SOTA 分离式调度器,P95 TTFT 最高降低 81%,SLO 达成率最高提升 79%,每请求路由开销亚毫秒级。
二、核心思想
问题定义
PD 分离式服务的初衷是隔离 prefill(计算密集)与 decode(访存密集)两阶段。但在真实的重尾突发负载下产生了严重的资源失衡:
- prefill 节点饱和:SM 利用率 76–84%,成为瓶颈
- decode 节点闲置:SM 利用率仅 7–26%,存在大量可利用的算力/时间余量
- TTFT 被非计算开销主导:真正的 prefill 计算只占 P95 TTFT 的 2–23%,剩余是排队等待 + 跨节点 KV 传输(KV transfer P95 可达 1.4–4.2 秒)
关键洞察:既然 decode 节点有空闲,为什么不让它们直接”就地”完成部分请求的 prefill?这样既利用了闲置算力,又省去了 prefill→decode 的跨节点 KV 传输。
解决方案概述
Kairos 采用逐请求、TBT 安全的 chunk 扫描策略进行偏转决策:
- 对每个请求,估计它留在 prefill 节点的 TTFT(排队 + 执行)
- 在每个 decode 节点上贪心构造一个 TBT 安全的 chunked-prefill 调度(保证在飞 decode 不超其 TBT SLO)
- 若某 decode 节点能更快完成且满足安全裕度,则将请求偏转到该节点就地跑 prefill
- 偏转后 prefill 在 decode 节点本地运行 → 无需跨节点 KV 传输
三、技术架构
整体架构
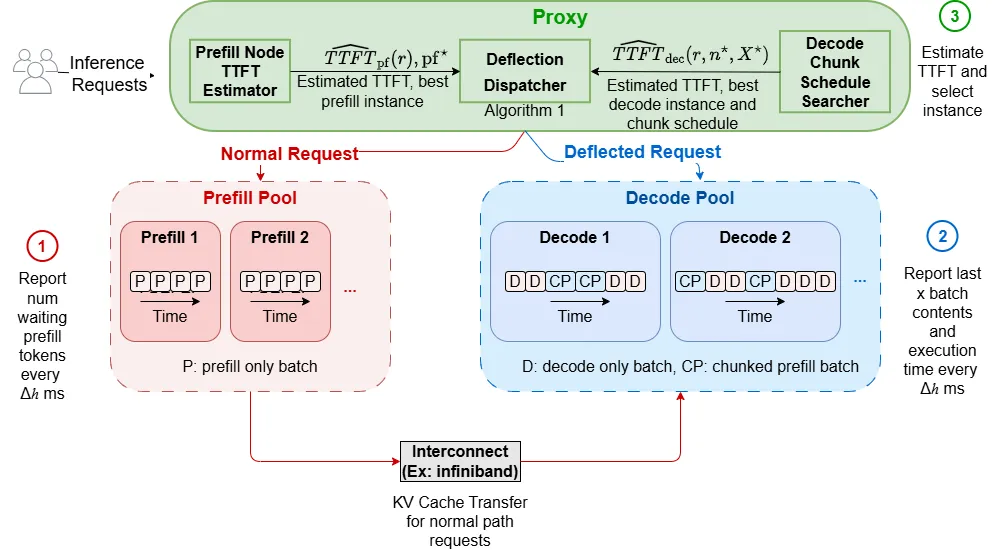
Kairos 由三个核心组件构成:
| 组件 | 功能 |
|---|---|
| Prefill-Node TTFT Estimator | 估计请求留在 prefill 节点的预期 TTFT(排队等待 + prefill 执行) |
| Decode-Node Feasibility Checker | 在每个 decode 节点上检查是否存在不违反 TBT 的 chunked-prefill 调度,并估计其 TTFT |
| Deflection Decision Algorithm | 组合上述两者,选出最快的可行节点,并在满足安全裕度时才偏转 |
背景术语
| 术语 | 含义 |
|---|---|
| Prefill | 处理输入 prompt、生成首个 token 的阶段(计算密集) |
| Decode | 逐 token 自回归生成阶段(访存密集) |
| TTFT | Time-To-First-Token,首 token 延迟 |
| TBT | Time-Between-Tokens,token 间延迟(decode 阶段 SLO) |
| Chunked Prefill | 将长 prompt 的 prefill 拆成小块,与 decode 步骤交错执行 |
| Deflection | 偏转——将本应在 prefill 节点跑的请求转到 decode 节点就地 prefill |
核心公式
1. Prefill 节点 TTFT 估计(式 1):
其中排队等待时间(式 2,FIFO 调度,假设每步半数未完成 prefill token 已缓存):
- :队列中排在 前面各请求的 prompt 长度
- :prefill 节点 chunk 大小
2. Decode 节点步延迟模型(式 4):
- :decode 节点当前 decode batch size
- :KV-cache 占用量(token 数)
- :该步注入的 chunked prefill 大小
- :纯 decode 基线步延迟;:注入 prefill token 带来的延迟增量
- 两项均由 §3.3 的线性回归预测器给出,held-out trace 上 MAPE < 10%,预测复杂度
3. TBT 安全的 Chunk 调度(式 5):
- 调度 ,满足
- :TBT SLO;:可调安全因子
- 关键发现:随着 decode 节点上缓存的 prefill token 累积, 增大,能安全承载的最大 逐步缩小 → 后续 chunk 不等价,需逐步收缩
- 贪心构造:每步选满足式 5 的最大
4. Decode 节点 TTFT 估计(式 6):
偏转决策算法(Algorithm 1)
输入:请求 (prompt 长度 )、prefill 节点队列状态 、chunk 大小 、各 decode 节点状态 、chunk 候选集 、TBT SLO 、偏转裕度
流程:
- 估计 prefill 节点 TTFT:(式 1)
- 逐 decode 节点构造 TBT 安全调度:贪心地用
LargestSafe选出满足式 5 的最大 chunk,累加直到覆盖 ;若某步 则该节点不可行 - 选最快可行节点 :在可行集 中选 最小者
- 裕度判定后偏转:仅当 decode 路径的 TTFT 满足 裕度条件(明显优于 prefill 路径)时才偏转,否则留在 prefill 节点
输出:
四、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| Prefill 偏转(Deflection) | 让空闲 decode 节点以 chunked-prefill 代跑 prefill,消除跨节点 KV 传输 | TTFT 中 KV 传输占大头(P95 达 1.4–4.2s) |
| 逐请求 TBT 安全扫描 | 每请求动态搜索最大安全 chunk 调度,保证在飞 decode 不违反 TBT | 静态策略要么欠偏转要么过偏转(表 4) |
| 收缩式 chunk 调度 | 认识到后续 chunk 因 KV 累积而不等价,逐步收缩 | §3.2 实验发现 随缓存增长 |
| 轻量步延迟预测 | 线性回归预测器,MAPE<10%, 开销 | 亚毫秒级路由开销 |
| 主动负载感知路由 | 综合排队+执行+安全裕度做全局最优偏转 | 相比静态阈值策略避免两种失效模式 |
五、实证研究 (Empirical Study)
5.1 P95 TTFT 分解
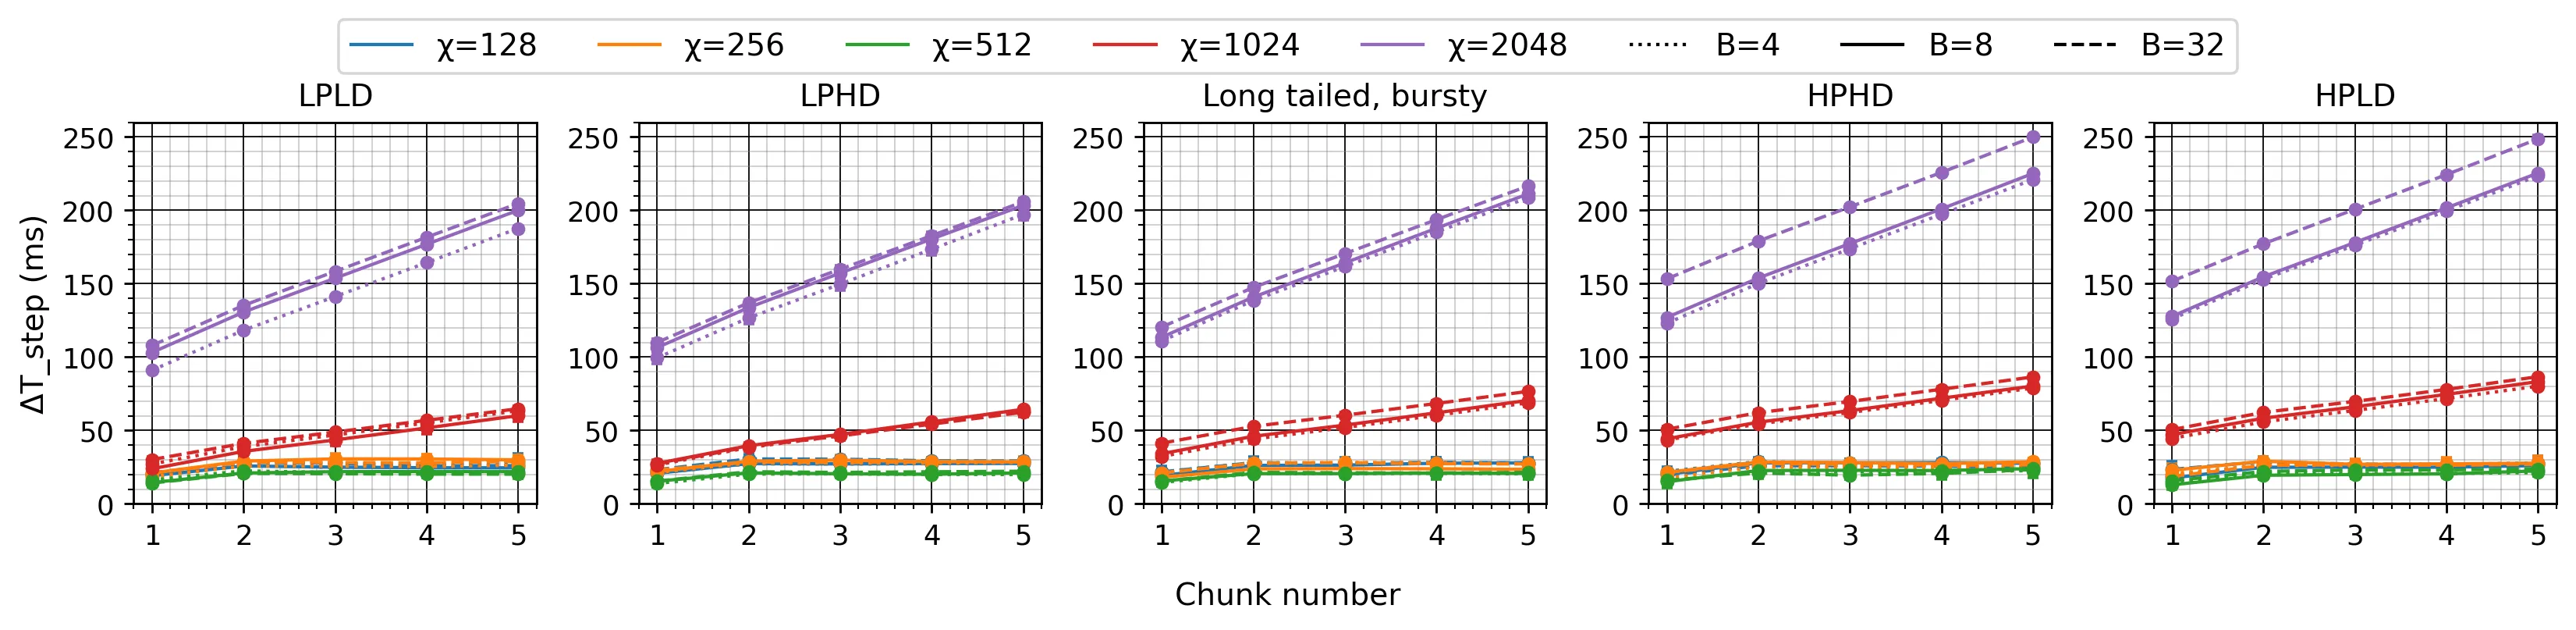
表 3:P95 TTFT 分解(ms) —— prefill 执行仅占 2–23%,其余为排队与 KV 传输:
| 工作负载 | Prefill 排队 | Prefill 执行 | KV 传输 | Decode 排队 | 端到端 TTFT |
|---|---|---|---|---|---|
| LPLD | 59.2 | 191.4 | 4,205.4 | 54.5 | 6,278.8 |
| LPHD | 54.4 | 177.0 | 1,428.9 | 58.6 | 7,876.1 |
| HPLD | 655.3 | 1,340.2 | 1,723.4 | 37.4 | 5,781.5 |
| HPHD | 349.6 | 1,222.8 | 3,584.6 | 55.4 | 6,292.0 |
| Bursty | 840.8 | 1,070.1 | 2,175.6 | 55.6 | 7,893.9 |
5.2 资源利用率失衡
表 2:prefill vs decode 稳态利用率 —— prefill 节点 SM 76–84%(饱和),decode 节点 SM 仅 7–26%(闲置):
| 工作负载 | Prefill SM% | Prefill TC% | Decode SM% | Decode TC% |
|---|---|---|---|---|
| LPLD | 76.3 | 43.2 | 15.5 | 1.9 |
| LPHD | 75.0 | 42.7 | 26.4 | 5.6 |
| HPLD | 83.9 | 48.6 | 7.5 | 1.2 |
| HPHD | 82.5 | 47.7 | 16.8 | 2.1 |
| Bursty | 79.6 | 45.8 | 16.4 | 2.0 |
5.3 静态策略的失效
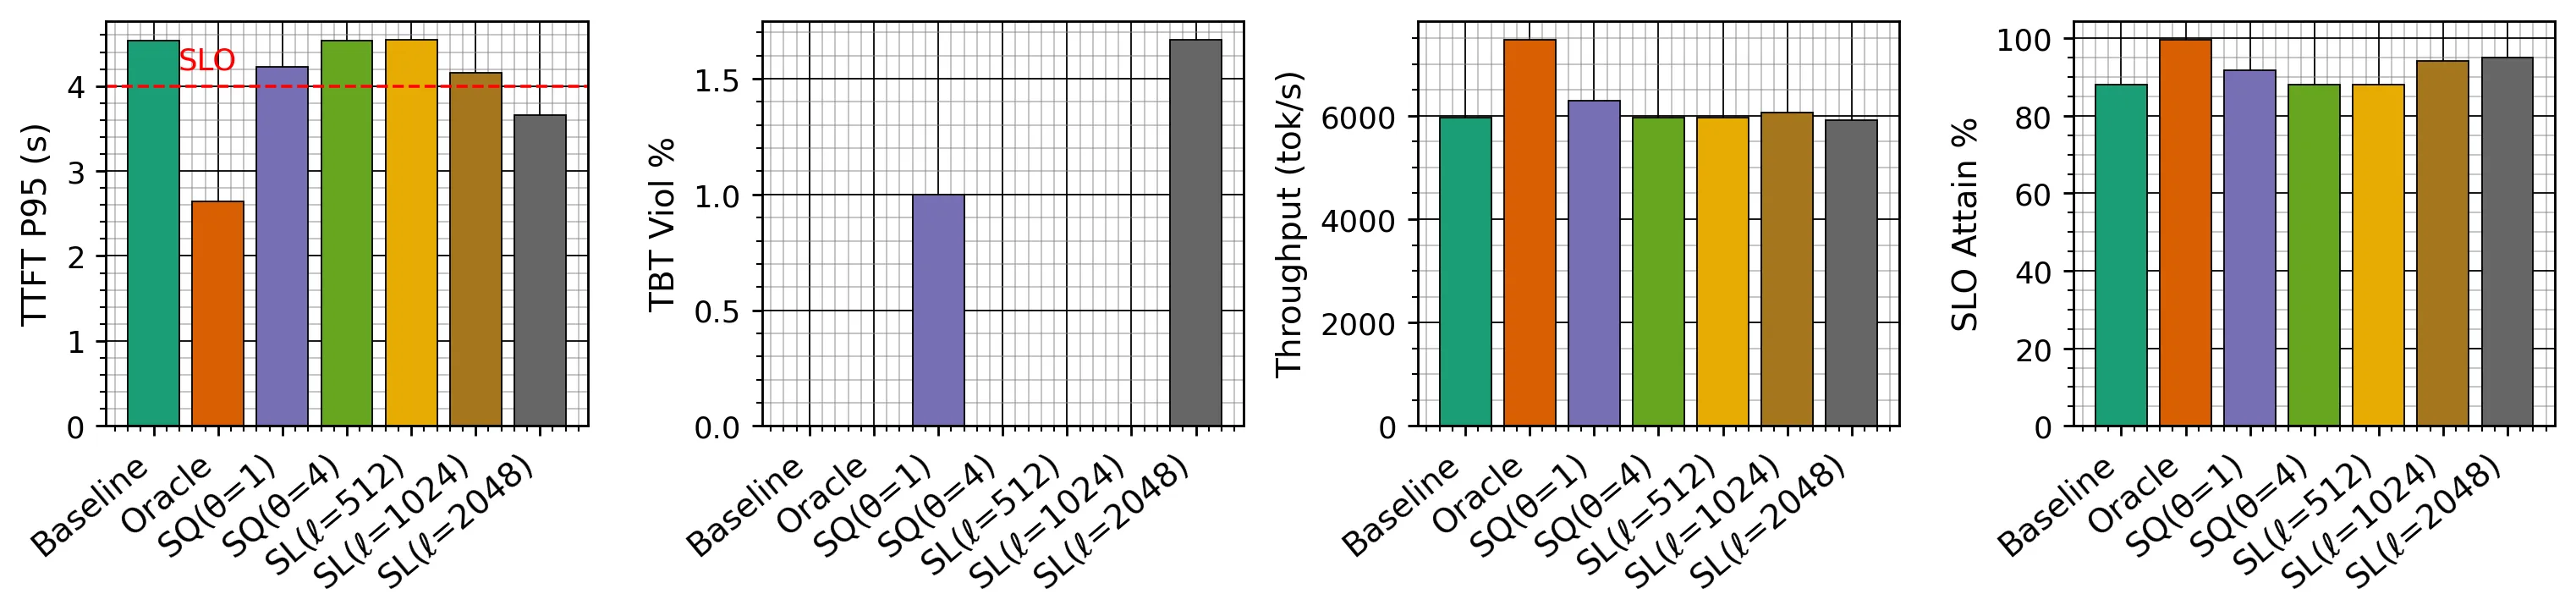
表 4:静态偏转策略 vs Oracle(Bursty 负载) —— 静态策略有两种失效模式:欠偏转(SQ、SL(ℓ≤1024))和过偏转(SL(ℓ=2048),引发 TBT 违规):
| 策略 | 偏转数 | P95 TTFT(s)↓ | TBT违规%↓ | SLO达成%↑ |
|---|---|---|---|---|
| Baseline (无偏转) | 0 | 4.5 | 0.0 | 88.0 |
| SQ(θ=1) | 7 | 4.2 | 1.0 | 91.7 |
| SQ(θ=4) | 0 | 4.5 | 0.0 | 88.0 |
| SL(ℓ=512) | 3 | 4.5 | 0.0 | 88.0 |
| SL(ℓ=1024) | 151 | 4.1 | 0.0 | 94.1 |
| SL(ℓ=2048) | 298 | 3.6 | 1.5 | 95.1 |
| Oracle | 251 | 2.6 | 0.0 | 99.5 |
结论:需要动态、逐请求的偏转决策才能接近 Oracle。
六、实验结果
6.1 实验设置
- 硬件:Azure ML Compute(Standard_ND96amsr_A100_v4),每节点 8×A100-SXM4-80GB(NVLink 3.0),AMD EPYC 7V12 64 核,900 GiB 内存;节点间 InfiniBand + Azure Accelerated Networking
- 拓扑:2P2D(2 prefill + 2 decode)
- 模型:DeepSeek-V2-Lite(MoE,16B 总参 / 2.4B 激活)
- Trace:Bursty(最真实,未经分层处理)
- SLO:P95 TTFT ≤ 4s 且 P95 TBT ≤ 70ms(须同时满足)
- 基线:
- PD Disaggregation:DistServe 风格传统分离,所有 prefill 在 prefill 节点
- TaiChi:聚合/分离统一 + 差异化 GPU 实例 + flowing-decode 调度
6.2 Q1:降低尾 TTFT 同时维持 TBT
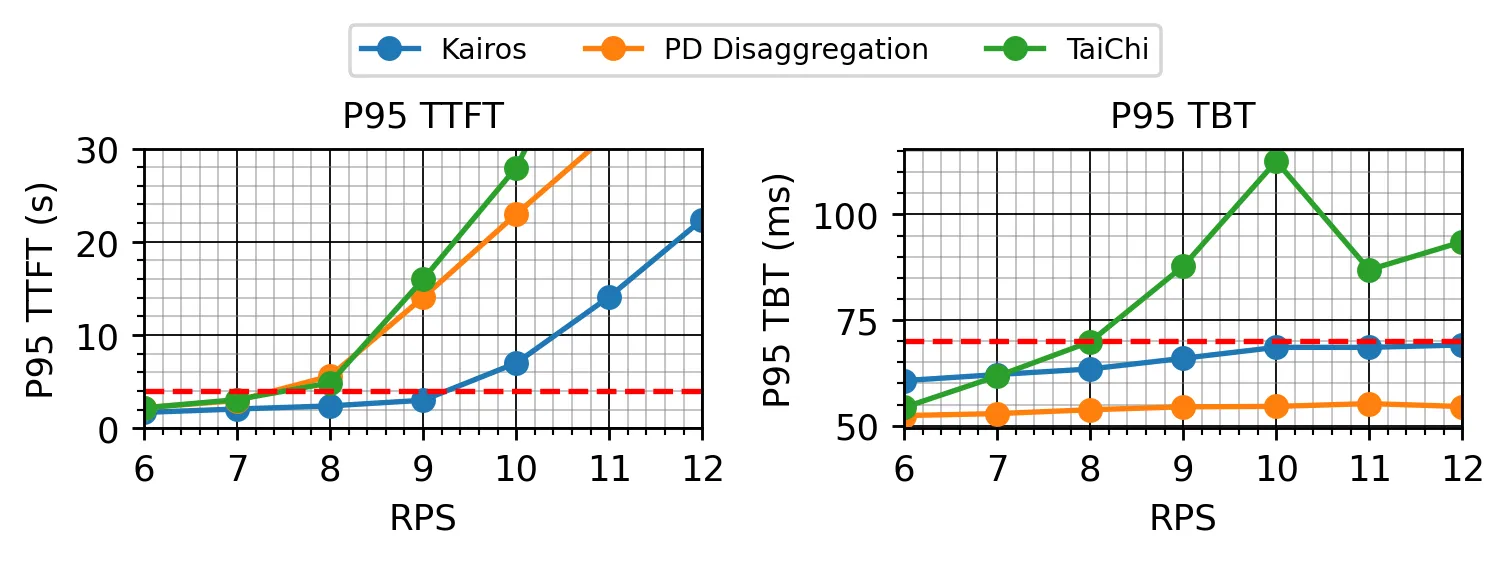
- P95 TTFT:Bursty trace 上 Kairos 在 9 RPS 内维持 SLO,而 PD 分离和 TaiChi 仅能到 7 RPS。低 RPS 时 Kairos 与 PD 分离接近(排队少无需偏转),高 RPS 时差距拉大
- P95 TBT:Kairos 构造上保证零 TBT 违规,始终低于 70ms SLO;因利用 TBT 余量偏转,P95 TBT 比基线高 5–10ms
6.3 Q2:吞吐量与 SLO 达成率
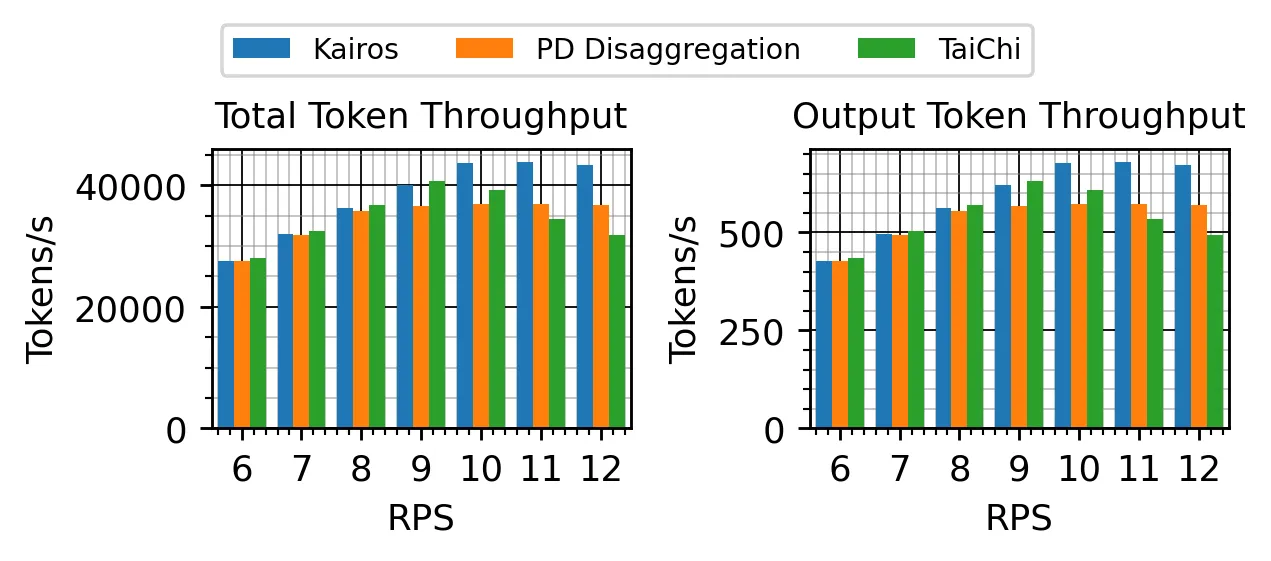
- 吞吐量:Kairos 在高 RPS 下总吞吐/输出 token 吞吐均高于两基线;PD 分离和 TaiChi 在更低吞吐处饱和(TaiChi 在 9 RPS 后甚至恶化)
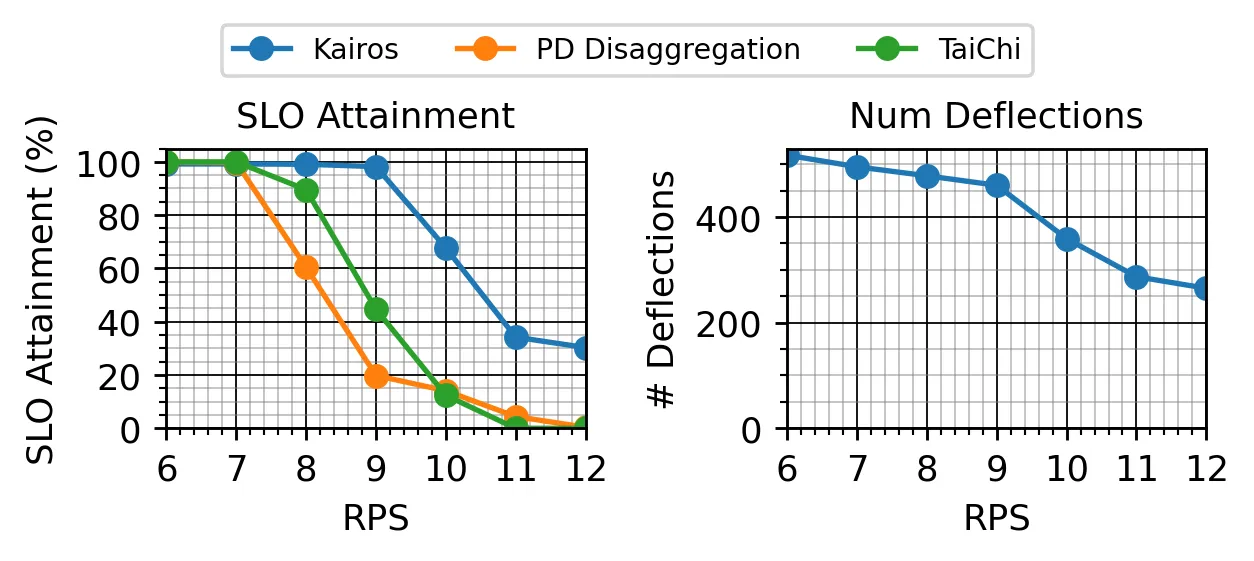
- SLO 达成率:Kairos 在 9 RPS 内保持 100% 联合 SLO 达成,优于 PD 分离和 TaiChi(图 6 左,各 RPS 下均最佳)
6.4 Q3:偏转数量随负载的变化
- 6 RPS 时偏转 >500 个请求,12 RPS 时降至 265 个
- 原因:高 RPS 下 prefill 排队更严重 → 偏转潜在收益更大;但 decode 节点 batch 更大、缓存 token 更多 → TBT 余量收窄 → 安全 chunk 变小甚至为 0 → 偏转数减少以避免违反在飞 decode 的 TBT
- 体现了 Kairos 的自适应负载感知特性
6.5 总体收益
- P95 TTFT 最高降低 81%
- SLO 达成率最高提升 79%(相比 SOTA 分离式调度器)
- 路由开销亚毫秒级(每请求)
七、相关工作
表 5:Kairos vs 其他系统
| 系统 | 机制 | 范围 | 目标 |
|---|---|---|---|
| Sarathi | Token chunked prefill | 节点内 | 缓解 decode stall |
| Nexus | GPU 内 SM 划分 | GPU 内 | 阶段干扰 |
| PPD | Append-prefill 路由 | 跨节点(多轮) | 第 2+ 轮 TTFT |
| TaiChi | 聚合+分离滑块 | 集群配置 | 任意 SLO 下的 goodput |
| Splitwise | 静态 PD 划分 | 集群拓扑 | 阶段分离 |
| DistServe | 放置优化 | 集群供给 | 节点比例 |
| Kairos | 逐请求 TBT 安全 chunk 扫描 | 跨节点偏转 | prefill 瓶颈 |
Kairos 的独特之处:首个在跨节点层面、基于逐请求 TBT 安全性主动偏转 prefill 以消除 KV 传输的调度器。
八、总结
核心贡献
- 实证发现:在生产级 2P2D 集群上,prefill 执行仅占 P95 TTFT 的 2–23%,瓶颈是排队与跨节点 KV 传输,且 decode 节点存在大量闲置算力
- Prefill 偏转机制:让 decode 节点以 chunked-prefill 就地代跑 prefill,消除跨节点 KV 传输
- TBT 安全的动态调度:逐请求贪心构造收缩式 chunk 调度,构造上保证零 TBT 违规
- 轻量预测器:线性回归步延迟模型(MAPE<10%,),实现亚毫秒级路由
- 显著收益:vLLM 实现,P95 TTFT 降低最高 81%,SLO 达成率提升最高 79%
技术影响
- 揭示了 PD 分离架构在真实重尾负载下的资源失衡问题,为”弹性利用 decode 闲置算力”提供了新思路
- 提出的”负载感知偏转”可与现有分离式部署(DistServe/Splitwise 风格)结合,无需改变集群拓扑
局限性
- 评测限于 2P2D 小规模拓扑与单一模型(DeepSeek-V2-Lite)
- 预测器依赖离线 profiling,模型/硬件变化需重新标定
- 偏转会抬高 decode 节点 TBT(5–10ms),在极紧 TBT SLO 场景余量有限
- 未涉及多轮对话/前缀复用等更复杂场景的偏转策略
九、参考资源
- arXiv: https://arxiv.org/abs/2607.02043
- 实现基础: vLLM
- 评测模型: DeepSeek-V2-Lite
图表索引
| 图号 | 描述 | 文件名 |
|---|---|---|
| Figure 1 | 各工作负载的 chunked-prefill 注入步延迟增量(松弛度) | figure-1-slack-per-workload.png |
| Figure 2 | 静态偏转策略对比 | figure-2-static-policies.png |
| Figure 3 | Kairos 系统架构 | figure-3-system-diagram.png |
| Figure 4 | P95 TTFT 与 P95 TBT vs 请求率 | figure-4-ttft-tbt.png |
| Figure 5 | 吞吐量对比 | figure-5-throughputs.png |
| Figure 6 | SLO 达成率与偏转数量 | figure-6-slo-deflections.png |
分析日期: 2026-07-07 分析师: AI Paper Analyzer