Multi-Resolution Flow Matching: Training-Free Diffusion Acceleration via Staged Sampling
MrFlow achieves 10x+ training-free acceleration for flow-matching diffusion models via a four-stage low-to-high resolution pipeline
Multi-Resolution Flow Matching: Training-Free Diffusion Acceleration via Staged Sampling
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Multi-Resolution Flow Matching: Training-Free Diffusion Acceleration via Staged Sampling |
| 作者 | Xingyu Zheng, Xianglong Liu, Yifu Ding, Weilun Feng, Junqing Lin, Jinyang Guo, Haotong Qin |
| 机构 | (作者机构未在摘要页明确列出,代码见 GitHub) |
| 论文 | https://arxiv.org/abs/2607.01642 |
| 代码 | https://github.com/Xingyu-Zheng/MrFlow |
| 发布 | 2026-07-02 (v1) |
| 许可 | Non-exclusive distributable license |
二、核心思想
问题定义
现代扩散模型(如 Qwen-Image-20B)在 A100 上生成 1024×1024 图像需要约 4747 秒(50-100 步 NFE)。现有加速方法各有局限:
- 时间步蒸馏(如 SenseFlow, Pi-Flow):将 50-100 步降至 1-4 步,但需要训练
- 特征缓存(如 Teacache, DB-Taylor):跨时间步复用特征,加速有限(<4×)
- 多分辨率方法(如 LSSGen, RALU, SPEED):无需训练即可实现 >5× 加速,但在潜空间上采样并通过上采样生成高分辨率图像,导致明显的模糊或伪影
解决方案概述
本文提出 MrFlow(Multi-Resolution Flow Matching)——一种无需训练的多分辨率加速策略,专为预训练流匹配(flow-matching)模型设计。MrFlow 采用分阶段低分辨率到高分辨率的流水线:
- 快速 LR 结构生成:在低分辨率下用少量步骤生成主要结构
- 像素空间超分辨率:用轻量级预训练 GAN 模型(Real-ESRGAN)进行上采样
- 低频噪声注入:注入弱噪声以启用高频重采样,使高分辨率流先验能够校正/重采样高频细节
- HR 细节精炼:在高分辨率下进行一步细节精炼
在 FLUX.1-dev 和 Qwen-Image 上的定量和定性结果表明,MrFlow 利用二次方 token 减少和减少的步骤需求实现了 10× 端到端加速,同时保持 OneIG 质量差距在 1% 以内,显著超越了其他无需训练的加速策略。MrFlow 还可以直接与预训练的时间步蒸馏策略组合,实现高达 25× 的生成加速。
三、技术架构
整体框架图
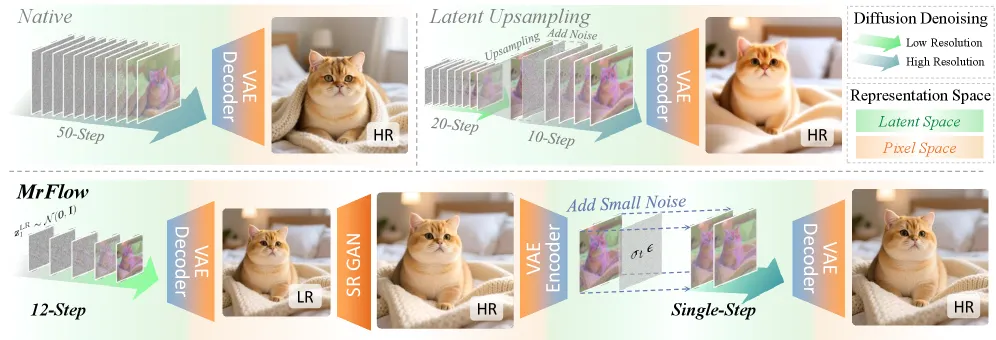
MrFlow 的四阶段流水线:
┌────────────────────────────────────────────────────────────────┐
│                     MrFlow Staged Pipeline                      │
├────────────────────────────────────────────────────────────────┤
│                                                                 │
│  Stage 1: Low-Resolution Structure Generation                   │
│  ┌─────────────────────────────────────────────────────────┐   │
│  │  z_1^LR ~ N(0,I)  (in LR latent space)                  │   │
│  │  ↓ Flow Matching ODE sampling (K_L = 12 steps)          │   │
│  │  ↓ VAE Decoder                                          │   │
│  │  → x_LR (clean LR image, e.g. 512×512)                  │   │
│  └─────────────────────────────────────────────────────────┘   │
│                    ↓                                            │
│  Stage 2: Pixel-Space Super-Resolution                          │
│  ┌─────────────────────────────────────────────────────────┐   │
│  │  x_SR = GAN-SR(x_LR)  (Real-ESRGAN, ×2 upscaling)      │   │
│  │  → x_SR preserves LR structure + adds HF details        │   │
│  └─────────────────────────────────────────────────────────┘   │
│                    ↓                                            │
│  Stage 3: Low-Strength Noise Injection                          │
│  ┌─────────────────────────────────────────────────────────┐   │
│  │  z_0^SR = VAE_Encode(x_SR)                               │   │
│  │  z_t^HR = (1 - σ_t) · z_0^SR + σ_t · ε                  │   │
│  │  where σ_t ∈ [0.1, 0.15]                                 │   │
│  │  → Weakens SR artifacts, keeps LR structure at high SNR  │   │
│  └─────────────────────────────────────────────────────────┘   │
│                    ↓                                            │
│  Stage 4: High-Resolution Detail Refinement                     │
│  ┌─────────────────────────────────────────────────────────┐   │
│  │  z_t^HR → Flow Map (1 step, same velocity net)          │   │
│  │  ↓ VAE Decoder                                          │   │
│  │  → x_HR (final image, e.g. 1024×1024)                   │   │
│  └─────────────────────────────────────────────────────────┘   │
│                                                                 │
└────────────────────────────────────────────────────────────────┘
核心公式
Stage 3 噪声注入公式:
其中 为低强度噪声系数。
噪声强度下界推导:
其中 为干净数据的高频功率,可通过可测的高频分量计算得到。
加速来源:
- 二次方 token 减少:每边分辨率减半 → token 数量减少 4× → 每步加速 ~4×
- 更少步骤:LR 主导结构,收敛所需时间步更少(通常 12 步 vs 50 步)
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| Flow Matching 采样器 | 使用预训练的 flow-matching 模型(FLUX.1-dev, Qwen-Image) | LR 步数 K_L = 12-20, HR 步数 K_H = 1 |
| VAE Encoder/Decoder | Stable Diffusion 风格的编解码器 | 潜空间分辨率 512×512 / 1024×1024 |
| GAN-based SR | Real-ESRGAN(选择原因:GAN 先验产生更真实的高频细节) | ×2 上采样 |
| 噪声注入模块 | 低强度高斯噪声 | σ_t ∈ [0.1, 0.15] |
关键设计选择
为什么选择像素空间 SR 而非潜空间上采样?
现有方法(LSSGen, RALU, SPEED)在潜空间中进行上采样和选择性区域修改,导致模糊或伪影。MrFlow 改为在像素空间进行超分辨率,然后重新编码回潜空间,避免了潜空间上采样的结构失真。
为什么选择 Real-ESRGAN 而非插值或其他 SR 模型?
| SR 方法 | 加速比 | Geneval 得分 | 备注 |
|---|---|---|---|
| 双线性插值 | 10.7× | 0.87 | 速度快但质量较低 |
| Real-ESRGAN (GAN) | 10.3× | 0.86 | 最佳质量/效率权衡 |
| SwinIR (L2 监督) | 4.67× | — | 模型计算太慢 |
| OSEDiff | 9.45× | — | 备选方案 |
Real-ESRGAN 的 GAN 先验比 L2 监督模型(如 SwinIR)产生更真实的高频细节,且计算开销远低于 SwinIR。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 四阶段分阶段采样 | 将扩散生成解耦为结构生成(SR)+高频重采样两步 | 结构-细节解耦:LR 负责全局结构,HR 负责局部细节 |
| 像素空间超分辨率 | 避免潜空间上采样的模糊/伪影 | Real-ESRGAN 在质量和速度间取得最佳平衡 |
| 低频噪声注入 | 降低高频信噪比,使去噪器可以重采样/校正高频细节 | 理论下界推导 + CLIP 相似度验证(1 步 vs 5 步仅 0.9974 vs 0.9999) |
| 单步 HR 精炼 | 利用接近干净的端点和平坦的速度场,只需 1 步 | 欧拉离散化误差极小 |
| 正交组合蒸馏 | 可与时间步蒸馏策略直接组合 | 最高 25× 加速 |
五、代码实现分析
GitHub: https://github.com/Xingyu-Zheng/MrFlow
MrFlow 的核心实现思路:
- 复用预训练的 flow-matching 模型(无需修改权重)
- 在采样流程中插入 Real-ESRGAN 上采样和噪声注入步骤
- 无需训练或运行时动态识别
与现有加速方法的正交性: MrFlow 不依赖于模型微调或训练,因此可以与需要训练的方法(如时间步蒸馏)组合使用,实现加速效果的复合叠加。
六、实验结果
基准测试
训练-free 加速方法对比(FLUX.1-dev):
| 方法 | 加速比 | Geneval 得分 |
|---|---|---|
| MrFlow (20,1) | 5.78× | 0.65 |
| MrFlow (12,1) | 8.25× | 0.63 |
| LSSGen | 3.93× | — |
| Teacache | 崩溃于 >8× | — |
| DB-Taylor | 崩溃于 >8× | — |
| RALU | 明显退化 | — |
| Native (80 steps) | 1× | — |
训练-free 加速方法对比(Qwen-Image):
| 方法 | 加速比 | Geneval | OneIG-En |
|---|---|---|---|
| MrFlow (20,1)×2 | 6.98× | 0.87 | 0.54 |
| MrFlow (12,1)×2 | 10.3× | 0.86 | 0.52 |
| SPEED | 急剧下降 | — | — |
| Native (50×2 steps) | 1× | — | — |
与训练依赖方法对比
| 方法 | 是否需要训练 | 加速比 | Geneval |
|---|---|---|---|
| MrFlow (12,1) | 否 | 8.25× | 0.63 |
| SenseFlow (4-step) | 是 | 11.1× | — |
| Pi-Flow (4-step) | 是 | — | — |
| LSSGen (需训练) | 是 | 3.93× | — |
MrFlow 在无需训练的前提下,性能接近需要训练的蒸馏方法。
消融实验
SR 方法选择(Qwen-Image, MrFlow (12,1)×2):
| 方法 | 加速比 | Geneval |
|---|---|---|
| 双线性插值 | 10.7× | 0.87 |
| Real-ESRGAN | 10.3× | 0.86 |
| SwinIR | 4.67× | — |
| OSEDiff | 9.45× | — |
HR 步数配置(Figure 4):
- K_H = 1 步默认配置已足够
- CLIP 相似度:1 步 (s=0.1) = 0.9974 vs 5 步 = 0.9999,差异可忽略
扩展模型结果:
- FLUX.2 Klein 变体(4B, 8B):一致获得 7-8× 加速
- Z-Image 和 Z-Image-Turbo:MrFlow 保持有效加速
质量-速度权衡曲线
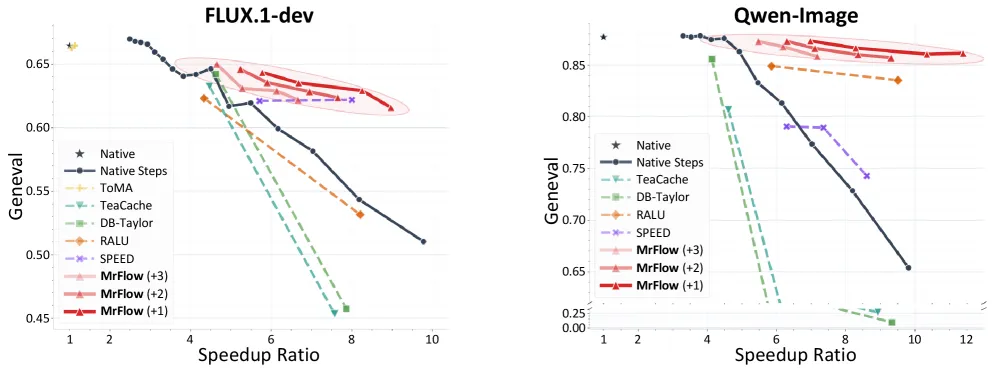
MrFlow 在高加速比区域(>8×)明显优于其他训练-free 方法,后者在此区域普遍出现质量崩溃。
运行时分解
Native Qwen-Image 的 50×2 步 vs MrFlow 的 12+1 步,MrFlow 在各阶段的总运行时间大幅降低。
七、相关工作
- LSSGen / RALU / SPEED:多分辨率生成策略,>5× 加速但存在模糊/伪影问题
- ToMA / Teacache / DB-Taylor:特征缓存方法,加速有限(<4×)
- SenseFlow / Pi-Flow:时间步蒸馏方法,需要训练但可达 11× 加速
- FlashAttention:类似的思想——通过算法修改而非更多步骤来加速
八、总结
核心贡献
- MrFlow 框架:首个针对 flow-matching 模型的无需训练多分辨率加速策略
- 四阶段分阶段采样流水线:LR 结构生成 → 像素空间 SR → 低频噪声注入 → 单步 HR 精炼
- 理论分析:噪声强度下界推导、单步充分性证明、结构-细节解耦分析
- 实证结果:FLUX.1-dev 上 8.25×、Qwen-Image 上 10.3× 加速,质量损失 <1%
- 可扩展性:与时间步蒸馏正交组合,最高 25× 加速;适用于 FLUX.2、Z-Image 等多个模型
技术影响
- 无需训练:直接应用于任何预训练的 flow-matching 模型,无需微调
- 即插即用:只需替换采样流程中的上采样和噪声注入步骤
- 正交组合:可与蒸馏、特征缓存等方法叠加使用
局限性
- 当前仅针对 flow-matching 模型(未测试传统 DDPM)
- GAN-based SR 可能在某些风格上引入过度锐化
- 对于极端加速需求(>20×),仍需结合蒸馏方法
九、参考资源
- arXiv: https://arxiv.org/abs/2607.01642
- GitHub: https://github.com/Xingyu-Zheng/MrFlow
- 评估模型: FLUX.1-dev, FLUX.2-Klein (4B/8B), Qwen-Image, Qwen-Image-20B, Z-Image, Z-Image-Turbo
- 基准测试: OneIG-Bench, Geneval
关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 2 | MrFlow 框架总览 | framework-overview.png |
| Figure 1 | 定性对比(MrFlow vs 其他方法) | qualitative-comparison.png |
| Figure 3 | 不同 SR 方法对比 | sr-methods.png |
| Figure 5 | 质量-速度权衡曲线 | tradeoff-curve.png |
| Figure 6 | 运行时分解 | runtime-breakdown.png |