AdaJEPA: An Adaptive Latent World Model
A test-time adaptation framework that performs lightweight updates within the closed loop of Model Predictive Control (MPC) to continuously recalibrate a JEPA world model during deployment
AdaJEPA: An Adaptive Latent World Model
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | AdaJEPA: An Adaptive Latent World Model |
| 作者 | Ying Wang, Oumayma Bounou, Yann LeCun, Mengye Ren |
| 机构 | New York University, AMI Labs |
| 论文 | https://arxiv.org/abs/2606.32026 |
| 代码 | https://agenticlearning.ai/adajepa |
| 发布 | arXiv:2606.32026, June 30, 2026 |
| 许可 | - |
二、核心思想
问题定义
潜在世界模型(latent world models)通过在紧凑的潜在空间中预测未来状态来实现高效规划和决策。然而,这些模型在训练后通常保持冻结(frozen)——当预测变得不准确时,模型预测控制(MPC)会优化错误的目标。在测试时分布偏移(distribution shift)下尤为严重:
- 视觉变化:噪声、光照、背景干扰会导致编码器对齐偏差
- 动力学变化:摩擦、质量、接触动力学的改变会导致潜在预测器偏差
即使是有高容量的世界模型,微小的测试环境变化也可能导致性能大幅下降。
解决方案概述
提出 AdaJEPA——一个自适应的世界模型框架,在MPC闭环中执行测试时适应(test-time adaptation)。核心循环:
Plan → Act → Adapt → Replan- 用当前模型规划动作序列
- 执行第一个动作,观察环境返回新状态
- 用新观测到的转换
(o_t, a_t, o_{t+1})作为自监督信号,更新模型(仅1个梯度步) - 用更新后的模型重新规划
这种设计使得学习和规划紧密耦合:模型用预测选择动作,动作的后果提供适应信号,适应后的模型改进下一次规划的预测。
三、技术架构
整体框架
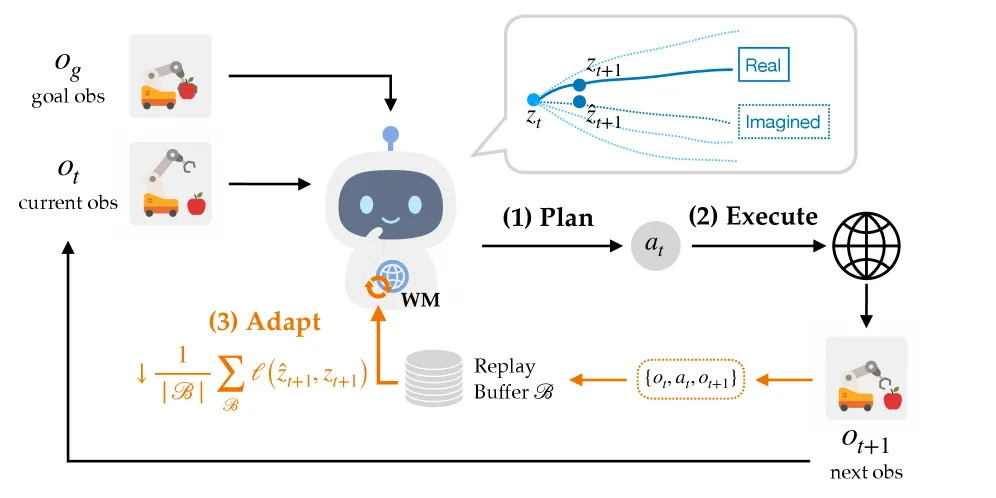
JEPA 世界模型基础
世界模型由编码器、动作编码器和预测器组成:
预测损失:
MPC 规划目标:
AdaJEPA 适应算法
Algorithm 1: AdaJEPA Closed-Loop Plan-and-Adapt
输入: 预训练世界模型 (ℰ_φ^s, ℰ_ψ^a, f_θ), 可训练参数 Ω, 目标观测 o_g,
      规划 horizon H, 适应步数 U, 缓冲区大小 N, 最大步数 T
初始化缓冲区 ℬ ← ∅; 观察 o_0
for t = 0, 1, ..., T-1 do:
    4: 用当前模型规划: 最小化潜在目标到达代价 (公式3)
    5: 执行第一个动作 a_t 并观察 o_{t+1}
    6: 将 (o_t, a_t, o_{t+1}) 加入 ℬ 并裁剪至最多 N 个转换
    7: for u = 1, ..., U do:
    8:     Ω ← Ω - η∇_Ω ℒ_ada(ℬ)
    9: end for
10: end for适应损失:
其中 sg(·) 表示 stop-gradient 算子以防止崩溃。
在线缓冲区策略:
- recent-N:只保留最近 N 个转换,聚焦局部观测和动力学
- hard-N:只保留预测误差最大的 N 个转换
适应参数:默认只更新视觉编码器和预测器的最后层,其余参数冻结。这使得适应轻量且快速。
架构概览
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 视觉编码器 | ResNet,输出全局特征 | lr=1e-5 |
| 预测器 | Transformer-based | lr=5e-4 |
| 动作编码器 | 拼接视觉和本体感受嵌入 | lr=5e-4 |
| 防崩溃机制 | stop-gradient + 曲率正则化 | - |
| 规划器 | GD 或 CEM | horizon=25 |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| MPC 内测试时适应 | 首次在 JEPA 世界模型的 MPC 闭环中进行测试时适应 | 第3节,Algorithm 1 |
| 单步适应 | 每次MPC重规划仅需1个梯度步 | 表2:增加0.01-0.03秒延迟 |
| 环境无关的适应性 | 适应目标的选择因环境而异,但对具体选择不敏感 | 图7:所有适应层组合均优于冻结模型 |
| 数据稀缺时的补偿 | 适应可以补偿训练数据的不足,低数据量下效果最显著 | 图5:1k轨迹下从28.1%提升到60.8% |
五、实验结果
评估环境
| 环境 | 任务 | 分布偏移类型 |
|---|---|---|
| PushT | 接触丰富的推物体操作 | 形状偏移、视觉偏移 |
| PushObj | 多种形状物体的推物 | 形状偏移、数据规模 |
| PointMaze-Medium | 2D导航 | 动力学偏移(低质量、高阻尼) |
| Diverse PointMaze | 随机生成的8×8迷宫 | 布局偏移(5个未见迷宫) |
分布偏移下的规划成功率
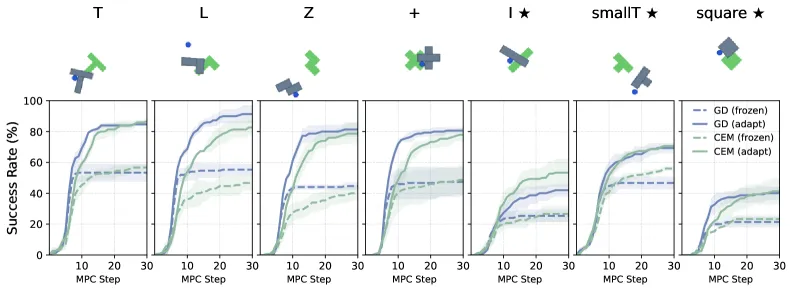
表:PointMaze 动力学和布局偏移下的规划成功率(%)
| 设置 | 默认 | 低质量 | 高阻尼 | 未见迷宫 |
|---|---|---|---|---|
| Frozen (GD) | 82.7±6.8 | 84.0±3.3 | 77.3±8.2 | 53.3±8.2 |
| Frozen (CEM) | 82.0±2.8 | 77.3±5.0 | 76.0±2.8 | 49.3±6.2 |
| AdaJEPA predlast+enclast (GD) | 83.3±6.6 | 83.3±3.4 | 80.0±3.3 | 77.3±10.5 |
| AdaJEPA predlast+enclast (CEM) | 86.7±2.5 | 78.7±3.4 | 78.7±5.0 | 66.0±7.1 |
| AdaJEPA predfirst+enclast (GD) | 84.0±1.6 | 82.0±1.6 | 82.7±3.4 | 78.7±4.7 |
| AdaJEPA predfirst+enclast (CEM) | 82.0±3.3 | 78.7±5.0 | 70.7±3.8 | 25.3↑ |
不同 JEPA 实现的 AdaJEPA 对比
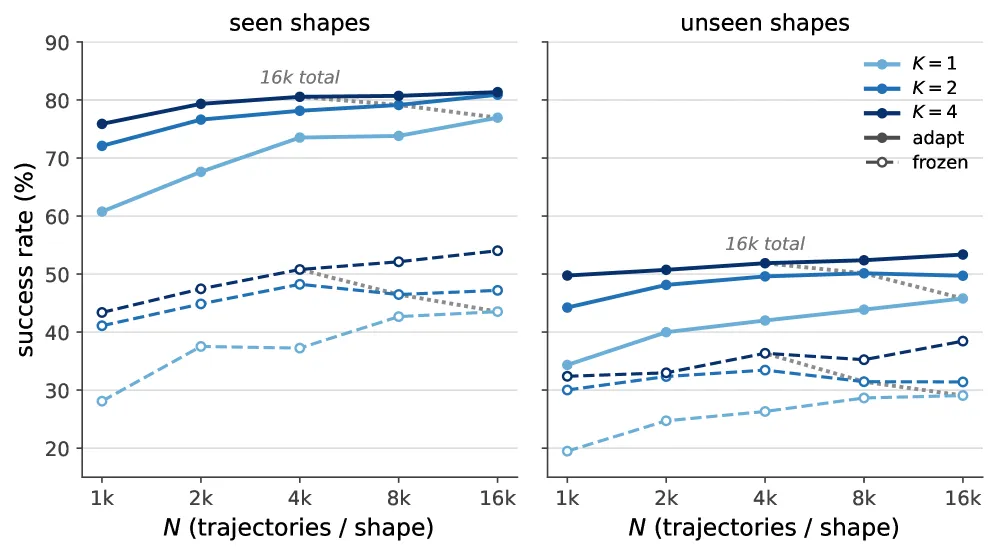
表:AdaJEPA 在不同实现上的表现(H200 GPU)
| 模型 | 维度 | 冻结(%) | AdaJEPA(%) | 延迟增加(s) |
|---|---|---|---|---|
| WM w/ TS (global) GD | 1×384 | 84.0±3.1 | 85.3±3.1 | +0.03 |
| WM w/ TS (global) CEM | 1×384 | 74.0±6.4 | 81.3±6.4 | +0.03 |
| WM w/ TS (spatial) GD | 196×384 | 91.3±4.2 | 92.0±3.5 | +0.01 |
| WM w/ TS (spatial) CEM | 196×384 | 89.3±3.1 | 93.3±2.3 | +0.02 |
| DINO-WM (patch) GD | 196×384 | 68.0±10.6 | 70.0±4.0 | +0.02 |
| DINO-WM (patch) CEM | 196×384 | 86.7±6.1 | 90.0±3.5 | +0.03 |
训练数据规模分析
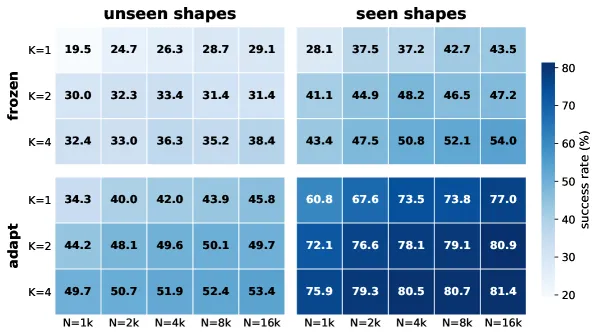
关键发现:
- 形状多样性(K)比每形状的轨迹数(N)更重要
- 相同 16k 轨迹预算下,K=4, N=4k 的未见形状成功率为 51.9%,而 K=1, N=16k 仅为 45.8%
- 低数据量下适应效果最显著:K=1, N=1k 时,AdaJEPA 从 28.1% 提升到 60.8%,超过冻结模型训练 16× 更多轨迹(43.5%)
适应层分析
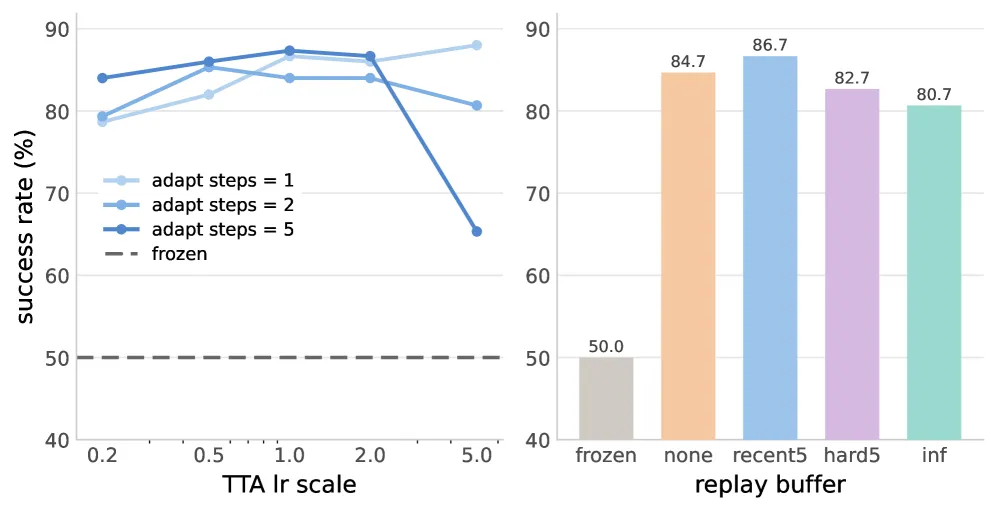
- 所有适应选择均优于冻结模型
- 形状偏移:大部分修正在预测器中
- 视觉/布局偏移:需要同时适应编码器和预测器
- 适应第一层预测器对布局偏移特别有效
- LoRA 也改善性能,但未持续优于直接层更新
六、相关工作
| 工作 | 关系 |
|---|---|
| DINO-WM | JEPA 世界模型,测试时冻结 |
| Temporal Straightening (wang2026temporal_straightening) | 直线化潜在轨迹促进规划,AdaJEPA 在其基础上做适应 |
| ViJEPA-2 | 视频 JEPA,测试时冻结 |
| AdaWM (wang2025adawm) | 需要目标域微调数据或额外在线 rollout |
| TTT/TTA 系列 | Tent, EATA, COTTA 等用于分类,AdaJEPA 首次用于潜在规划 |
| Parthasarathy et al. (2025) | 通过数据合成缩小 train-test gap,但仍冻结 |
七、总结
核心贡献
- AdaJEPA 框架:首次在 JEPA 世界模型的 MPC 闭环中执行测试时适应
- Plan-Act-Adapt-Replan 循环:每次重规划仅用1个梯度步,延迟增加仅 0.01-0.03s
- 跨分布偏移的一致改善:形状偏移、视觉偏移、动力学偏移、布局偏移均显著受益
- 数据稀缺时的补偿效应:1k 轨迹 + 适应 = 超越 16k 轨迹的冻结模型
- 模型无关性:对 DINO-WM、Temporal Straightening、全局/空间特征等均一致有效
技术影响
- 世界模型不应在训练后保持冻结,而应在部署中持续适应
- 测试时适应可以弥补训练数据覆盖的不足
- 适应目标的选择因环境而异,但性能对具体选择不敏感
局限性
- 适应效果受限于预训练表示的覆盖范围:当测试环境需要训练中未出现的特征时,适应可能无法完全弥合差距
- 当前适应是轻量级的(单步梯度更新),对于极端分布偏移可能需要更强适应
- 未结合持续学习(continual learning)或主动学习(active learning)来扩展世界模型的覆盖范围
八、参考资源
- arXiv: https://arxiv.org/abs/2606.32026
- 项目页面: https://agenticlearning.ai/adajepa
- DINO-WM: https://github.com/mengyek/Learning-World-Models-using-Vision-Language-Models-and-Offline-RL
- Temporal Straightening: wang2026temporal_straightening
- PushT: chi2024pusht
- PushObj: dinowm