Predict, Reuse, and Repair: Accelerating Dynamic Sparse Attention for Long-Context LLM Decoding
PRR 推理运行时,通过 EMA 预测器+增量修复内核将动态稀疏注意力的选择-注意力依赖瓶颈降低 30%+
Predict, Reuse, and Repair: Accelerating Dynamic Sparse Attention for Long-Context LLM Decoding
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Predict, Reuse, and Repair: Accelerating Dynamic Sparse Attention for Long-Context LLM Decoding |
| 作者 | Tianyu Wang (UPitt), Gourav Rattihalli (HPE Labs), Aditya Dhakal (HPE Labs), Junbo Li (UPitt), Zhiwei Ren (UPitt), Dejan Milojicic (HPE Labs), Longfei Shangguan (UPitt) |
| 机构 | University of Pittsburgh, HPE Labs |
| 论文 | arXiv:2606.30389 |
| 代码 | https://github.com/Tianyu9748/Incremental_FlashAttention |
| 发布 | 2026-06-30 |
核心贡献:
- 识别选择-注意力依赖瓶颈:DSA 的 top-K 选择阶段占解码关键路径高达 41%,且随上下文长度增长至 71%
- PRR(Predict, Reuse, Repair)推理运行时:预测可能选中的块,在 selection 飞行中并行执行推测注意力,selection 完成后增量修复遗漏的块
- EMA 轻量级预测器:训练无关,直接利用 DSA 的压缩注意力分数,每提示在线校准(仅增加 0.06ms 关键路径延迟)
- 基于 FlashAttention 的增量修复内核:支持在线 softmax 重加权,将修复工作量从 |A| 降至 |A\P|
- 动态推测预算选择:离线 profiling 查找表,运行时根据上下文长度自动选择最优 δ,确保推测工作不扩展关键路径
- 跨 6 个 LLM × 5 个基准的全面评估:PRR 平均加速 1.42× (Quest) / 1.56× (InfLLM-v2),精度无损
二、研究背景与动机
问题:DSA 的关键路径瓶颈
动态稀疏注意力(DSA)在长上下文 LLM 解码中通过选择 top-K KV 块减少注意力计算,但引入了新的瓶颈:
Figure 1: 标准 DSA vs PRR
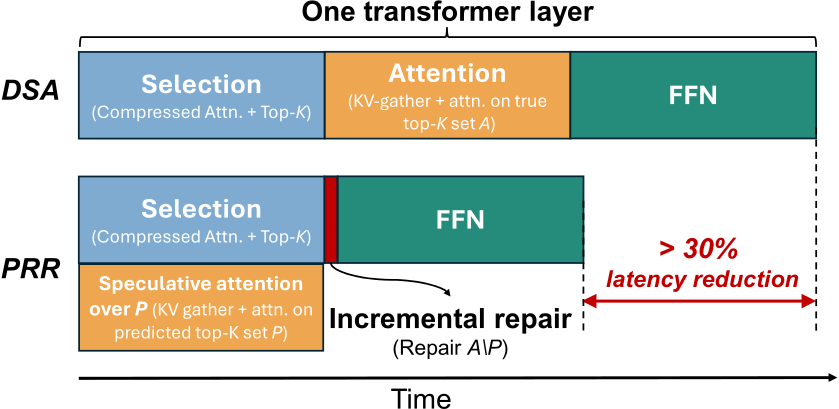
标准 DSA 中,每个解码步骤(一个 transformer layer)包含三个阶段:
- Selection:压缩注意力 + 选择 top-K KV 块
- Attention:对选中块执行精确 attention
- FFN:前馈网络
Selection 和 Attention 严格串行——block 身份在 selection 完成前未知。随上下文长度增长,selection 占比持续上升:16K tokens 占 ~60%,512K 占 ~71%。
观察一:时序局部性
Figure 3: 连续选择之间的块重叠率
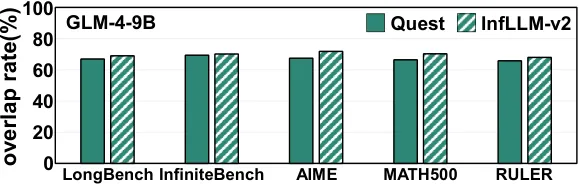
Across five benchmarks (LongBench, InfiniteBench, RULER, AIME, MATH500),Quest 和 InfLLM-v2 在相邻解码步之间始终重复选择 >65% 的块(平均约 68%)。
观察二:GPU 资源空闲
Figure 4: GPU 利用率分析
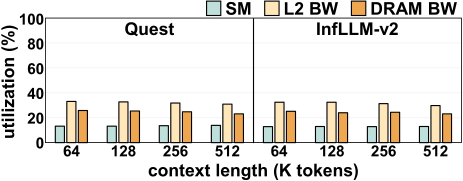
即使 512K 上下文,SM 利用率 <40%,L2/DRAM 带宽利用率也远低于饱和。说明 GPU 有大量空闲资源可用于推测计算。
三大挑战
- 提升预测精度:简单复用上一帧 top-K 的命中率不够(~68%),需要更精确的预测器
- 容忍推测错误:现有引擎(vLLM, SGLang)和内核(FlashAttention)不支持将遗漏块增量合并到部分注意力结果
- 预算控制:推测集合过大会使推测注意力本身成为关键路径瓶颈
三、方法设计(PRR)
3.1 EMA 轻量级预测器(Section 4.1)
对每个块 i,维护两个状态变量:平滑水平 和趋势估计 。
预测(step t 开始,selection 之前):
其中 控制外推激进程度。
更新(selection 后获得真实分数 IS_i^t):
控制平滑水平响应速度, 控制趋势估计适应性。
为什么不用神经网络? 神经预测器虽精度高,但会引入额外模型执行开销和内存流量,抵消推测节省的延迟。EMA 直接利用 DSA 已产生的压缩注意力分数,无需额外计算。
3.2 在线预测器校准(Section 4.2)
Figure 6: EMA 校准流程
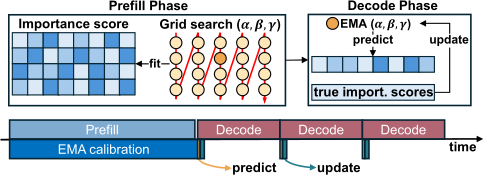
EMA 超参数 影响预测精度,固定值无法适应不同 prompt 的特性。PRR 利用 prefill 阶段的重要性分数轨迹进行在线校准:
校准目标(score-weighted hit rate):
搜索空间: (step 0.2), (step 0.1), (step 0.25),共 80 个候选。搜索与 prefill 阶段并行执行,关键路径仅需增加 0.06ms。
3.3 增量修复内核(Section 4.3)
核心创新:基于 FlashAttention 的在线 softmax 递推,实现增量注意力修复。
Instrumented speculative kernel:修改 FlashAttention forward,额外写入分母 和运行最大值 到 HBM。修改微小(每 head 仅需存储两个标量),保留原始内存访问模式和 occupancy。
Repair kernel:给定 和遗漏块 M 的 KV,对每个遗漏块应用一次递推:
每个 query 独立处理,遗漏块以 FlashAttention 相同的 tiled 方式流过 on-chip 内存。FLOPs 和内存流量均仅与 |M| 成正比,而非 |A|。
3.4 动态推测预算(Section 4.4)
Figure 5: 推测预算比例 δ 的影响
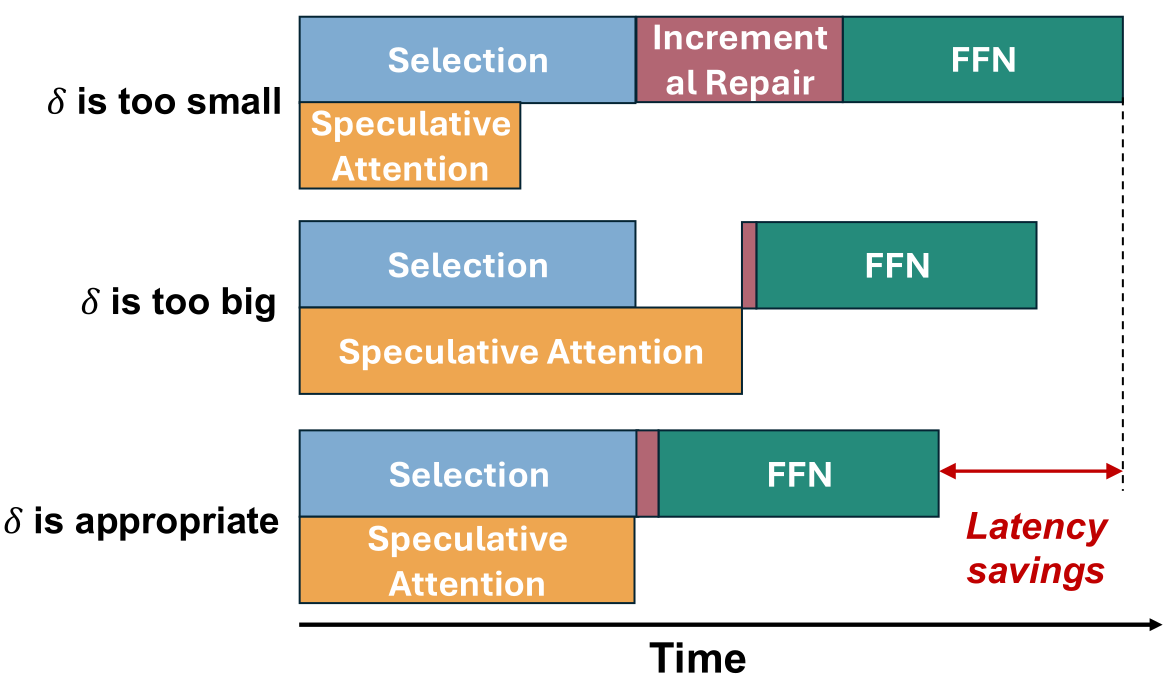
PRR 使用离线 profiled 查找表,按上下文长度索引选择最大安全的 δ,确保推测注意力不超出 selection 窗口。Profile 过程:< 5 分钟(单 H100),对 4K/8K/16K/32K/64K 五个上下文长度。
四、核心实验结果
实验设置
| 配置项 | 值 |
|---|---|
| GPU | NVIDIA H100 |
| DSA 后端 | FlashInfer BlockSparseAttention |
| 基础模型 | GLM-4-9B (主实验), 扩展至 GLM-Z1-9B, DeepSeek-R1-8B, Llama3-8B-1M, Qwen3-14B, Qwen3-32B |
| DSA 方法 | Quest, InfLLM-v2 |
| 上下文长度 | 16K–512K |
| Batch size | 1 |
| 基准 | LongBench, InfiniteBench, RULER, AIME, MATH500 |
关键结果
| 指标 | 结果 |
|---|---|
| 平均解码加速 | 1.42× (Quest), 1.56× (InfLLM-v2) |
| 最大加速 | 40% 延迟降低 |
| EMA 命中率 | >97%(跨 6 LLM × 5 基准) |
| 精度保持 | 与标准 DSA 完全一致(零精度损失) |
| 校准开销 | 0.06ms 关键路径延迟 |
| Profile 开销 | <5 分钟(单 H100) |
| 选择-注意力依赖占比 | 41% (16K) → 71% (512K) |
Ablation(Table 8)
| Stage | 组件 | Quest 平均 | InfLLM-v2 平均 |
|---|---|---|---|
| S1 (reuse only) | 复用上一帧 top-K | 1.00–1.04× | 1.00–1.04× |
| S2 (+repair kernel) | S1 + 增量修复内核 | 1.20× | 1.20–1.32× |
| S3 (+EMA predictor) | S2 + EMA 预测器 (PRR) | 1.28–1.42× | 1.32–1.56× |
Stage 1 收益甚微(~1.00–1.04×),因为 70% 重叠率下单次遗漏即触发全量重算。Stage 2 的修复内核带来显著改善(~1.20×)。Stage 3 的 EMA 预测器将命中率提升至 >97%,最终达到最大加速。
EMA 命中率(Table 7)
| 模型 | LongBench | InfiniteBench | RULER | AIME | MATH500 | 平均 |
|---|---|---|---|---|---|---|
| GLM-4 (Quest) | 98.65% | 96.86% | 98.36% | 98.15% | 98.25% | 98.05% |
| GLM-Z1 (InfLLM-v2) | 99.12% | 98.89% | 98.56% | 98.42% | 98.49% | 98.70% |
| DeepSeek-R1 (InfLLM-v2) | 99.03% | 99.01% | 98.27% | 99.40% | 98.57% | 98.86% |
| … | … | … | … | … | … | … |
所有模型-基准组合的 EMA 命中率均 >96%,平均 >98%。
五、核心创新
| 创新点 | 说明 |
|---|---|
| PRR 推理运行时 | 首次实现选择-注意力并行的推测-修复模式,打破 DSA 的关键路径依赖 |
| EMA 预测器 | 训练无关、零额外计算开销,利用已有 DSA 分数 |
| 在线校准 | prefill 阶段 grid search 校准超参数,prompt-adaptive |
| 增量修复内核 | 基于 FlashAttention 在线 softmax 递推,修复开销仅与遗漏块数成正比 |
| 动态推测预算 | 离线 profile + 在线查找表,自动匹配 selection 窗口 |
| Quest GQA 扩展 | 在 KV-head 粒度上操作,生成代表性查询 Q̄,解决 GQA 下多 query head 共享同一 KV head 的难题 |
六、相关工作总结
| 方法 | 论文 | 与 PRR 的关系 |
|---|---|---|
| H2O | NeurIPS 2023 | KV cache eviction,无推测注意力 |
| Quest | ICML 2024 | DSA 基线,PRR 在其上叠加 |
| InfLLM-v2 | arXiv 2025 | DSA 基线,PRR 在其上叠加 |
| FlexiCache | MLSys 2026 | 利用 attention head 时序稳定性,方法不同 |
| FlashAttention | NeurIPS 2024 | PRR 的修复内核基于此 |
| FlashInfer | arXiv 2025 | DSA 稀疏注意力后端 |
七、局限性
- Batch size = 1:当前仅评估 batch size 1,多请求批处理的 stage 协同(selection/speculation 间调度)是未来方向
- EMA 预测器局限:对频繁突变的选择模式(如极端注意力 sink 转移)预测精度可能下降
- 单次 profile 绑定:每个模型-硬件-DSA 配置需离线 profile,不同硬件间不能直接迁移
- 仅评估 GQA 扩展的 Quest:其他 DSA 方法(如 SnapKV 变体)未测试
- 512K 以下未充分覆盖:profile 仅覆盖 4K–64K,更大上下文的外推依赖多项式回归
八、实用建议
- 适用场景:任何使用 DSA(Quest, InfLLM-v2 等)的长上下文 LLM 推理服务,特别是批量 size 小的场景
- 部署步骤:(1) 离线 profile selection/attention 延迟(<5min/H100)→ (2) 部署增量修复 CUDA 内核 → (3) PRR 运行时接管 DSA pipeline
- 集成路径:可扩展至 vLLM/SGLang/FlexAttention,需实现 online-softmax 递推接口
- 性能预期:Quest + PRR ≈ 1.4× 加速,InfLLM-v2 + PRR ≈ 1.56× 加速,无精度损失
- GPU 要求:需要支持 FlashAttention 的 GPU(A100/H100/B100 等)
九、参考资源
- arXiv: 2606.30389
- 代码: https://github.com/Tianyu9748/Incremental_FlashAttention
- 相关论文: Quest (2402.17152), InfLLM-v2 (2509.24663), FlexiCache (2601.02780), FlashAttention (2307.08691), FlashInfer (2501.01005), H2O (2306.01186)
- 基础模型: GLM-4-9B, GLM-Z1-9B, DeepSeek-R1-8B, Llama3-8B-1M, Qwen3-14B, Qwen3-32B
附图索引
| 编号 | 文件名 | 说明 |
|---|---|---|
| Figure 1 | figures/prr-dsa/figure-01-teaser.svg | PRR 总览:推测-复用-修复三段式流水线 |
| Figure 2 | figures/prr-dsa/figure-02-latency-breakdown.svg | DSA 三阶段及延迟分解(16K–512K) |
| Figure 3 | figures/prr-dsa/figure-03-hit-rate.png | 连续选择间的块重叠率(5 个基准) |
| Figure 4 | figures/prr-dsa/figure-04-utilization.svg | SM/L2/DRAM 利用率分析 |
| Figure 5 | figures/prr-dsa/figure-05-choose-alpha1.svg | 推测预算 δ 对执行时间线的影响 |
| Figure 6 | figures/prr-dsa/figure-06-ema-calibration.svg | PRR EMA 在线校准流程 |