DiLaServe: High SLO Attainment Serving for Diffusion Language Models
首个面向扩散语言模型(DLM)的集群级服务系统。DLM 每步并行解掩多个 token,比自回归模型吞吐高 1.75×,但引入置信度阈值这一「速度-质量」旋钮与 TP 度「时延-吞吐」权衡。DiLaServe 以「去噪步」为调度粒度,用 SLO 感知阈值调整 + 自适应负载控制动态选阈、轻量梯度提升 Step Predictor 在线预测剩余步数、按最低步时延调度并支持步级迁移、两阶段 ILP 定期重构集群 TP 配置,并把近似 KV 缓存的 cache/recompute 步异构成本纳入调度。基于 vLLM+Ray 实现(9500 行),真实 trace 上 SLO 达成率 +30.2pp、时延 -46%、质量仅降 0.09;多基准最高 +56.6pp SLO、精度仅降 0.9%
DiLaServe: High SLO Attainment Serving for Diffusion Language Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | DiLaServe: High SLO Attainment Serving for Diffusion Language Models |
| 作者 | Tzu-Tao Chang, Benjamin Yuanyang Hong, Kiet Pham, Shivaram Venkataraman |
| 论文 | arXiv:2606.29094(v1,2026-06-27) |
| 发布 | 2026 年 6 月 27 日 |
| 领域 | cs.LG |
| 性质 | 系统 + 算法(集群级推理服务系统,非新模型) |
| 实现 | 基于 vLLM + Ray,约 9,500 行 Python 扩展代码 |
| 测试硬件 | 16-GPU 集群(NVIDIA GH200 / H100,96GB HBM3) |
| 测试模型 | LLaDA-8B、Dream-7B(两个最大开源 DLM) |
二、核心思想
问题定义
自回归 LLM 的吞吐受逐 token 串行生成的根本约束。扩散语言模型(Diffusion Language Models, DLMs)提供另一范式:从全 [MASK] 序列出发,反复执行去噪步(denoising step),每步用全双向注意力并行预测所有掩码位置,只解掩置信度超过阈值的 token,其余重新掩码,迭代至无掩码为止。因单步可并行解掩多个 token,DLM 吞吐显著更高——工业报告称 10×,本文实测开源 DLM 在同等或更好精度下达 1.75×(图 1)。
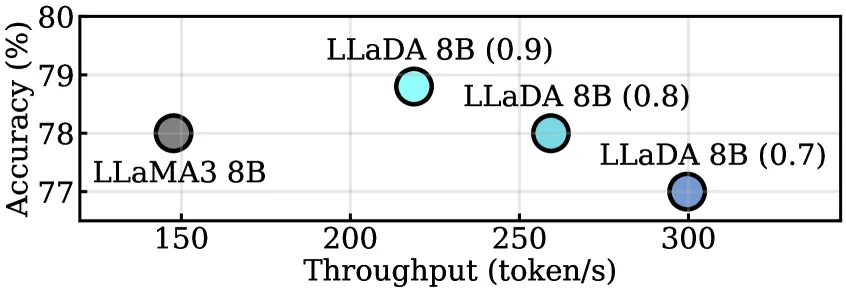
图 1:LLaMA(自回归)与 LLaDA(扩散)在 GSM8K 上单 H100 的精度-吞吐对比,括号内为去噪置信度阈值。DLM 在同等/更优精度下吞吐高 1.75×。
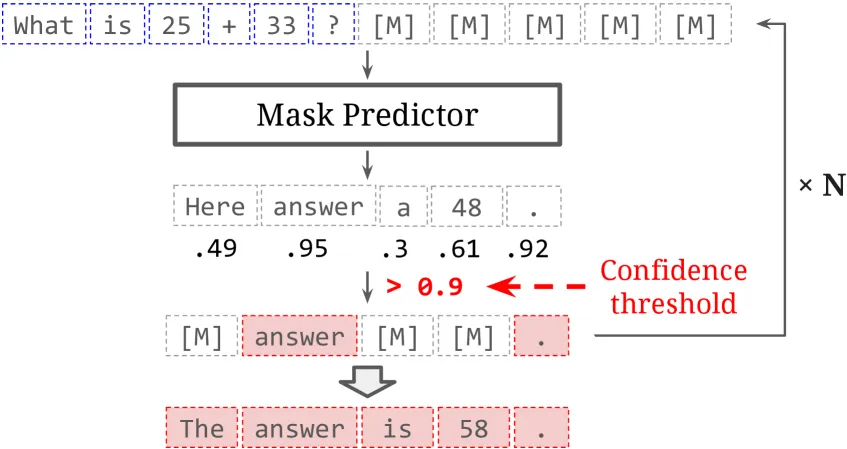
图 2:扩散语言模型去噪过程——prompt 拼接 [MASK],mask predictor 一次前向并行预测全部掩码位,按置信度阈值选择性解掩。若阈值设为 0.6,「25+33=?」可能错误解掩「48」。
但要在满足时延 SLO 的同时兑现 DLM 吞吐收益,需应对三重挑战(§2.2)——这构成本文动机。
解决方案概述
DiLaServe(Diffusion Language Model Serving)是首个面向 DLM 的集群级服务系统,以去噪步为调度粒度实现细粒度负载均衡与截止期感知自适应。核心机制:
- 动态置信度阈值:对每个请求选出满足剩余 SLO 预算的最高阈值以最大化质量,并施加自适应负载控制限制各请求的最高阈值,使聚合负载不超集群容量;
- Step Predictor:离线训练的轻量梯度提升模型,用解掩进度 + token 置信度特征在线预测各阈值下的剩余去噪步数;
- 调度器:把每一步分派到步时延最低的实例(高 TP 度 / 低负载),支持步级迁移;
- 两阶段 ILP 重构:定期(如每 5 分钟)求解,Stage 1 定各 TP 度实例数以保证稳态容量并最大化平均阈值,Stage 2 求最小迁移开销的过渡方案;
- 支持近似 KV 缓存:将 cache / recompute 步的异构计算成本直接纳入调度与重构。
三、背景与挑战(§2)
3.1 扩散语言模型(§2.1)
DLM 用基于 Transformer 的 mask predictor + 全双向注意力,能同时依赖左右上下文推断掩码 token,在反转推理任务上更强。解掩策略普遍基于 token 置信度:以 softmax 概率为置信分,每步只解掩超过预设阈值者;若无 token 超阈,则解掩置信度最高者以保证进度。多 token 并行解掩即吞吐优势来源。
3.2 三重挑战与机会(§2.2)
① 速度-质量权衡(§2.2.1):高阈值→只解掩很确信的 token,正确率高但每步解掩少、总步数多;低阈值→每步解掩多、步数少但易错。图 3(a) 显示 LLaDA 在 GSM8K 上,阈值从 0.9 降到 0.7 使步数减少 38%,即系统可多处理 1.61× 请求而精度仅降 1.5%。阈值无需全程固定,可按步粒度控制(图 3b:默认 0.9,随机一部分步切到 0.6)。此旋钮创造两类机会:请求级截止期自适应(预测将超 SLO 时临时降阈减步,有余量再回升)与系统级负载感知控制(过载时降阈稳定队列、防尾时延级联)。
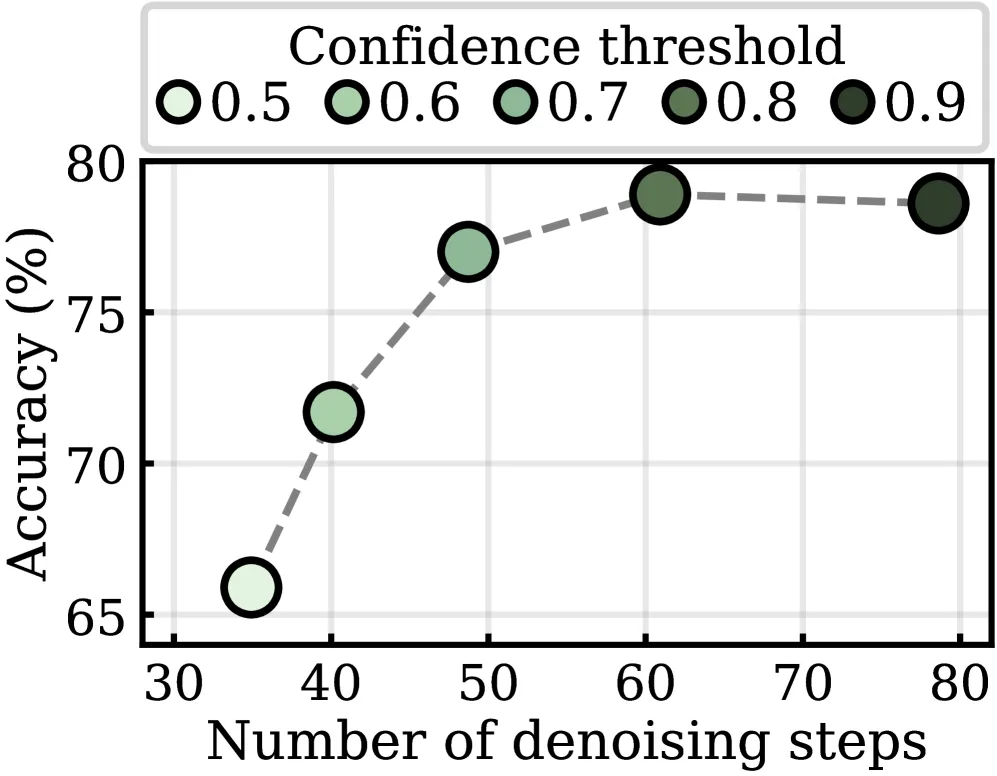
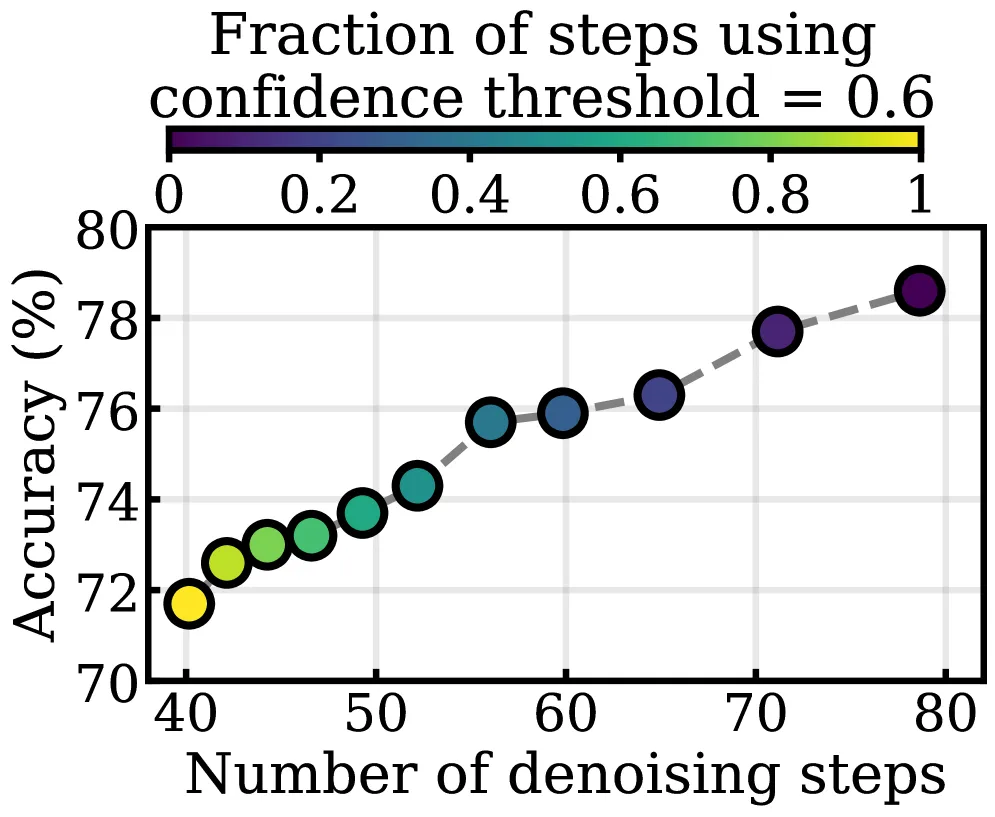
图 3:LLaDA 在 GSM8K 上的精度-速度权衡。(a) 固定阈值:每点为全程单一阈值;(b) 动态阈值:默认 0.9,随机一部分步切到 0.6,低阈占比越高精度与步数同步下降。
② 集群级服务的 TP 权衡(§2.2.2):全双向注意力使每步计算密集,DLM 极受益于张量并行——图 4(a) 显示 2 GPU 降单步时延 25%、4 GPU 降 55%。但固定集群规模下 TP 度带来时延-吞吐权衡:图 4(b) 对比「少量高 TP 实例」vs「大量低 TP 实例」——低负载下高 TP 配置降时延达 43%;高负载下其 worker 数受限、队列暴涨、排队时延主导,低 TP 配置因吞吐高而稳定。真实 trace 到达率与组成剧烈波动,单一静态配置不够。叠加阈值旋钮后需联合决策阈值控制 + TP 分配 + 负载条件。
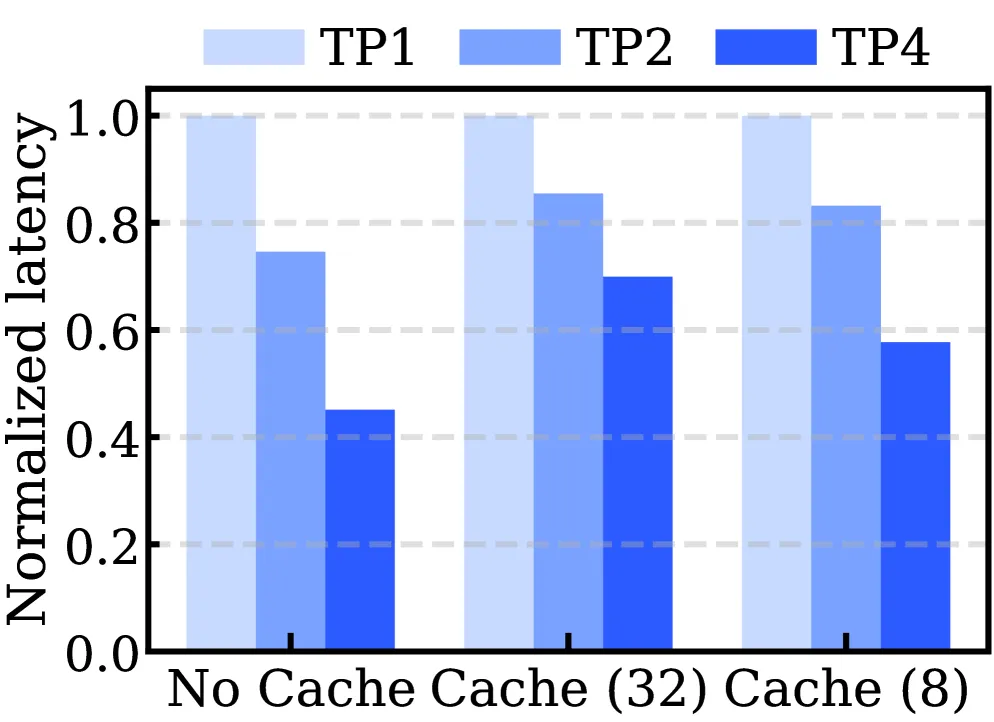
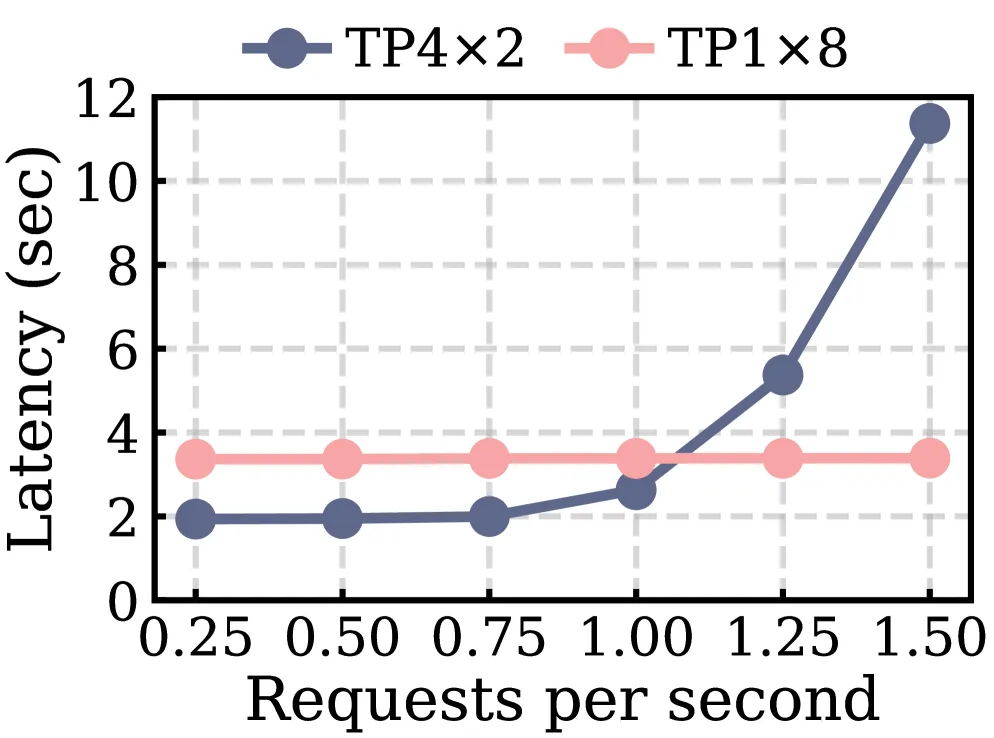
图 4:DLM 的张量并行。(a) 不同 TP 度下的时延(括号为去噪块大小);(b) 2 个 TP-4 实例 vs 8 个 TP-1 实例随 RPS 的时延——高 TP 低负载优、低 TP 高负载稳。
③ 支持近似缓存(§2.2.3):自回归的 KV 缓存精确可复用;DLM 因全双向注意力,前缀 KV 随去噪演变,现有工作用近似 KV 缓存跨步复用 KV 但需定期刷新避免陈旧,导致去噪步计算成本非均匀(cache 步轻、recompute 步重),服务系统须建模这一异构性。
四、系统架构(§3)
4.1 设计总览(§3.1)
管理员指定:请求时延 SLO、支持的 TP 度集合、初始集群配置、候选置信度阈值集(如 [0.5,0.6,0.7,0.8,0.9])。系统一次性 profiling 测出每个 TP 度、每种 batch 大小的单步时延。核心组件(图 5):
- Confidence Threshold Controller:为每请求选满足剩余 SLO 的最高阈值,并做跨请求自适应负载控制;
- Step Predictor:离线训练的轻量模型,据当前状态预测剩余去噪步数;
- Scheduler:把每步分派到步时延最低实例,必要时迁移请求;
- Workload Monitor + Reconfigurator:监控到达与输入输出长度分布,定期用两阶段 ILP 重算集群配置。
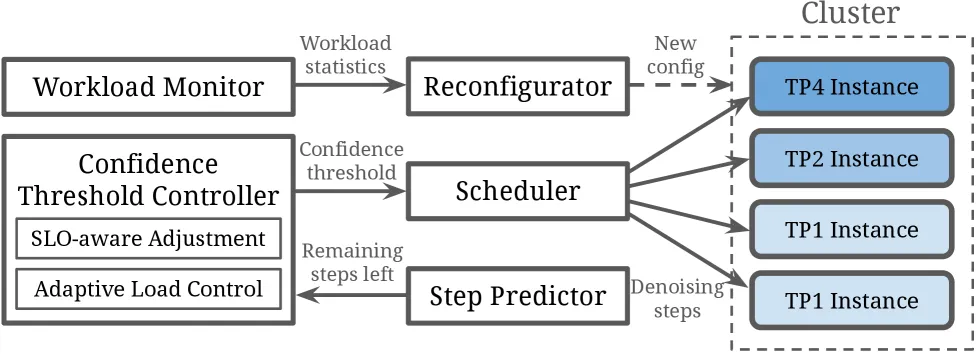
图 5:DiLaServe 架构——阈值控制器(SLO 感知选阈 + 负载控制)、Step Predictor、按步时延调度的 Scheduler、Workload Monitor 与两阶段 ILP Reconfigurator。
4.2 动态阈值调整与调度(§3.2)
① SLO 感知阈值调整(Algorithm 1):估计剩余时延 = 预测剩余步数 × 单步时延(据 TP 度与 batch 查 profile),选剩余时延不超剩余 SLO 预算的最高阈值。高负载下相比固定阈值提升 SLO 达成率最高 70.8pp。
② 自适应负载控制(Algorithm 2):若每请求各自选最高可行阈值,聚合负载可能超容量致全系统违约(最高降 SLO 42.4pp)。请求负载 = 总 token 数 ×预测剩余步数;实例容量 = 每秒可处理 token 数 × SLO 时长。算法按到达序遍历请求,对每个请求降序尝试阈值,最坏情况聚合负载 =(已提交负载)+(当前请求该阈值负载)+(剩余请求全用最低阈值的保守估计);超容量则从该请求允许集中移除此阈值,否则保留。由此给每请求最宽可行阈值区间。
③ Step Prediction(§3.2.3):一次性估计误差可达 75%,致选阈次优、SLO 降最多 15pp。改为在线更新:用进度特征(已解掩 token 比例,降误差 34.9%)+ 置信度特征(输出 token 置信分位数,再降 15.8%)。用 11 个标量特征(阈值、输出长度、full/block 进度、min/q25/median/avg/q75 置信度)离线训练 梯度提升机(GBM),仅需 100 条请求的训练集,每模型一次性完成。相比一次性估计提升 SLO 最多 11pp、精度 1.1%。逐 token 更新有 20% 开销,故选误差在逐 token 基线 5% 内的最大更新粒度,并用异步线程 + 跨请求/跨阈值批处理摊薄成本(图 7)。
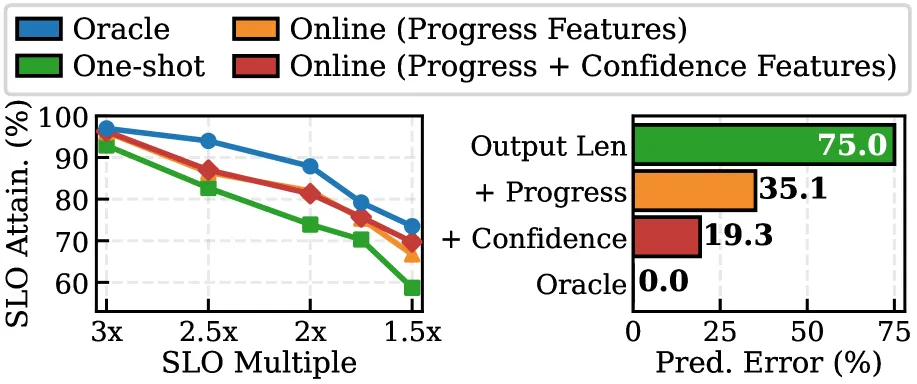
图 6:LLaDA 在 GSM8K 上不同步预测策略的服务性能(左)与预测误差(右)。在线进度 + 置信度特征大幅降误差。
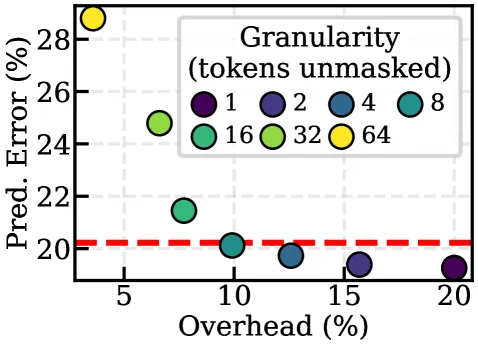
图 7:不同预测粒度下的预测误差与执行开销。红虚线为相对逐 token 粒度 5% 相对误差上界;粗粒度更新在小误差代价下大幅降开销。
④ 请求调度(Algorithm 3):调度事件(新请求到达 / 实例完成一步)触发;FindBestInstance 在能容纳的实例中选 latencyProfile 最低者(偏好高 TP / 轻负载)。无 KV 缓存时去噪步本质无状态,迁移极轻量——只需传 prompt + 当前掩码/解掩 token(长序列也仅数十 KB),支持步级迁移与细粒度负载均衡(§E 显示降尾时延最多 19%)。迁移后按新实例 TP/负载更新阈值。
4.3 集群重构(§3.3,两阶段 ILP)
Workload Monitor 按输入-输出规模将请求分类并跟踪各类到达率。Reconfigurator 定期(如每 5 分钟,远粗于 Scheduler)求解:
- Stage 1 质量感知容量规划:分层目标——主目标最大化每输出 token 的平均置信度阈值(即最大化质量),次目标(同分时)最大化 SLO 余量。约束含 token 解掩完整性、步分配一致性、SLO 满足、batch 选择、节点 GPU 容量、系统稳定性(各 TP 度负载不超其处理容量,据排队论保证队列有界)。不可行时回退全 TP-1(最大吞吐);
- Stage 2 最小开销重构规划:因同构集群节点可互换,只关心各 TP 度实例总数 ;目标最大化可保留实例数(同节点同 GPU 继续运行),减少终止/启动、限制过渡期容量下降。用 slot 抽象建模(节点 上 TP- 最多 个 slot)。
实用考量:仅当 Stage 1 提案较当前配置改进足够(如主/次目标 ≥10%)才触发重构;RPS 加安全缓冲以抗短期波动。
4.4 支持近似 KV 缓存(§3.4)
近似 KV 缓存把去噪步分为 cache 步(复用 KV,只算当前缓存块内 token,轻)与 recompute 步(重算全序列 KV,重)。DiLaServe 的适配:
- 负载/容量/剩余时延估计:分别对 cache 与 recompute 步计算并求和(详见 §C);
- 迁移粒度:cache 步迁移需在目标实例重建 KV(等于多一次 recompute),故只允许在 recompute 步迁移——此时本就要重建 KV,迁移零额外成本(§E 表 6:降时延最多 38%);
- 重构:Stage 1 用 recompute 步 、cache 步 与各自 batch 选择 ;系统稳定性约束改为分别计入 recompute 步成本 与 cache 步成本 。
4.5 扩展(§3.5)
- 非同构 SLO:容量估计用平均/最小 SLO,Stage 1 各类携带自身 SLO;选阈与调度本就按请求剩余 SLO 预算工作,天然支持;
- 请求优先级:在负载控制中按优先级排序请求,高优先请求先处理以获最宽阈值区间,极端情况保证其始终可用全阈值范围。
4.6 实现(§4)
基于 vLLM,约 9,500 行 Python。模型实例为 Ray actor,Scheduler 以 Ray task 下发去噪步命令(含 prompt、输出长度、上步解掩 token、所选阈值)。Scheduler 跑异步事件循环;Reconfigurator 用 Gurobi 求解 ILP。近似 KV 缓存下 FlashAttention 配置为全双向注意力(无因果掩码),KV 存 GPU 显存、recompute 步按需重建。
五、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| 首个 DLM 集群级服务系统 | 以去噪步为调度粒度,联合优化阈值 / TP 度 / 负载 | §3 |
| SLO 感知动态阈值 + 自适应负载控制 | 请求级选最高可行阈值,系统级限阈防聚合过载 | §3.2.1-2;Algo 1/2 |
| 轻量 Step Predictor | 11 特征 GBM,在线进度+置信度特征,100 条训练集 | §3.2.3;Fig 6/7 |
| 步级无状态迁移 | 无 KV 时迁移仅传数十 KB,细粒度负载均衡 | §3.2.4;降尾时延 19% |
| 两阶段 ILP 重构 | Stage 1 质量感知容量规划 + Stage 2 最小迁移开销 | §3.3 |
| 近似 KV 缓存异构建模 | cache/recompute 步分离估计,仅 recompute 步迁移 | §3.4;降时延 38% |
六、实验结果(§5)
6.1 评测设置(§5.1)
- 硬件:Cluster 1(GH200,每节点 4×H100 96GB + Grace CPU,200Gbps)用于 §5.2/5.4;Cluster 2(4×H100 96GB,100Gbps)用于 §5.3;均 16 GPU;
- 模型:LLaDA-8B、Dream-7B;默认近似 KV 缓存去噪块 32 token、默认阈值 0.9;
- 真实 trace:ShareGPT(对话 prompt/输出,表 2:prompt 均值 140、输出均值 264)+ BurstGPT(到达时间戳),合成 2 小时 trace 共 63,736 请求,峰值 RPS 20 缩放到集群容量;对话质量用 Llama-3.3-70B-Instruct 做 LLM-judge(0-10 分);
- 基准(表 3):GSM8K(数学,1319)、MMLU-Pro(通用,12032)、MBPP(编码,474);输出长度 256;默认 SLO = TP-1 单请求隔离时延的 5×;
- 基线:INFaaS(多实例 ML 服务,按 token 数派发到最轻负载 worker)与 Llumnix(自回归 LLM 多实例服务,迭代级迁移负载均衡)——均用固定置信度阈值,均适配为 DLM。
6.2 真实负载(§5.2)
16-GPU 集群服务 LLaDA。相比 INFaaS / Llumnix:SLO 达成率 +21.1pp / +30.2pp,时延 -34.7% / -46.0%,质量分仅降 0.09。DiLaServe 随负载自适应:低负载选高 TP 实例降时延(-16.6% / -30.0%),高负载转向更多低 TP 实例提吞吐、同时降最高阈值控制有效负载(高负载期时延 -32.2% / -44.0%)。
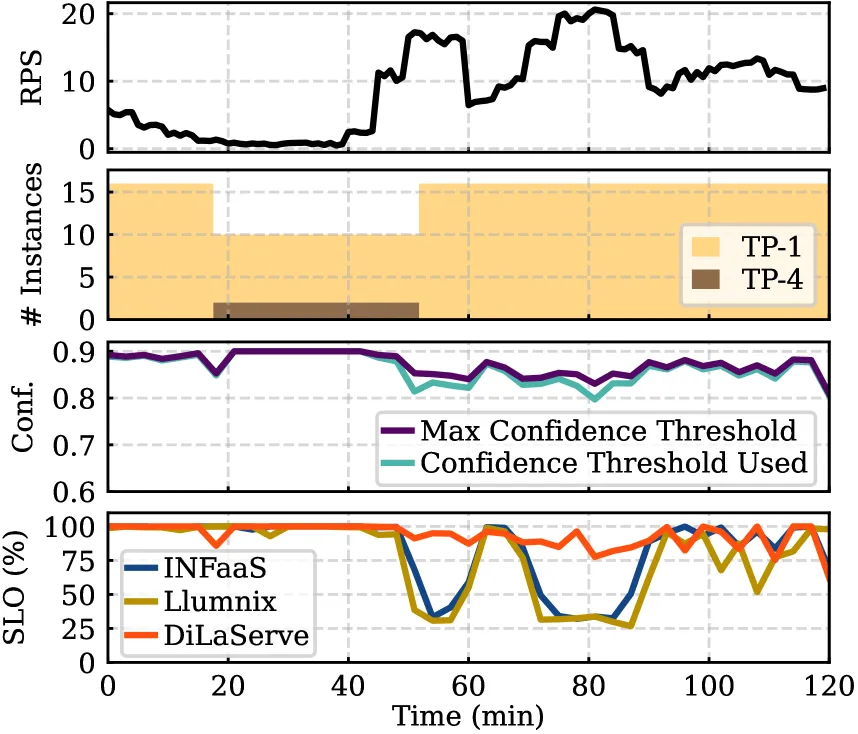
图 8:真实 trace 的 RPS、DiLaServe 的集群配置与置信度阈值、三系统随时间的 SLO 达成率。DiLaServe 随负载动态重构 TP 配置并调阈。
6.3 精度基准(§5.3)
服务 LLaDA 与 Dream,三系统均固定 16 TP-1、无重构,纯比调度效果。高请求率下 DiLaServe 相比 INFaaS +55pp SLO(精度仅降 0.7%)、相比 Llumnix +56.6pp SLO(精度仅降 0.9%)。收紧 SLO 时,中等紧(≥3×)区间相比 INFaaS/Llumnix 分别 +33.9pp / +42.3pp(精度均仅降 0.1%);极紧 SLO 下可进一步以质量换时延维持高达成率。
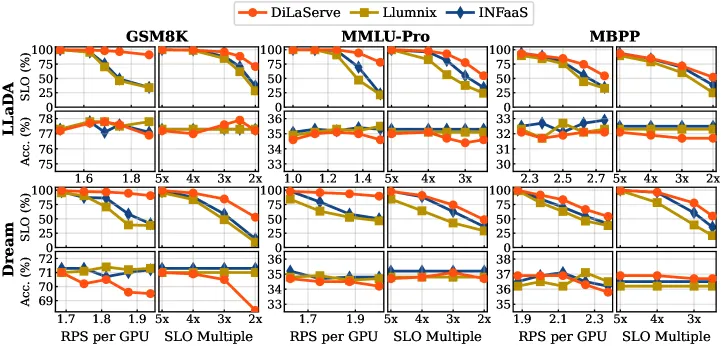
图 9:LLaDA 与 Dream 在 GSM8K / MMLU-Pro / MBPP 上随请求率的 SLO 达成率与精度。DiLaServe 通过动态阈值一致取得更优速度-质量权衡。
6.4 消融研究(§5.4)
阈值控制(图 10,LLaDA/GSM8K):相比固定阈值,SLO 感知动态调整(§3.2.1)提升 SLO 达成率最高 70.8pp(精度最多降 1.9%);再加聚合负载感知控制(§3.2.2)额外 +42.4pp(精度变动 ≤1.7%)。
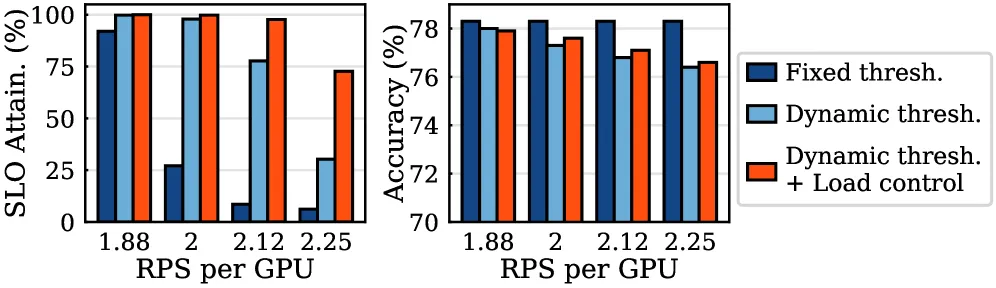
图 10:LLaDA/GSM8K 上的置信度阈值控制消融——动态调整 + 系统级负载控制逐层提升 SLO 达成率。
重构(图 11):不同峰值 RPS 下 Reconfigurator 定期据统计重算配置——低负载偏好少量高 TP 实例降时延,峰值 RPS 升高转向更多低 TP 实例提吞吐,且随 trace 时序波动动态变化。
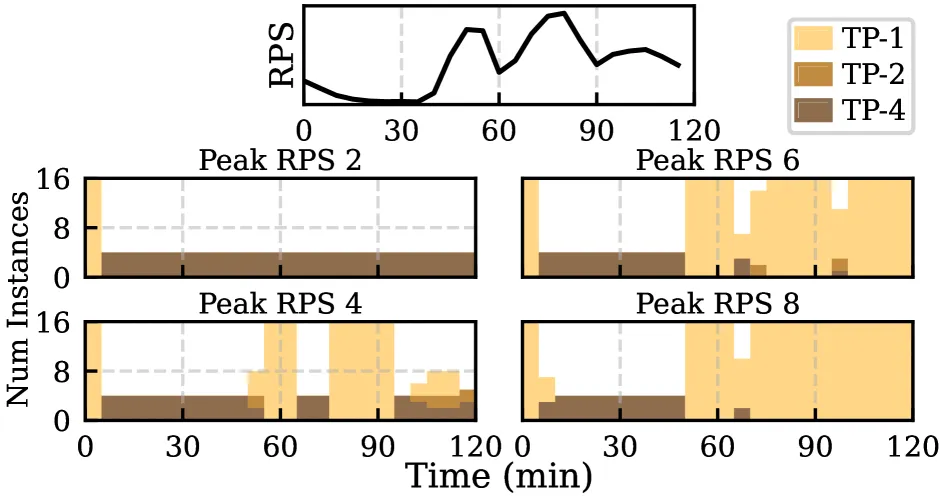
图 11:不同峰值 RPS 下随时间推导的集群配置——随负载水平与时序波动自适应 TP 组成。
输入/输出长度(图 12):跨输入长度(few-shot 数)SLO 达成率相比 INFaaS 提升最高 81.0pp(精度降 ≤1.0%);跨输出长度最高 82.3pp(精度降 ≤0.8%)。
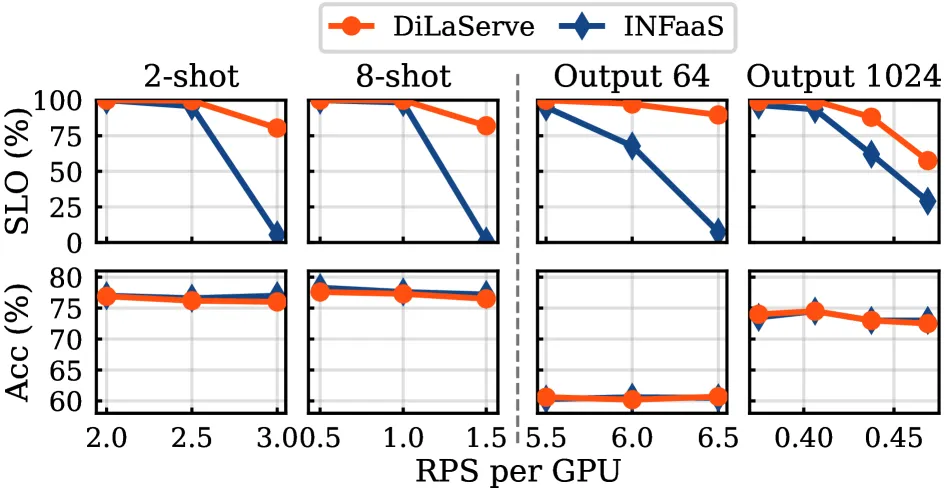
图 12:输入/输出长度消融。左二列变输入长度(输出固定 256);右二列变输出长度(few-shot 固定 5)。DiLaServe 在各规模下均超固定阈值基线。
迁移与无缓存(附录 E/F):步级迁移降尾时延最多 19%、仅 recompute 步迁移降时延最多 38%;无 KV 缓存场景下亦保持优势。
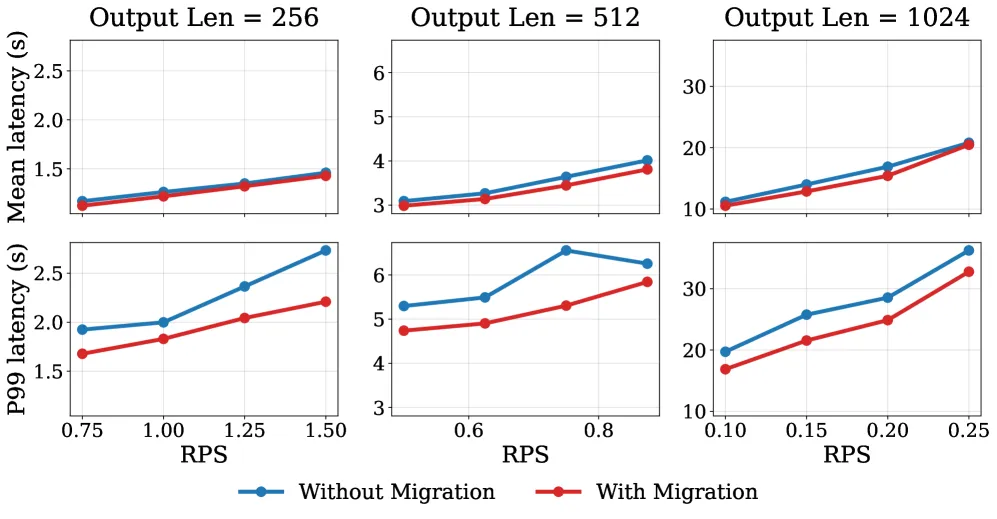
图 13(附录 E):迁移粒度有效性——步级/仅 recompute 步迁移对尾时延的影响。
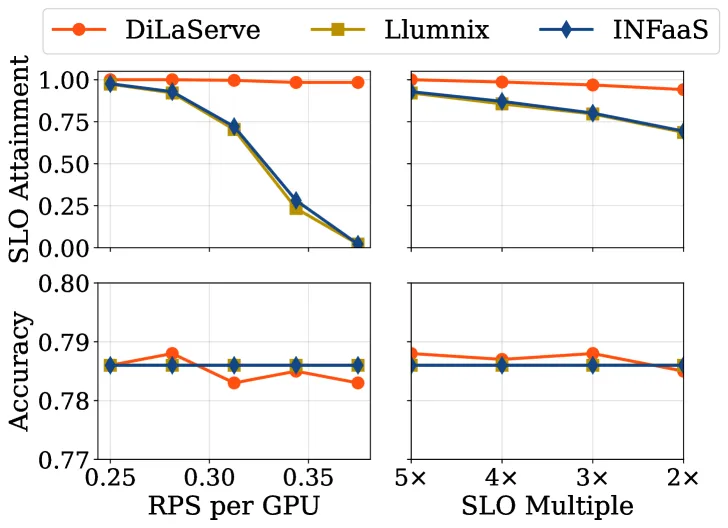
图 14(附录 F):GSM8K 无 KV 缓存服务下的性能。
七、总结
核心贡献
- 首个 DLM 集群级服务系统:识别 DLM 服务的三重挑战(速度-质量旋钮、TP 度时延-吞吐权衡、近似缓存异构成本),以去噪步为调度粒度统一应对;
- 动态阈值 + 负载控制:SLO 感知选阈最大化质量、自适应负载控制防聚合过载;
- 轻量在线 Step Predictor:11 特征 GBM,用进度+置信度特征在线预测剩余步数;
- 两阶段 ILP 重构 + 近似 KV 缓存支持:质量感知容量规划 + 最小迁移开销过渡,cache/recompute 步异构建模;
- 显著收益:真实 trace SLO +30.2pp、时延 -46%、质量仅降 0.09;多基准最高 +56.6pp SLO、精度仅降 0.9%。
局限性
- 假设同构 SLO / 同构集群(扩展至异构 SLO/优先级仅作讨论,未充分评估);
- Stage 1 ILP 假设各 TP 度共享单一 batch 大小(建模简化);
- Step Predictor 依赖离线 profiling 与每模型一次性训练,跨分布漂移的鲁棒性未评估;
- 仅在 8B 级开源 DLM(LLaDA/Dream)、16-GPU 规模验证,更大模型/集群的可扩展性待探。
八、参考资源
- arXiv 论文:https://arxiv.org/abs/2606.29094
- 实现基础:vLLM(Kwon 2023)、Ray(Moritz 2018)、Gurobi 求解器
- 测试模型:LLaDA(Nie 2025)、Dream(Ye 2025)
- 对比基线:INFaaS(Romero 2021)、Llumnix(Sun 2024)
- 数据集/基准:ShareGPT、BurstGPT(Wang 2025)、GSM8K(Cobbe 2021)、MMLU-Pro(Wang 2024)、MBPP(Odena 2021)
- 近似 KV 缓存:Wu et al. (2025b)