Qwen-Image-2.0-RL Technical Report
面向 Qwen-Image-2.0 扩散模型的 RLHF + On-Policy Distillation 后训练管线。用 VLM 微调 + 逐点评分 + CoT 构建 T2I(对齐/美学/人像)与编辑(指令遵循/人脸ID)复合奖励;基于 Flow-GRPO 引入混合 CFG(仅 rollout 用 CFG)、组内奖励范围过滤、每类权重校准、高噪声时间步采样;最后用 OPD 通过轨迹级速度匹配(W2 上界)把 T2I 与编辑双教师合并为单学生。Qwen-Image-Bench 57.84(+2.61),T2I Elo 1193(+78),编辑 Elo 1349(+93)。
Qwen-Image-2.0-RL Technical Report
本文基于 MinerU 从 PDF 提取的全文(arXiv 未提供 HTML 版本)撰写,含完整公式与图表。
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Qwen-Image-2.0-RL Technical Report |
| 作者 | Yixian Xu*, Kaiyuan Gao*, Yuxiang Chen* 等 28 人,Chenfei Wu†(通讯) |
| 机构 | Qwen Team(https://qwen.ai) |
| 提交时间 | 2026-06-25 |
| arXiv | 2606.27608 |
| 分类 | cs.CV / cs.LG |
| 基础模型 | Qwen-Image-2.0(flow matching 扩散模型,同时支持 T2I 与图像编辑) |
二、核心思想
问题定义:预训练扩散模型(尤其同时具备 T2I 与图像编辑的多任务模型)在视觉质量、指令遵循、人像保真度上仍不完全匹配人类偏好;单一奖励难以覆盖多任务,而在混合数据上联合做 RL(Mix-RL)会因任务目标相互竞争产生「跷跷板效应」,得到次优折中。
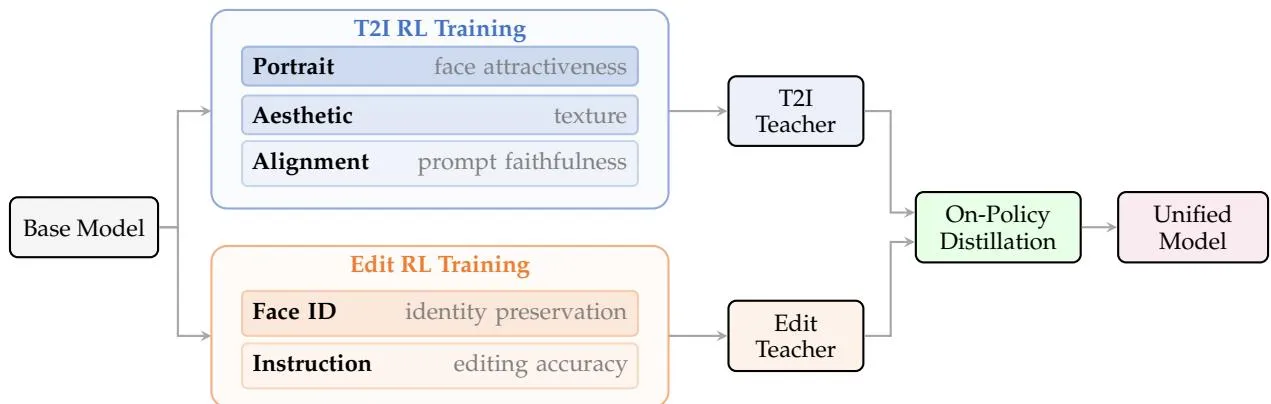
解决方案:Qwen-Image-2.0-RL 提出一条三段式后训练管线(见 Figure 1):
- 复合奖励系统:VLM 微调 + 逐点评分(pointwise)+ CoT,T2I 覆盖对齐/美学/人像三维,编辑覆盖指令遵循 + 人脸 ID(后者用模型级 embedding 打分器)。
- 可扩展 GRPO RL:基于 Flow-GRPO,引入混合 CFG(仅 rollout 用 CFG)、异步奖励管线、多奖励加权优势、高噪声时间步采样、组内奖励范围过滤、每类奖励权重校准。
- On-Policy Distillation (OPD):分别训练 T2I 与编辑两个专家教师,再通过轨迹级速度匹配把双教师蒸馏为单一部署学生,从理论上由 2-Wasserstein 距离上界 推导得到。
三、背景与基础公式
3.1 Flow-GRPO(本文 RL 的基座)
将多步去噪轨迹建模为 MDP。给定 prompt ,策略 生成一组 张图 ,奖励模型 打分。组内归一化优势:
flow matching 用确定性 ODE 生成,难以直接套 GRPO,Flow-GRPO 改用等价随机采样器:
Euler-Maruyama 离散化后转移密度为高斯,可算重要性比 ,再用裁剪代理目标:
其中 。(论文也讨论了 DiffusionNFT 的前向过程构造,Eqn. 7–9,作为对比。)
四、奖励建模(§3)
4.1 Pointwise vs Pairwise(关键消融)
- Pairwise:Bradley-Terry 排序损失
- Pointwise:对绝对分 做回归
- 实现上 VLM 输出离散分数集 的 token,奖励取期望:
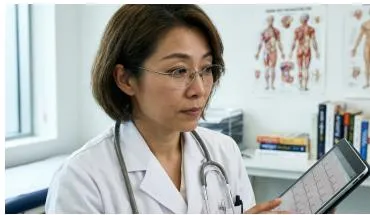
结论:在同评价维度、同数据池、只变标注格式的对照下,pointwise 训练出的奖励模型在 RL 后产出图像质量更高、纹理更细、伪影更少(Figure 2)。原因是绝对分提供”有多好”的校准信号,而 pairwise 只给”哪个更好”。因此全系统默认采用 pointwise。
4.2 T2I 奖励(分层设计,均微调 Qwen 系 VLM)
- 图文对齐奖励(最基础):优先级 = 物体存在/计数 > 属性(颜色/尺寸/形状/材质) > 空间关系 > 动作/姿态;违反高优先级项直接封顶低分。
- 美学奖励:在对齐达标后叠加,优化纹理保真。
- 人像奖励:专门优化面部吸引力、皮肤/头发细粒度真实感。
4.3 编辑奖励
- 指令遵循奖励:VLM 接收 (源图, 指令, 输出图) 三元组,把指令分解为核心/非核心要求,评估 (1) 核心编辑是否完成、(2) 非核心要求、(3) 整体视觉一致性。
- 人脸身份一致性奖励:VLM 对细微身份漂移不敏感,故引入独立的模型级 embedding 人脸打分器做精确 ID 保留信号。
五、训练框架(§4)
5.1 混合 CFG 策略(核心 trick)
系统对比三种 CFG 用法(Figure 3):
| 策略 | 结果 |
|---|---|
| rollout + training 都用 CFG | 训练不稳定,图像最终崩溃 |
| 两阶段都不用 CFG | 奖励上升但逐渐丢失风格化能力与世界知识(认不出名人、失去特定风格) |
| 仅 rollout 用 CFG(本文采用) | 训练稳定 + 保留预训练全部生成能力 |
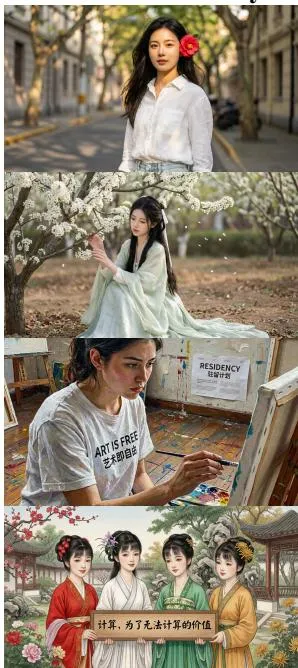
采用「仅 rollout 用 CFG」:CFG 引导的 rollout 产出结构连贯、奖励可靠的候选,而 CFG-free 的训练目标避免联合优化条件/无条件分支的困难,梯度稳定且降低计算量。
5.2 异步奖励管线
奖励模型作为远程 API 服务独立部署。生成一批图后由后台线程异步提交到远程 VLM 端点,奖励延迟被 GPU 推理计算掩盖,从而可扩展到多个奖励模型而不线性增加训练时间。
5.3 多奖励加权优势
每组 per-prompt-group 归一化是关键:使复合奖励对各奖励模型的绝对尺度差异不变,防止某一维因数值范围大而主导优势信号。
5.4 任务专用优化
- 时间步采样:rollout 用 40 步 ODE,但只在**高噪声时间步()**子集上加 RL 训练信号——高噪声步主导全局结构/语义布局,是更稳健的优化目标,可减缓 reward hacking(否则几个迭代内就退化)。
- Prompt curation:基模型对每个候选 prompt 做 次 rollout,算组内奖励极差(max−min),只保留极差超阈值者。整组同高/同低分的 prompt 梯度信号弱,丢弃以集中算力。
- Per-category 奖励校准:把 prompt 分成 portrait/landscape/typography/general 等类别,各配类别专属权重向量(人像题加大人像奖励权重、排版题加大对齐权重),避免收敛到单一主导风格。
5.5 On-Policy Distillation(§4.3)
目标:把任务专用的 T2I / 编辑教师合并为单一部署学生 (初始化自基模型)。学生用 步反向 ODE 生成,保存自身完整轨迹 ,在自己轨迹的每点匹配对应任务教师 的速度场:
多教师蒸馏:维护 T2I 教师与编辑教师两个,按当前样本任务类型选择教师;仅激活教师载入 GPU,非激活教师 offload 到 CPU,从而多大教师而不线性增显存。教师做速度预测时用 CFG,学生不用;OPD 后再把 CFG 集成回学生。
理论依据(附录 A):以 2-Wasserstein 距离为分布度量, 直接算需解最优传输不可行。借助 Benton et al. (2023) 定理,在光滑流 + 教师速度场 Lipschitz 假设下:
指数因子只依赖教师网络的 Lipschitz 常数、与训练目标无关,故最小化 上界等价于最小化轨迹级速度匹配目标(Eqn. 18→离散化为 Eqn. 14/19)。
六、核心创新
| 创新点 | 描述 |
|---|---|
| Pointwise + CoT 奖励 | 逐点绝对打分(Eqn. 11-12)比 pairwise 排序更稳、可解释,实证 RL 后画质更优 |
| 任务专用复合奖励 | T2I 拆对齐/美学/人像三层,编辑拆指令 + 模型级人脸 ID embedding 打分 |
| 混合 CFG(仅 rollout) | 抑制 reward hacking 与预训练能力流失,兼顾稳定性与算力 |
| 高噪声步采样 + 组内极差过滤 + 每类校准 | 三项 GRPO 稳定化 / 数据高效化技巧 |
| 轨迹级速度匹配 OPD | 由 上界推导,多任务教师合一学生,避免 Mix-RL 的跨任务目标冲突 |
七、实验结果(§5)
7.1 Qwen-Image-Bench(Table 1,[0,100],Q-Judger 评审,130K+ 人工标注)
| 模型 | Quality | Aesthetics | Alignment | Real-world Fidelity | Creative Gen. | Overall |
|---|---|---|---|---|---|---|
| Qwen-Image-2.0-Base | 52.29 | 57.10 | 57.64 | 47.54 | 58.22 | 55.23 |
| Qwen-Image-2.0-RL | 54.39 | 58.67 | 59.28 | 51.83 | 64.94 | 57.84 |
| Δ | +2.10 | +1.57 | +1.64 | +4.29 | +6.72 | +2.61 |
- 五维全面提升,Creative Generation +6.72、Real-world Fidelity +4.29 增幅最大。
- 对照强基线(部分节选):GPT Image 2 = 64.69、Nano Banana 2.0 = 59.82、Seedream 5.0 = 57.22、FLUX 2 Max = 55.33。RL 后 Qwen-Image-2.0-RL(57.84) 超过 Seedream 5.0 但仍低于 Nano Banana / GPT Image 1.5 等最强闭源模型。
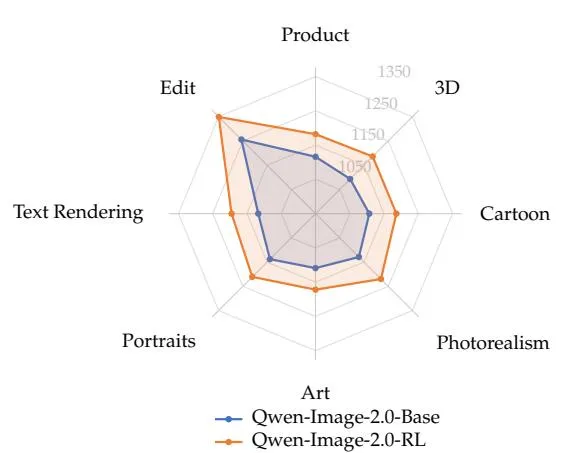
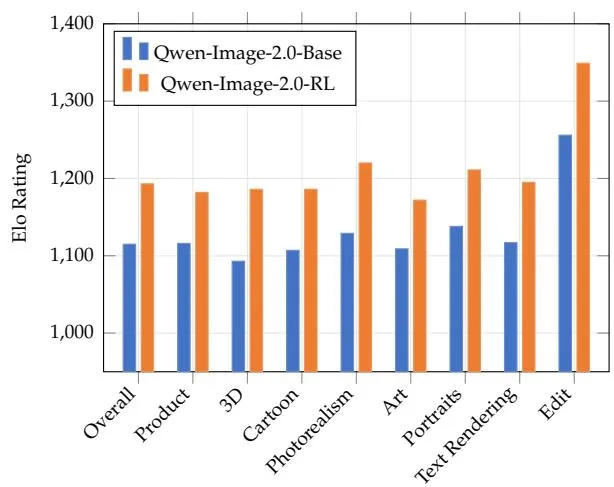
7.2 人类偏好 Arena(Figure 4,Elo)
| Arena | 基线 | RL 后 | Δ |
|---|---|---|---|
| 文生图 T2I | 1115 | 1193 | +78 |
| 图像编辑 | 1256 | 1349 | +93 |
- 8 个子类全线提升;T2I 中 3D Modeling +93、Photorealism +91 增幅最大(结构一致性与细节提升)。
7.3 OPD vs Mix-RL(关键消融,Figure 5/6)
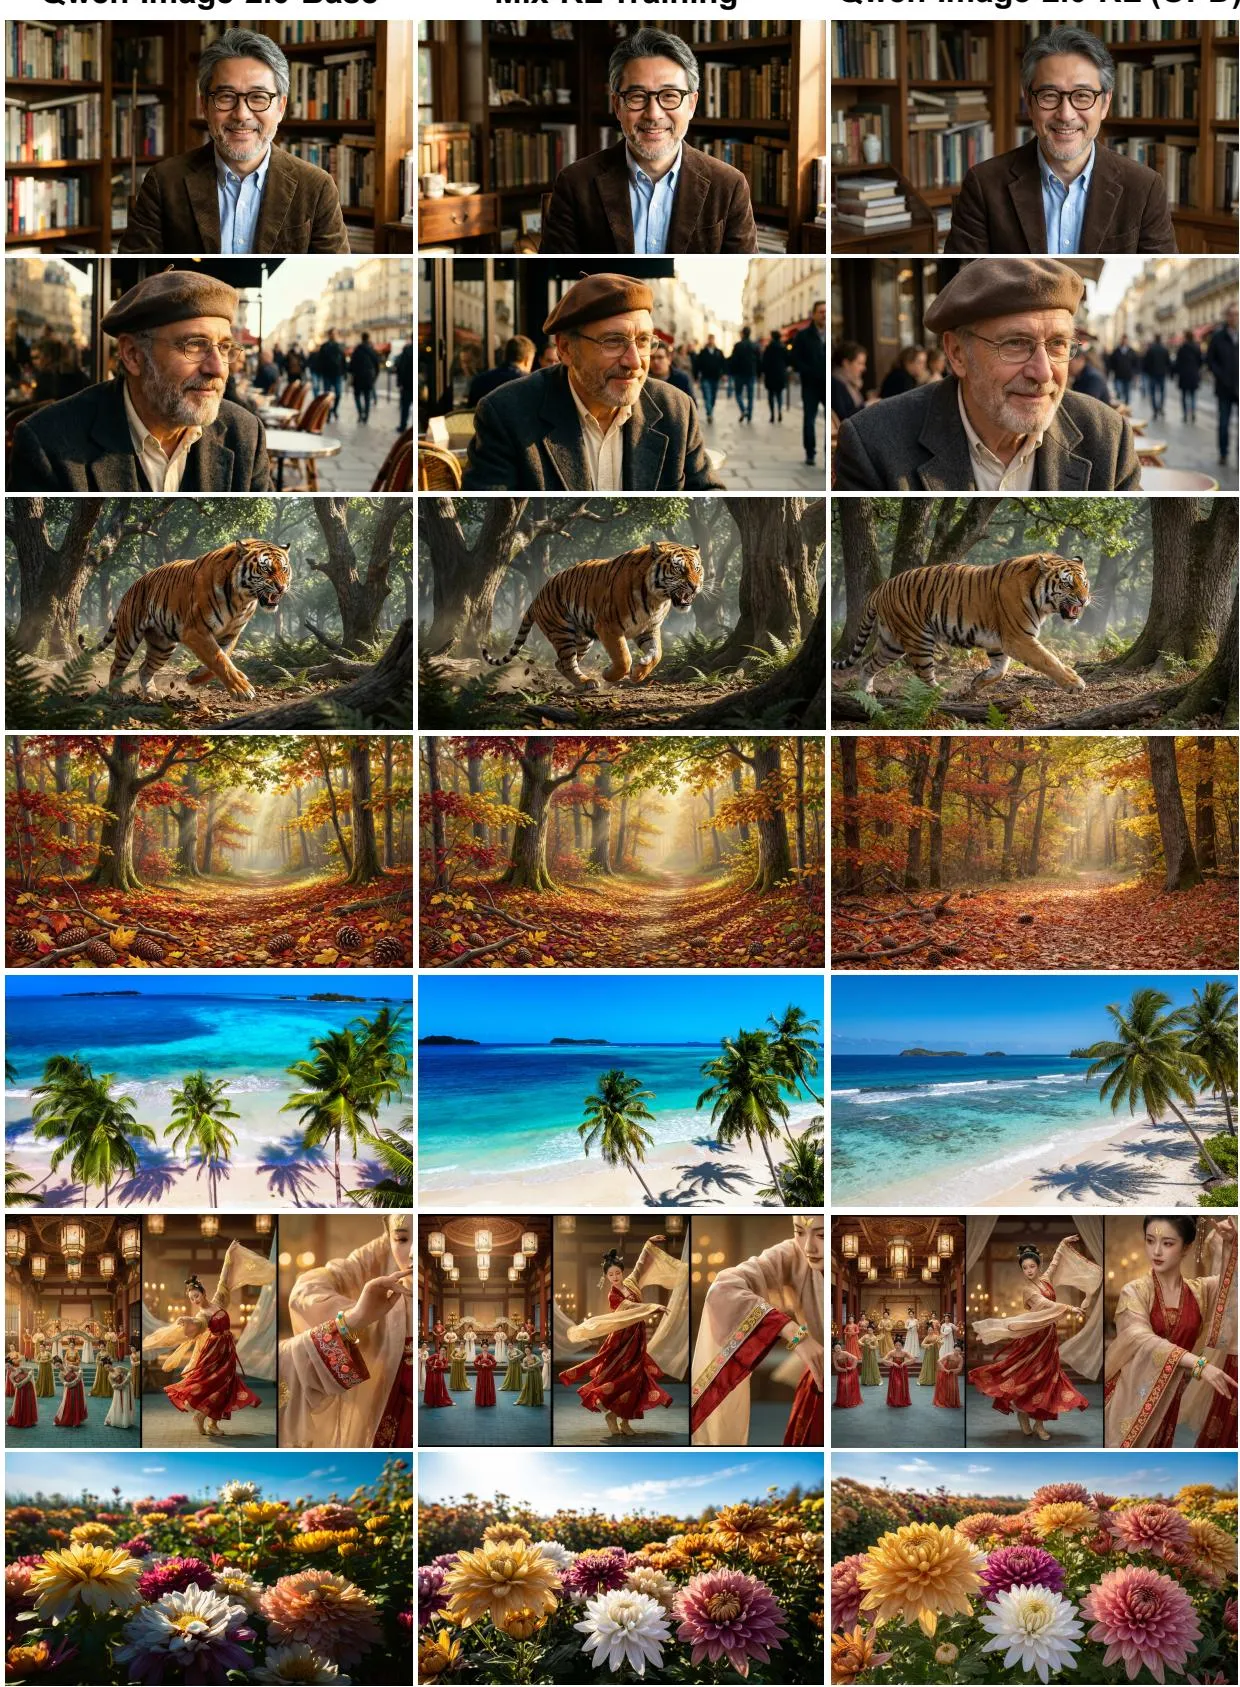
三方对比:Base → Mix-RL → Qwen-Image-2.0-RL(OPD)。
- Mix-RL 已比 Base 提升(纹理/构图/真实感),证明奖励套件有效;
- 但 OPD 始终优于 Mix-RL:细节更锐、prompt 遵循更准、美学更好;
- 编辑任务上 OPD 在人脸身份保留与复杂指令遵循上明显胜出,而 Mix-RL 仍有身份漂移/编辑不完整。→ 验证「分解训练 + 蒸馏合并」优于「联合多奖励 RL」。
八、相关工作
- 扩散 RL:Flow-GRPO(GRPO→flow matching)、GRPO-Guard(regulated clipping 抑过优化)、AWM、DiffusionNFT(前向过程构造)。本文在其上引入面向 Qwen-Image-2.0 的混合 CFG。
- 扩散奖励模型:CLIP → ImageReward / PickScore / HPSv2 / HPSv3(BT 回归)→ UnifiedReward / RewardDance(token 概率打分 + CoT)。
- On-Policy Distillation:GKD(LLM 起源);并行工作 Flow-OPD、DiffusionOPD 把 OPD 扩到 flow matching(证明高斯转移核 KL 退化为速度场 MSE),但只合并单奖励 T2I 教师。本文差异:按任务类型专门化教师(T2I + 编辑),并从 上界推导目标。
九、总结
核心贡献
- 面向 T2I + TI2I 的 VLM 复合奖励系统(结构化评分 rubric,pointwise + CoT)。
- 适配 flow matching 的 GRPO 框架:混合 CFG + 异步奖励管线 + 高噪声步采样 + 组内极差过滤 + 每类校准。
- 由 上界推导的 OPD,把任务专用 RL 教师合一为部署模型,消除推理期奖励模型依赖,且超过 Mix-RL。
技术影响
- 为扩散/流匹配模型 RLHF 提供工业级可复现配方。
- OPD 的「多任务教师→单学生」思路可迁移到更广的多模态生成合并场景。
局限性
- 相比 GPT Image 2 / Nano Banana 等最强闭源模型仍有差距(57.84 vs 64.69)。
- 奖励模型基于 VLM,天花板受限于 VLM 自身评价能力与偏差。
- 评估以 Qwen-Image-Bench + Elo Arena 为主,缺 GenEval / T2I-CompBench 等公开基准直接对比。
十、参考资源
- arXiv 论文:https://arxiv.org/abs/2606.27608
- 官网:https://qwen.ai
- 图片索引:
figures/2606.27608-qwen-image-2-rl/README.md - 相关工作:Flow-GRPO, DiffusionNFT, GRPO-Guard, ImageReward, HPSv2/v3, UnifiedReward, RewardDance, GKD, Flow-OPD, DiffusionOPD