CAT-Q: Cost-efficient and Accurate Ternary Quantization for LLMs
CAT-Q首次以纯PTQ路线量化LLM到1.58bit三元权重,无需QAT。两个核心模块:Learnable Modulation用可学习因子$(\delta_\mu,\delta_\alpha,\delta_\Delta)$调制预训练权重分布与三元阈值,Softened Ternarization用tanh-based smooth transition函数从identity渐变到hard ternarization。仅512校准样本、8卡A100 8–60小时即可把1.7B–235B模型三元化,性能超越用100B tokens训练的BitNet 1.58-bit v1/v2,训练token量减少约10^5倍。
CAT-Q: Cost-efficient and Accurate Ternary Quantization for LLMs
一、论文概述
| 项目 | 内容 |
|---|---|
| arXiv ID | 2606.26650 |
| 标题 | CAT-Q: Cost-efficient and Accurate Ternary Quantization for LLMs |
| 作者 | Shigeng Wang, Chao Li, Yangyuxuan Kang, Jiawei Fan, Anbang Yao |
| 提交日期 | 2026-06-25 |
| 学科分类 | cs.CL, cs.AI |
| 模型规模 | 1.7B → 235B(Qwen3、Llama2、Qwen3-30B-A3B、Ring-flash-2.0 100B-A6.1B、Qwen3-235B-A22B) |
| 校准 | 512 samples, seq len 2048(C4) |
二、核心思想
问题定义:Ternary(1.58-bit)量化把权重映射到 ,10× 内存压缩且用整数加减替代 FP 乘法。现有最强 ternary LLM 方法(BitNet 1.58-bit v1/v2、TriLM、Tequila)均走 QAT 路线,需要100B+ tokens 训练,成本极高且模型规模有限。而现代 PTQ 方法(AWQ/GPTQ/OmniQuant/QuaRot/FlatQuant/SliderQuant)在 W2 及以下会崩溃。
解决方案:CAT-Q 是纯 PTQ 三元量化,只用 512 calibration samples(约 1M tokens,比 BitNet 减少 ~10^5×)就能三元化 1.7B–235B LLM。两个核心组件从优化视角耦合:
- Learnable Modulation (LM):以 三个可学习因子调制预训练权重的均值/尺度/三元阈值,让 W 分布对 ternarization “不敏感”;
- Softened Ternarization (ST):用可微 smooth transition 函数 ,随校准 epoch 逐步把 identity mapping 变成 hard ternarization,避免直接跳跃到非可微硬阈函数导致的收敛问题。
外层用 Sliding-Layer Ternarization Optimization(借鉴 SliderQuant)做多层联合输出重建。
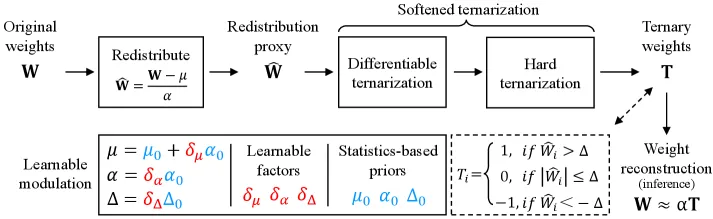
三、技术架构/方法
3.1 Preliminary
线性层三元量化目标:
TWN 静态近似:,。BitNet 系列的 absmean:, 。
3.2 Learnable Modulation
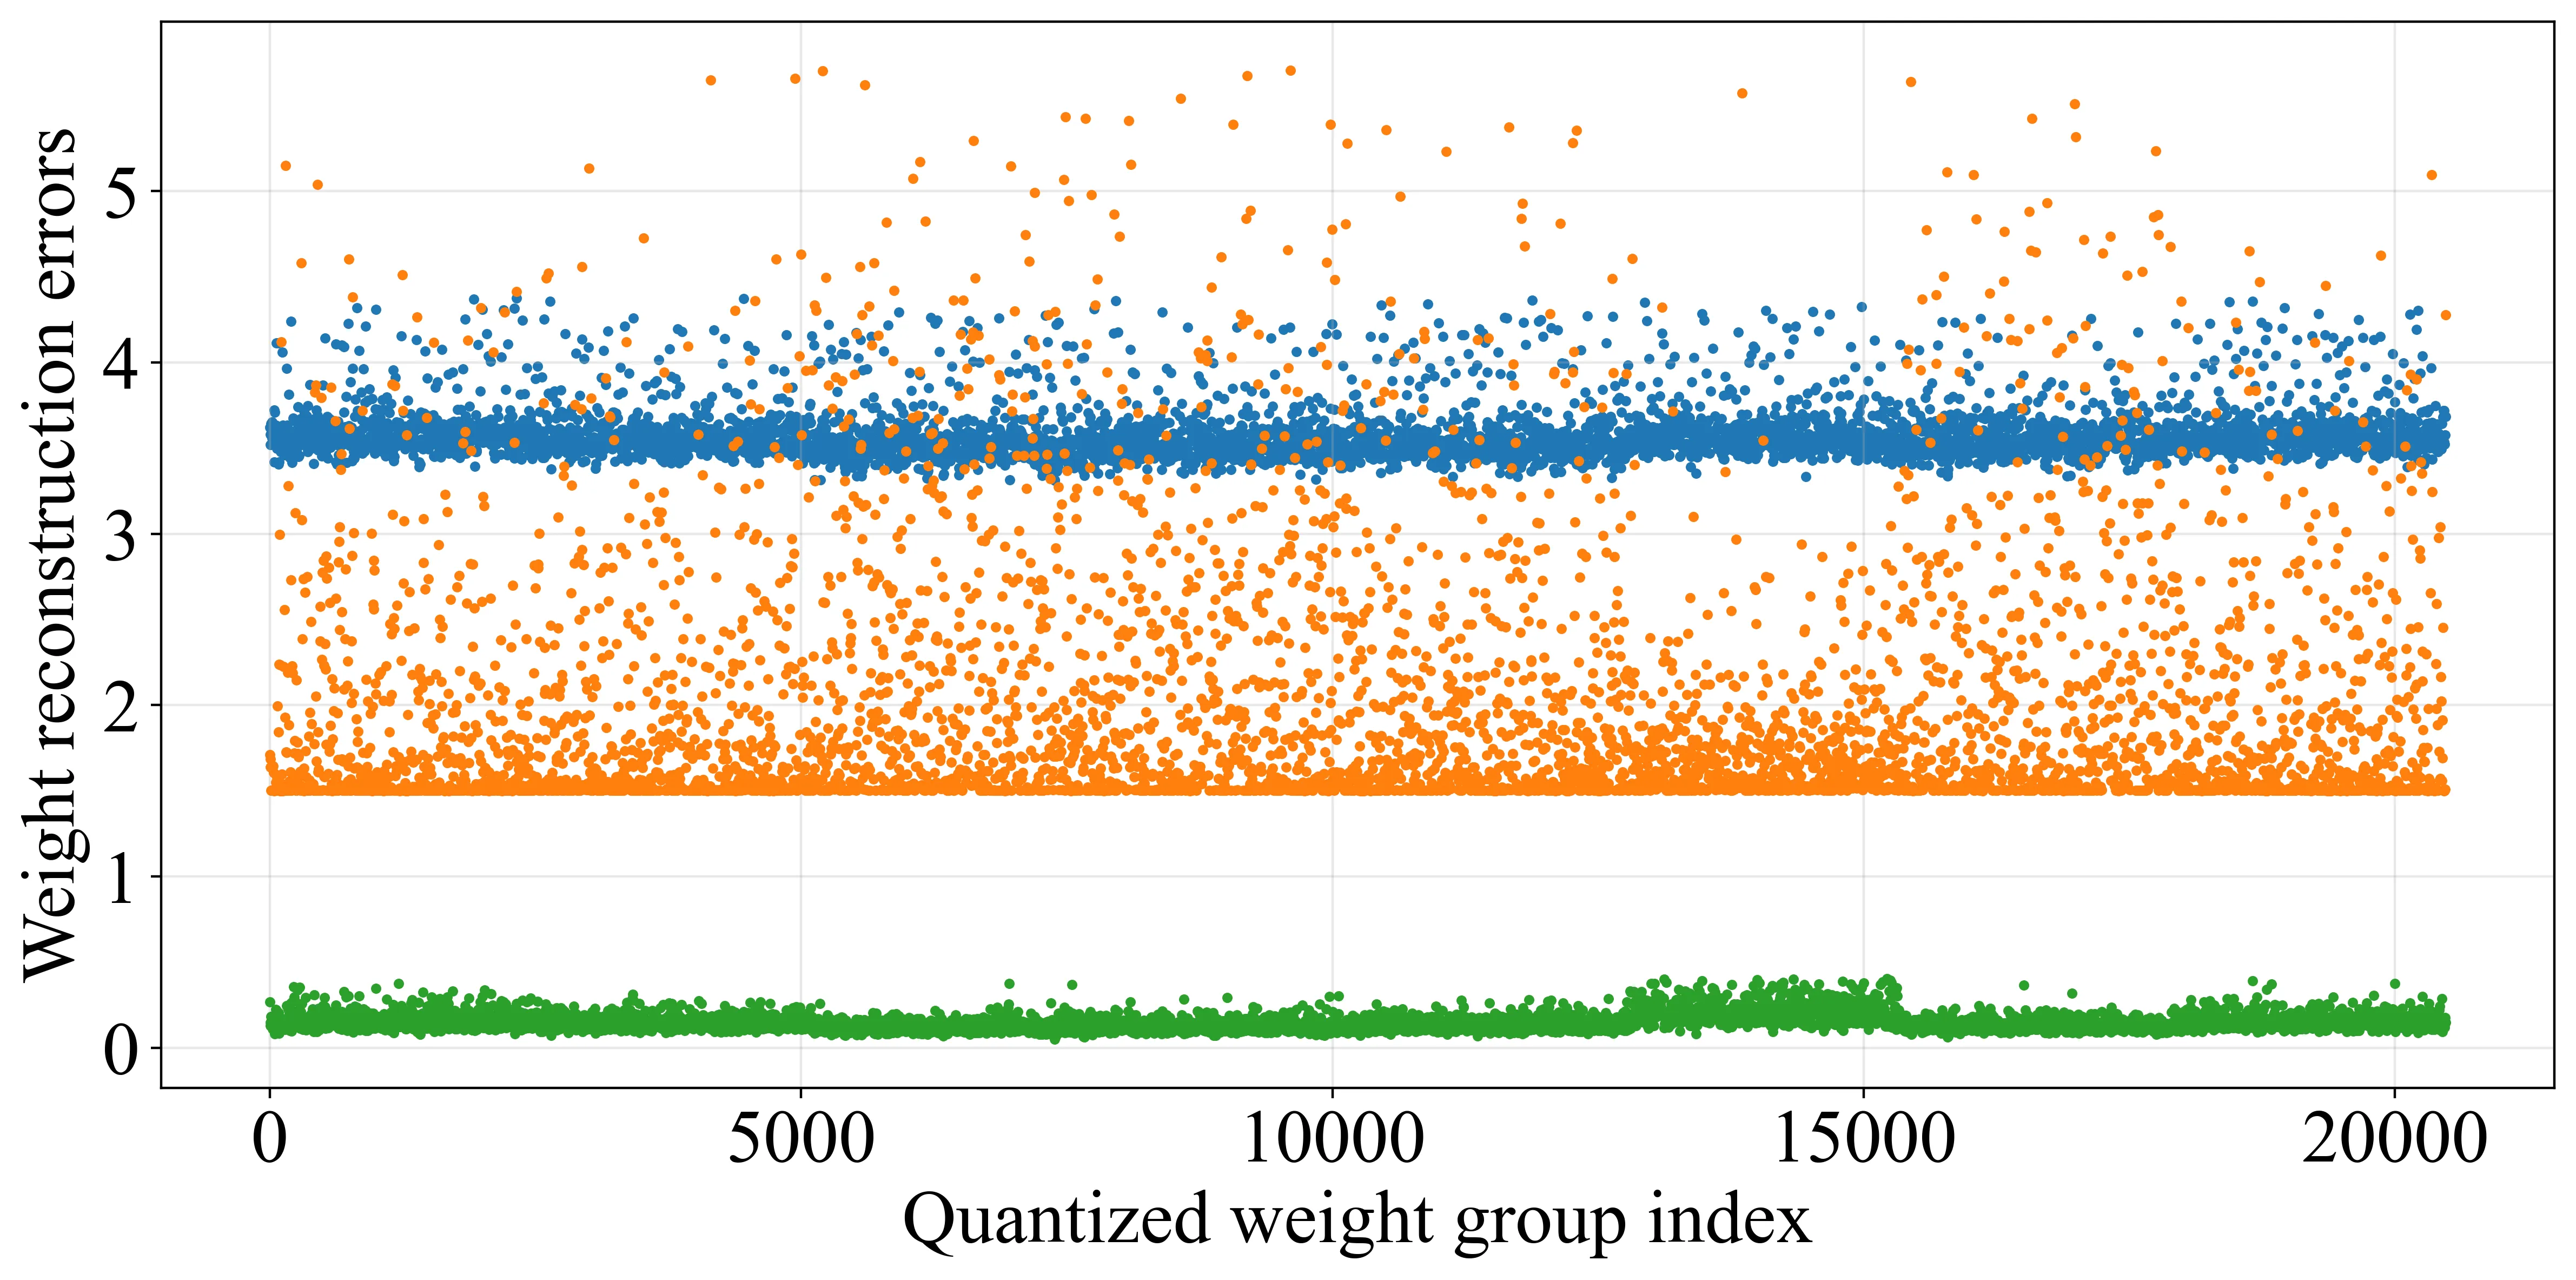
作者发现直接把 变成 learnable 参数只比静态略好,因为未处理预训练权重分布与三元化的错位。LM 给权重做可学习线性变换:
其中 、 为静态初值; 是可学习标量因子。。三个因子分别调制均值、尺度、阈值,让权重分布向三元友好方向搬动。图 2 显示 LM(绿点)显著优于静态近似(蓝)与直接学习 (橙)。
3.3 Softened Ternarization
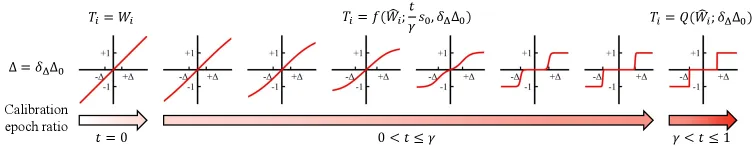
Smooth transition 函数:
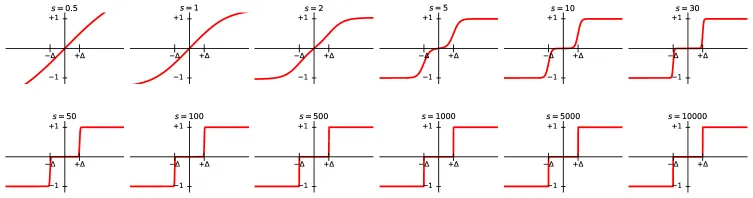
性质:
- :identity mapping;
- 增大:output 曲线越尖锐; 时输出已缩到 ;:等价 hard ternarization。
耦合 LM 后:
默认 ,校准 epoch ,(即 80% epoch 用可微阶段,20% 用硬阶段收敛)。
3.4 Sliding-Layer Ternarization Optimization
不做每层单独重建,而是滑动窗口内 层联合优化输出:
是窗口输出特征,让邻层相互 aware,缓解误差累积。窗口尺寸沿用 SliderQuant 默认。
四、核心创新
| 创新点 | 说明 |
|---|---|
| PTQ 三元量化范式 | 首个可直接适配任意架构/尺寸 LLM 的 PTQ 三元方案,跳过昂贵 QAT |
| Learnable Modulation | 用 三因子调整均值/尺度/阈值,把 W 分布搬到三元友好域 |
| Softened Ternarization | tanh-based smooth transition + 两阶段(可微→硬)relay 保证 PTQ 无 QAT 的稳定收敛 |
| Sliding-window 输出重建 | 借 SliderQuant 框架把多层联合优化引入三元化 |
| 极小校准成本 | 512 样本 × 60 epoch;8×A100 8–60 h 即可量化 14B–235B |
五、实验结果
5.1 主结果(W1.58 三元,A16/A8)
10 个模型 × 5 个 zero-shot benchmark(PIQA, ARC-e, ARC-c, HS, WG),部分节选:
| Model | Method | Avg | PPL 掉幅 |
|---|---|---|---|
| Qwen3-8B | W16A16 | 71.57 | — |
| + CAT-Q W1.58A16 | 61.76 | −9.81 | |
| Qwen3-32B | W16A16 | 76.43 | |
| + CAT-Q W1.58A16 | 71.19 | −5.24 | |
| Llama2-70B | W16A16 | 76.53 | |
| + CAT-Q W1.58A16 | 72.72 | −3.81 | |
| Qwen3-30B-A3B (MoE) | W16A16 | 72.64 | |
| + CAT-Q W1.58A16 | 62.55 | −10.09 | |
| Ring-flash-2.0 100B-A6.1B | W16A16 | 74.88 | |
| + CAT-Q W1.58A16 | 64.68 | −10.20 | |
| Qwen3-235B-A22B | W16A16 | 79.59 | |
| + CAT-Q W1.58A16 | 69.09 | −10.50 |
模型越大,退化越小;MoE 模型比同规模 dense 更敏感。首次证明可将 235B PTQ 三元化,8×A100-80GB × 60h。
5.2 与 QAT 系列对比(W1.58A16)
| Model | #Tokens | Avg |
|---|---|---|
| BitNetV1-1.3B | 100B | 48.28 |
| TriLM-1.5B | 300B | 50.20 |
| Qwen3-1.7B + CAT-Q | 1M | 51.01 |
| BitNetV1-3.9B | 100B | 54.16 |
| TriLM-3.9B | 300B | 56.55 |
| TequilaLLM-3B | 10B | 57.60 |
| Qwen3-4B + CAT-Q | 1M | 57.06 |
| Qwen3-4B + CAT-Q (2M cal) | 2M | 58.80 |
| BitNetV1-7B | 100B | 57.42 |
| TernaryLLM-8B + KD | 1T | 60.04 |
| Qwen3-8B + CAT-Q | 1M | 61.76 |
在同规模区间 CAT-Q 全部超越 BitNet v1/v2 与 TriLM,且训练 token 少约 5 个数量级(1M vs 100B–1T)。
W1.58A8 上同样击败 BitNetV2 家族(Qwen3-8B + CAT-Q W1.58A8:Avg 60.96 vs BitNetV2-7B 57.63)。
5.3 与近 1.58bit PTQ 对比(Llama2)
| Method | Bits | Llama2-7B Avg | Llama2-70B Avg |
|---|---|---|---|
| AWQ | W2A16 | 35.82 | — |
| GPTQ | W2A16 | 41.55 | 34.38 |
| OmniQuant | W2A16 | 46.98 | 54.87 |
| PB-LLM | W1*A16 | 37.59 | — |
| BiLLM | W1*A16 | 41.68 | — |
| DB-LLM | W1*A16 | 55.12 | 65.82 |
| SliderQuant | W2A16 | 55.38 | 71.08 |
| CAT-Q | W1.58A16 | 57.69 | 72.72 |
在更低 bit width 下击败所有 W2/W1 PTQ 基线*。
5.4 消融
- LM 各因子 + ST:从静态 → 逐步加 → 加 ST,性能逐级上升;LM+ST 联合最佳。
- 选择: 稳定最优;(不做硬阶段)明显掉; 都 robust。
- 估计策略对比(Qwen3-4B / Llama2-7B):SA(静态近似)40.16 / 45.37;DL(直接学 )46.94 / 50.23;LM 57.06 / 57.69。
- 含 vs 不含 :细微差异,默认不含 稍好。
- learnable 阈值 vs 手工 :learnable 全面胜出。
六、总结
核心贡献
- 首个可扩展到 235B 的 PTQ 三元 LLM 量化方案;
- LM + ST 从优化耦合视角处理”分布敏感 + 非可微”两大障碍;
- 用 SliderQuant 风格 sliding-window 输出重建加强层间协同;
- 训练成本相对 QAT 家族 减少 ~10^5×,14B–235B 8 卡 8–60h 即可完成。
技术影响
- 让 1.58bit LLM 部署脱离 QAT 依赖,pretrained checkpoint 可直接压缩;
- 展示 PTQ 在 W1.58 上超越 QAT 的可能路径(在小模型区间);
- 与 SliderQuant 等多层重建框架天然兼容,可作为通用 PTQ backbone。
局限性
- 小模型(1.7B/4B)退化仍相对明显(Qwen3-1.7B 平均掉 10 pp);
- MoE 模型(Qwen3-30B-A3B 等)比同规模 dense 更敏感,需专家路由感知的额外设计;
- 校准 epoch 数 60 仍需相当 GPU 时间(235B 60h),未做速度优化;
- 未在数学/代码等挑战性任务全面评估(附录做了 pilot)。
七、参考资源
- 论文原文:https://arxiv.org/abs/2606.26650
- HTML 版本:https://arxiv.org/html/2606.26650v1
- 代码:论文注明 GitHub 仓库
- 相关工作:BitNet 1.58-bit v1/v2、TriLM、Tequila、TernaryLLM、TWN、SliderQuant、GPTQ、AWQ、OmniQuant、QuaRot、FlatQuant、DB-LLM、BiLLM、PB-LLM