Moebius: Serving Mixture-of-Expert Models with Seamless Runtime Parallelism Switch
首个在运行时于专家并行(EP)与张量并行(TP)间无缝切换、不重启引擎、不丢弃在途请求的 MoE 服务系统。核心洞见:EP 与 TP 是同一模型的两种布局而非两个模型,切换只改变「哪个 rank 拥有哪一片」,唯一成本是搬运换主字节,NVLink 使其在两次 decode step 间完成。用统一内存管理器保持 CUDA graph 跨切换有效、融合直传 kernel、双控制平面同时驻留。8×H200 服务 Qwen3-235B-A22B,RL rollout 超越 1.16-1.25×,每次切换 215-434ms,仅 2.4% 显存开销
Moebius: Serving Mixture-of-Expert Models with Seamless Runtime Parallelism Switch
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Moebius: Serving Mixture-of-Expert Models with Seamless Runtime Parallelism Switch |
| 作者 | Shaoyu Wang, Yizhuo Liang, Jaeyong Song, Chong Li, Seo Jin Park |
| 论文 | arXiv:2606.26607(v1,2026-06-25) |
| 发布 | 2026 年 6 月 25 日 |
| 领域 | cs.DC(分布式、并行与集群计算) |
| 性质 | 系统(MoE 推理服务的运行时并行切换引擎) |
| 实现 | 基于 SGLang v0.5.5,约 7,400 行自包含模块 + 约 200 行引擎改动 |
| 测试硬件 | 单节点 8×NVIDIA H200(141GB HBM,NVLink 全互连) |
| 测试模型 | Qwen3-235B-A22B(BF16,235B 参数,94 层,64 query / 4 KV 头) |
二、核心思想
问题定义
混合专家(Mixture-of-Experts, MoE) 通过每 token 只激活少量专家子网,把 LLM 扩到数千亿参数而不成比例增加单 token 计算。服务单个 MoE 需多 GPU 并行,主流两种布局:
- 张量并行(TP):每个专家与注意力头都跨所有 GPU 分片,全 batch 在每 GPU 上跑,逐层 All-Reduce 同步部分结果;
- 专家并行(EP):每 GPU 拥有一部分专家 + 一份互不相交的请求切片,token 经 All-to-All 路由到拥有对应专家的 GPU。
关键观察:最优并行严重依赖并发度(图 1a、图 2)——低并发 TP 快(EP 把 batch 碎片化、每 rank 工作太少,kernel/attention 效率低),高并发 EP 胜(TP 逐层 All-Reduce 传整个 hidden state、且每 rank MoE 激活流量更大)。而生产负载持续跨越这条边界:
- 在线服务:突发到达后归于平静,反复穿越 TP–EP 交叉点(图 1b);
- RL rollout:每步以高并发 burst 开始(利于 EP),随样本陆续完成衰减为长尾 straggler(利于 TP)(图 1c)。
固定任一布局都会在负载跨越到另一侧时损失性能。
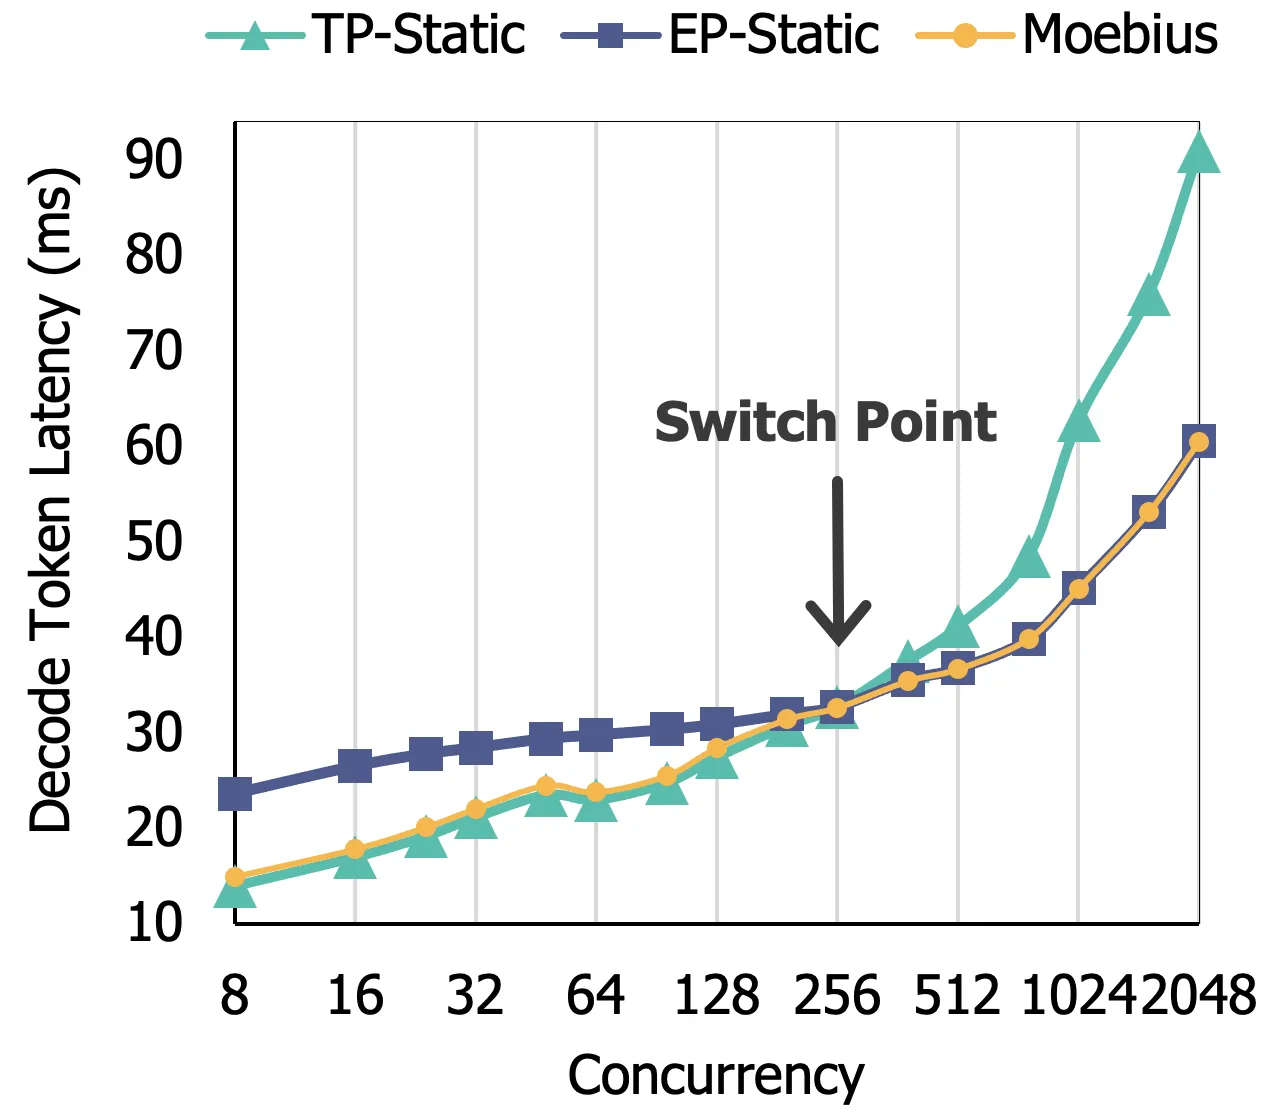
图 1:MoE decode 的最优并行随活跃负载迁移。(a) 静态负载扫描下 TP/EP/Moebius 的 decode 时延 vs 并发(8×H200, Qwen3-235B),交叉点即 TP–EP 切换点;(b) Azure 在线 trace 与 bursty trace 的到达率,竖线标注切换点;(c) 同一 RL rollout batch 在 TP/EP/Moebius 上运行,每白条为一个样本的 decode 生命周期,burst 转为长尾时 Moebius 在边界处 EP→TP 切换。
MoE 切换的三大挑战(§1)
复用稠密 LLM 的运行时切换方案(Shift Parallelism、Amoeba、Flying Serving)不可行,因它们假设「两种并行的权重都本地驻留、在途请求可暂停/丢弃、runtime 重建代价低」——MoE 全部否定:
- 更大的权重搬运:专家权重远大于稠密模型,只能驻留一种布局的权重,切换须跨互连重分片 GPU 常驻专家(EP 与 TP 沿正交轴切分,不共享字节);
- 请求需恢复:EP 按请求分区、TP 每 GPU 服务全部请求但只存分片头——活切换须重分布在途请求及其分页 KV cache 以恢复解码;
- 图执行:CUDA graph 预捕获是低时延服务事实标准,张量地址嵌在图中,切换不得改写已捕获的权重/cache 地址。
解决方案:Moebius
核心洞见:在 NVLink 等高带宽互连上,EP 与 TP 是同一模型的两种布局,而非两个模型——它们在字节完全相同的权重与 KV 上计算相同函数,只差「如何跨 GPU 分片」与「哪个 collective 搬运」。因此切换并非本质昂贵,其唯一不可省成本是搬运换主的字节。Moebius 将切换拆为:
- 控制平面(CUDA graph、通信组、attention 元数据)——小,故两套布局同时驻留,切换只选中已备好的状态;
- 数据平面(专家权重、分页 KV cache)——大,故在单份固定地址分配上重分片,只搬换主字节。
三大机制:统一内存管理器(UMM) + 融合直传 kernel + 运行时保持(runtime preserving)。
三、背景与动机(§2)
3.1 MoE 推理的并行(§2.1)
MoE 推理拆为两个独立放置选择:注意力可 TP(每 GPU 全 batch、分片头)或 DP(每 GPU 一份请求切片、只存该片 KV);专家可 TP(每权重矩阵 All-Reduce 分片)或 EP(每 GPU 拥有部分专家、All-to-All 路由)。叉积得 4 种布局(attention/expert):TP/TP、DP/EP、DP/TP、TP/EP。
在 8×H200 服务 Qwen3-235B-A22B、开 CUDA graph 扫描发现(图 2):全局 batch 从 8 到 2048,TP/TP 在小 batch 领先 1.5×、DP/EP 在大 batch 领先 1.5×,边界在 ~ 间。两种混合布局从不进入下包络(DP/TP 先聚全 token 再跑 TP 专家,丢了 EP 的 MoE 体量削减;TP/EP 保留 TP 全 token batch 又让每 token 过路由层,抹掉 EP 的激活节省)。故全文聚焦两个「幸存者」:TP(=TP/TP)与 EP(=DP/EP)。
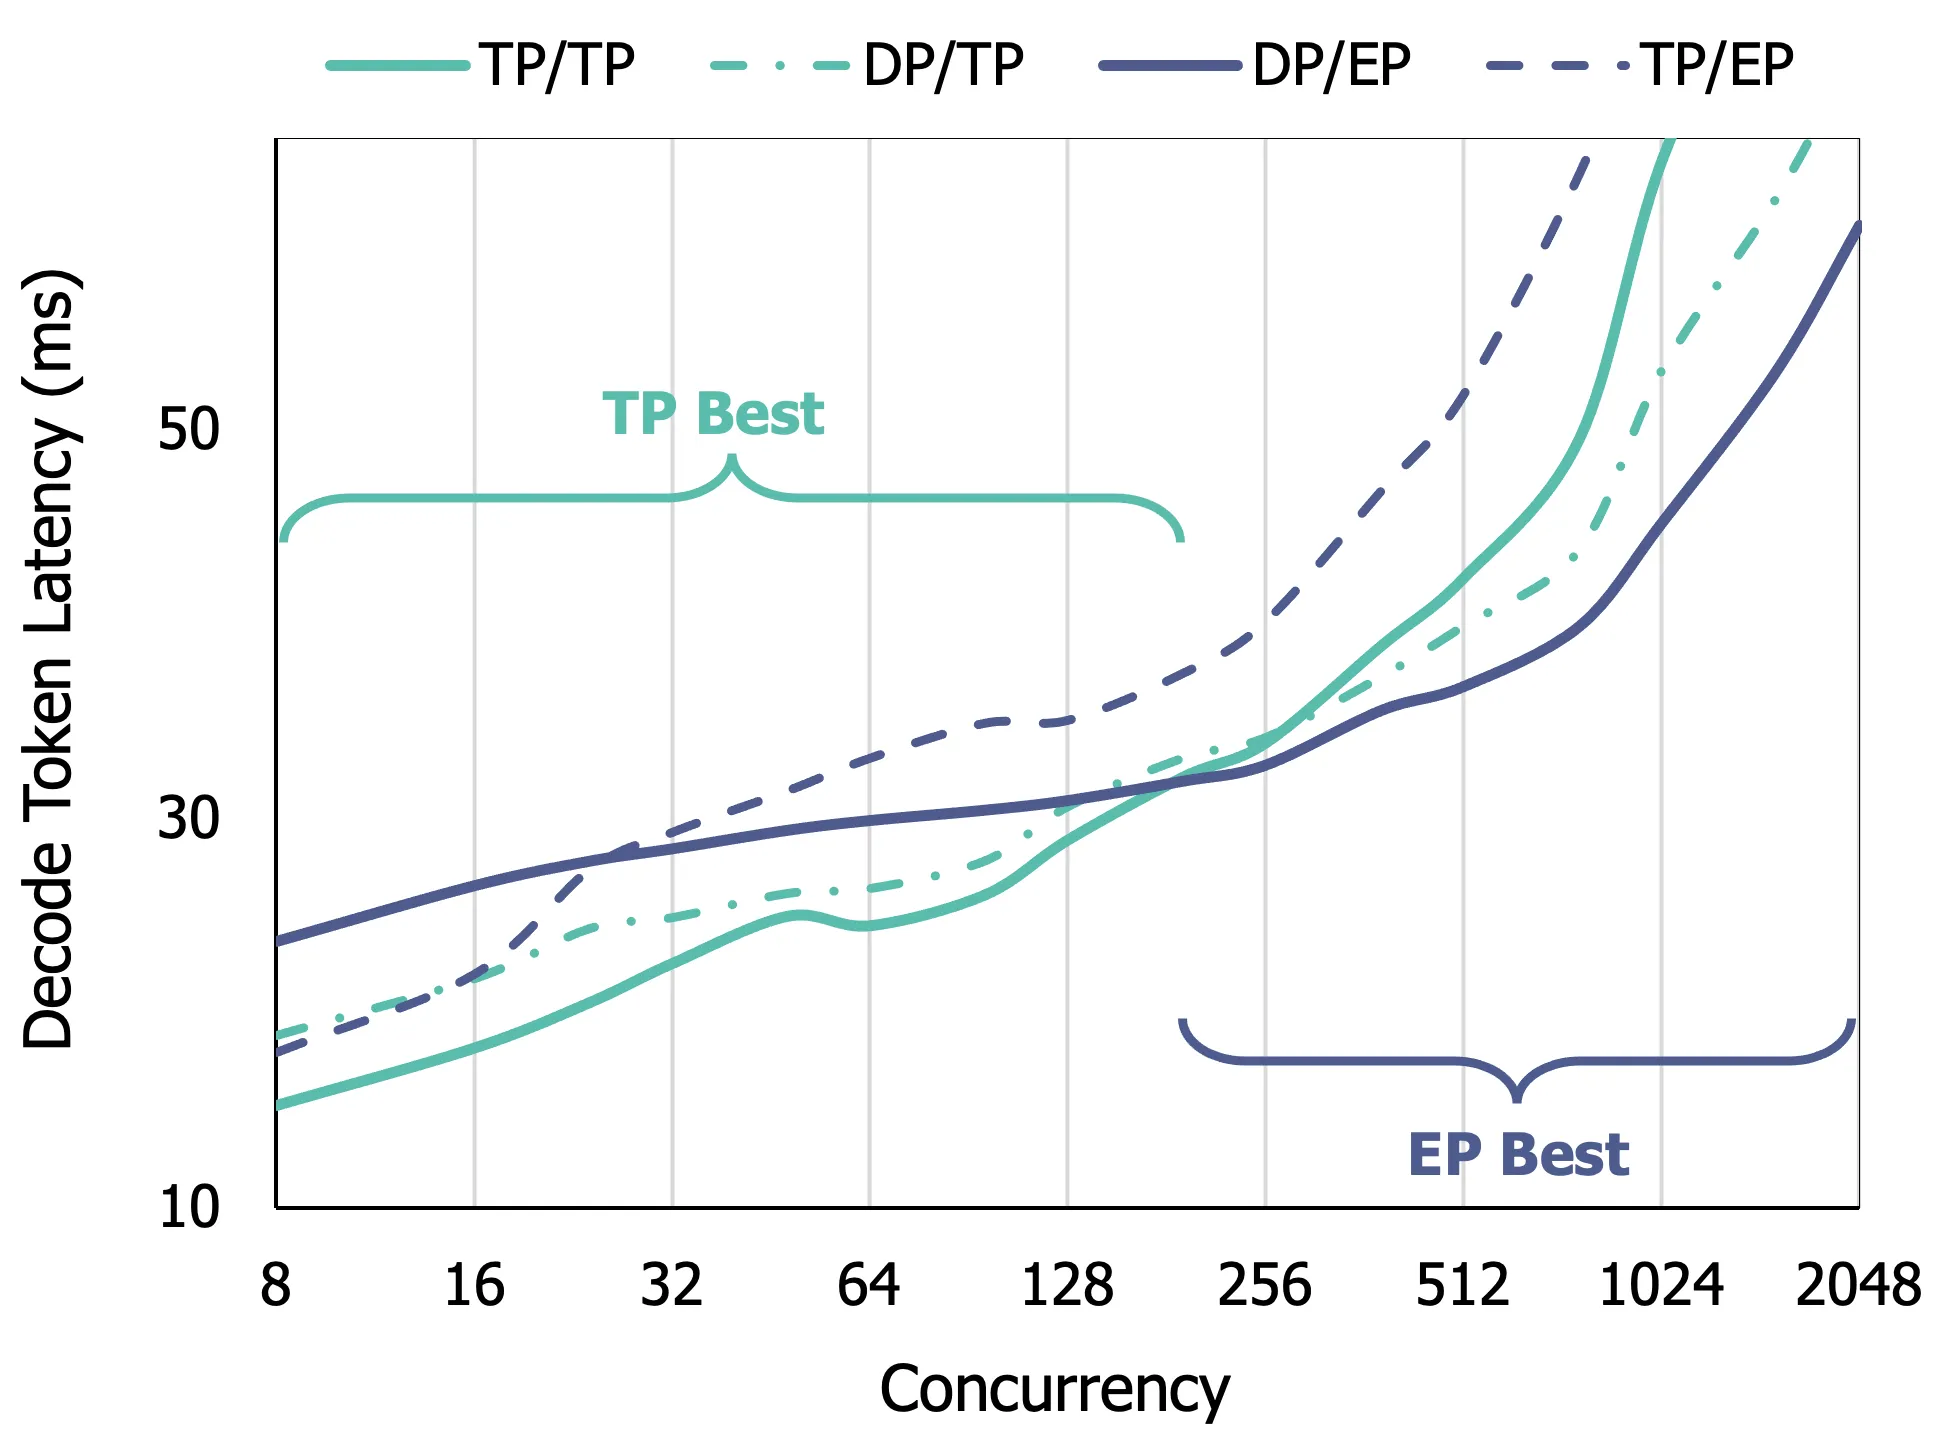
图 2:Qwen3-235B-A22B 在 8×H200 上的稳态 decode 单步时延(越低越好)。TP/TP 小 batch 优、DP/EP 大 batch 优,混合布局从不进入下包络。
边界为何存在:TP 与 EP 沿两轴对立且随 增大翻向(图 3)——① 通信:TP 逐层 All-Reduce 传整个 hidden state(随 增长),EP 的 All-to-All 只带路由 token 但有小消息 dispatch 下限( 低时主导);② MoE 计算:decode MoE GEMM 内存受限,每 rank 运行时随每 rank token 数——TP 为 、EP 为 ( 为 EP 组大小)。两轴均在小 favor TP、大 favor EP。该交叉硬件与模型无关(结构性,非模型/GPU 数产物)。
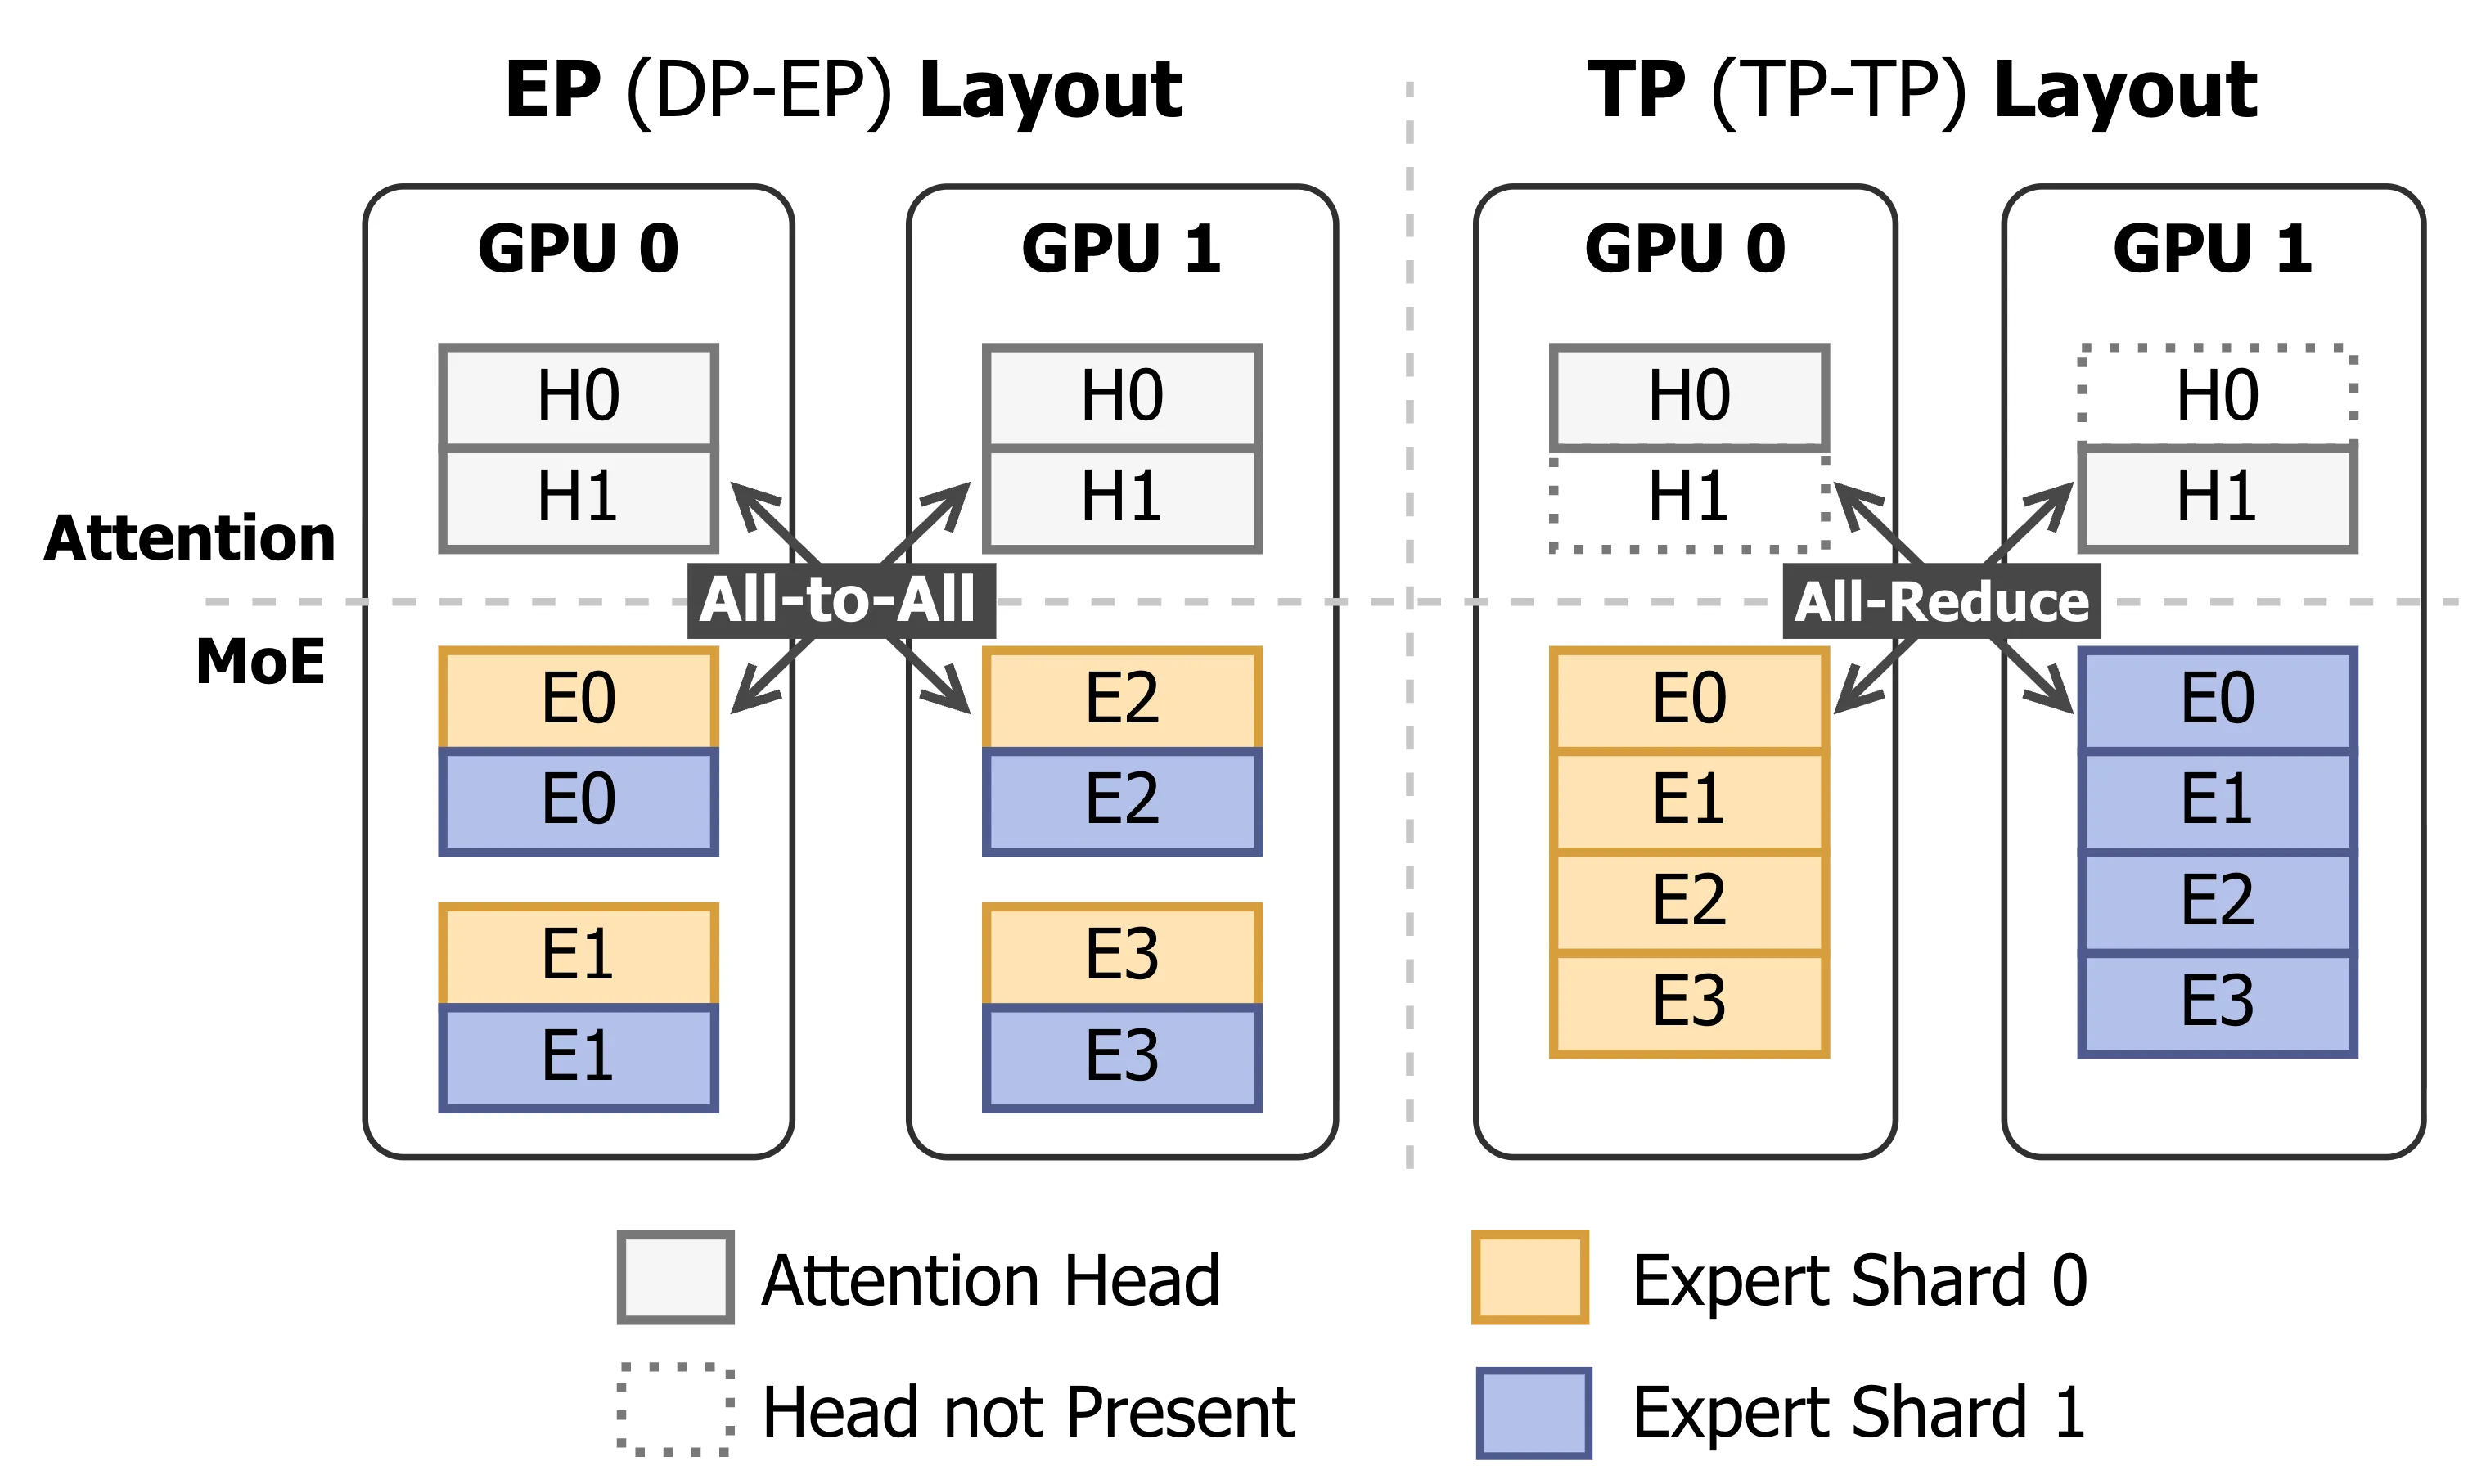
图 3:EP 与 TP 的分层布局对比。EP 跑数据并行注意力、每个完整专家留在一个 rank;TP 把注意力头与单个专家都跨 rank 分片。
3.2 真实负载跨越边界(§2.2)
- 突发在线服务:生产 trace 突发到达间隔长静默期,峰值在途数分钟内跨 2-3 个数量级,单部署反复穿越边界——EP 撑起排空 burst 的吞吐、TP 交付静默期交互所需的单 token 时延;
- RL rollout:GRPO/DAPO 交错策略更新与 rollout 步,每步是一个服务负载——提交一批 prompt、每 prompt 采样多次、全部解码到完成才更新权重,burst 峰值见数千在途请求;输出长度跨请求差异逾一个数量级(推理链在不同点终止),故活跃 batch 从边界之上开始、衰减穿越、滞留于 straggler 长尾。同步/异步/partial rollout 各框架处理长尾不同,但都不减轻生成引擎所见的 burst-to-tail 衰减。
3.3 已有切换方案不迁移到 MoE(§2.3)
稠密模型系统假设三点均被 MoE 否定:权重不常驻(稠密 TP shard 是 DP 副本的 切片,留副本即拥有全部 TP shard 无需重分片;但 MoE 专家沿正交轴切分不共享字节);引擎不可排空(须携 decode batch 及分页 KV 跨 EP/TP 注意力布局而不丢工作);runtime 重建昂贵(各布局 attention 元数据、通信 buffer、CUDA graph 重建需数十秒并阻塞每个请求)。
四、自适应并行(§3)
核心观察:EP↔TP 切换只改变所有权——权重、在途请求、KV 值切换前后跨所有 rank 完全相同,变的只是「哪个 rank 拥有哪片」与「每 rank 后续步用哪种模式视图」。
4.1 权重重分片(§3.1)
设 专家总数、 切换组 rank 数、 隐藏维、 专家中间维。EP 下每 rank 拥有 个完整专家( 形状 , 形状 );TP 下每 rank 拥有每个专家的一个 shard( 形状 , 形状 )。重分片分三潜在阶段——local permute(把出站字节打包成每目标 peer 一块连续)、All-to-All(跨全局通信组转移所有权)、local scatter(把入站字节写入目标布局)。权重重分片任一方向只需两阶段(图 4):EP→TP 先 permute 后 exchange;TP→EP 先 exchange 后 permute。注意力权重小,默认两布局驻留、指针交换切换(每 rank 多付一份重复头 shard);省显存变体只保活跃布局、TP→EP 用 All-Gather 重建。
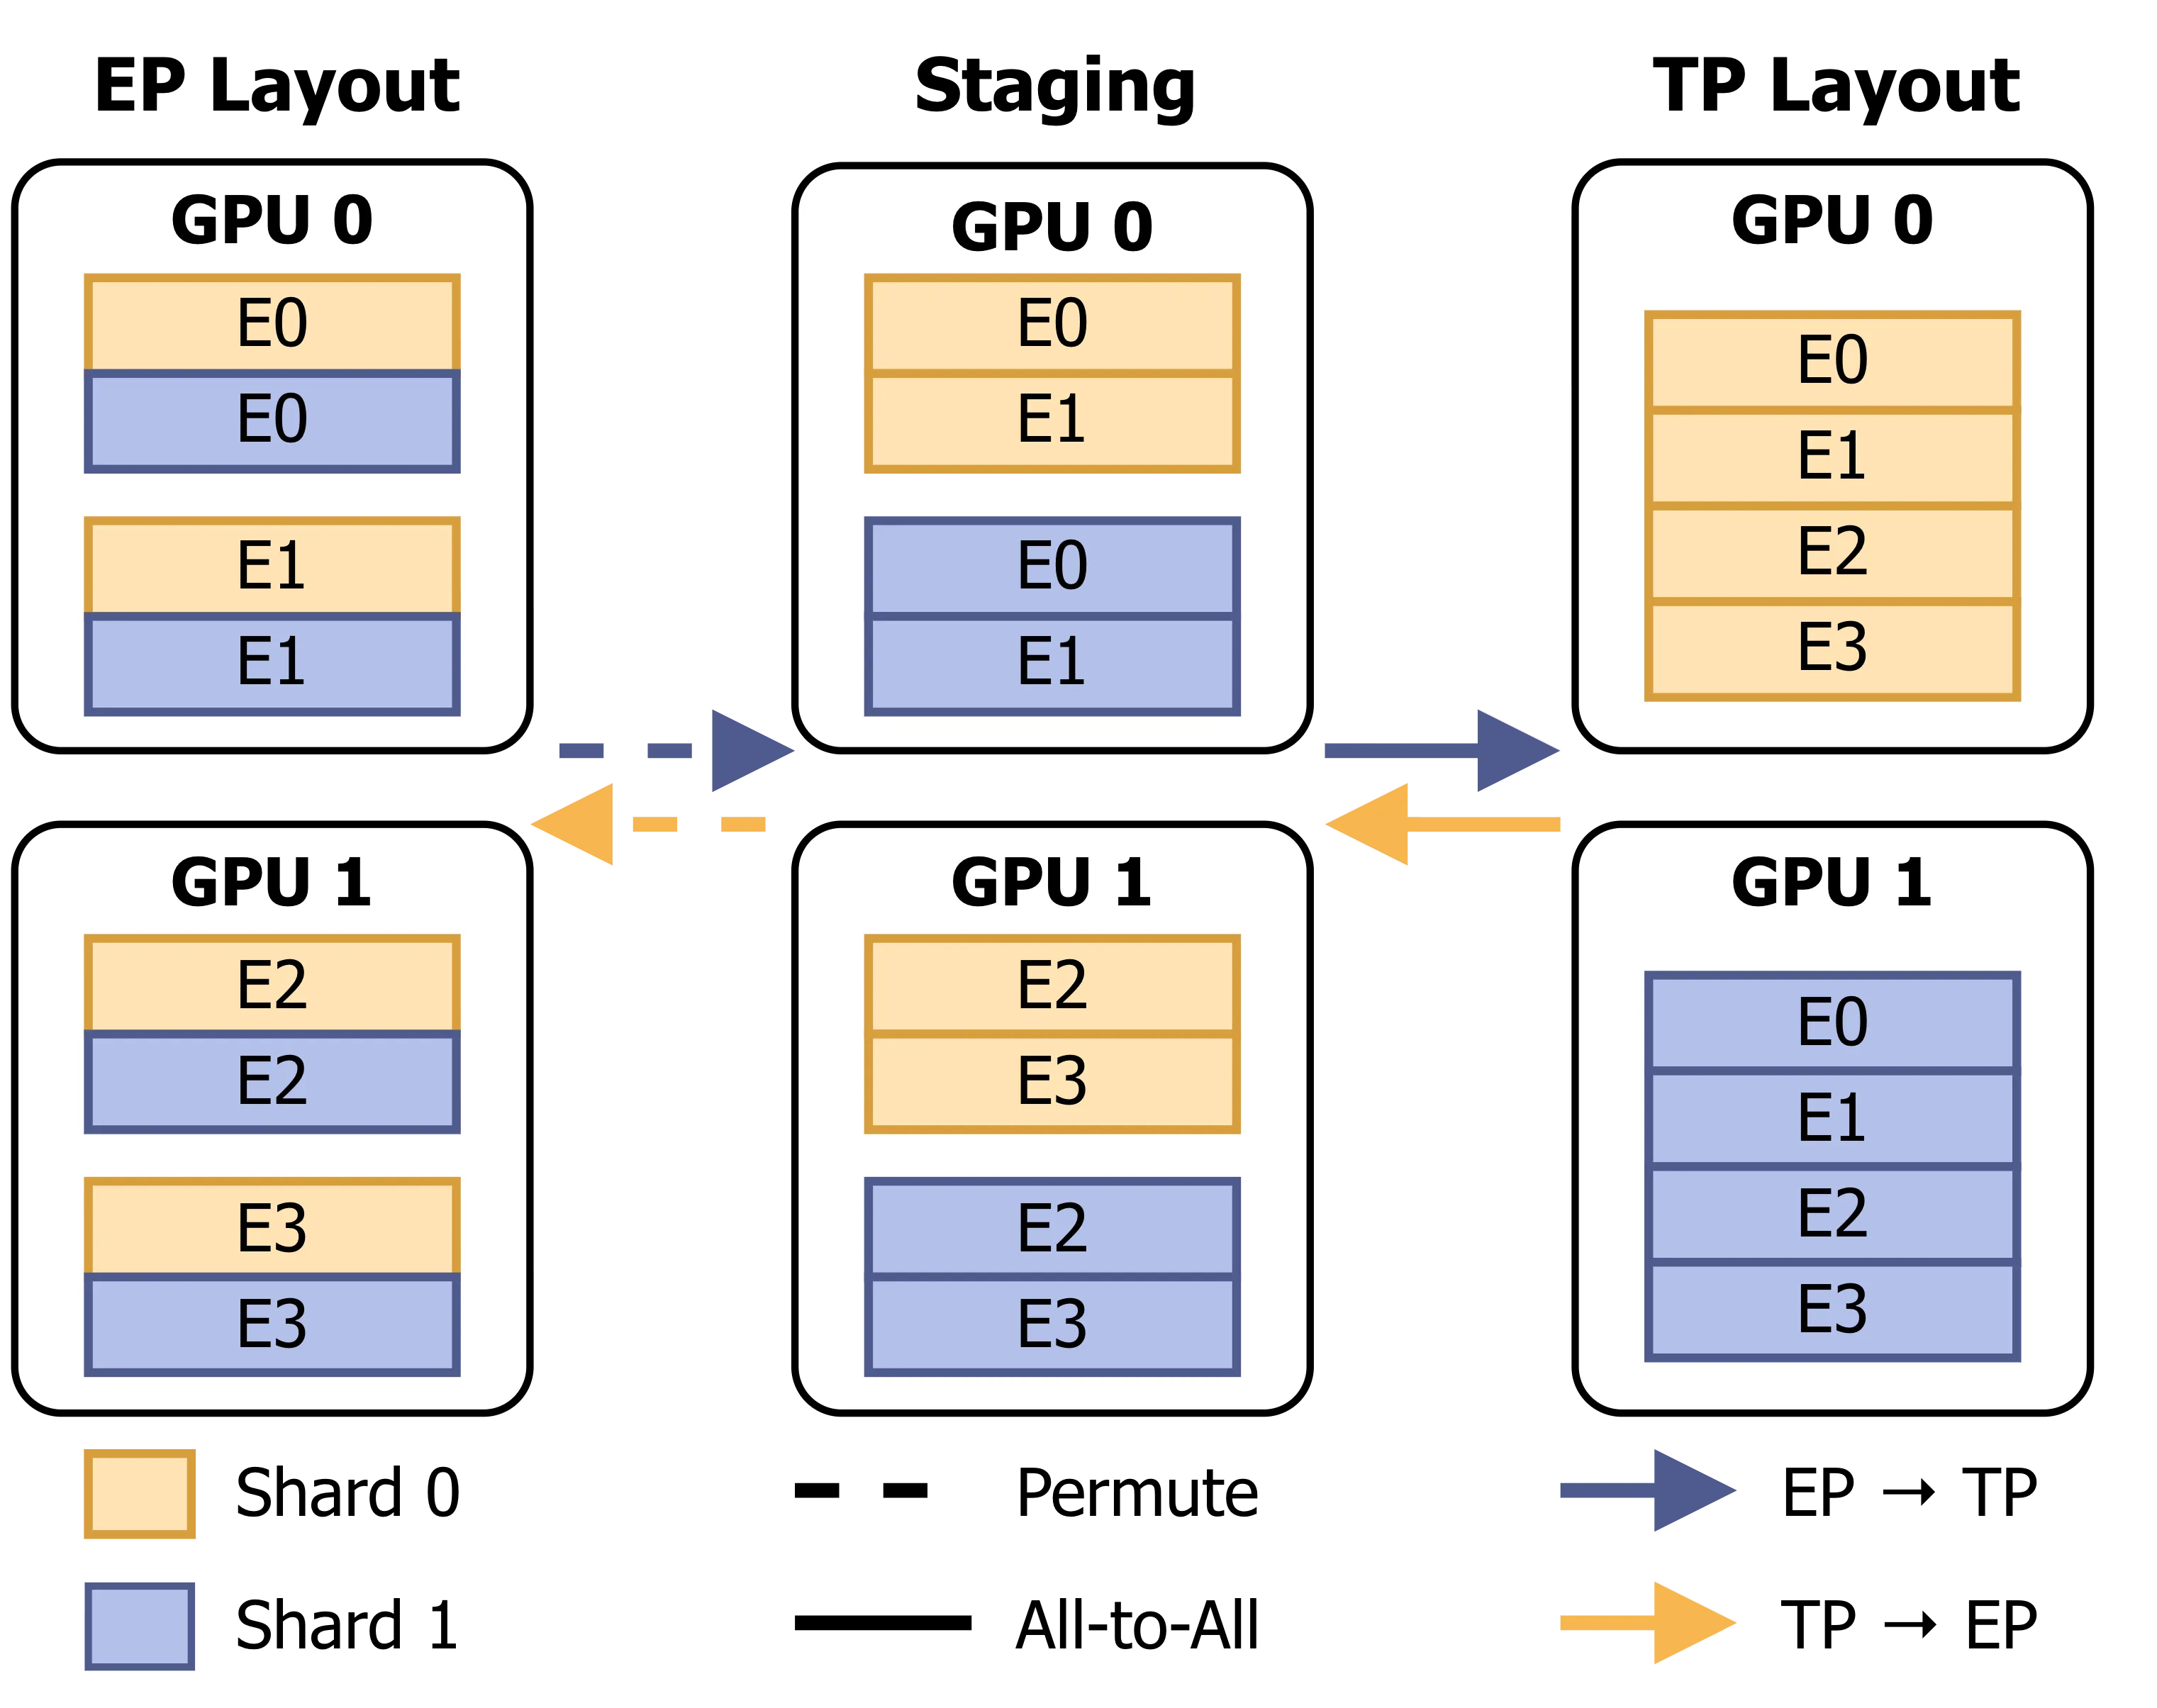
图 4:切换时的专家权重重分片。EP→TP 把本地专家打包成每 peer 块后一次 All-to-All;TP→EP 先交换数据再本地重构完整专家。
4.2 请求重分布(§3.2)
请求与其 KV cache 跟随注意力布局。EP 下每 rank 拥有互不相交的在途请求子集、存其所有头的 KV;TP 下每 rank 服务每个请求但只存其 KV 头切片(图 5)。当 KV 头少于 rank 数时 TP 跨 rank 组复制头(如 Qwen3 的 4 个 KV 头在 TP-8 下每头 2 rank)。
- EP→TP:先用元数据 All-Gather 重分配请求所有权(各 rank 贡献 running/waiting 请求,所有 rank 构造相同有序在途列表),再按注意力头重分 KV cache(每 rank 得每请求的一个头 shard);
- 分页 attention 复杂化:KV 存于共享池固定大小块、token 占非连续槽由 page table 追踪。Moebius 读 page table 预算一个覆盖每 rank 须发送 token 的索引向量,把散乱槽聚成每 peer 连续块,一次 All-to-All 交换,散射入 TP 下重分配的目标页(KV 传输保留全部三阶段,因分页散射源与目标);
- TP→EP:把全局请求列表按序列长度降序、贪心放到最少负载 rank(确定性启发式,各 rank 无通信算出相同划分)。
切换在迭代间 decode 暂停时跨 rank 同步运行,请求元数据/采样状态/KV 值一起迁移,无请求被丢弃、各请求在同一位置恢复解码。
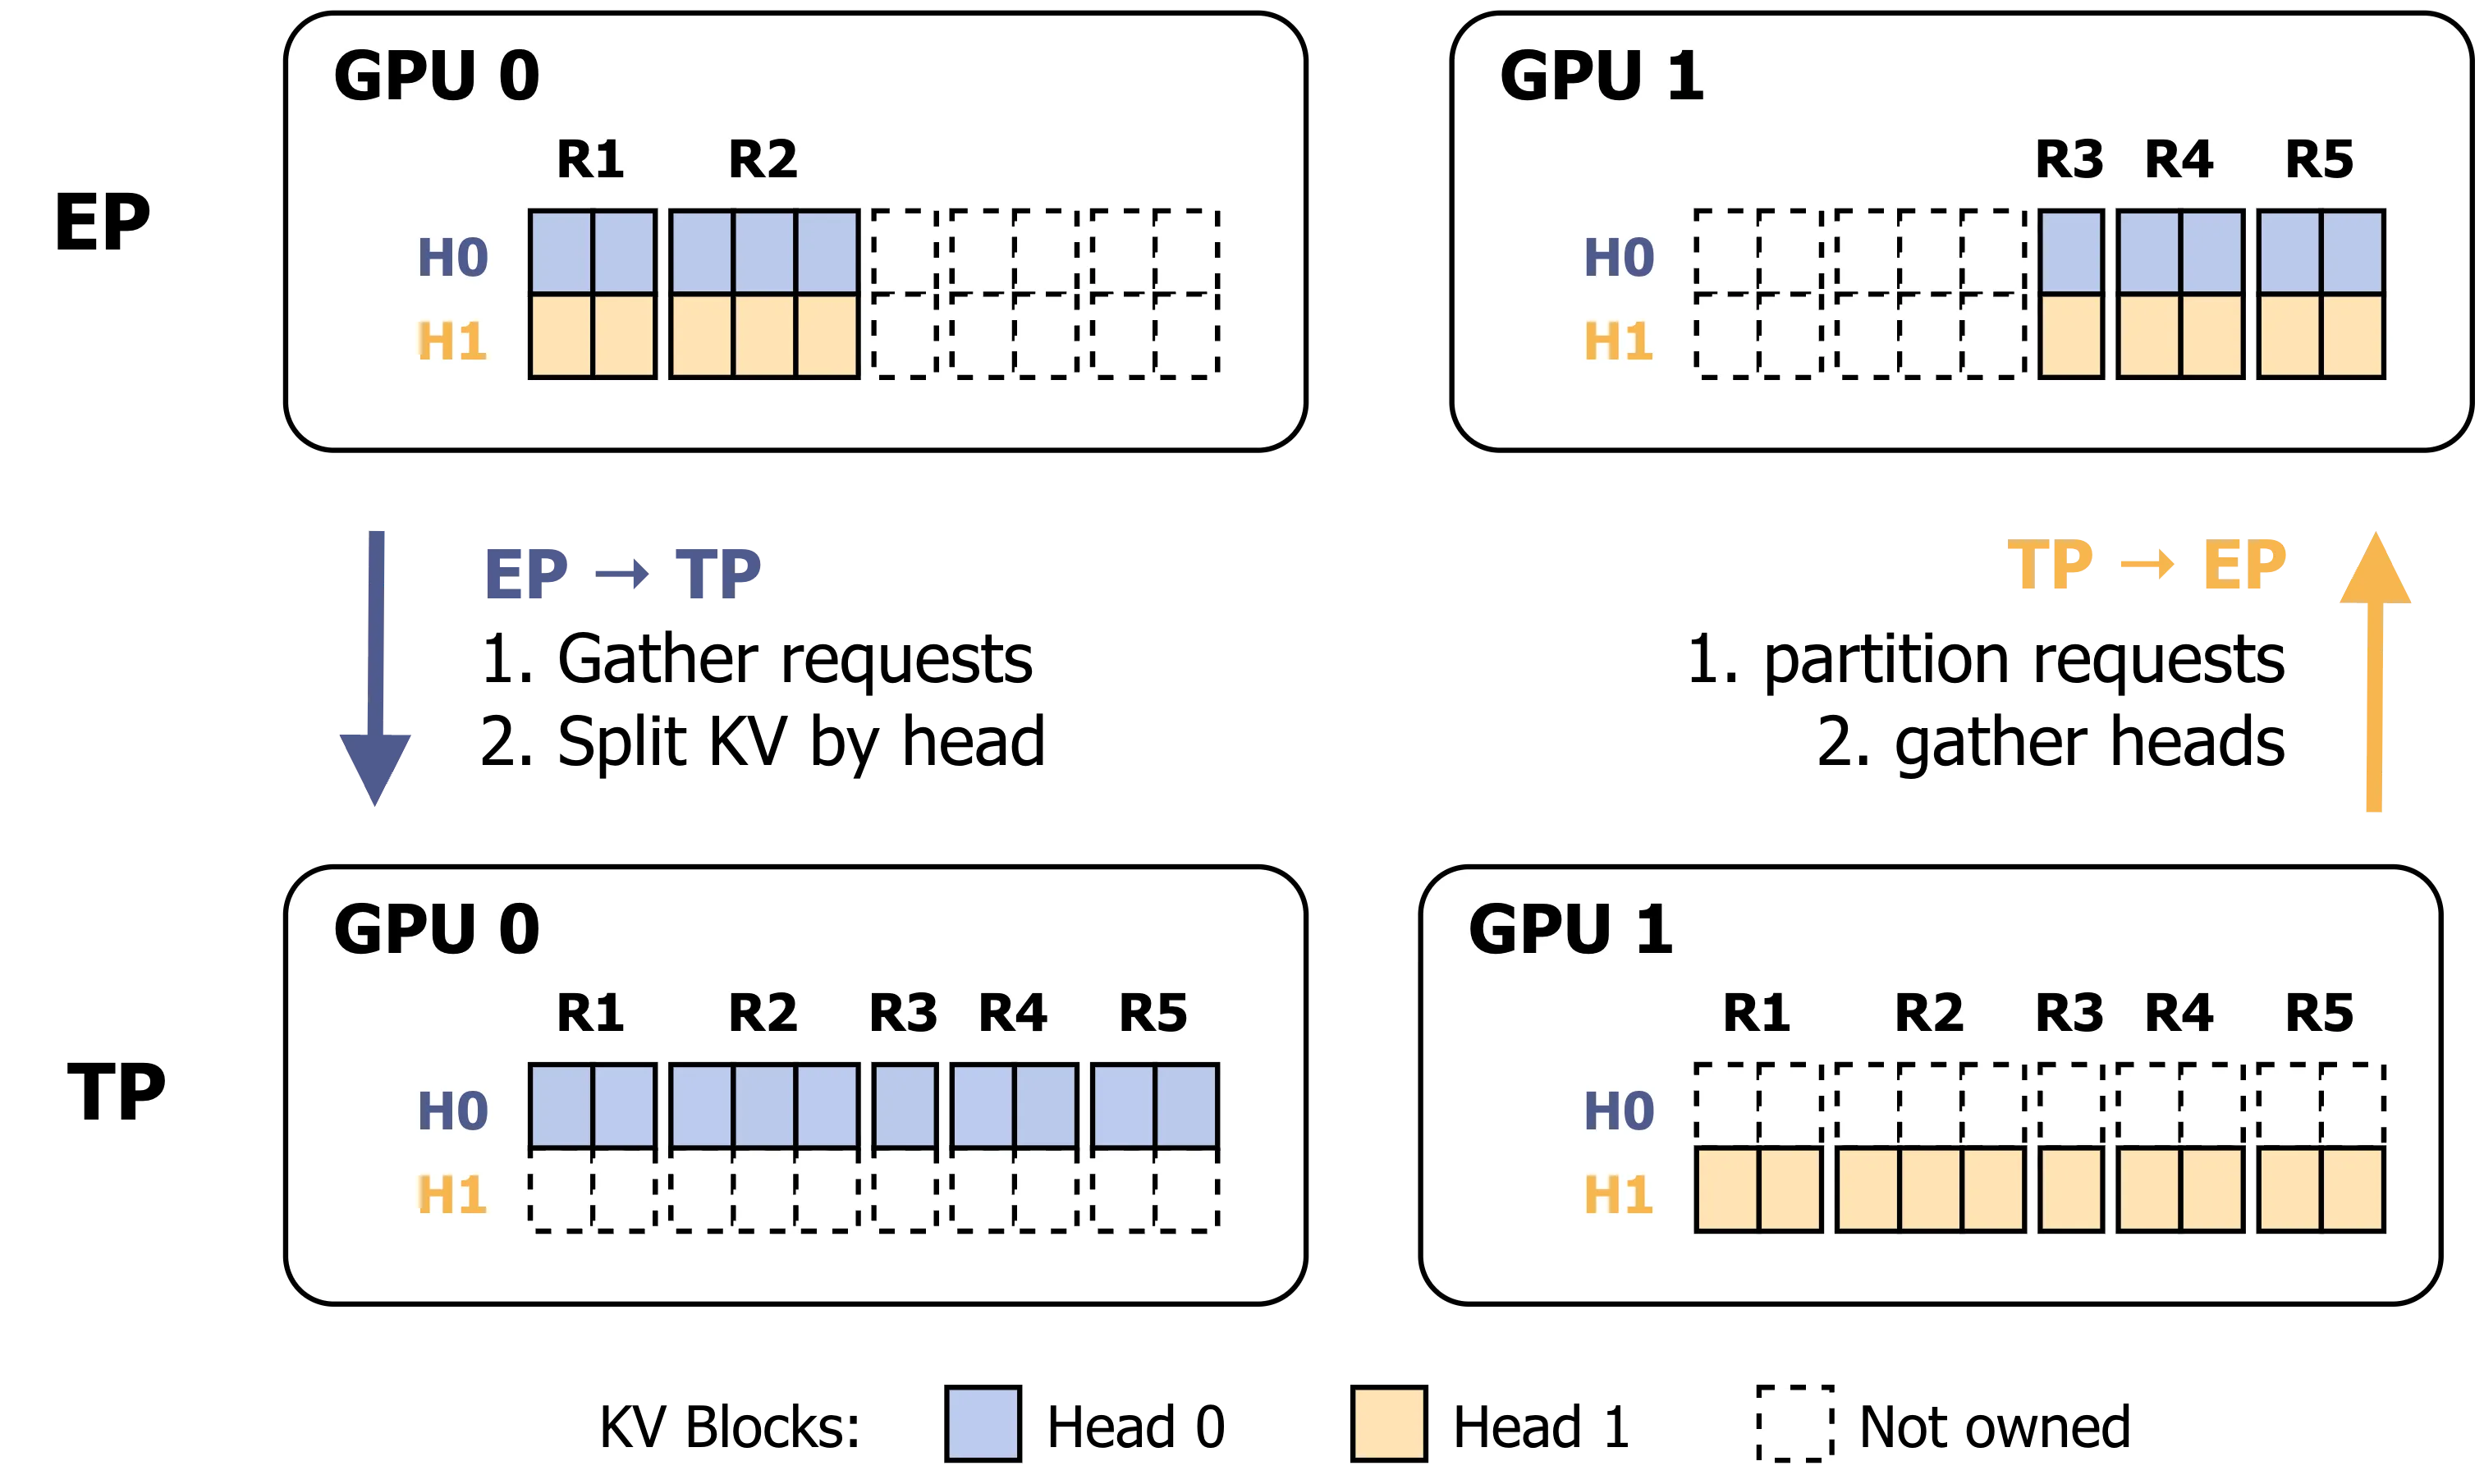
图 5:EP→TP 切换的请求与 KV cache 重分布。请求变为跨 TP rank 共享,分页 KV 块按注意力头重分区;TP→EP 反转映射。
五、系统设计(§4)
5.1 架构总览(§4.1)
中心化 API server 接纳请求并分派到每 rank scheduler,每 scheduler 含四组件:switch coordinator(选目标模式)、request manager(追踪请求元数据与 KV 所有权)、execution engine(跑活跃 EP/TP 前向)、memory manager(拥有 GPU 常驻权重/KV/传输暂存)。切换在连续前向步之间运行:每步前 rank 0 的 coordinator 按策略决定是否切换并广播,触发时所有 rank 一起进入过渡,完成后在新布局下恢复解码。
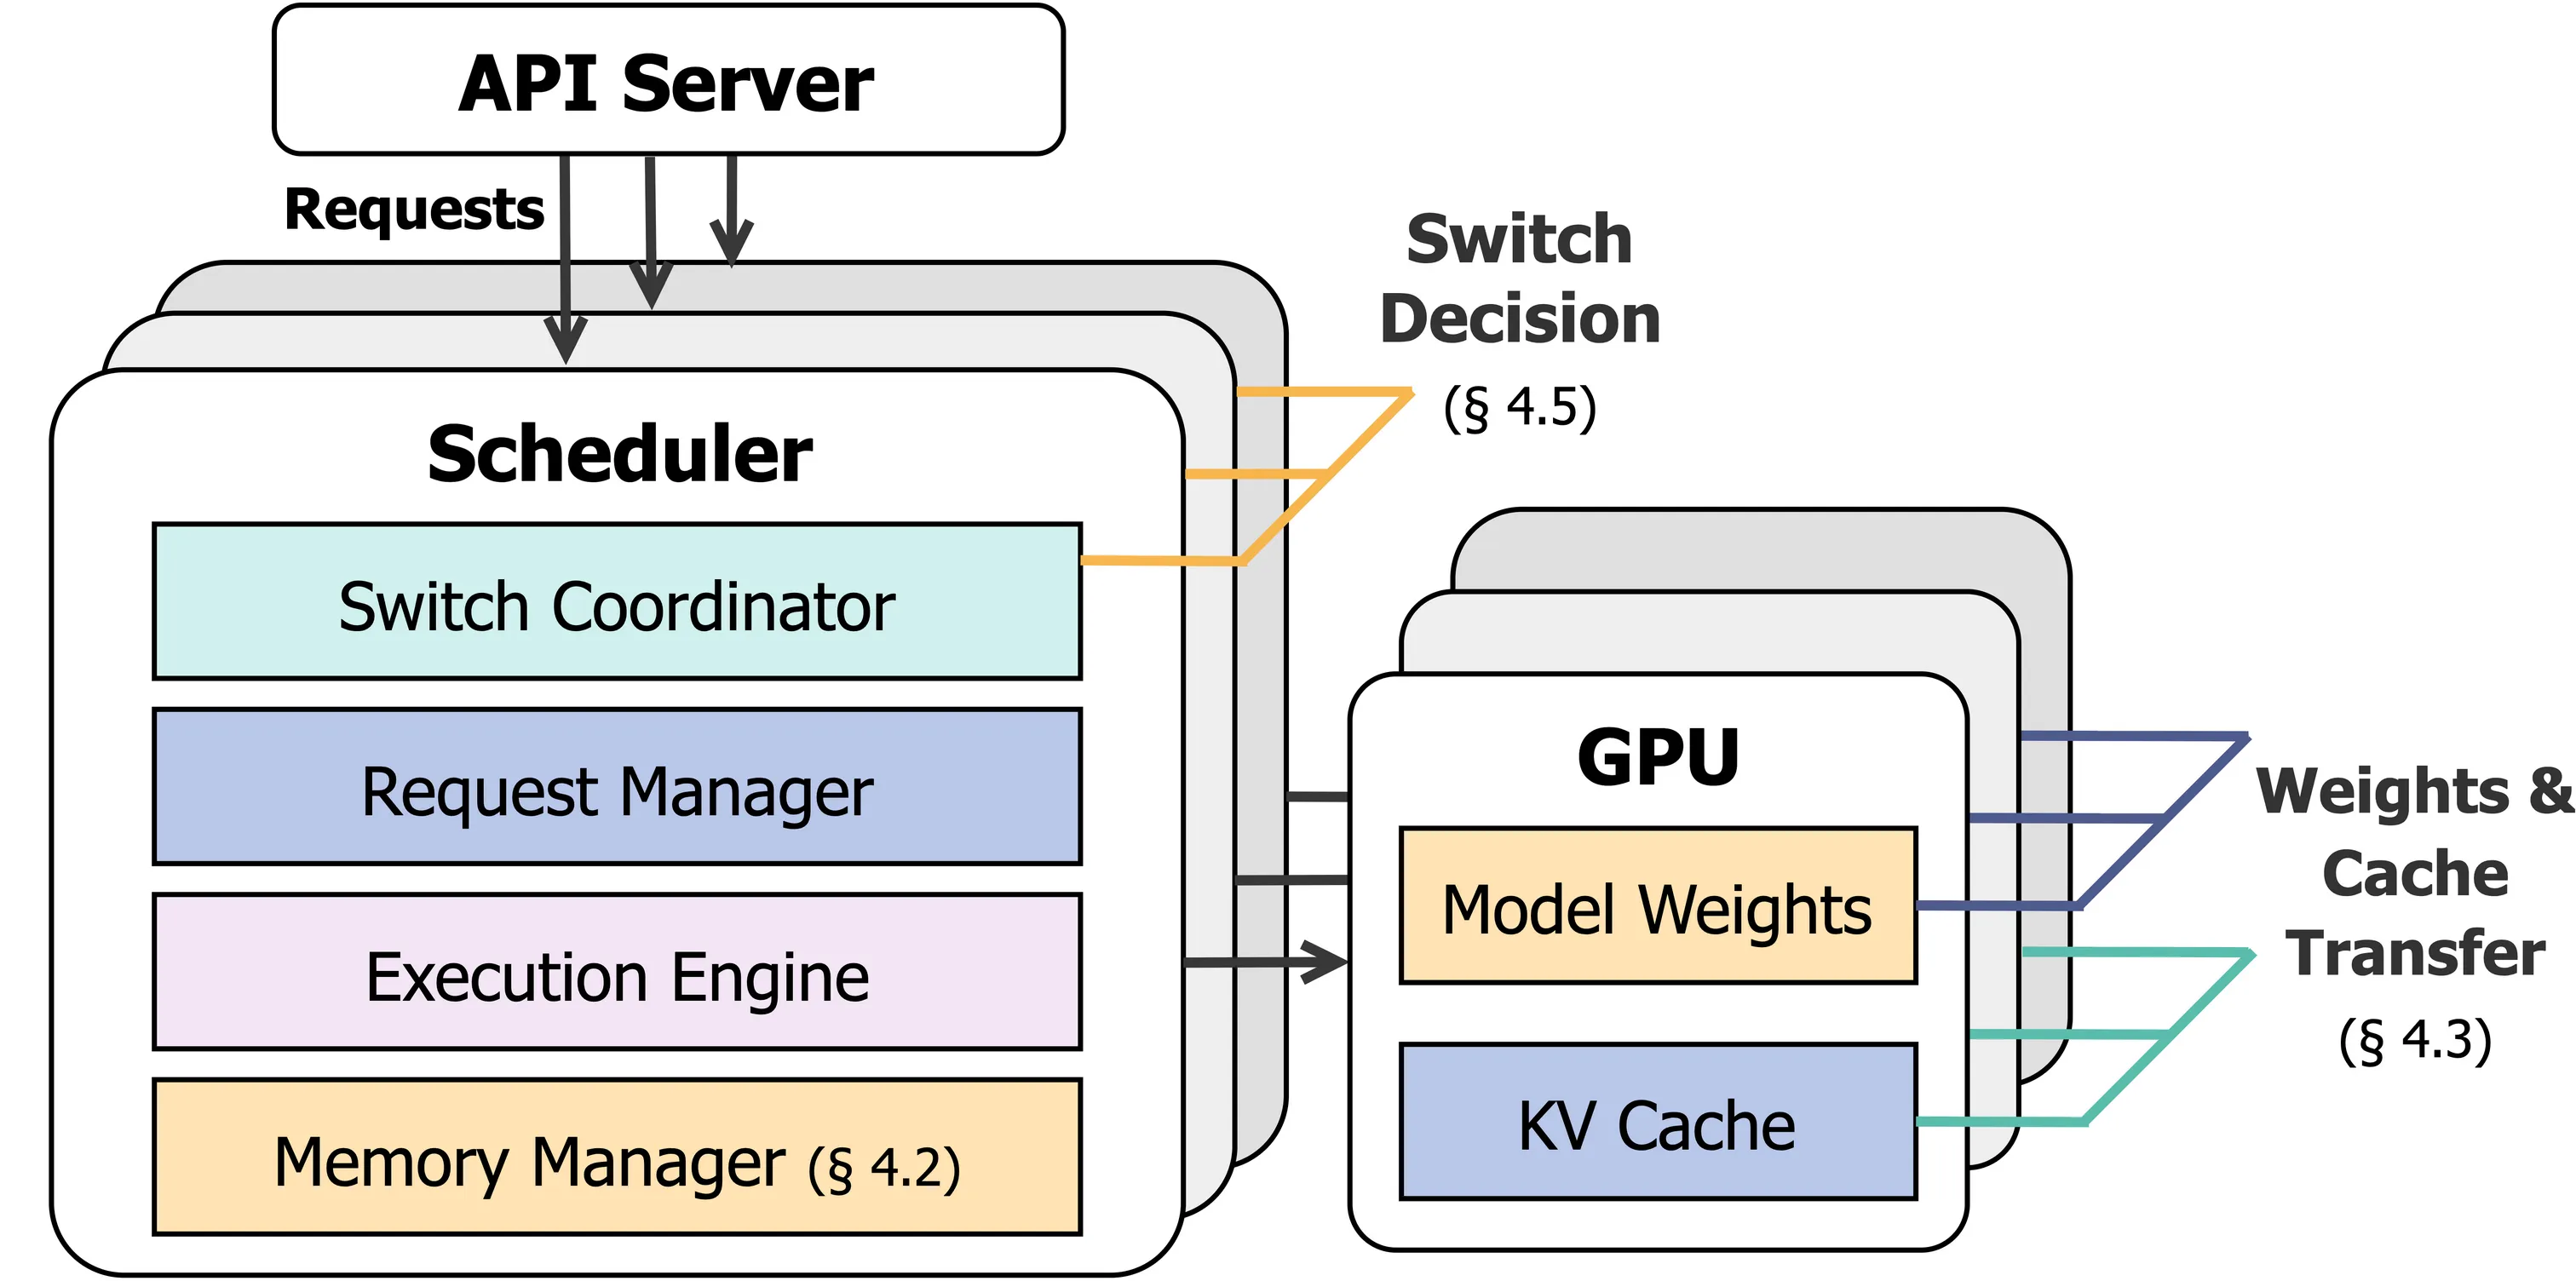
图 6:Moebius 架构。coordinator 决定切换,GPU 持有专家权重与 KV cache,Moebius 跨 GPU 互连重分片而无第二份副本。
5.2 统一内存管理器 UMM(§4.2)
每 rank 启动时分配一大块连续 GPU 统一缓冲,所有长寿命切换状态(专家权重、注意力权重、KV 页)作为该缓冲的固定区域张量视图。对专家权重,UMM 分成固定大小每层槽位,建两套张量视图(TP 与 EP)别名同一 rank 本地后备缓冲。为在原地重分片安全,多留一个槽: 层时 TP 把层 映射到槽 、EP 映射到槽 (图 7),一槽偏移给每层分离的源/目标槽,方向特定层序避免覆写未读旧内容(EP→TP 顺序、TP→EP 逆序)。
由此三大切换路径特性:① 切换不动态分配(目标槽/KV 页已存在,避免触发 PyTorch GC 延迟);② 统一缓冲从不移动,每 rank 一次性导出为 CUDA IPC,peer GPU 经 NVLink 直写目标槽;③ 每模式张量保持固定设备地址,分别捕获的 EP/TP CUDA graph 跨切换仍有效。
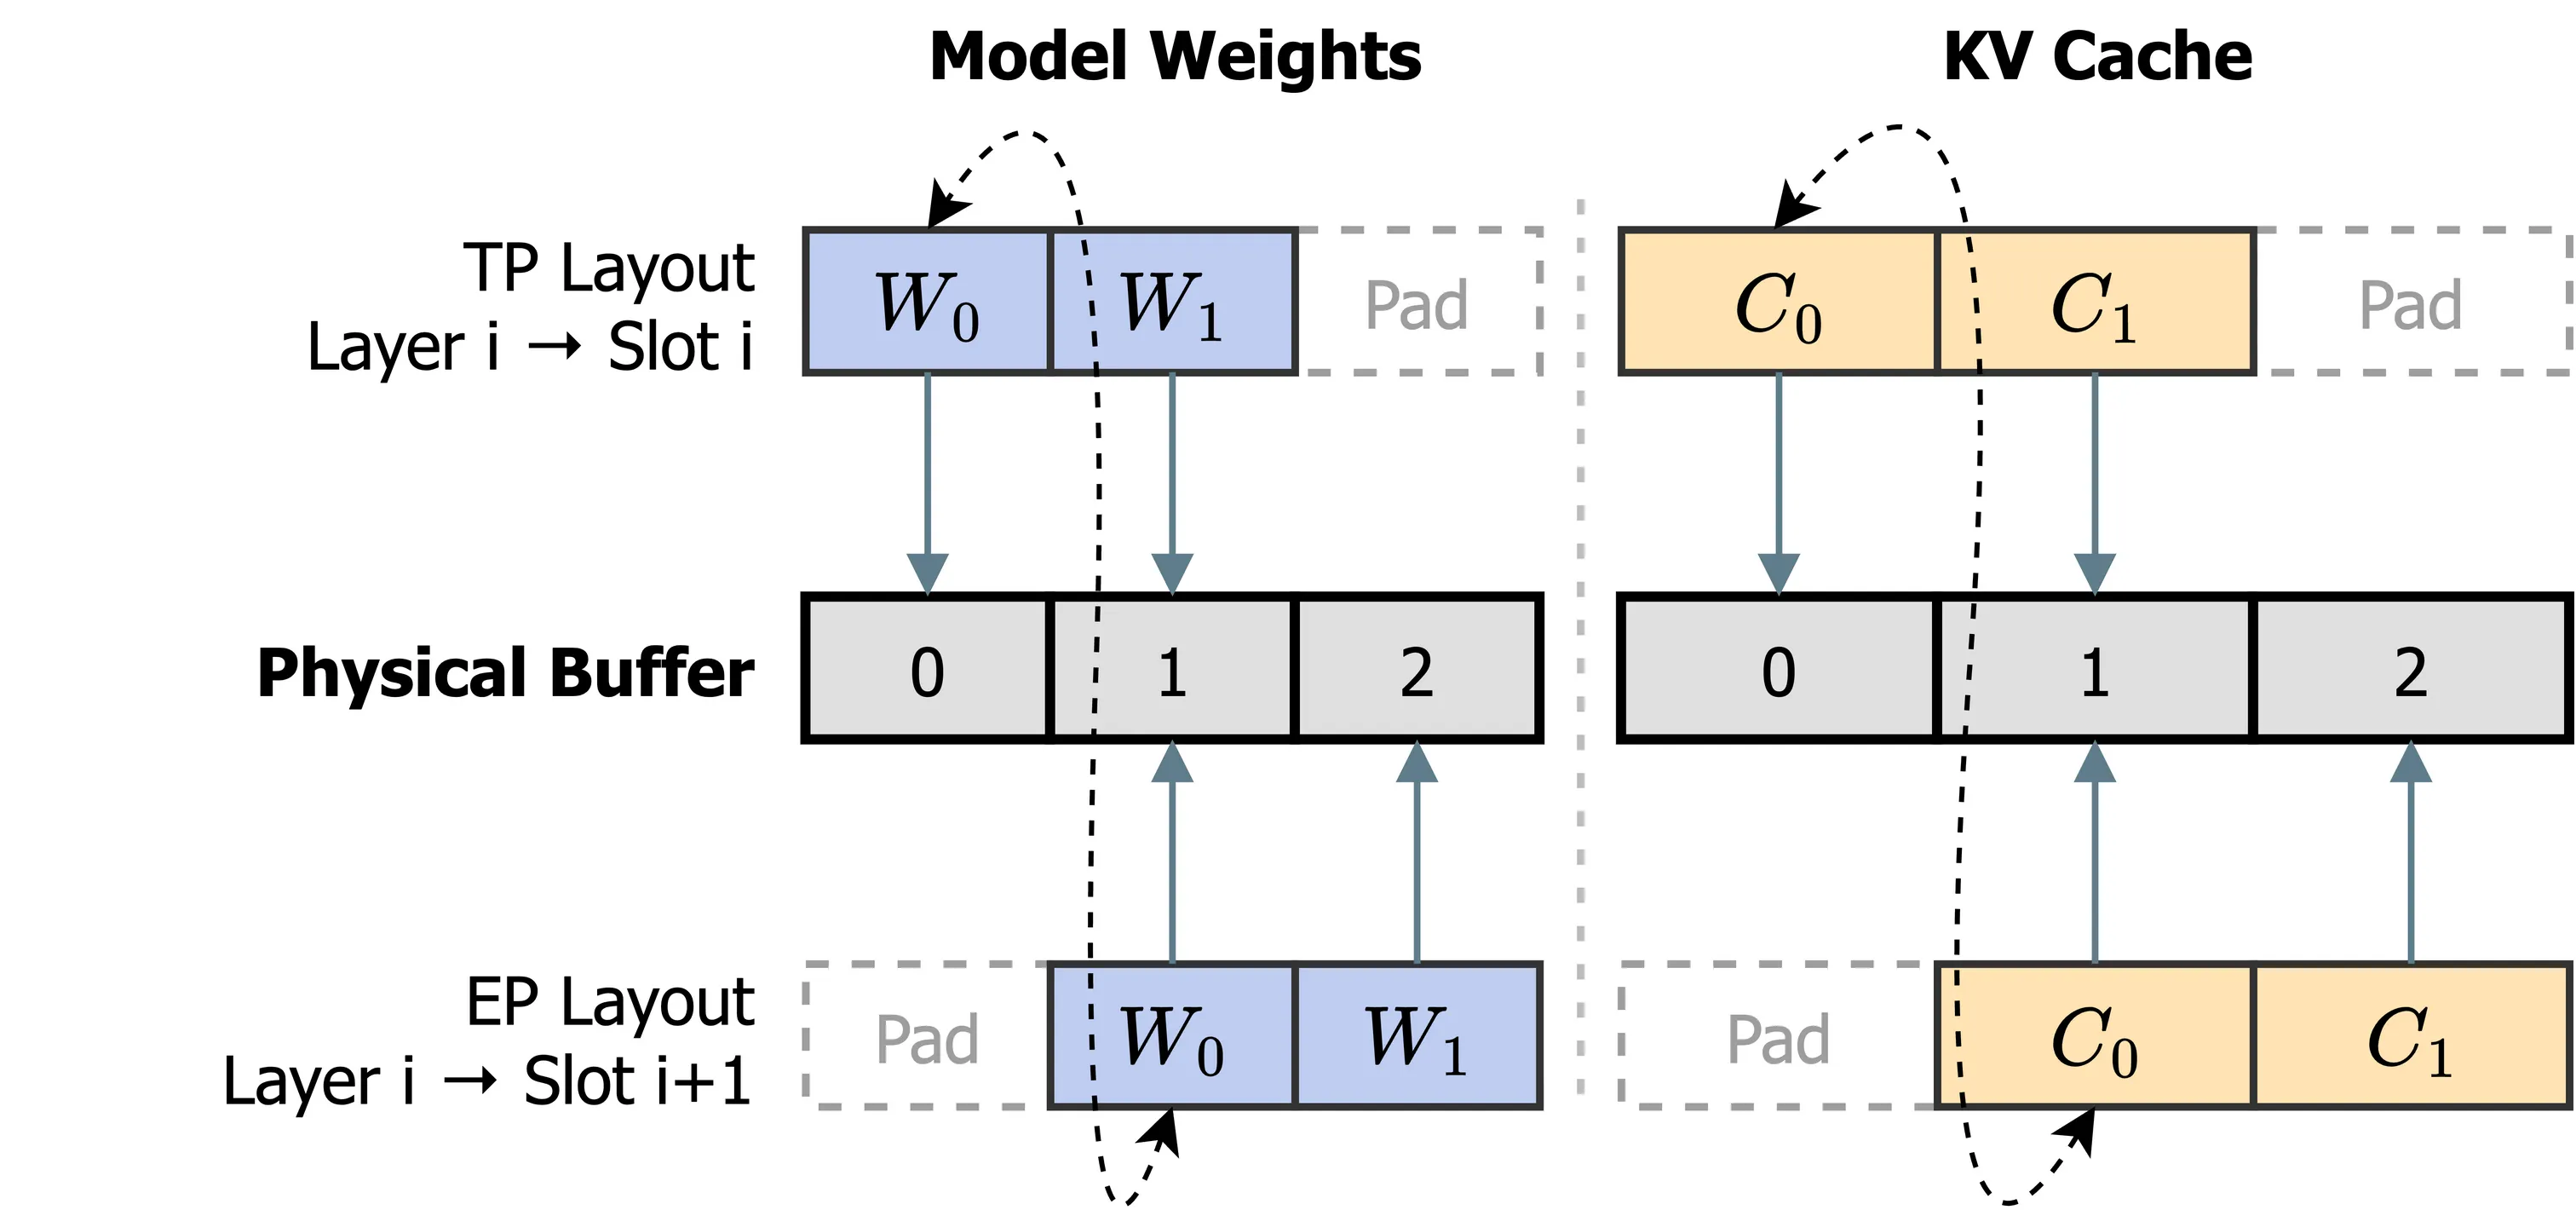
图 7:统一内存管理器。每 rank 分配一大 GPU 缓冲,权重/KV 页/请求缓冲/传输暂存皆为其张量视图;专家权重留 N+1 槽,TP 层 i→槽 i、EP 层 i→槽 i+1,一槽偏移给重分片分离的源目标槽。
5.3 融合直传 kernel(§4.3)
朴素实现把 gather/exchange/scatter 映射到 NCCL collective(每层暂存每 peer 块、经 All-to-All 同步),正确但慢:多次触碰 HBM、需每活跃层暂存缓冲、每层 All-to-All。Moebius 改用直传 CUDA kernel 库:UMM 给每 rank 固定后备地址,一次性导出 IPC handle 并映射 peer 缓冲入自身地址空间。专家权重 kernel 从源模式别名读、经 NVLink 写入 peer 目标模式槽;KV kernel 读 live 请求 page table、经其读散乱源块、直写 peer 目标页。两类 kernel 都把暂存/交换/散射塌缩为对最终目的地的直写,不物化每 peer 中间块、不逐层 All-to-All、不动态分配。
Table 1 量化数据移动:NCCL 权重 2 读+1 写 HBM、cache 额外读写(散乱页先聚连续);融合直传单次 pass(权重/cache 均 1 HBM 读 + 1 NVLink 直写 peer 槽,零暂存缓冲,复用 UMM 那个额外目标槽)。KV kernel 从当前请求元数据构建 page-indexed 工作描述符(因 KV 流量细粒度、各 rank token 数不均)。
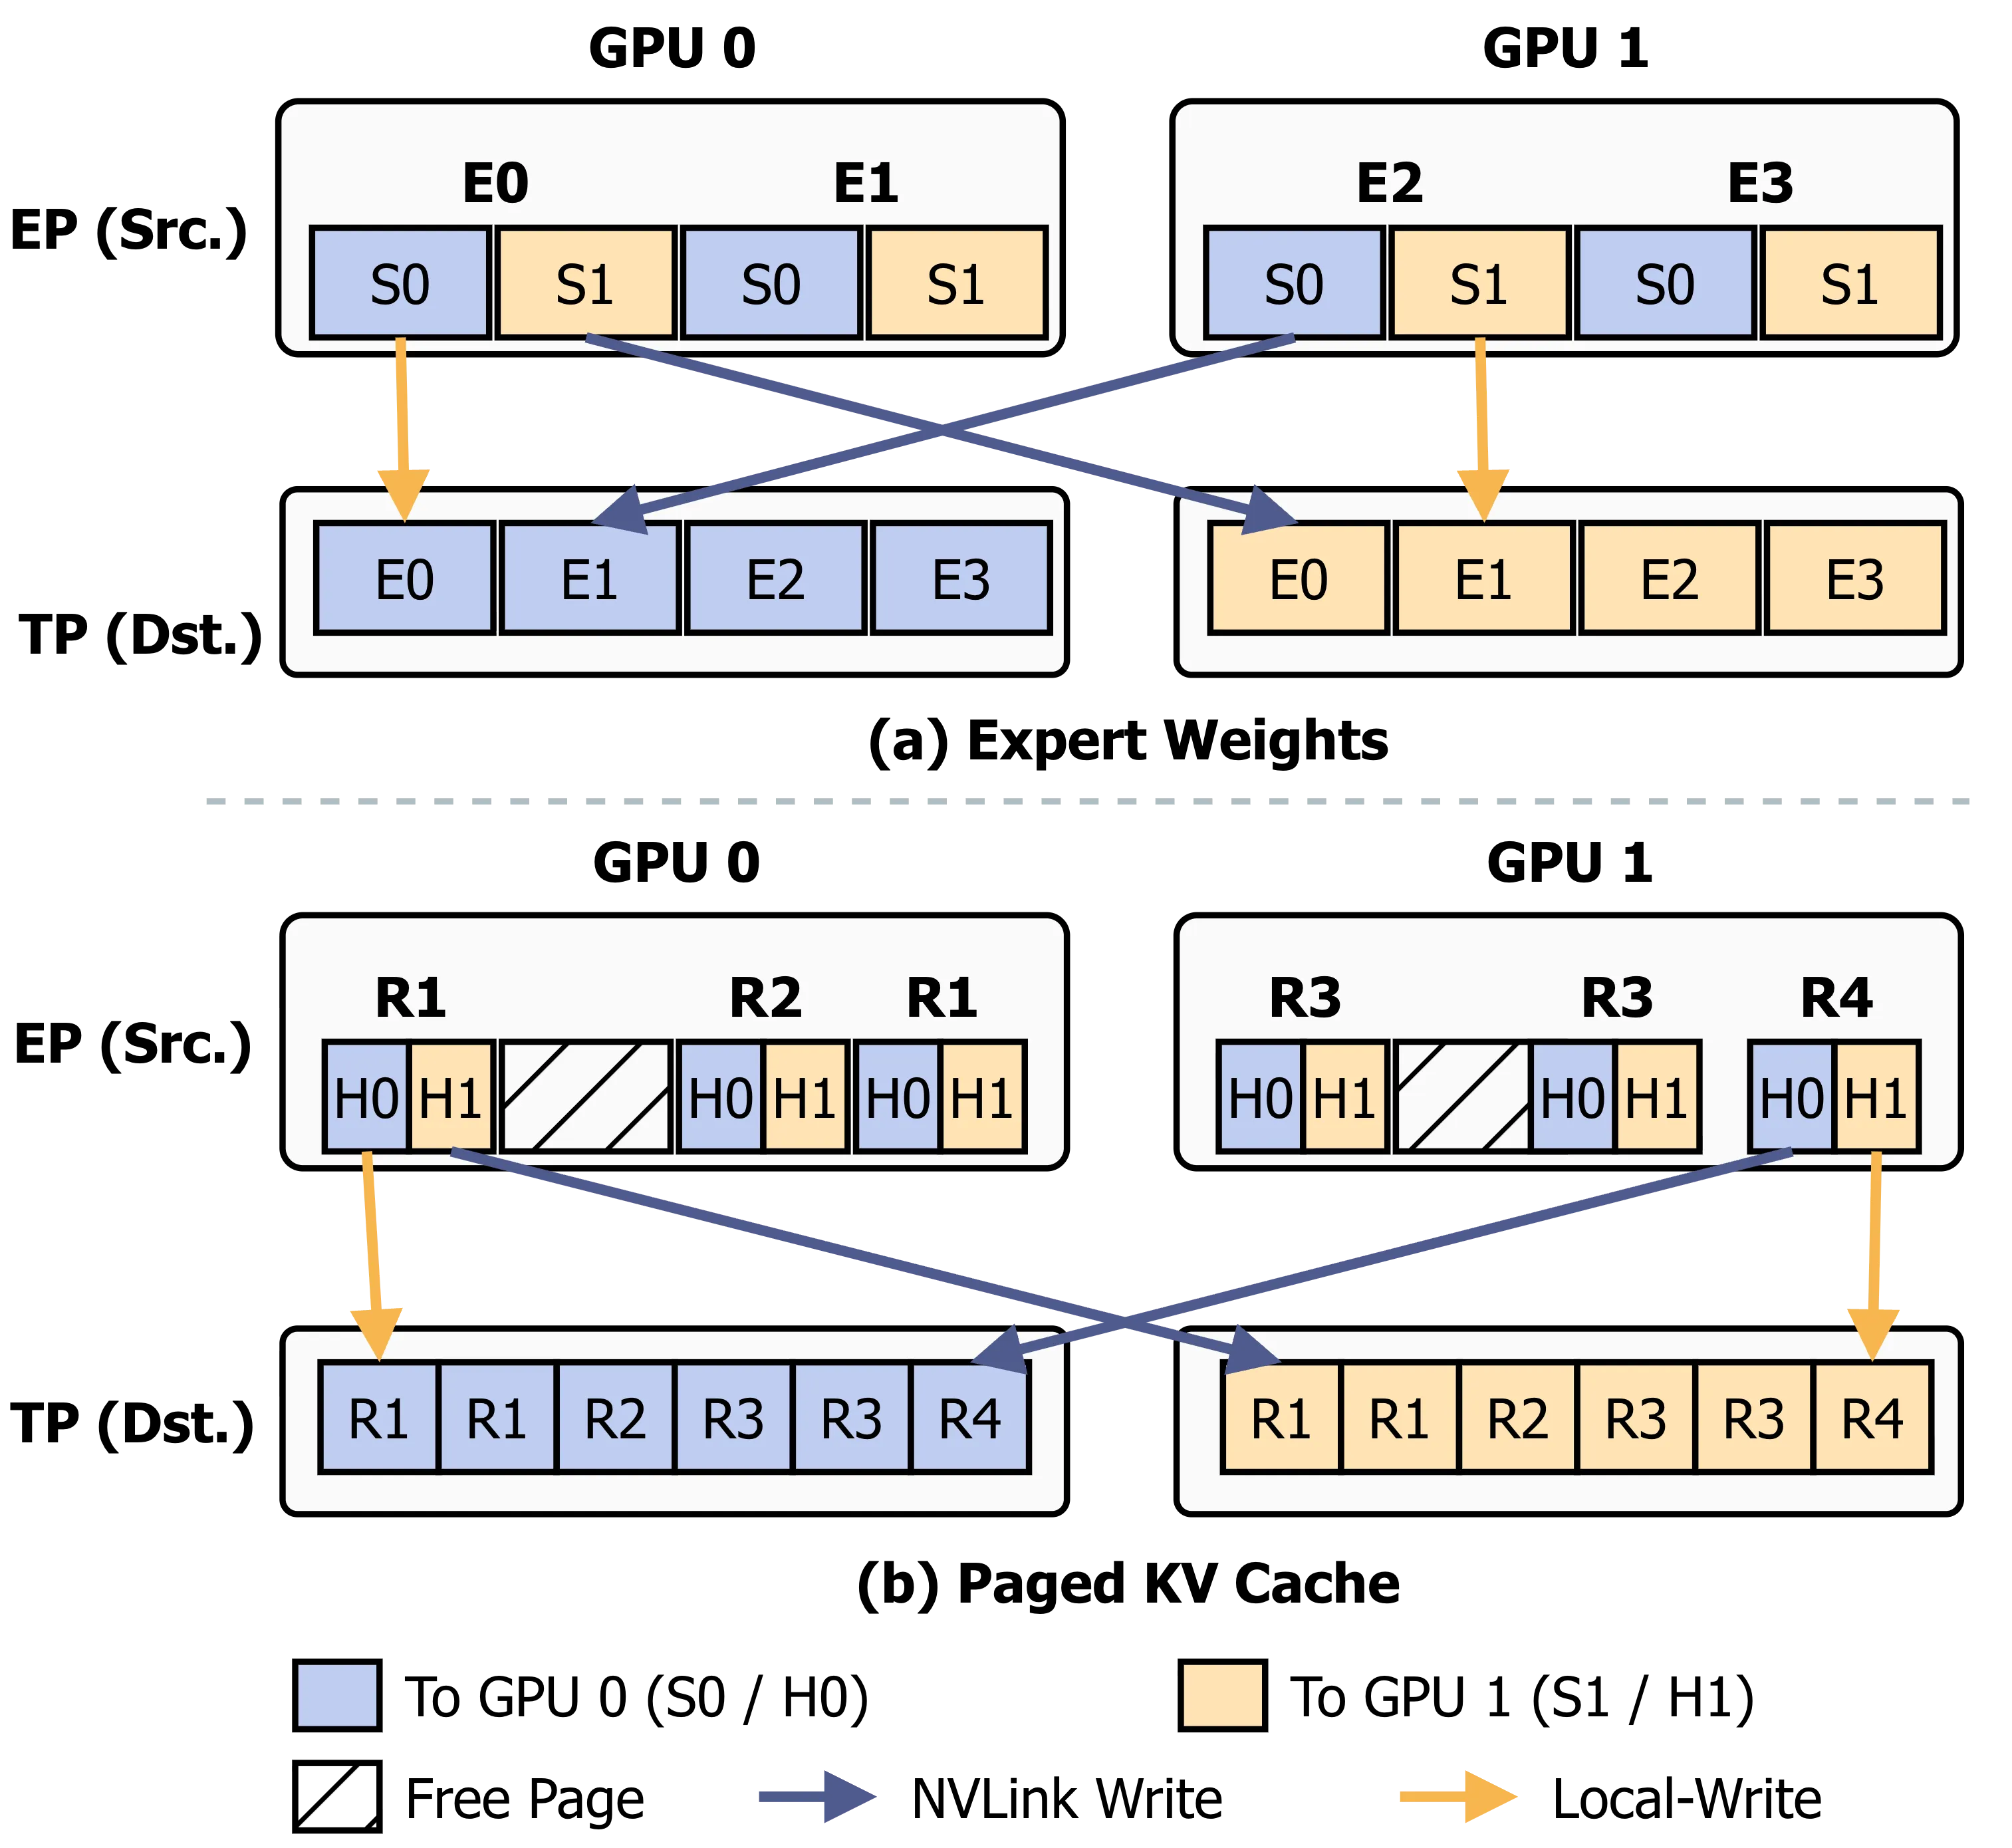
图 8:EP→TP 切换的融合直传 kernel(TP→EP 对称反转描述符)。每 rank 把 (a) 专家权重 shard 与 (b) 分页 KV 切片直写目标槽,无暂存缓冲、无 All-to-All。蓝为跨 GPU 流量、橙为片上拷贝。
5.4 运行时保持(§4.4)
CUDA graph、通信组、EP 通信缓冲、attention 后端元数据须匹配活跃前向路径且重建昂贵,但合起来足够小可两模式常驻。Moebius 启动时构建两套 runtime-state bundle、迭代边界切换已备副本。CUDA graph 约束最强(图重放嵌设备地址、强制每输入张量固定地址):EP/TP 各捕一套图、均引用 UMM 管理的模式特定张量(跨切换地址不变,下次切换把目标模式数据写回同缓冲再重放)——切换改的是缓冲内容而非图地址。启动时用 weight-only warmup switch 在无请求时进入替代模式,捕获两套图。
5.5 切换策略(§4.5)
rank 0 的 coordinator 以全局在途请求数为控制信号(每 decode 迭代采样一次,在当前步完成后、下一步开始前)。策略不对称:TP 中一旦最新计数超高阈 即切 EP(负载骤增使 TP 吞吐受限);EP 中仅当最近 迭代均值跌破低阈 才切回 TP(避免过早切换振荡)。带 提供滞回,切换后 cooldown 限制最大切换率。阈值由启动校准(捕图后探测 EP/TP decode 成本、选交叉为初始阈)。提交前检查目标模式 KV 容量是否够容当前 live 请求(KV 头少于 rank 时 TP 复制头、聚合 KV 容量降;Qwen3-235B 4 头 8 rank)——不够则取消切换、cooldown 后重试,故永不进入不可行布局。
5.6 实现(§5)
基于 SGLang v0.5.5,约 7,400 行自包含模块(UMM + 融合直传 kernel + switch coordinator),仅改约 200 行现有 SGLang 代码。高阈/滞回带/窗口/cooldown 皆命令行参数,交叉自动校准。无需改模型权重、请求 API 或周边训练/服务栈,coordinator 跑在 rank 0 现有引擎进程内,无需单独控制器。
六、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| 首个 MoE 运行时 EP↔TP 无缝切换 | 不重启引擎、不丢在途请求,两 decode step 间完成 | §1、§3 |
| 「一模型两布局」洞见 | 字节相同权重/KV,切换只改所有权,唯一成本=搬换主字节 | §3 |
| 统一内存管理器(UMM) | 固定地址 + 槽位/别名 + N+1 槽,使 CUDA graph 跨切换有效 | §4.2;图 7 |
| 融合直传 kernel | gather/exchange/scatter 塌缩为单次跨 GPU 直写,零暂存 | §4.3;Table 1 |
| 运行时保持 | 两套 CUDA graph/通信/attention 元数据常驻,切换=指针交换 | §4.4 |
| 容量感知非对称切换策略 | 滞回 + cooldown + KV 容量检查,界下不劣于更优静态布局 | §4.5 |
七、实验结果(§6)
7.1 评测设置(§6.1)
- 硬件/模型:8×H200(141GB HBM,NVLink 全互连),Qwen3-235B-A22B BF16(94 层,64 query/4 KV 头);
- 对比:三套 SGLang 部署仅并行布局不同——TP(8 路 TP)、EP(DP 注意力 + 8 路 EP,用 DeepEP dispatch/combine)、Moebius(两布局运行时切换);
- 配置:radix cache 关、overlap scheduling 开、2048 并发上限、0.85 静态显存分数、CUDA graph 开;策略 、,交互 ,rollout 。
7.2 突发在线服务(§6.2)
回放 3,107 请求 trace(375s,两 burst 峰值 80/120 req/s 夹 300s 静默期 1-5 req/s,prompt 为 ShareGPT 300-700 token、输出 U(800,1200))。Moebius 切换 4 次(每 burst 起切 EP、排空后切回 TP)。各静态布局各有短板:TP burst 下 mean TTFT 达 9.9s(约 EP 2.0s 的 5 倍);EP 静默期 All-to-All 开销致 TPOT 52ms(vs TP 37ms,40% 差距)。Moebius 跟随更优布局:静默期 TPOT 贴 TP、burst TTFT 峰 3.1s(比 TP 低 3 倍、接近 EP),两 burst 的 p99 TTFT 保持 6.0s/1.9s(远低于静态 TP 90s 的 burst 起始崩溃)。
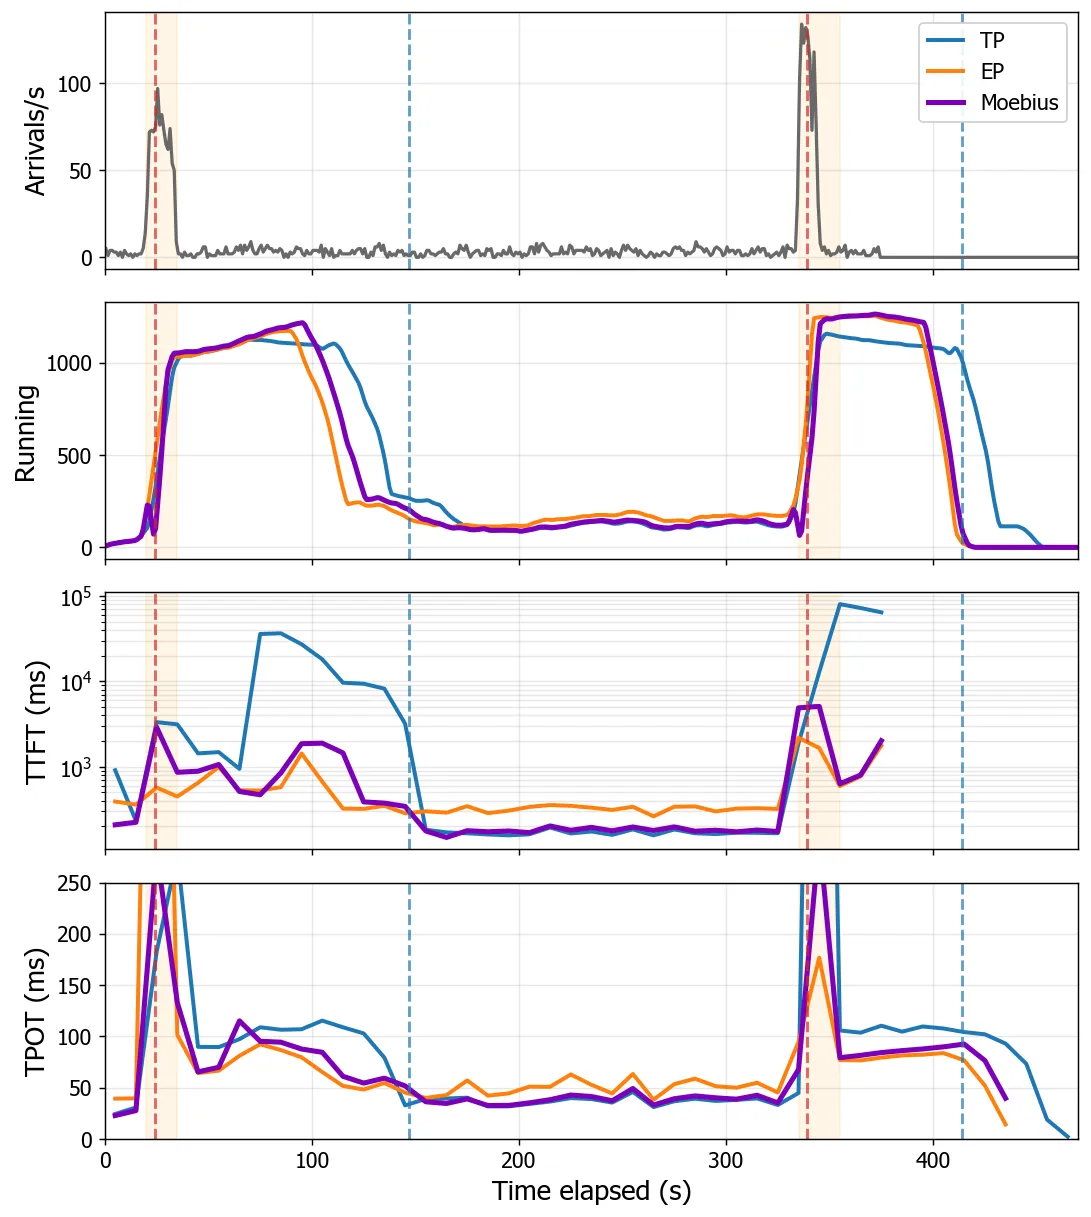
图 9:突发在线服务(自上而下:到达率、running 请求、mean TTFT、mean TPOT)。橙带为 burst 窗口,虚线为 Moebius 的 TP→EP(红)与 EP→TP(蓝)切换。
7.3 RL Rollout 负载(§6.3)
DeepMath 数学推理,每 rollout 步提交 prompt、每个解码到 32,768 token 上限。九步共 18,432 请求:输入短而集中(中位 120,最大 1,352),输出长且重尾(中位 1,510,p99 10,386,最长到 32k 上限)。为隔离系统性能,先在 EP 下捕获各请求输出长度、再在 TP/Moebius 下重放相同长度。Moebius 用 rollout 设置(EP 起、batch 跌破 时切一次 TP)。
结果:Moebius 九步全最快,超越更优静态布局 1.16-1.25×(均值 1.22×)、超越更差布局达 1.31×。关键:哪个静态布局更优取决于该步 prompt 组成、跑完才知(EP 多步凭 burst 吞吐胜,最重尾步 TP 反超)——「更优静态布局」是无法部署的先知 oracle,而 Moebius 仍超越它,因收益来自步内切换(burst 段跑 EP、长尾段跑 TP)。端到端投影:同步 on-policy 65-85% rollout 占比下,Amdahl 定律把 1.16-1.25× 每步增益投影为 1.10-1.20× 端到端。
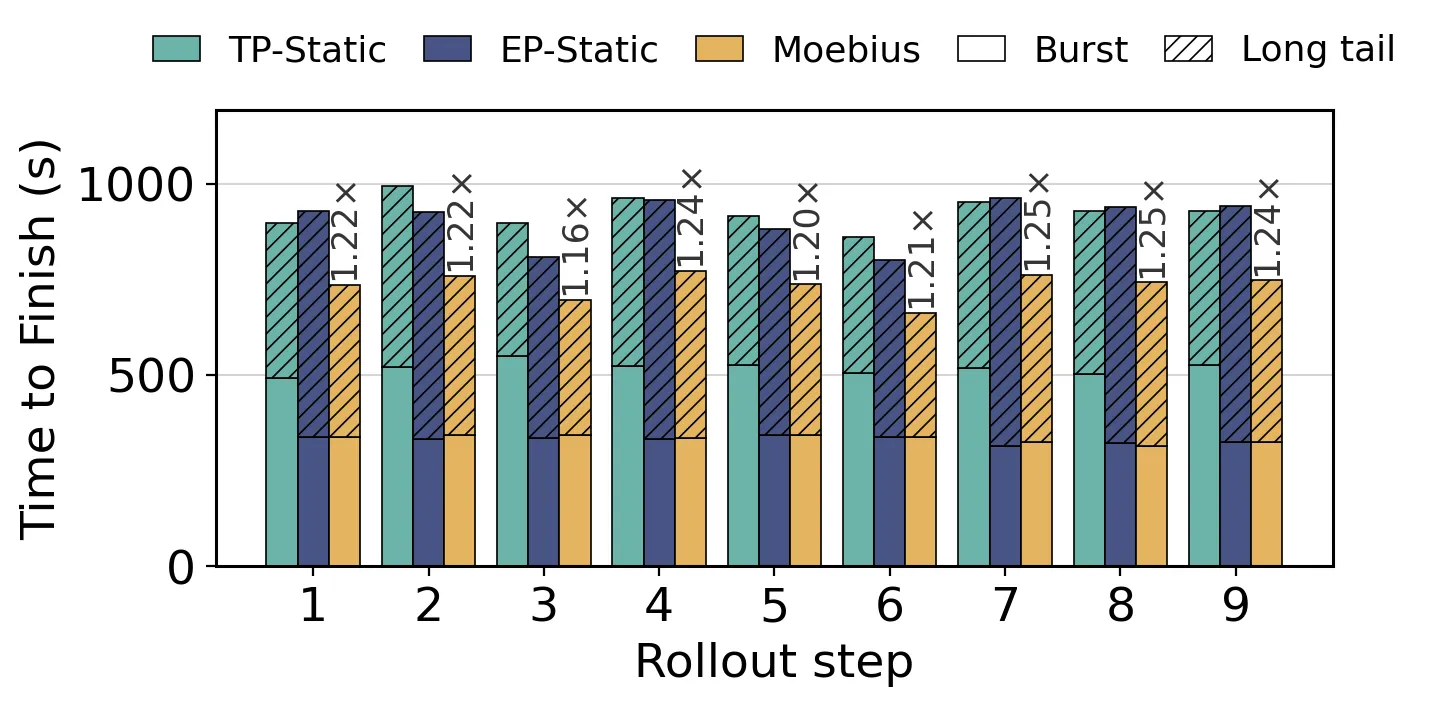
图 10:九个 DeepMath rollout 步在固定 TP、固定 EP、Moebius 下的端到端完成时间。每条按 切分为 burst 段(实心)与长尾段(斜纹),Moebius 上方标注对更优静态布局的加速。
7.4 切换成本与优化(§6.4)
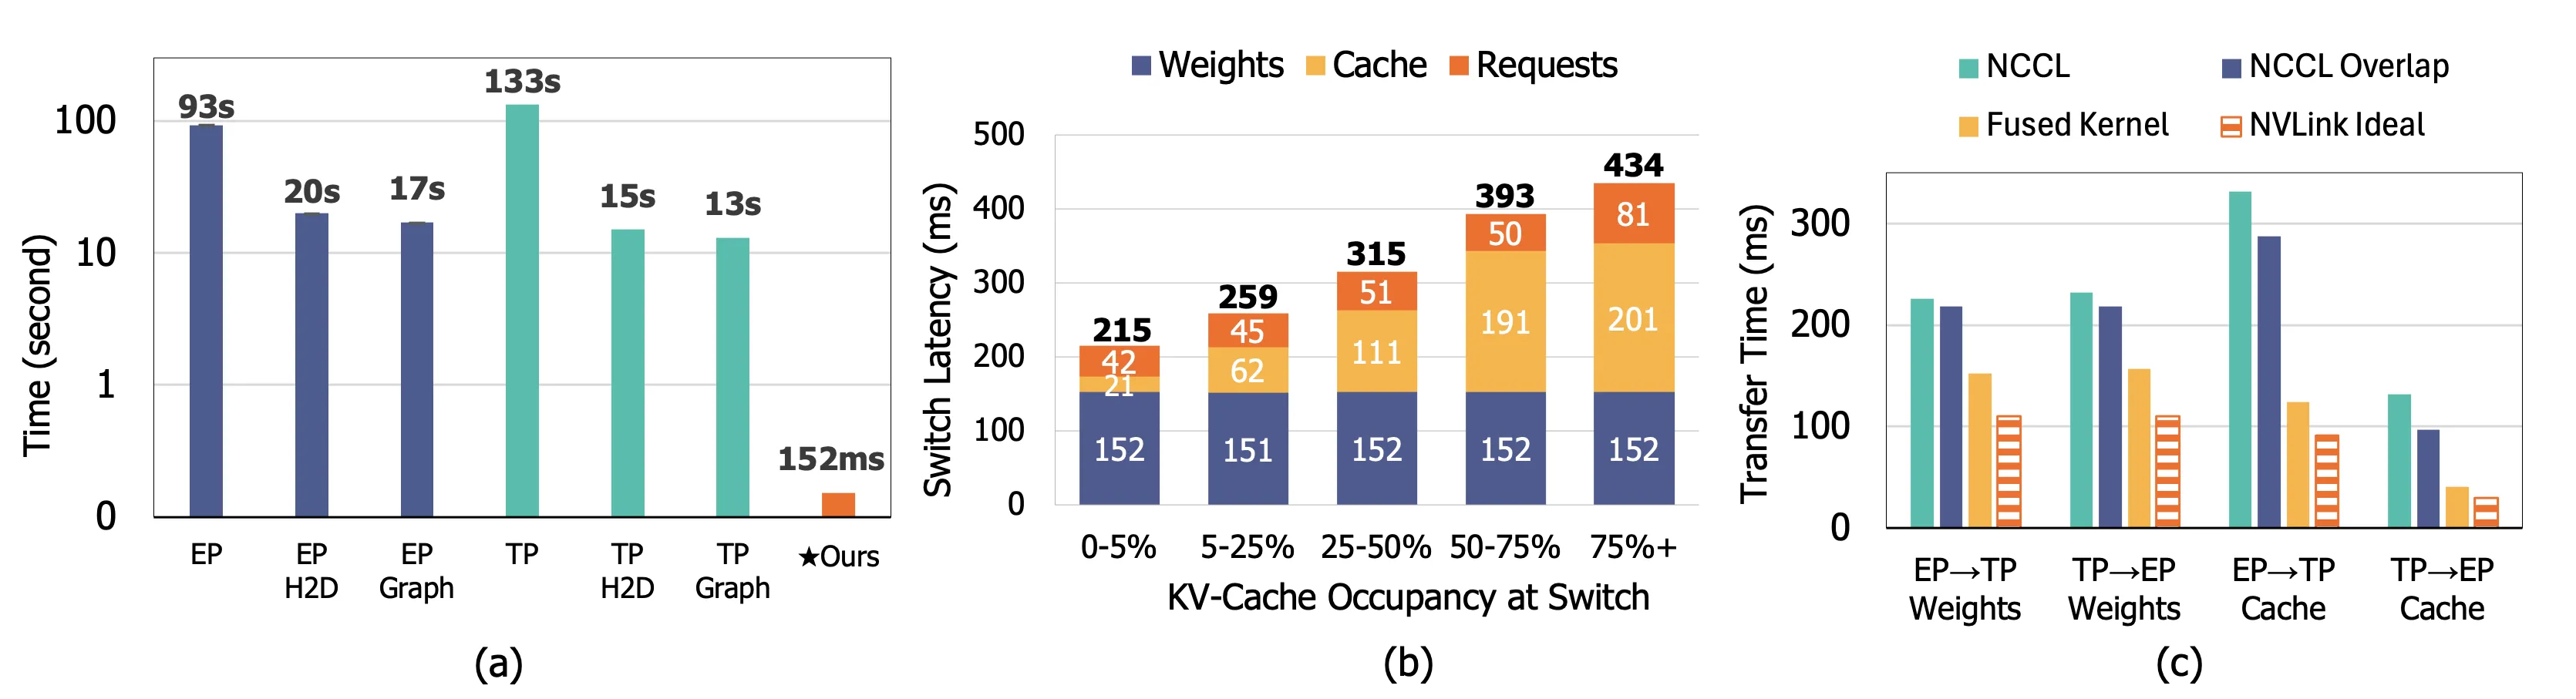
图 11:Moebius 切换成本与优化。(a) 三种重建 strawman(restart、host 内存加载、CUDA graph 重捕)与 Moebius 双向切换的端到端时延;(b) 生产 EP→TP 切换按权重/KV/请求阶段分解、按 KV 占用分箱;(c) 专家权重与 KV 传输在融合 kernel/NCCL/NCCL-overlap/NVLink 带宽上限下的分解。
- 不重建即胜数个数量级(图 11a):strawman 逐一剥离成本(restart 付冷加载+重捕、host 加载省磁盘、复用融合传输仅剩重捕),每级仍需秒到分钟;Moebius 传入固定地址 + 两套图常驻,切换 152ms(排空 batch),快数个数量级。375s bursty trace 切 4 次,若用 strawman 的 93-133s(或 host/重捕的 13-20s)成本将淹没整个 trace,naive 自适应净负收益;
- 切换 = 固定权重底 + 负载相关 KV 项(图 11b):挖 16 次 EP→TP 切换按三阶段分箱,权重传输为固定底、仅 KV 阶段随占用单调增、请求重分布随请求数(非缓存足迹)保持平坦,满缓存下总计仍 < 0.5s;
- 融合 kernel 优于 NCCL(图 11c):每条 bar 维持 NVLink 峰值 70%+,专家权重双向比 NCCL 快 1.49×、cache 快 2×+;融合把布局变换融进拷贝、留在 SM 上(SM 上限约 77% 峰值),70% 峰值已达 90%+ 效率。
注:论文摘要与结论报告完整生产切换(保留在途请求)为 215-434ms;§6.4 的 152ms 为排空 batch 的纯 reshard 下限。
7.5 保持 CUDA graph 的代价(§6.5)
Moebius 启动捕两套图、常驻,切换 <1ms 交换指针。避免两成本:每次切换重捕停顿 + eager 解码的每 token 税。eager 解码每步都被税(图 12):无图逐层单独发射 kernel,低 batch 处最痛达 6.95×(正是 Moebius 进 TP 服务的低并发区),且不可预测(GC/发射队列 stall 偶发尖峰)。两套图常驻很便宜:每模式 capture 上限每 rank batch 256、仅 36 张图(因超 即进 EP,EP 数据并行注意力使每 rank ≤256)。
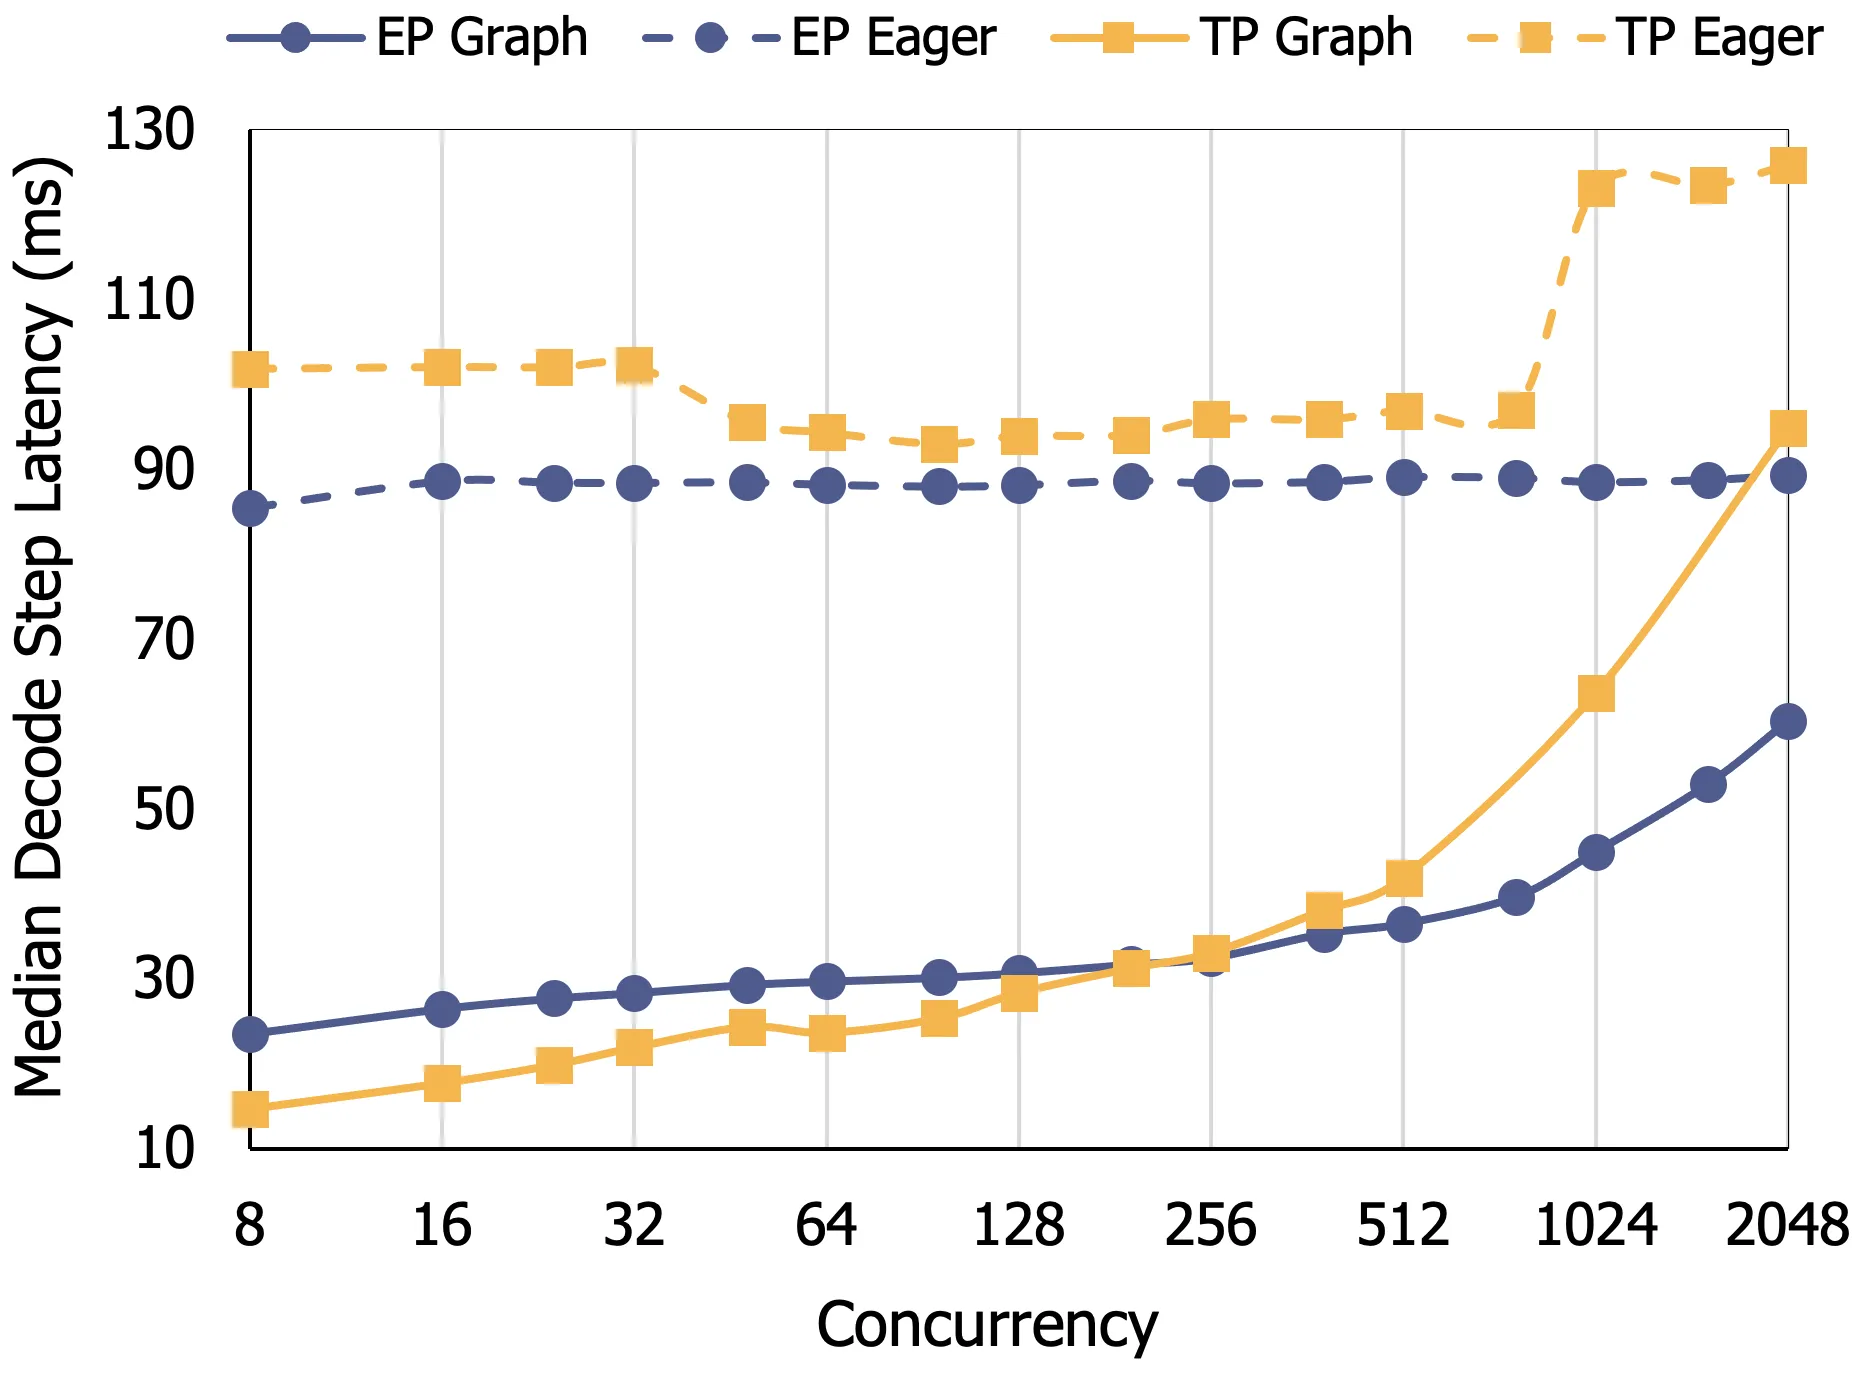
图 12:不同 batch 下开/关 CUDA graph 的中位每步 decode 时延。低 batch 无图开销最高 6.95×。
7.6 显存足迹(§6.6)
尽管持两套 CUDA graph 与两注意力布局,Moebius 不翻倍显存(图 13):在 EP 预算内(比 EP 多 0.2GB、比 TP 少 3.7GB)。重状态共享非复制(权重同 EP,MoE 专家/EP 通信缓冲/NCCL communicator 一次分配两布局复用)。唯一真正开销是 2.8GB 双模式缓冲(存 TP 模式注意力 shard + 完整 EP 副本使切换保持指针交换 + 一份备用物理层暂存传输),因位于权重分配内,靠让出 2.8GB KV cache 出资(每 GPU +2.4%)而非额外加显存。
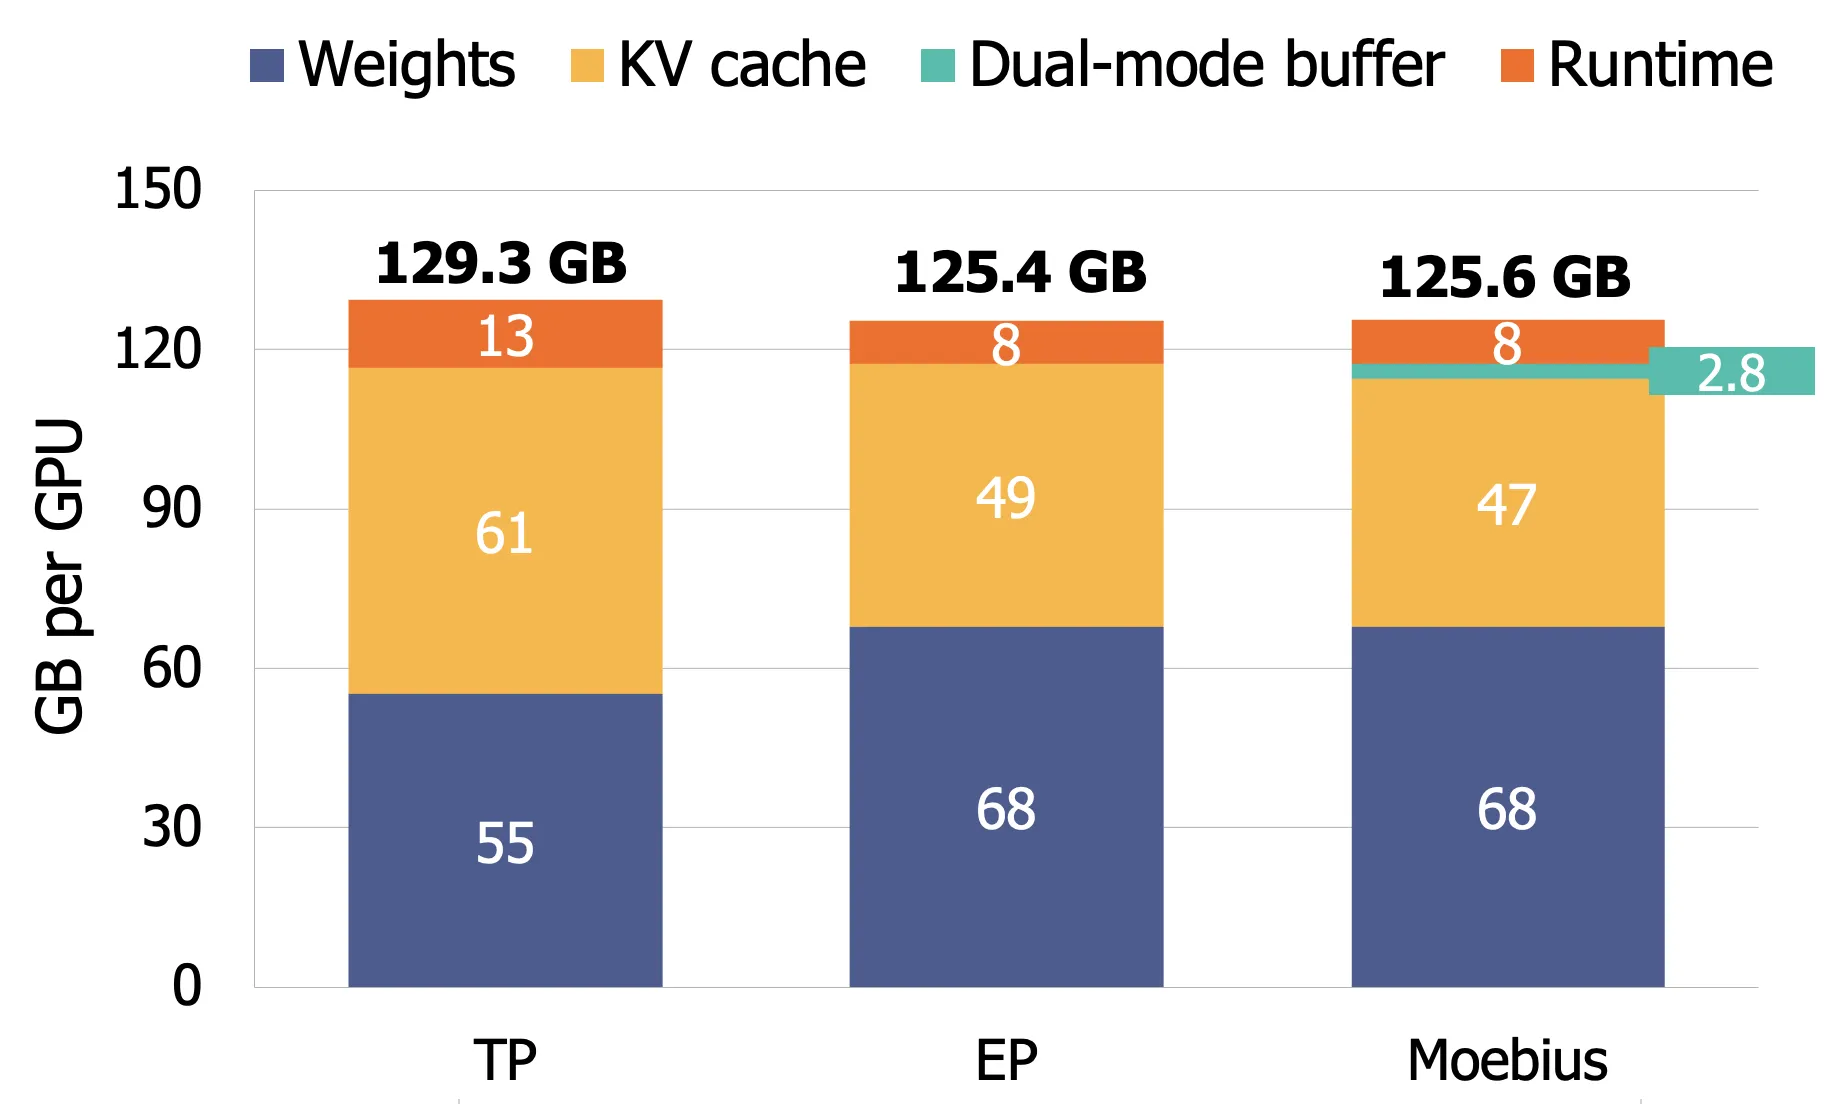
图 13:静息态每 GPU 显存足迹,分为权重、KV cache、Moebius 双模式缓冲、runtime 状态。
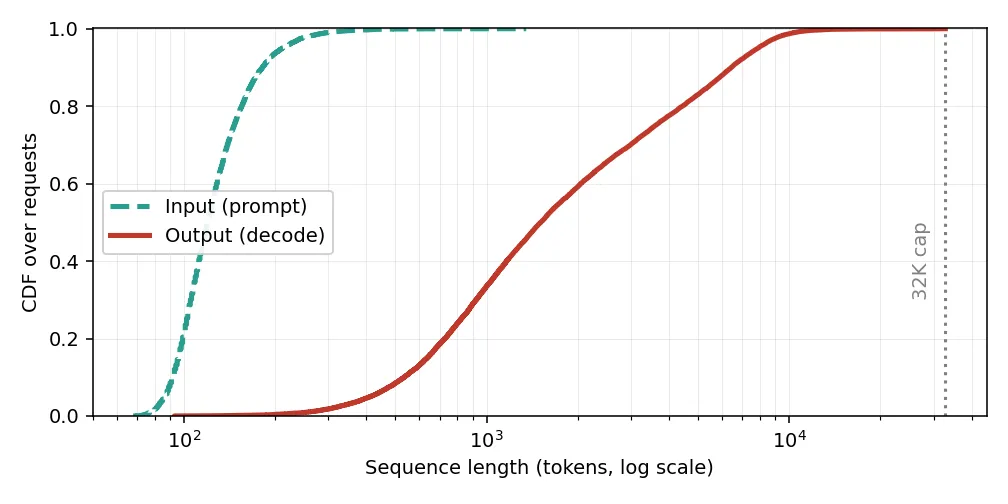
图 14(附录 A):九个 DeepMath rollout 步的输入(虚线)与输出(实线)token 长度 CDF——输出长而重尾。
八、总结
核心贡献
- 首个 MoE 运行时并行切换服务系统:不重启引擎、不丢在途请求,在两次 decode step 间完成 EP↔TP 切换;
- 「一模型两布局」洞见:把切换视为数据所有权变更而非语义变更,在单份常驻权重/KV 上重分片,无需第二副本;
- 三大机制协同:UMM(固定地址 + 槽位别名保 CUDA graph 有效)、融合直传 kernel(塌缩 gather/exchange/scatter 为单次直写)、运行时保持(两套控制平面常驻);
- 容量感知非对称策略:滞回 + cooldown + KV 容量检查,保证界下不劣于更优可行静态布局;
- 显著收益:8×H200 服务 Qwen3-235B 每操作点匹配更优静态布局,RL rollout 超越 1.16-1.25×,每次切换 215-434ms,双布局驻留仅 2.4% 显存开销。
局限性
- 直传 kernel 仅针对单 NVLink 域;跨节点切换回退到 collective(仍保单份权重/CUDA graph/迁移请求),RDMA 直传路径为未来工作;
- rollout 数字仅测生成引擎本身,与完整 RL 系统(生成 + 策略更新 + 调度)耦合以转化为端到端训练增益为未来工作;
- 加速数字特定于本文模型与硬件;
- 容量感知切换在 TP 容量不足时会取消切换、放弃时延收益(保正确性但非最优)。
九、参考资源
- arXiv 论文:https://arxiv.org/abs/2606.26607
- 实现基础:SGLang v0.5.5(Zheng 2024)、DeepEP(EP dispatch/combine)
- 测试模型:Qwen3-235B-A22B(Yang 2025)
- 对比方案:Shift Parallelism、Amoeba、Flying Serving(稠密模型运行时切换)
- 相关背景:MoE(Shazeer 2017)、PagedAttention/vLLM(Kwon 2023)、GRPO(Shao 2024)、DAPO(Yu 2025)、DeepMath(He 2026)