SharQ: Bridging Activation Sparsity and FP4 Quantization for LLM Inference
SharQ提出FP4量化与N:M稀疏协同的免训练推理方案:在线抽取outlier主导的稀疏骨干做sparse FP4 GEMM,再用dense FP4 GEMM对稀疏路径的量化+掩码误差做残差补偿,两路径共享单份FP4权重与path-specific scale视图。Llama-3.1-8B/Qwen2.5-7B/Qwen3-30B-A3B/Qwen3-VL-8B上恢复43–63%的NVFP4-FP16精度差,RTX 5090延迟对FP16降2.2–2.4×、对FP8吞吐提升1.2–1.4×,Wan2.2-T2V加SageAttention最高1.58×。
SharQ: Bridging Activation Sparsity and FP4 Quantization for LLM Inference
一、论文概述
| 项目 | 内容 |
|---|---|
| arXiv ID | 2606.26587 |
| 标题 | SharQ: Bridging Activation Sparsity and FP4 Quantization for LLM Inference |
| 作者 | Haoqian Meng, Yilun Luo, Yafei Zhao, Wenyuan Liu, Huaqing Zheng, Xindian Ma, Peng Zhang |
| 提交日期 | 2026-06-25 |
| 学科分类 | cs.LG, cs.AI |
| 硬件 | NVIDIA Blackwell / RTX 5090(NVFP4 + 4:8 in-pairs sparsity) |
| 集成 | vLLM |
二、核心思想
问题定义:块级 FP4 格式(NVFP4/MXFP4/HiF4)与 N:M 半结构化稀疏都已经进入 Tensor Core 硬件路径。同时组合两者做 LLM 激活压缩仍很难:
- 激活里存在输入相关的离群值,会主导 FP4 block scale、把 4bit 有效精度吃光;
- 直接套 N:M 掩码会丢弃中等幅值,把 sparsification loss 和 quantization error 耦合到一条路径上。
前人 outlier 处理路径(LLM.int8/SmoothQuant/AWQ/QuaRot/SpinQuant)虽有效但引入额外存储、异构数据流或额外 kernel,与 FP4 单 kernel 数据流不相容。
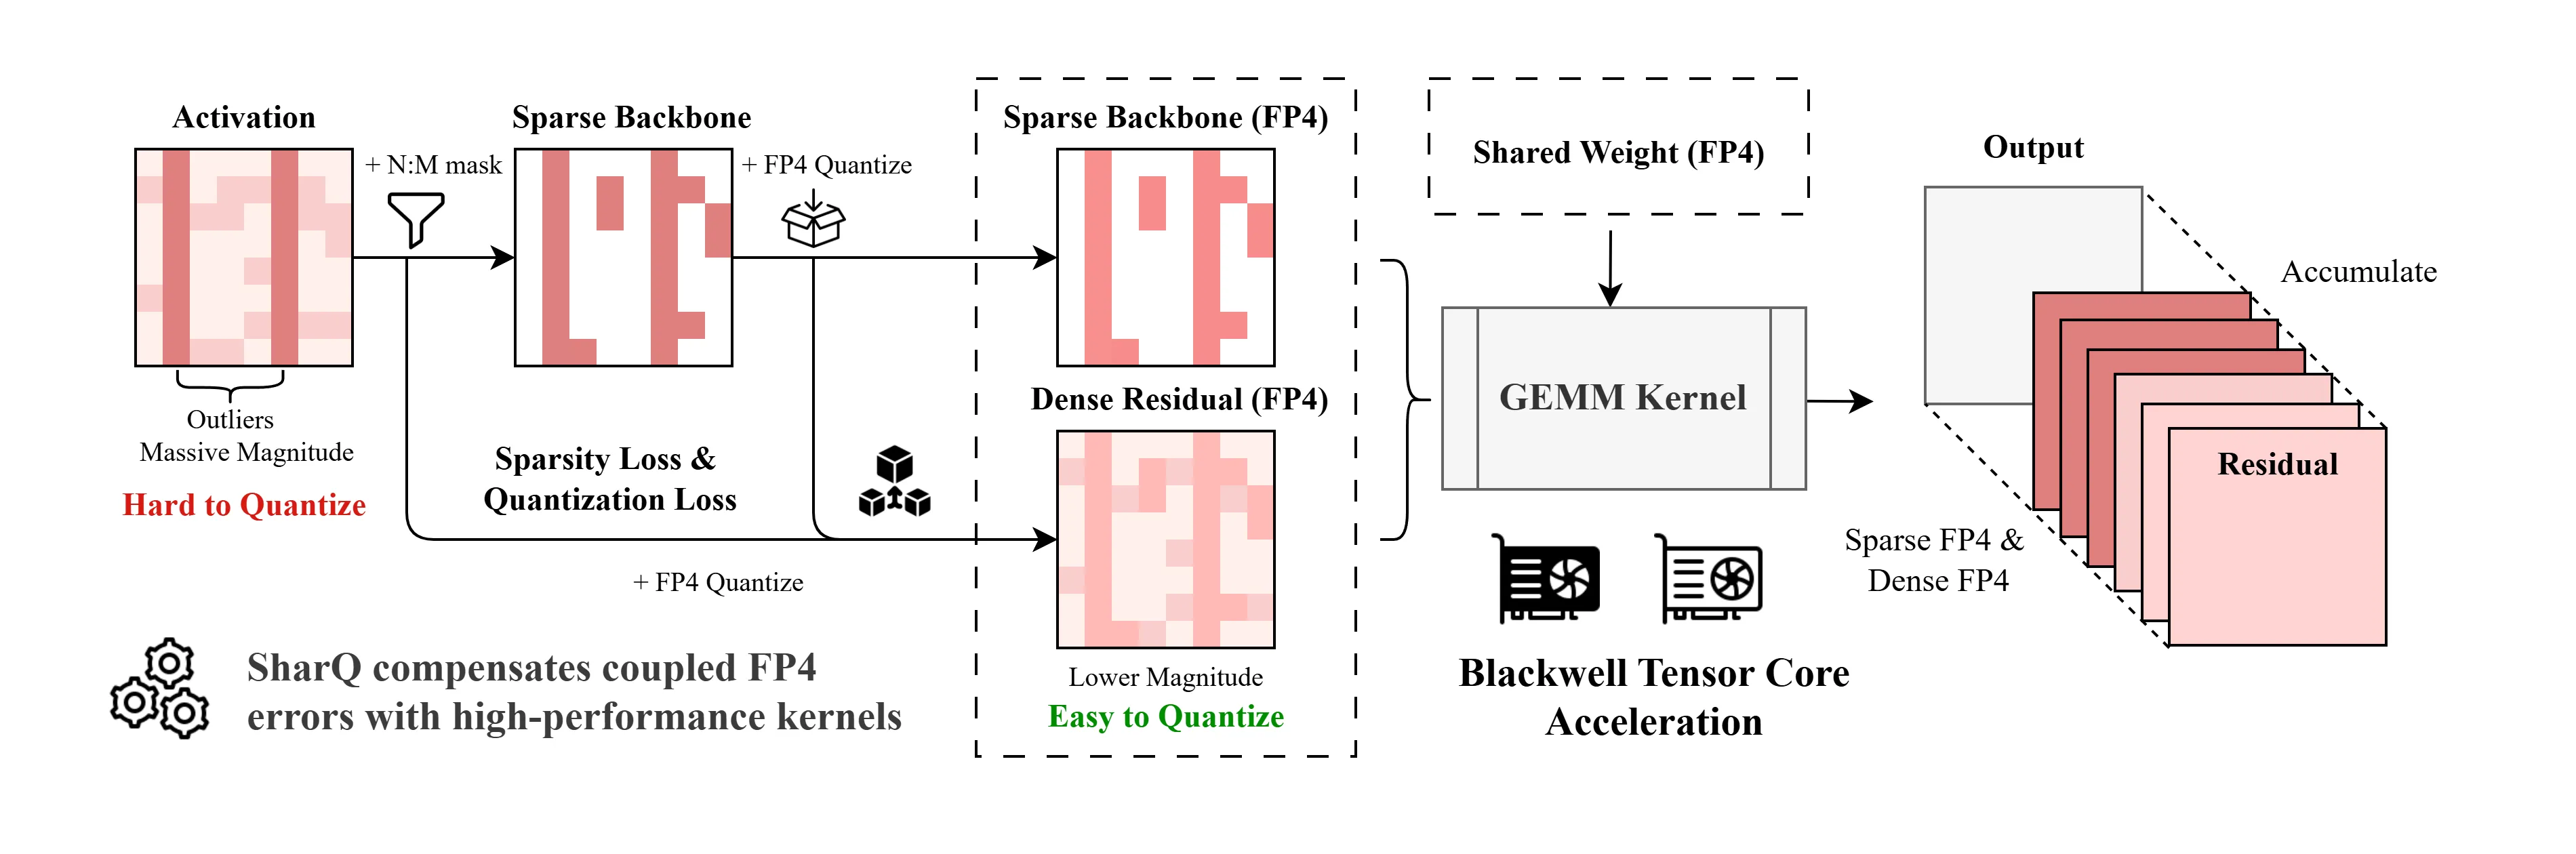
解决方案:SharQ 是免训练的推理方法,做在线 sparse–dense 分解:
- 生成输入自适应的 N:M 掩码 → outlier 主导的稀疏骨干;
- 骨干量化到 FP4;
- 定义残差 = 原激活 − 量化后骨干(不是未量化骨干),把 mask 丢失 + 骨干量化误差合并进单个残差;
- Sparse FP4 GEMM 处理骨干 + Dense FP4 GEMM 处理残差 → 求和。两路径共享一份 FP4 权重 payload,只用 path-specific scale views 区分;mask 生成、残差构造、layer norm 融进一个 fused preparation kernel。
三、技术架构/方法
3.1 前提与优化目标
对线性层 (, ),寻找
其中 由目标 FP4 格式 + N:M sparsity + 硬件 GEMM 决定。组内对称量化 ,NVFP4 是 FP4 值 + 本地 block scale + 二次全局 scale。
3.2 稀疏骨干
对每个 local block 选幅度 top-(或 target N:M 模式所需 entries)构成掩码:
NVFP4 用 4:8 in-pairs sparsity,HiF4 用 2:4 sparsity。掩码在线从当前激活计算,无需离线学固定 mask。
3.3 稠密残差(关键设计)
设 为稀疏路径的量化/去量化算子,稀疏路径实际表示的激活是:
残差相对量化后骨干(不是未量化骨干)定义:
这样 同时携带 mask 掉的信息 + 保留的 outlier 的 4bit 量化误差,把两类误差捏成一个残差重建问题。
3.4 双路径 GEMM 输出
第一项走 Blackwell 硬件加速的 N:M 稀疏 FP4;第二项走 dense FP4 补偿。
3.5 Kernel 设计
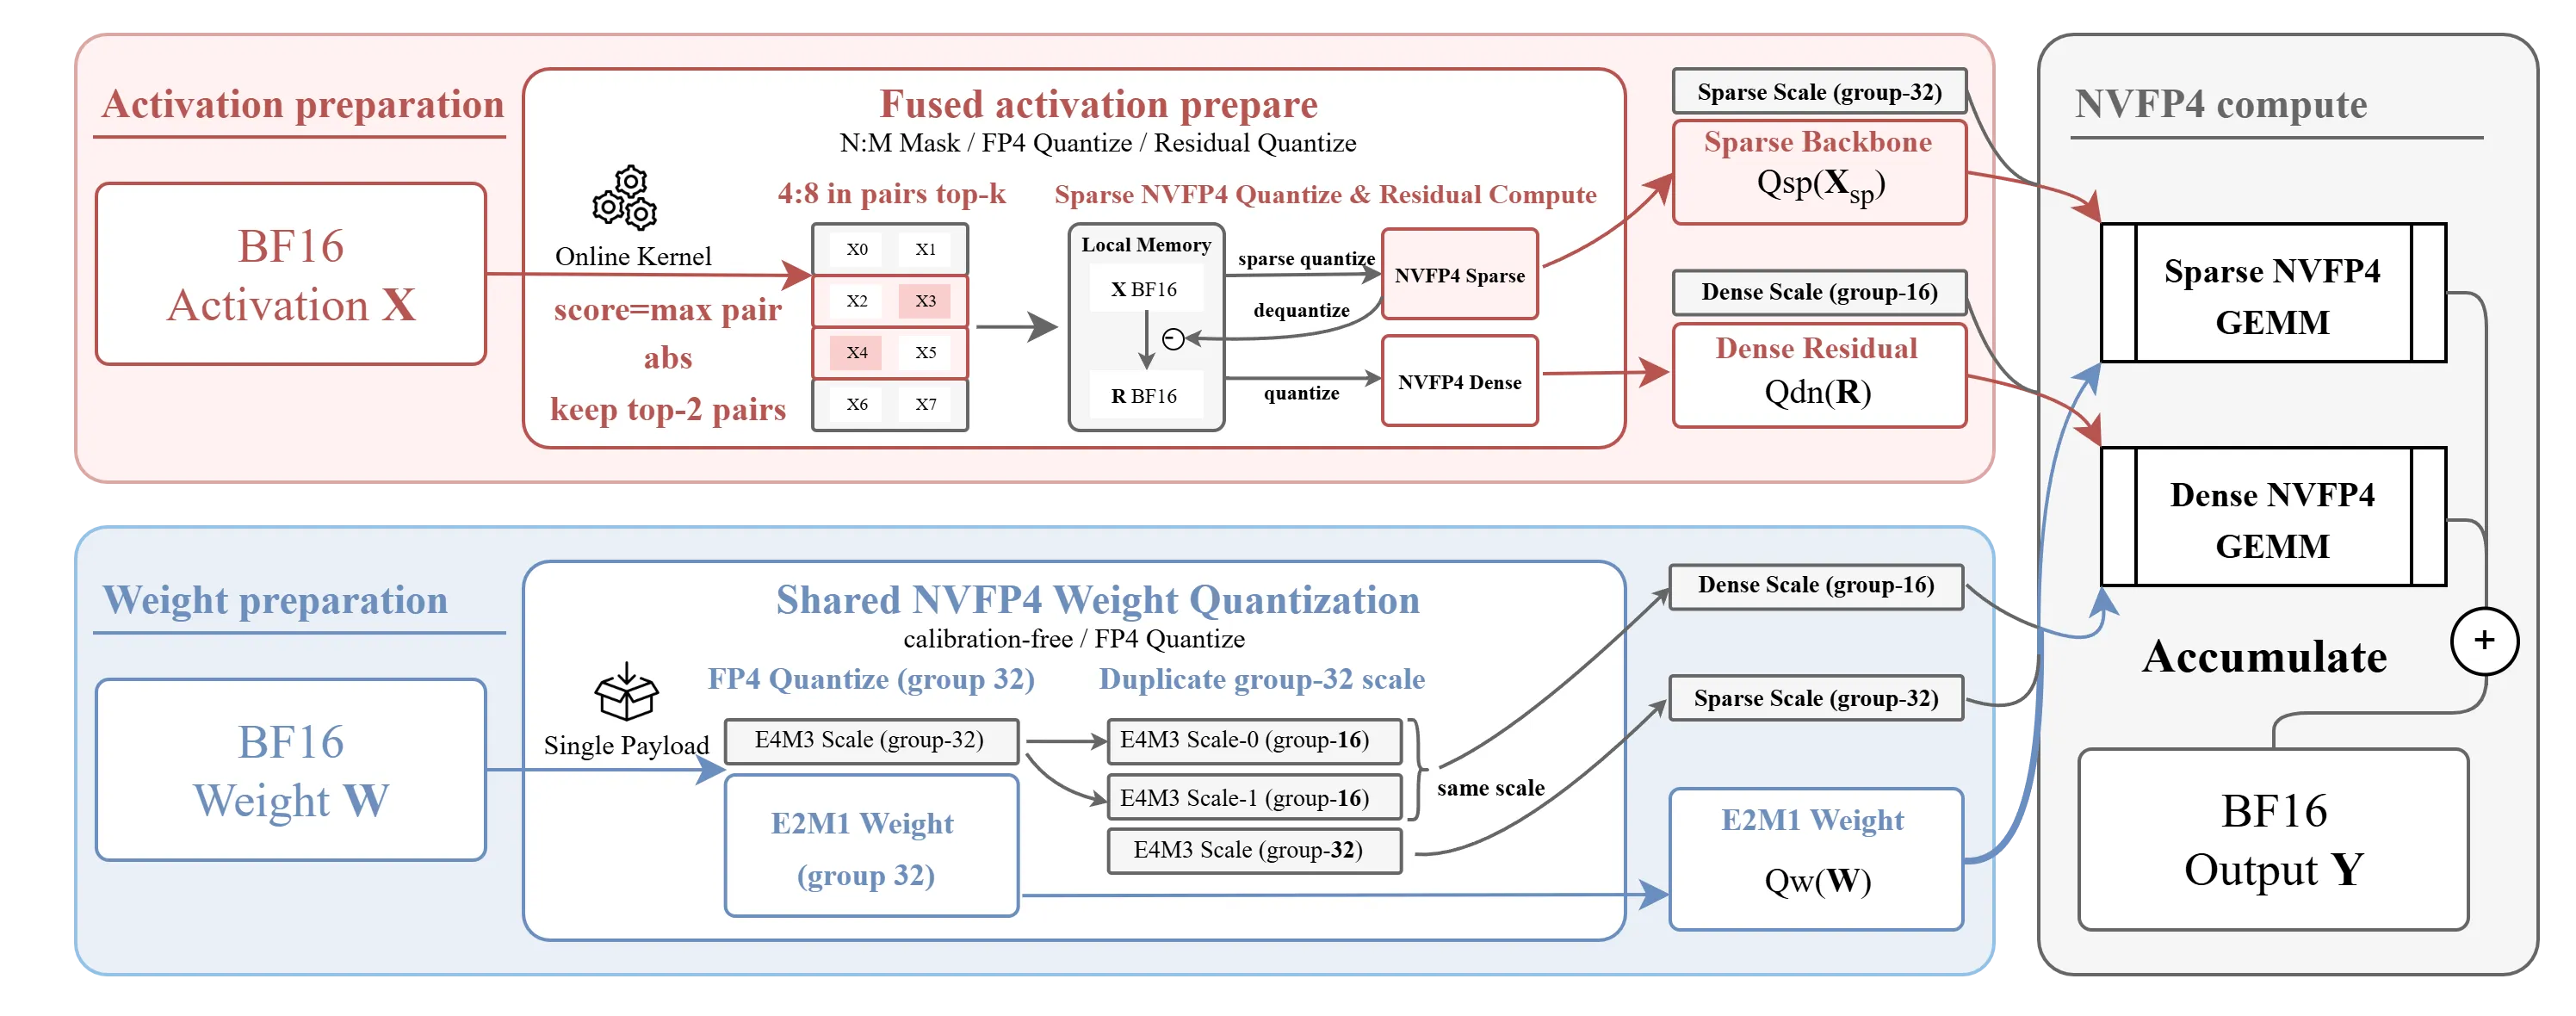
- Fused activation preparation:RMSNorm/PTS + pair-topk 4:8 in-pairs 掩码 + 稀疏压缩 + dense 残差构造,全部融入单一 preparation kernel,抵消掉动态 mask 生成本可能吃掉的 sparse compute 收益。
- Shared FP4 weight payload:两路径共享同一份 FP4 权重体,只用不同 scale view(sparse 组32 scale / dense 组16 scale duplicated),避免双份权重存储。
- Residual accumulation:dense 分支直接 accumulate 进 sparse 分支输出,无需 materialize 第二完整分支。
3.6 理论分析
- Outlier 隔离改善量化友好度:稀疏骨干把 outlier 拉走后,dense 残差的 block scale 不再被 outlier 主导,dynamic range 更集中,更适合低 bit FP4;
- 误差合并:,输出扰动满足 。SharQ 关键角色不是让稀疏路径独自逼近全部激活,而是让残差路径联合吸收两类误差。
四、核心创新
| 创新点 | 说明 |
|---|---|
| Online sparse–dense decomposition | 用输入自适应 N:M mask 抽取 outlier-dominated 骨干,训练/校准/微调全免 |
| 残差 = 原激活 − 量化后骨干 | 把 mask-induced loss 与 sparse-path quant error 合并为单一残差 |
| 共享 FP4 权重 + path-specific scale views | 两条路径同一权重 payload,避免存储翻倍 |
| Fused preparation kernel | RMSNorm/PTS + mask + 压缩 + 残差 融合到一个 op |
| 格式无关 | NVFP4 / HiF4 / MXFP4 全通用(分别配对 4:8 / 2:4 / 2:4 sparsity) |
五、实验结果
5.1 语言与多模态精度
Table 1(zero-shot + WikiText2):
| Model | Method | Avg (5 tasks) | WikiText2↓ | MMLU |
|---|---|---|---|---|
| Llama-3.1-8B | FP16 | 72.50 | 6.25 | 65.24 |
| NVFP4 | 70.32 | 6.94 | 61.93 | |
| SharQ | 71.55 | 6.73 | 63.76 | |
| Qwen2.5-7B | FP16 | 70.94 | 6.85 | 74.16 |
| NVFP4 | 69.43 | 7.29 | 72.06 | |
| SharQ | 70.38 | 7.15 | 72.83 | |
| Qwen3-30B-A3B | FP16 | 70.07 | 8.70 | 79.64 |
| NVFP4 | 68.40 | 9.12 | 77.72 | |
| SharQ | 69.17 | 8.96 | 78.79 |
- Llama-3.1-8B:恢复约 56% NVFP4→FP16 平均精度 gap;MMLU +1.83 pp;
- Qwen2.5-7B:恢复约 63%;
- Qwen3-30B-A3B(MoE):SharQ 也对专家线性层生效,Avg +0.77 pp。
- 总恢复率 43–63%,跨模型稳定。
Table 2(Qwen3-VL-8B 五个 VQA 基准):NVFP4 相对 FP16 掉 −1.40 pp → SharQ 恢复到 −0.80 pp(≈43% gap);TextVQA 恢复率 52%,POPE 涨 0.47 pp。
5.2 端到端服务效率
vLLM + RTX 5090,Llama-3.1-8B,batch=4,seqlen 256–2048:
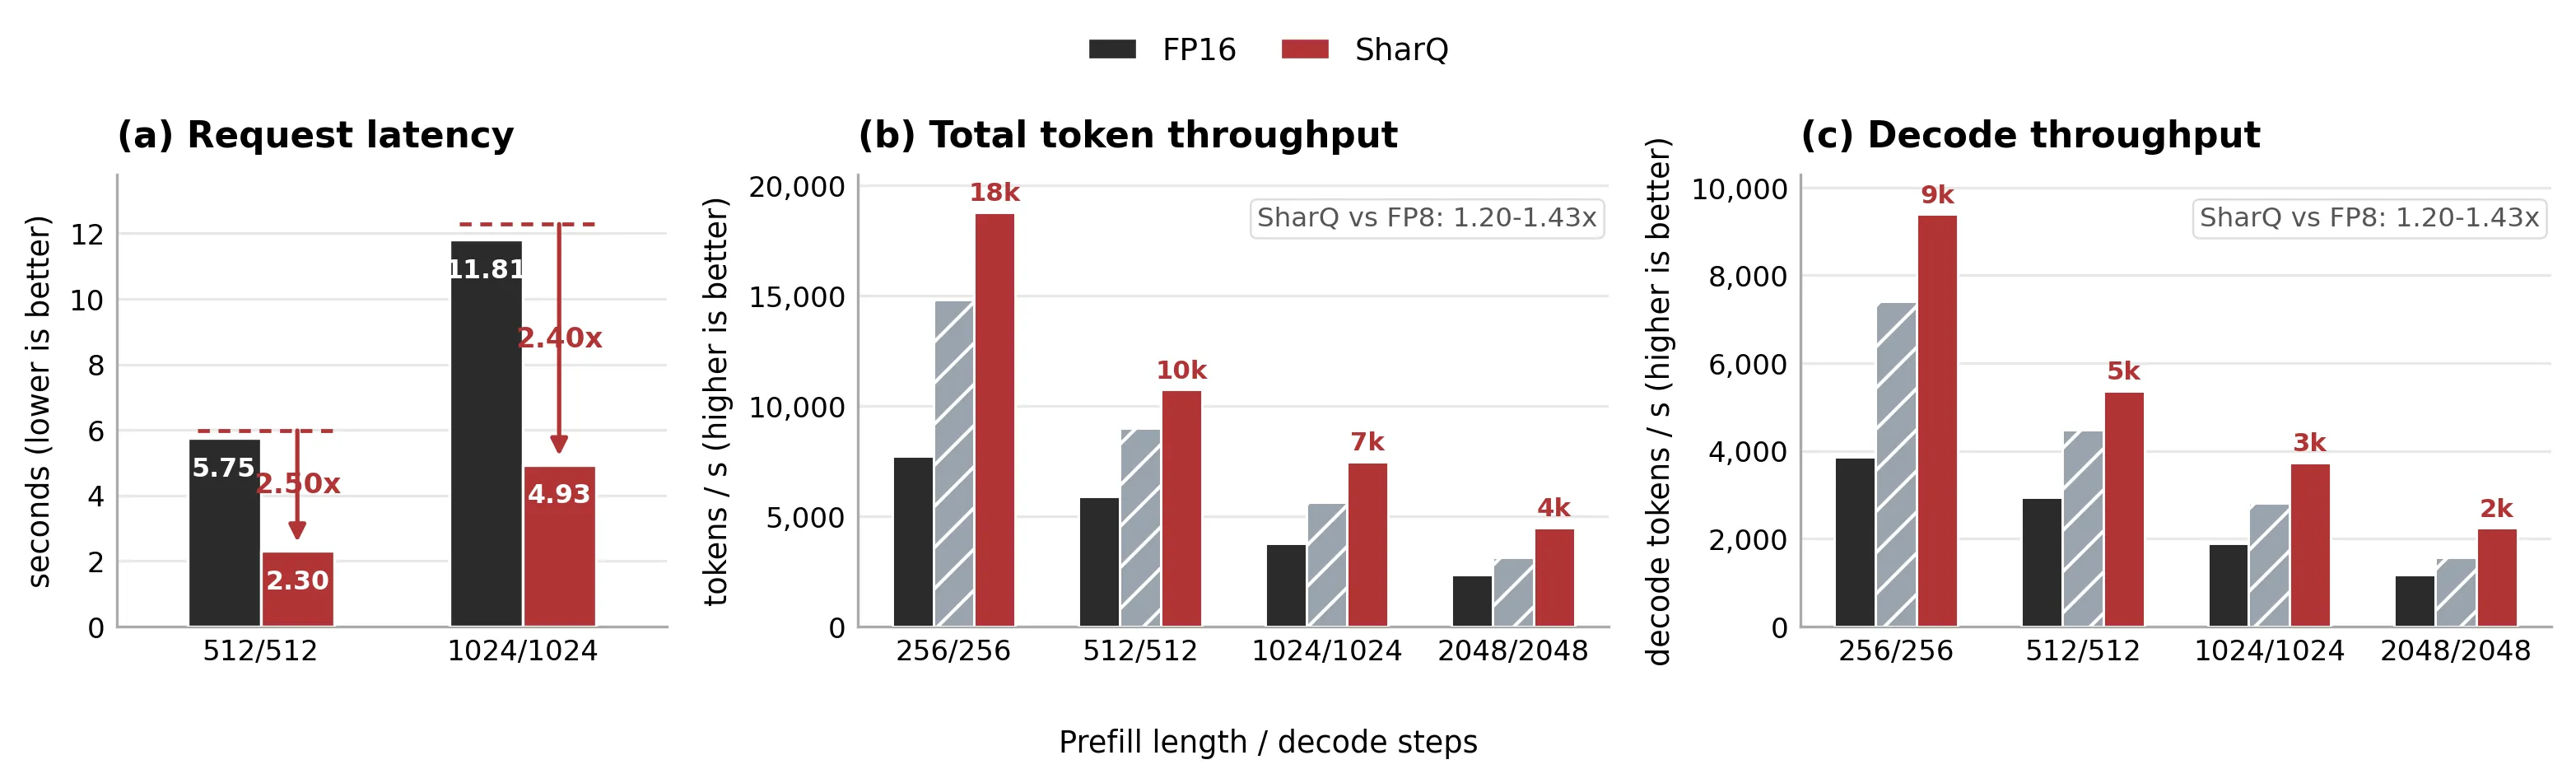
- 相对 FP16 延迟降 55–60%(seqlen 256: 2.85s → 1.17s = 2.4×;seqlen 2048: 24.88s → 11.11s = 2.2×)
- 相对 FP16 总吞吐 1.8–2.4×
- 相对 FP8 总吞吐 1.2–1.4×(seqlen 2048: 4491 vs 3146 tok/s = 1.43×)
Table 3(Wan2.2-T2V-A14B 4×RTX 5090):
| Method | 480P | 720P |
|---|---|---|
| FP16 | 223.41s | 717.88s |
| SharQ | 182.21s (1.23×) | 648.04s (1.11×) |
| SharQ+SageAttention | 141.63s (1.58×) | 457.88s (1.57×) |
5.3 消融
FP4 格式泛化(Qwen3-30B-A3B):SharQ 对 NVFP4/HiF4/MXFP4 均有增益。MXFP4 最弱(幂次2 scale + 大组),SharQ 让 WikiText2 从 9.70 降到 9.19(−0.51),HellaSwag +1.36pp、Lambada +2.84pp、WinoGrande +1.82pp、BoolQ +0.80pp。
Sparse/Dense 路径组合(Table 5, NVFP4, Llama-3.1-8B):
| 组合 | WikiText2↓ | MMLU |
|---|---|---|
| Sparse only | 82.95 | 25.78 |
| Dense+Dense | 6.63 | 63.61 |
| Sparse+Sparse | 6.95 | 61.93 |
| SharQ (Sparse+Dense residual) | 6.73 | 63.76 |
只用 sparse 灾难性失败(信息全丢),Sparse+Sparse 与 NVFP4 baseline 打平,SharQ 稀疏骨干 + dense 残差匹敌纯 dense 双路径但保留稀疏加速,验证不对称分解是关键。
Kernel 延迟拆解:
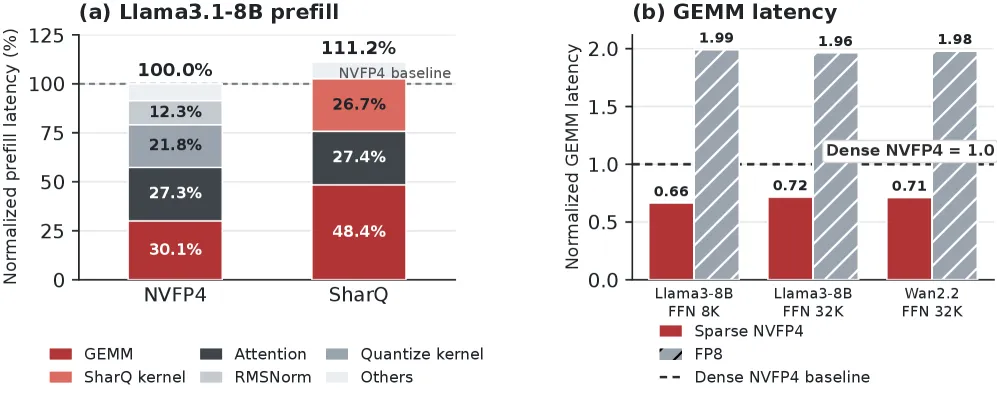
- SharQ 单一 fused kernel 取代原来分离的 Quantize + RMSNorm;
- Sparse NVFP4 GEMM 延迟 = dense NVFP4 的 0.66–0.72×;
- FP8 延迟基本是 dense NVFP4 的 ~2×。
六、总结
核心贡献
- 将 FP4 量化与 N:M 半结构化稀疏协同用作推理原语,免训练、免校准、免模型专用调参;
- 相对量化后骨干定义残差是理论关键,把 sparsification 和 quantization 两类误差合并为单一残差;
- 共享 FP4 权重 + path-specific scale views + fused preparation kernel 让方案在真实硬件(Blackwell RTX 5090)跑得动;
- 语言 / MoE / VLM / 视频扩散全场景验证。
技术影响
- 展示 FP4 + N:M sparsity 硬件路径的第一条”可组合、精度好”实践;
- 定义了一种输入自适应 outlier 提取的推理时压缩范式,与 SmoothQuant/AWQ 等离线离群处理正交;
- 与 SageAttention 等 attention 优化组合 1.57–1.58× 视频生成加速,展示了与其他 kernel 优化的可叠加性。
局限性
- 需要硬件支持 N:M 稀疏 Tensor Core(当前只在 Blackwell 上评估);
- 对 attention kernel 无直接优化(720P 视频生成加速 1.11× 反映了 attention 占比问题);
- 免训练场景下 gap 恢复上限约 63%,若允许 QAT 或校准可能进一步压缩。
七、参考资源
- 论文原文:https://arxiv.org/abs/2606.26587
- HTML 版本:https://arxiv.org/html/2606.26587v1
- 代码:论文注明 GitHub 仓库(见 abs 页 “code is available at this https URL”)
- 相关工作:NVFP4 (NVIDIA 2024)、MXFP4 (OCP Microscaling)、HiF4 (Luo et al. 2026)、SmoothQuant、AWQ、QuaRot、SpinQuant、vLLM、SageAttention