Mesh-RL: Coupled subgrid reinforcement learning
受有限元法与区域分解理论启发的强化学习加速框架:把状态空间沿列方向划分为 M 个重叠子网格,各自维护局部 Q_i;在重叠边界上通过边界一致 TD 更新耦合相邻子网格值函数(边界传播引理保证 Bellman 不动点保持)。不改奖励、不改 Bellman 算子、无显式规划,即可显著加速稀疏奖励下的价值传播。在 10×30 与 20×20 网格 50 洞环境中,M=6 让 Q-learning 累积奖励从 -175k 提升到 +454k;SARSA 从 -245k 提升到 +458k;Dyna-Q 亦获额外提升,最终奖励从 -4.3 → 47.9。
Mesh-RL: Coupled subgrid reinforcement learning
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Mesh-RL: Coupled subgrid reinforcement learning |
| 作者 | Behnam Gheshlaghi, Bahador Rashidi, Shahin Atakishiyev |
| 机构 | Independent Researchers / University of Alberta |
| 提交时间 | 2026-06-24 |
| arXiv | 2606.26333 |
| 分类 | cs.LG |
| 环境 | 稀疏奖励 hazard-dense grid-world(10×30、20×20,50 个洞) |
| 基础算法 | Q-learning / SARSA / Dyna-Q |
二、核心思想
问题定义:TD 强化学习在大规模或稀疏奖励环境中收敛缓慢——价值信息只能通过 Bellman 更新在状态空间局部扩散,距离目标较远的状态往往要经过大量回合才能获得可靠估计。
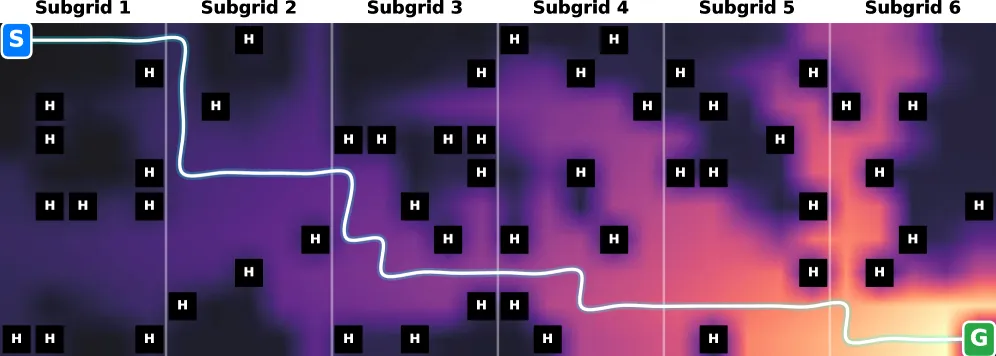
解决方案:借鉴科学计算中有限元法 (FEM) 与区域分解 (Domain Decomposition) 的思想,把 MDP 的状态空间沿列方向切成 个重叠子网格:
- 每个子网格 维护自己的局部 Q 函数 ;
- 相邻子网格在重叠区 上进行边界一致 TD 更新(boundary-consistent TD update),保证局部值函数在接缝处协调;
- 不修改奖励函数、不修改 Bellman 算子、不引入显式规划机制 —— 纯粹用”空间分解”加速远距离 credit assignment。
三、技术架构 / 方法
3.1 MDP 与经典 TD
3.2 Mesh 分解与 Mandatory-Passage Property
状态空间按列切成 个重叠子网格:
重叠边界 。Mandatory-Passage 假设:起点在最左子网格 ,目标在最右子网格 ,任何成功轨迹必须依次穿过所有边界。
3.3 局部 + 边界感知的 TD 更新
在子网格内部使用普通 TD 更新;当状态处于重叠边界 时,同时更新 与 ,并强制它们在此处一致:
作者证明了 Boundary Propagation Lemma:只要边界处的值一致,就能在稀疏奖励下逃出次优 plateau,把来自右侧目标的价值信息迅速传播到左侧起点。
3.4 全局 Stitched Value Function 与收敛性
全局价值函数由各子网格 拼接(stitched)得到,作者证明其满足原 MDP 的 Bellman 不动点方程(Bellman Fixed-Point Preservation),Mesh-RL 的收敛结论继承经典 Bellman 迭代。这也意味着算法收敛到的是原问题的最优策略,不引入额外偏差。
四、核心创新
| 创新点 | 描述 |
|---|---|
| FEM/DD 思路引入 RL | 首次系统地将有限元法与区域分解理论迁移到 TD 学习 |
| 重叠子网格 + 边界一致 TD | 通过边界更新耦合子网格,实现全局连贯的价值传播 |
| 无需改奖励/Bellman/规划 | 完全正交于奖励塑造、层次 RL、model-based planning,可与任意 TD 算法组合 |
| Bellman 不动点保持 | 理论证明拼接价值函数仍收敛到原 MDP 的最优解 |
| 直接加速 Dyna-Q | 即便 Dyna-Q 已经内含规划,Mesh 分解仍带来额外增益 |
五、实验结果
环境:10×30 与 20×20 网格,随机放置 50 个 hazard 洞;10 个随机种子,每次 10,000 episodes。指标包含累计奖励、平均奖励、Final Reward、Peak Reward、Peak Episode、Peak Time、Total Time。
5.1 20×20 网格 (50 holes)
| 算法 | 变体 | 累计奖励 | Final Reward | Peak Reward | Peak Ep |
|---|---|---|---|---|---|
| Q | 基线 | -175,022 | 9.3 | 16.3 | 2019 |
| Q | M=2 | 105,416 | 47.5 | 55.0 | 2592 |
| Q | M=6 | 454,641 | 63.0 | 63.0 | 963 |
| SARSA | 基线 | -245,010 | 9.1 | 16.9 | 3227 |
| SARSA | M=6 | 458,163 | 63.0 | 63.0 | 944 |
| Dyna-Q | 基线 | 531,434 | 63.0 | 63.0 | 620 |
| Dyna-Q | M=6 | 566,416 | 63.0 | 63.0 | 383 |
5.2 10×30 网格 (50 holes)
| 算法 | 变体 | 累计奖励 | Final Reward |
|---|---|---|---|
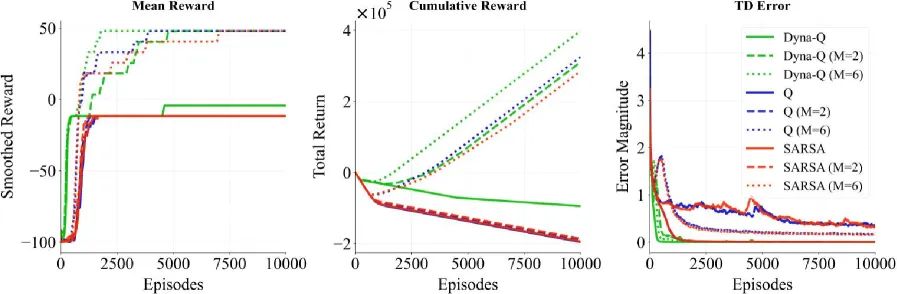
| Q | 基线 | -195,500 | -11.7 |
| Q | M=6 | 324,900 | 47.9 |
| SARSA | 基线 | -193,600 | -11.7 |
| SARSA | M=6 | 285,000 | 47.9 |
| Dyna-Q | 基线 | -94,400 | -4.3 |
| Dyna-Q | M=2 | 310,500 | 47.9 |
| Dyna-Q | M=6 | 398,200 | 47.9 |
关键观察:
- 纯 Q-learning、SARSA 在 10×30 长条形网格上完全无法学到正奖励(Final Reward ≈ -11.7),加入 Mesh-RL M=6 后一举跃升到 +47.9。
- Peak Episode 大幅提前:20×20 环境下 Q-learning peak 从第 2019 集提前到 963 集,接近减半。
- 即便 Dyna-Q 已经带有内置规划,Mesh 分解仍提升累积奖励 6.6%(20×20,531k→566k)与 322%(10×30,-94k→+398k)。
5.3 网格分辨率的影响
- 更高分辨率(更大 )持续维持探索,避免过早收敛,把 value propagation 加速到远端。
- 主要”打开一条通道”, 在长条网格上把整条价值链路全部激活。

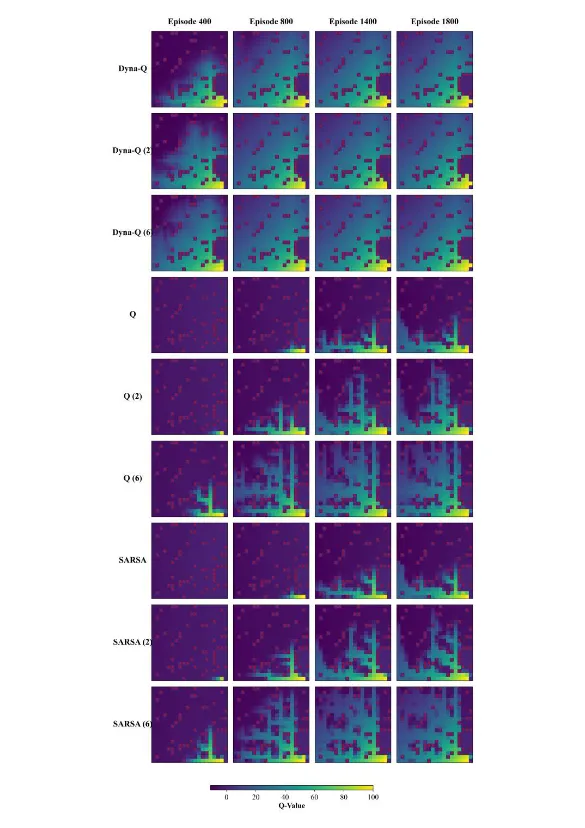
价值热力图显示:基线 Q/SARSA 的价值仅在目标附近呈”局部气泡”,Mesh-RL (M=6) 呈现从目标一路延伸到起点的清晰梯度带。
六、总结
核心贡献
- 提出 Mesh-RL:将 FEM/区域分解引入 TD 强化学习,通过重叠子网格 + 边界一致更新解决长距离 credit assignment。
- 证明拼接价值函数的 Bellman 不动点保持性和边界传播引理。
- 在 20×20 与 10×30 稀疏奖励网格 world 上,让 Q-learning / SARSA 从”完全学不会”跃升到接近满分。
技术影响
- 提供一种正交于 hierarchical RL / model-based planning 的稀疏奖励加速手段,且与已有算法兼容。
- 跨学科启发:将科学计算的数值方法迁移到 RL 的价值传播问题。
局限性
- 依赖 Mandatory-Passage 假设(起点—目标沿单轴分布),推广到任意拓扑仍需研究。
- 只在 tabular grid-world 验证,尚未扩展到函数逼近(DQN、Actor-Critic)与连续状态空间。
- 高分辨率 带来更多子网格与更长 total actions(20×20 up to 1.3M actions),计算开销升高。
七、参考资源
- arXiv 论文:https://arxiv.org/abs/2606.26333
- HTML:https://arxiv.org/html/2606.26333v1
- 相关工作:Finite Element Method、Additive Schwarz Domain Decomposition、Dyna-Q、Options Framework、Hierarchical RL