Accelerating Disaggregated RL for Visual Generative LLMs with Diffusion-Based Parallelism and Trainer-Assisted Generation
DigenRL:为扩散生成模型 RL 后训练设计的解耦式(disaggregated)系统。用 Generation-Axis Pipeline (GAP) 沿生成维度细粒度流水,Timestep Parallelism (TSP) 替代数据并行提升 trainer GPU 利用率,Elastic Trainer-Assisted Generation (TAG) 让 trainer 空闲时协助 rollout,Trajectory-Consistent Stale Sync (TCSS) 严格约束一步陈旧样本。相比 VeRL-Omni 在 QwenImage 20B 上加速 1.56×–2.21×;HunyuanVideo 1.13×–1.49×;异构 GPU 场景 1.46×–1.85×;消融显示 GAP+TSP+TAG+TCSS 累计将 speedup 从 naive 1.52× 提升到 3.34×。
Accelerating Disaggregated RL for Visual Generative LLMs with Diffusion-Based Parallelism and Trainer-Assisted Generation (DigenRL)
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Accelerating Disaggregated RL for Visual Generative LLMs with Diffusion-Based Parallelism and Trainer-Assisted Generation |
| 作者 | Sijie Wang, Zhengyu Qing, Zhiqiang Tan, Yiming Yin, Yeqing Zhang, Yaoyuan Wang, Qiang Wang, Xiaowen Chu, Shaohuai Shi |
| 机构 | 哈尔滨工业大学(深圳)、香港科技大学(广州)、华为 |
| 提交时间 | 2026-06-23(v1),2026-06-24(v2) |
| arXiv | 2606.24369 |
| 分类 | cs.AI / cs.DC / cs.NI / cs.PF |
| 目标场景 | 扩散生成模型(T2I / 视频)RL 后训练:QwenImage 20B、HunyuanVideo、Wan2.1 14B、FLUX.1 12B |
二、核心思想
问题定义:主流 RL 后训练系统(veRL、OpenRLHF、AReaL、StreamRL 等)为自回归 LLM 设计,扩散生成模型的 RL(DanceGRPO、FlowGRPO 等)仍以 colocated 执行(生成器与 trainer 共用同一批 GPU)为主。这带来三大痛点:
- 资源耦合:rollout 与训练无法独立扩缩容;
- 异构 GPU 不友好:整批 GPU 只能同一时刻做一件事;
- 调度死板:生成的 tightly-coupled denoising trajectory 无法像 AR 那样按 prompt 切分。
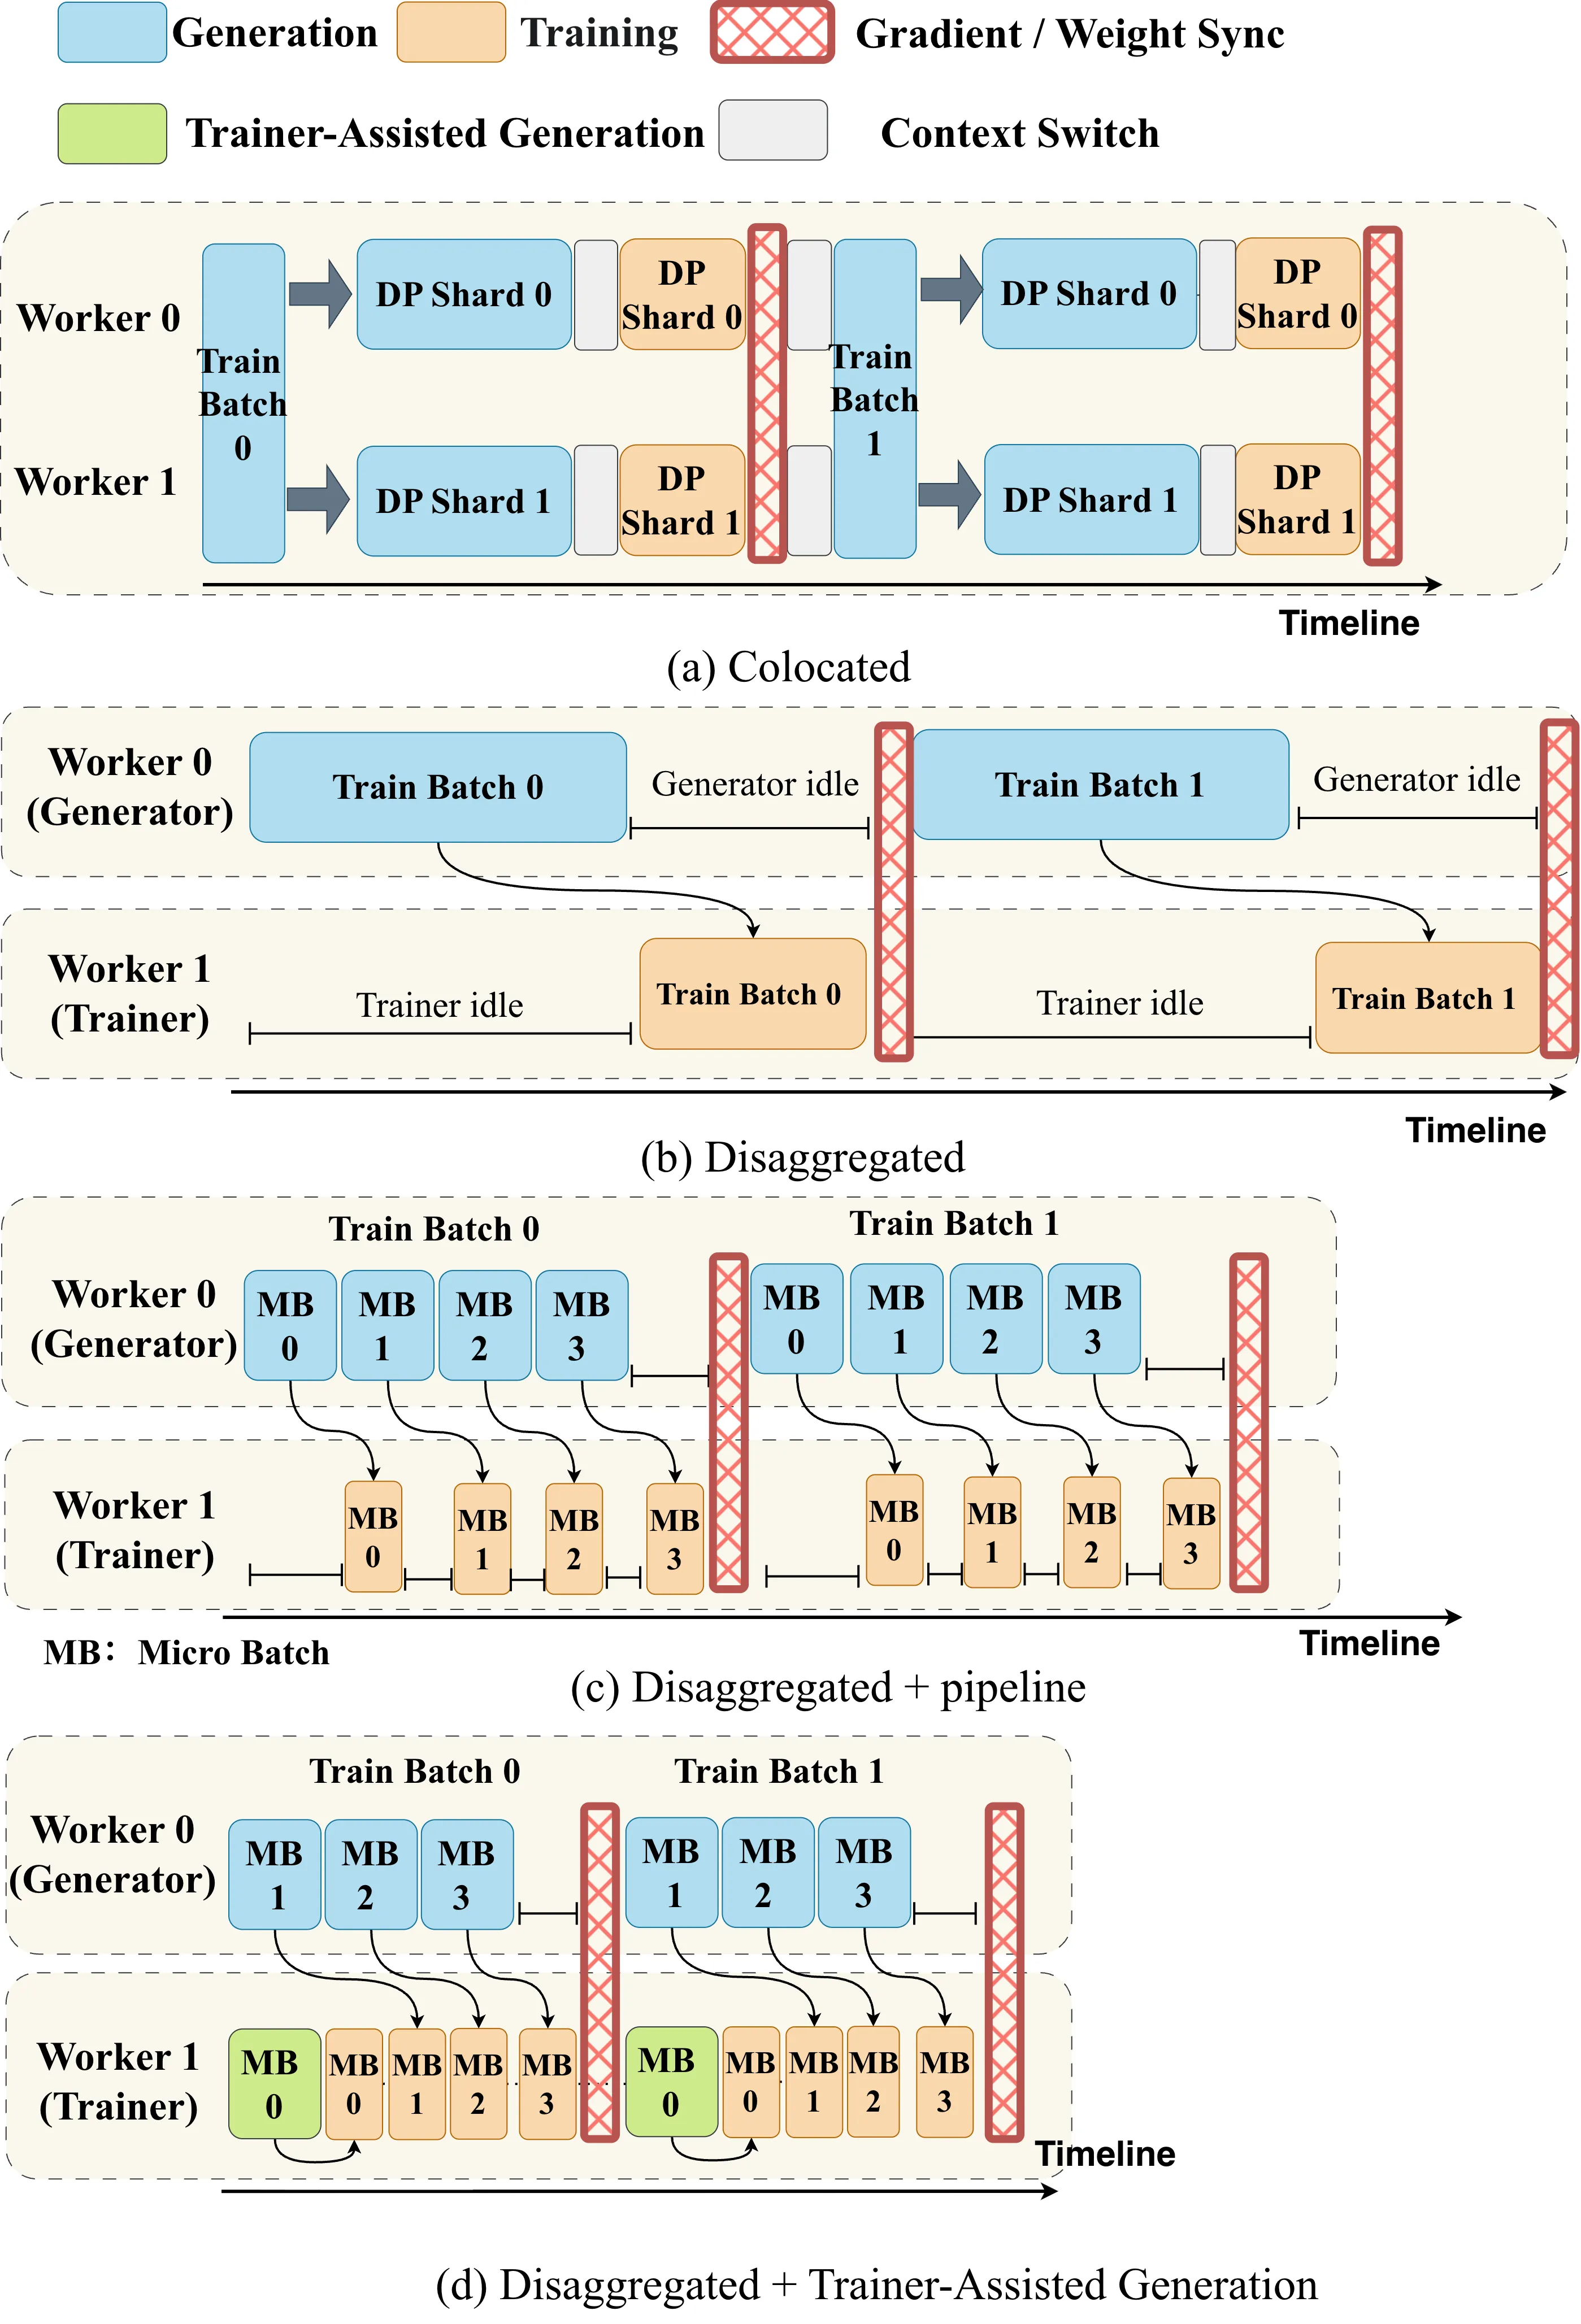
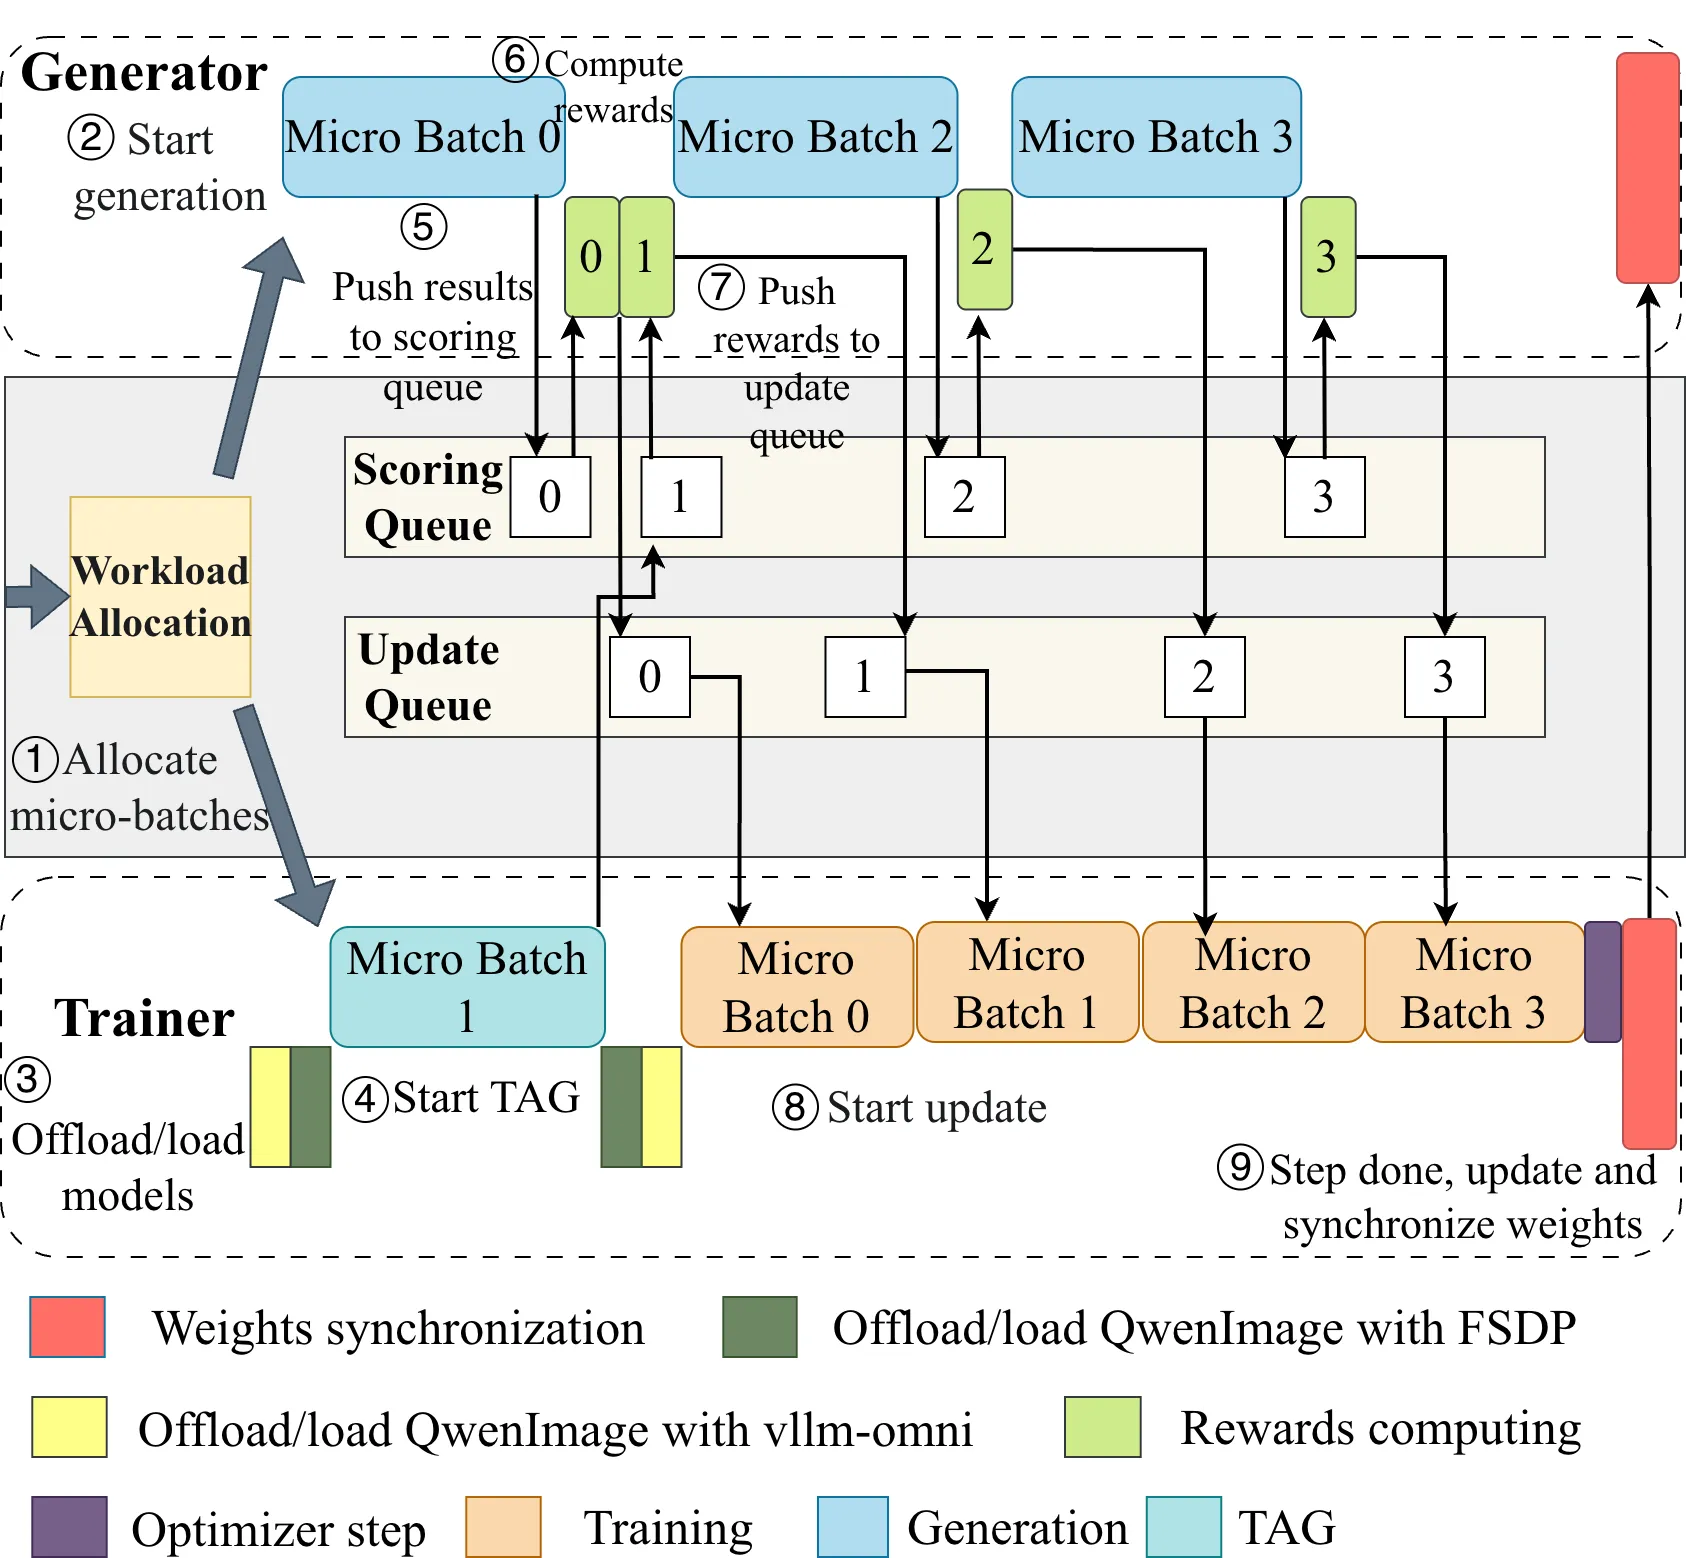
解决方案 (DigenRL):一个专为扩散生成模型设计的解耦式 (disaggregated) RL 框架,把 generator 与 trainer 分配到不同 GPU,并叠加四大机制填平流水线气泡:
- Generation-Axis Pipeline (GAP):沿”生成 timestep”维度切 micro-batch,而不是 batch 维度;
- Timestep Parallelism (TSP):把训练侧的 per-timestep loss 计算并行化,代替数据并行;
- Elastic Trainer-Assisted Generation (TAG):trainer GPU 空闲时动态”客串”生成;
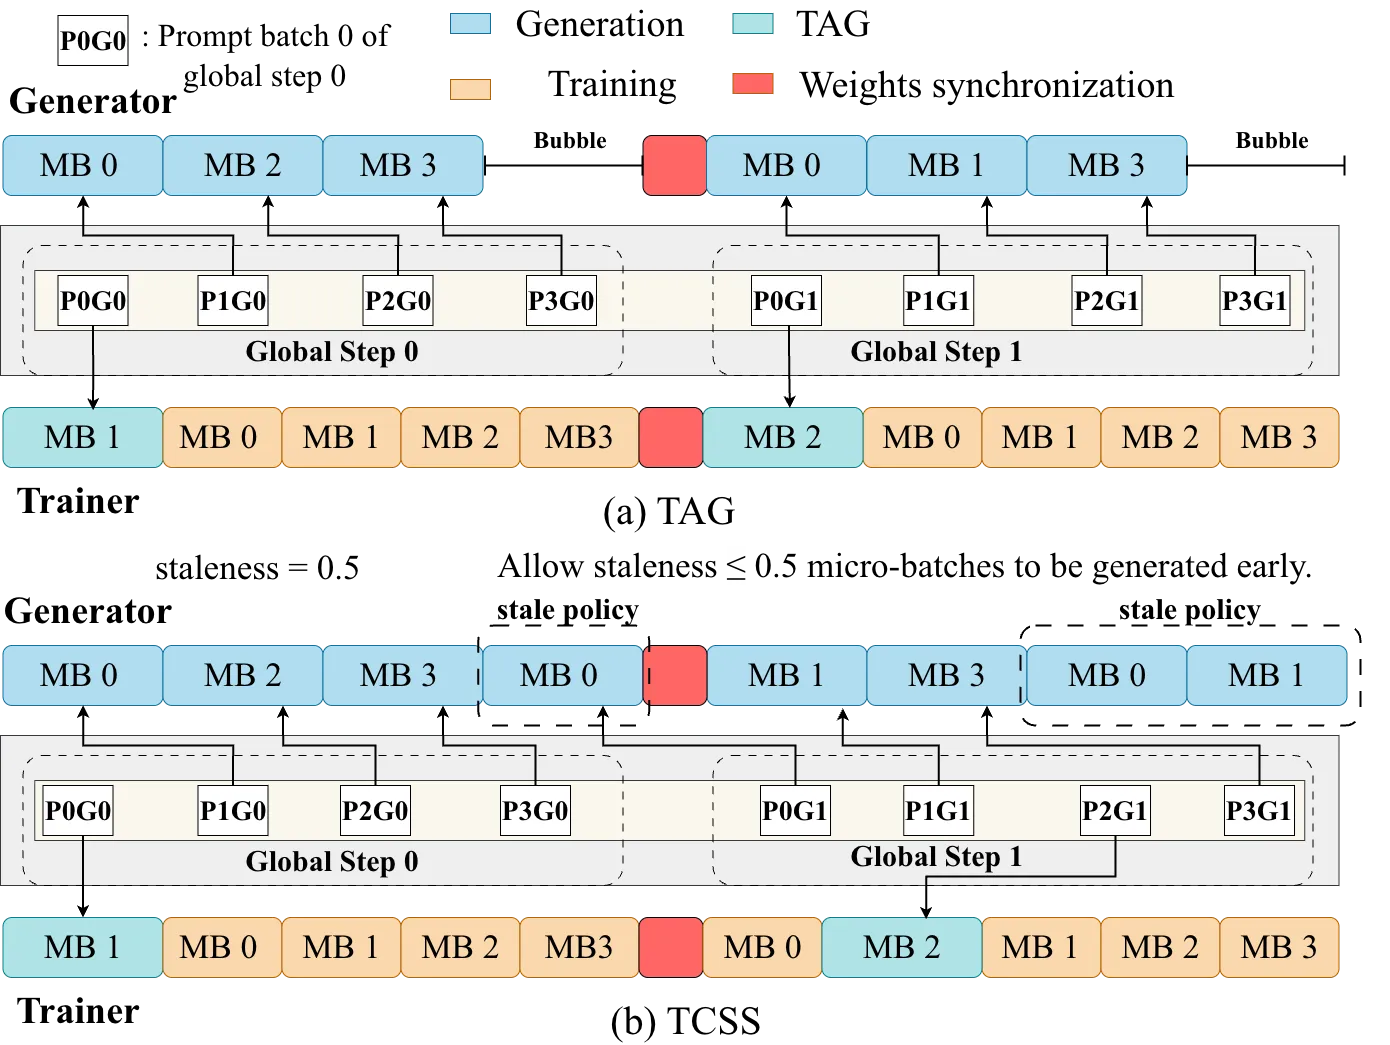
- Trajectory-Consistent Stale Sync (TCSS):一步陈旧同步,抹平尾部气泡但保证收敛。
三、技术架构 / 方法
3.1 系统总览
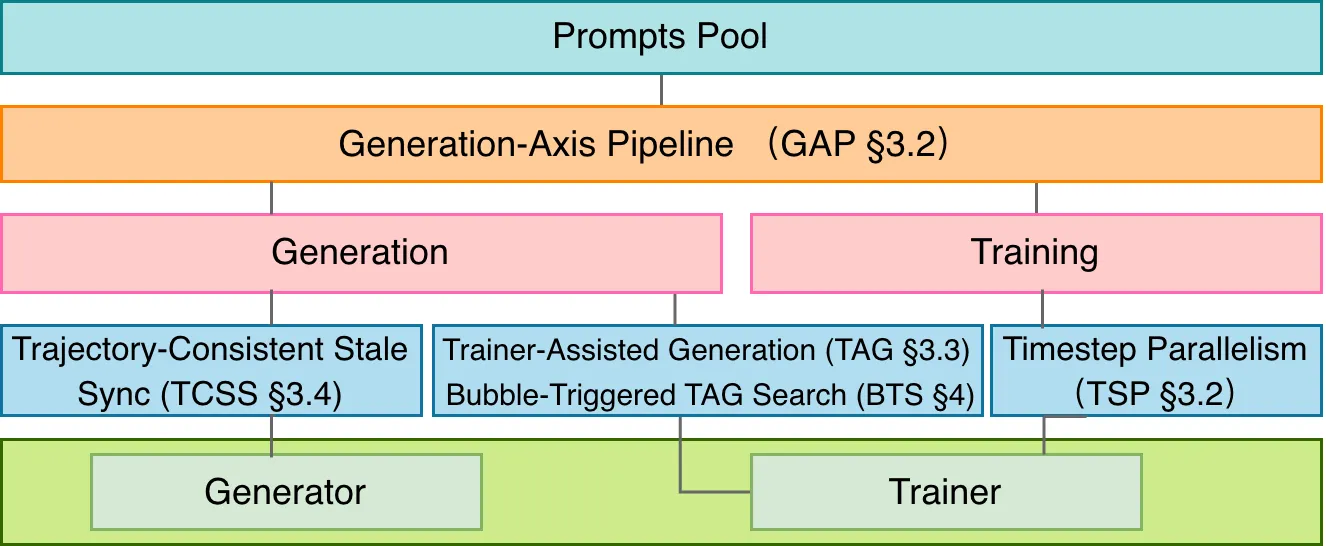
- 用户指定 mini-batch 与 micro-batch 大小 → GAP 沿生成维度切 micro-batch 并流水;
- Trainer 侧启用 TSP 替代常规数据并行;
- 运行时 TAG 判断是否让 trainer 协助生成;
- 若允许一步 off-policy,TCSS 利用最后一个 micro-batch bubble 生成一步陈旧样本。
3.2 Diffusion-Based Parallelism
Generation-Axis Pipeline (GAP):AR 系统按 prompt/sequence 长度切 micro-batch;扩散生成 RL 中 batch 通常只有 32,且轨迹紧耦合。DigenRL 沿**denoising 时间步(生成维度)**切 micro-batch,可获得更细粒度、更均衡的流水单元。
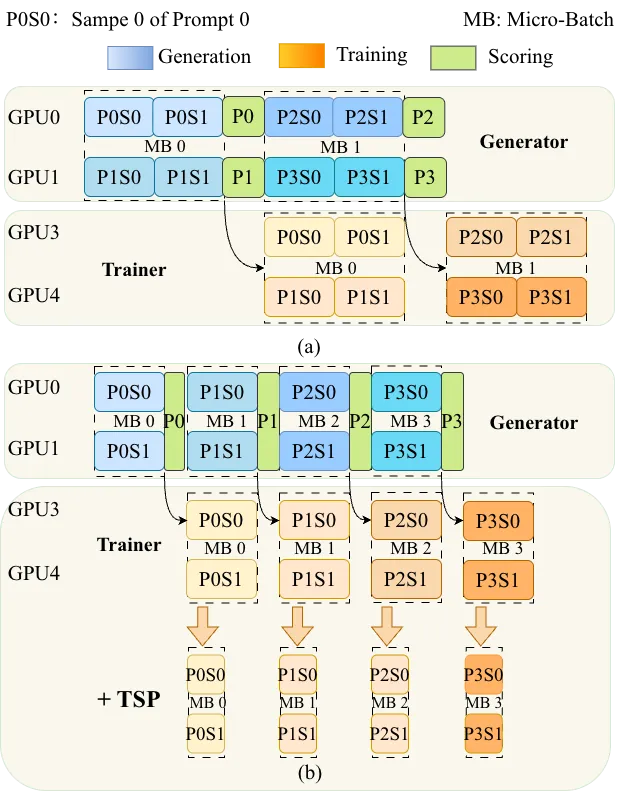
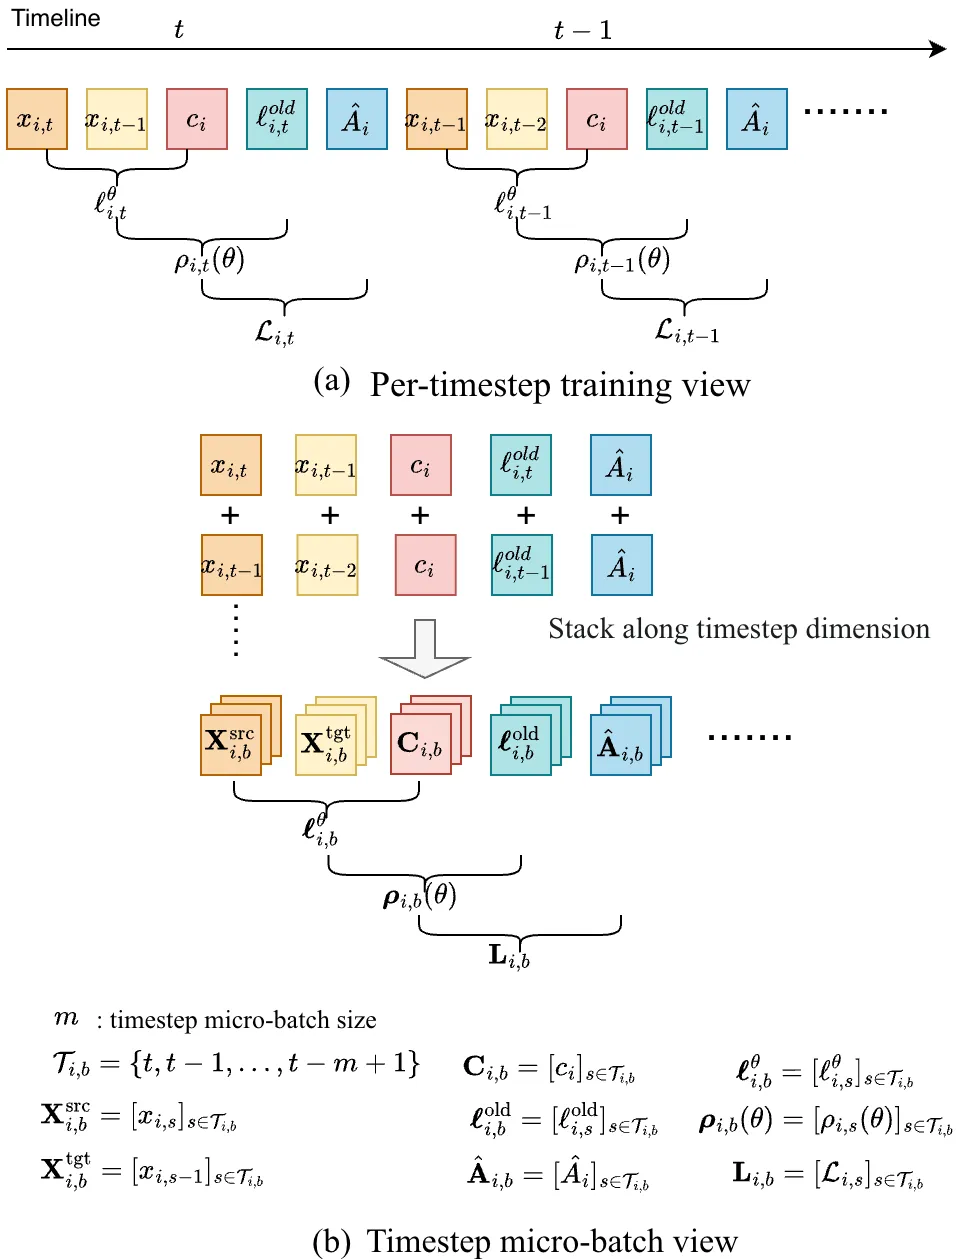
Timestep Parallelism (TSP):训练时的 per-timestep loss 传统上按数据并行,本文让不同 timestep 的 loss 计算分片到不同 GPU,避免 trainer 端小 batch 下 GPU 利用率低的问题。
3.3 Elastic Trainer-Assisted Generation (TAG)
生成阶段常慢于训练。TAG 让空闲 trainer GPU 动态执行一部分 rollout micro-batch,缩短生成时间。
关键设计:
- Trainer 参数与 generator 保持一致时才能协助(否则会破坏 on-policy 语义);
- 通过双队列调度机制协调 TAG micro-batch 与主训练任务。
3.4 Trajectory-Consistent Stale Sync (TCSS)
严格 on-policy 训练会在最后一个 micro-batch 处留下”尾部气泡”。TCSS 允许至多一步陈旧样本占据这段气泡:
- 训练用的策略参数与采样时策略至多相差 1 个 update step;
- 通过 Algorithm 1(Stitched TD 式的 stale sync)确保 log-prob、reward、policy version 三者一致;
- 理论保证与 on-policy 训练收敛趋势一致,实验中 reward 曲线基本重合。
3.5 Recursive Bubble-Triggered TAG Search
TAG 是否开启 / 每次填入多少个 micro-batch 由调度器决定。作者提出 Recursive Bubble-Triggered Search (Algorithm 2):
- 只在检测到新气泡时触发;
- 用”状态压缩”(pending / ready / completed 计数 + generator/trainer 时间戳)把 搜索空间压到可缓存;
- 单次搜索开销远小于 rollout / training 时间(Figure 10 显示即使 B=128,t/g=0.1 时搜索仍可忽略)。
四、核心创新
| 创新点 | 描述 |
|---|---|
| Disaggregated Diffusion-RL | 首个针对扩散生成 LLM 的解耦式 RL 系统,把 generator 与 trainer 分配到不同 GPU |
| Generation-Axis Pipeline | 沿 denoising 时间步切 micro-batch,比传统 batch 维度更细粒度、更易均衡 |
| Timestep Parallelism | 用 TSP 替代 trainer 端数据并行,提升小 batch RL 后训练时的 GPU 利用率 |
| Elastic TAG | 让 trainer GPU 动态协助 rollout,抹平生成瓶颈 |
| One-step 约束 TCSS | 只允许一步 off-policy,理论可控、系统吞吐进一步提升 |
| Recursive TAG Search | 状态压缩 + 记忆化,把指数级搜索降为可忽略开销 |
五、实验结果
Testbed:A(32×48GB GPU,200Gbps)、B(32×80GB GPU,400Gbps)、C(16×96GB GPU,200Gbps HDR IB)。
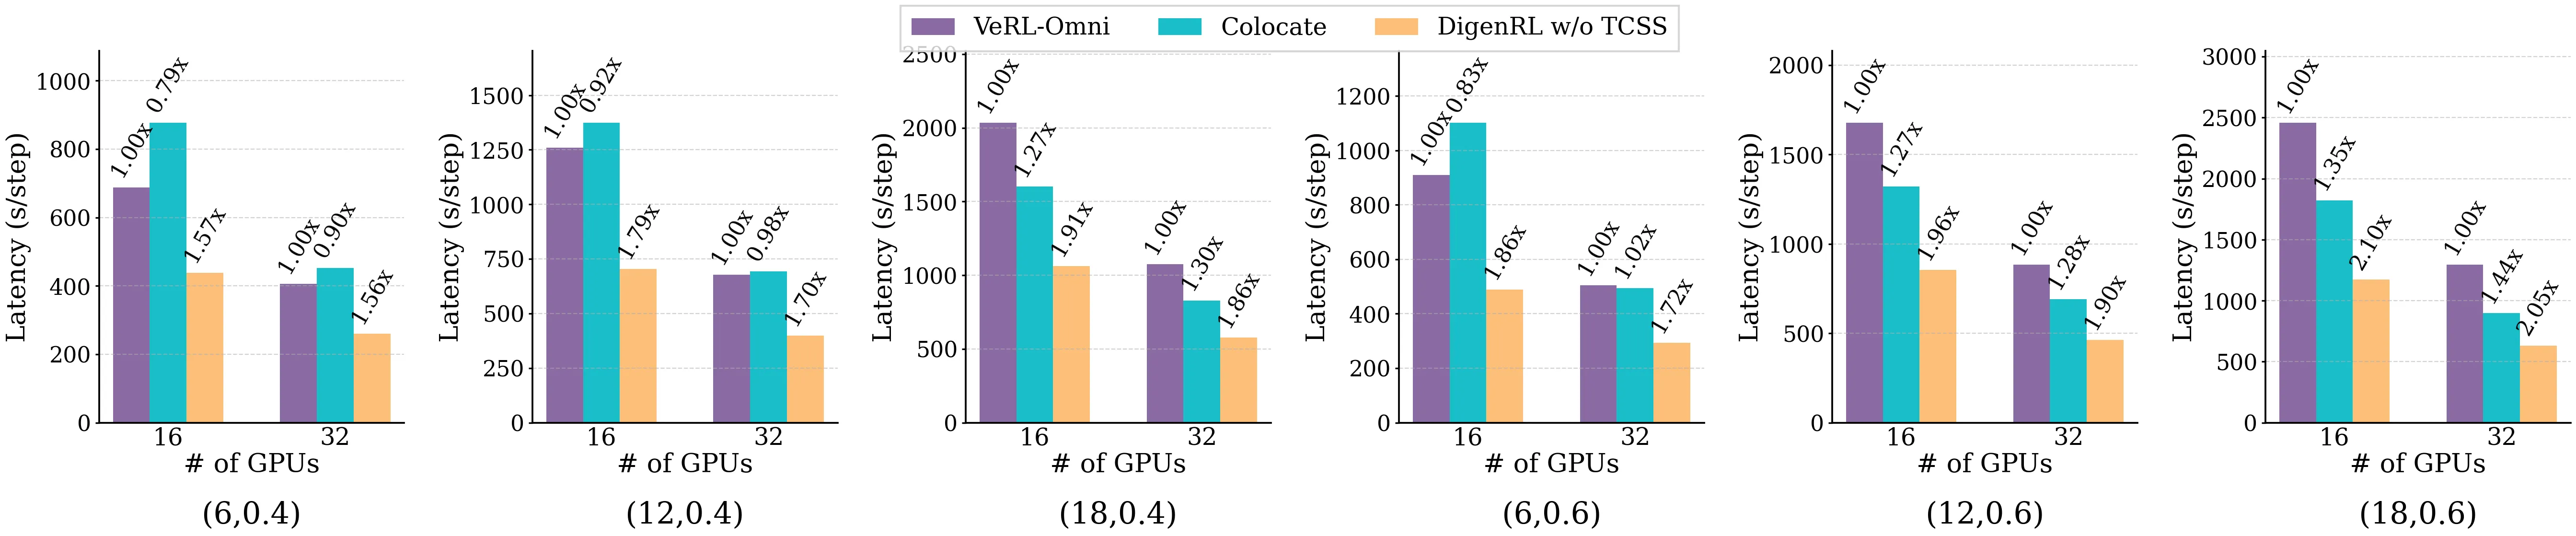
5.1 与 VeRL-Omni 对比(QwenImage 20B + FlowGRPO,Testbed B,512×512,disable TCSS 保持 on-policy)
- DigenRL 相较 VeRL-Omni 加速 1.56× – 2.21×。
- 原因:vLLM-Omni 大 batch 下异步队列长尾拖累;DigenRL 用 GAP 把大 batch 拆细流水,并结合高 TSP 并行度。
5.2 与 Native Colocation 对比
| 模型 | Testbed | Sampling steps | DigenRL 加速 | + TCSS |
|---|---|---|---|---|
| HunyuanVideo | A | 20/30/40 | 1.04× – 1.37× | 1.13× – 1.49× |
| Wan2.1 14B | B | 20/30/40 | 1.13× – 1.34× | 1.21× – 1.45× |
| FLUX.1 12B | B (32 GPU) | – | 1.06× – 1.21× | – |
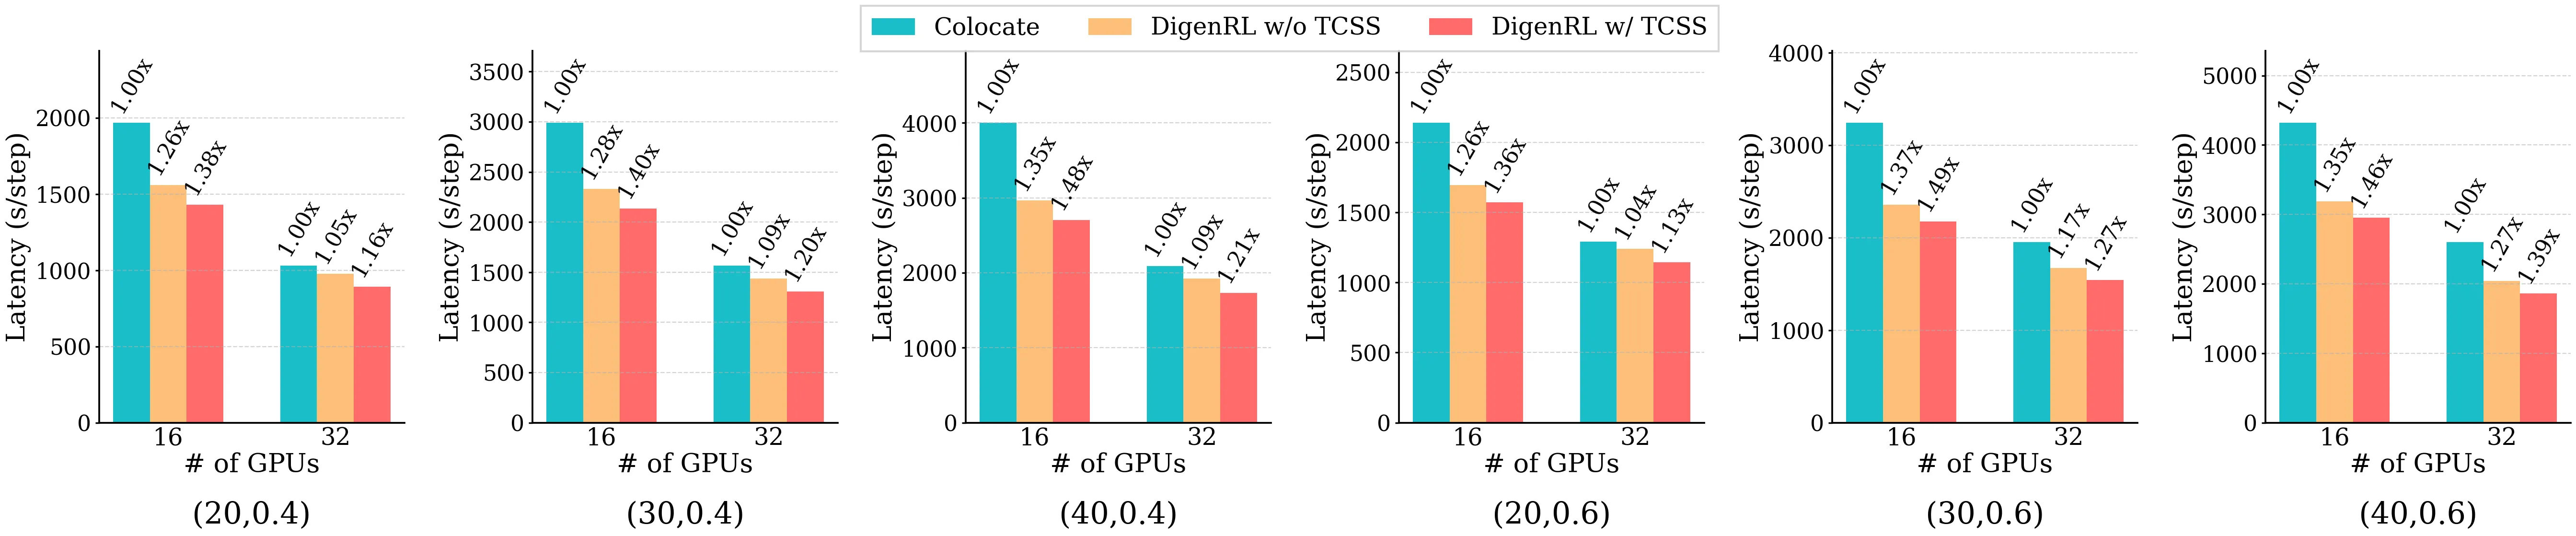
- 采样步数越多、timestep fraction 越大,DigenRL 加速越显著(计算占比大 → 通信/调度开销被摊薄)。
- 32 GPU 时驱动调度压力增大,Testbed B 的 CPU/带宽更强,因此保持加速;Testbed A 上 32 GPU 增益弱于 16 GPU。
5.3 异构 GPU(Testbed A + Testbed C 各 8 GPU)
- HunyuanVideo,colocated 基线只能受限于弱端内存;DigenRL 把 trainer 放在强端,加速 1.46× → 1.85×。
5.4 TCSS 训练效果
- 训练 FLUX.1-dev 12B,staleness=0.5 时 TCSS 的 reward 曲线与 on-policy 基本重合,说明”最多一步陈旧”不损害收敛。
5.5 消融(HunyuanVideo;相对 naive 解耦执行的累计 speedup)
| 累积开启的优化 | 加速下限 → 上限 |
|---|---|
| 仅 GAP | 1.52× → 1.84× |
| + TSP | 1.62× → 2.14× |
| + TAG | 2.28× → 3.05× |
| + TCSS | 2.49× → 3.34× |
Wan2.1-14B 上类似结论:GAP 1.58→1.70×,+TSP 1.71→2.10×,+TAG 2.27→2.79×,+TCSS 2.44→2.85×。
六、总结
核心贡献
- 首个针对扩散生成模型 RL 后训练的 disaggregated 系统 DigenRL,全面对标 veRL / veRL-Omni。
- 提出 GAP + TSP + TAG + TCSS 四件套,以及基于状态压缩的 Recursive TAG Search 调度算法。
- QwenImage 20B 加速 1.56×–2.21×、HunyuanVideo 1.13×–1.49×、异构 1.46×–1.85×;消融显示四件套累计提升 speedup 从 1.52× 到 3.34×。
技术影响
- 补齐 AR 大模型 RL(AReaL / StreamRL / Laminar 等)到多模态扩散 RL 的系统栈缺口。
- TSP、TAG、TCSS 思路可迁移到 flow matching、image-to-video 等其他基于 denoising trajectory 的强化学习工作流。
局限性
- 仅评测扩散 / 流匹配生成模型,对于混合 AR+扩散的多模态模型(例如统一 tokenized 世界模型)适用性未验证。
- TCSS 明确”一步陈旧”,跨越更长陈旧步长的策略(数十步 off-policy)不在讨论范围。
- 实验硬件均为 GPU 集群,缺少国产 NPU 或异构加速器的验证。
七、参考资源
- arXiv 论文:https://arxiv.org/abs/2606.24369
- HTML:https://arxiv.org/html/2606.24369v1
- 相关工作:veRL、veRL-Omni、AReaL、StreamRL、Laminar、RollArt、Weave、OrchestrRL、DanceGRPO、Flow-GRPO、DDPO