The Serialized Bridge:Blackwell GPU 机密计算下的 LLM 服务性能恢复
系统性刻画 Intel TDX + NVIDIA GPU-CC 机密计算下 CVM–GPU 桥被串行化的性能规律,并给出可迁移的运行时/加载器/KV 恢复策略;同时首次公开 B300 机密多 GPU NVSwitch 租户能力
The Serialized Bridge: Understanding and Recovering LLM Serving Performance under Blackwell GPU Confidential Computing
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | The Serialized Bridge: Understanding and Recovering LLM Serving Performance under Blackwell GPU Confidential Computing |
| 作者 | Hang Yin, Kevin Wang |
| 论文 | https://arxiv.org/abs/2606.23969 |
| HTML | https://arxiv.org/html/2606.23969v1 |
| 发布 | 2026-06-22(v1) |
| 分类 | cs.DC(分布式与集群计算)、cs.CR(密码学与安全)、cs.PF(性能) |
| 平台 | 两块 Blackwell 平台:RTX Pro 6000(PCIe,无 NVLink)+ B300 HGX;H200 作为 Hopper 边界对照 |
二、核心思想
GPU 机密计算(GPU Confidential Computing, GPU-CC)时代最早的问题是”机密模式下 GPU 慢多少?“。答案已经很清楚:几乎不慢。在 NVIDIA B300 上,BF16 matmul 在 CC 开/关下的比值是 0.998x,一个把 96,000 个 matmul 链接在一起的 CUDA graph 是 1.0012x。GPU 计算、Tensor Core、HBM 本身不是机密计算的成本所在。
然而端到端却完全不是这样:同一块 B300 上,稠密 LLM decode 损失 13–22%,MoE 服务损失高达 25%,KV-cache 恢复延迟上升 131%,加载 GPT-OSS-120B 需要 287 秒(硬件本可在一分钟内搬完同样的字节)。更糟的是相对损失随硬件代际增长:同一套 vLLM 栈在 RTX Pro 6000 上损失约 10%,在更快的 B300 上却损失约 26%——因为 GPU 加速的一切都在缩小,唯独机密数据通路没有。
问题定义
论文把所有这些损失定位到同一个地方、用同一个机制解释:在 GPU-CC 下,机密 VM(CVM)与 GPU 之间的桥被串行化了(the CVM–GPU bridge is serialized)。这个桥不是普通的 DMA——机密 CPU 域无法把私有内存暴露给设备,设备也无法把 CPR(Compute Protected Region)暴露给主机,因此命令和数据必须经过共享的 staging(bounce)缓冲、带加密/认证载荷来穿越。
解决方案概述
三条实测属性定义了桥的行为:
- 上下文内无并发(No concurrency within a context):一个 CUDA context 内所有跨设备流量共享一个固定的小型 secure copy channel 池。16 个 CUDA stream 各发 32 字节 D2H 拷贝在 CC 下几乎零并行(单流 40µs → 16 流 39µs),而 CC 关时能有 24% 的扩展。额外带宽只能靠增加 CUDA context 获得:1 个 context 只有 native 的 0.2x,24 个 context 恢复到 0.6–0.7x。
- 异步被静默撤销(Asynchrony is silently revoked):
copy_(..., non_blocking=True)到 pinned 内存这个 PyTorch 重叠传输的标准写法,在 CC 下会阻塞调用线程直到传输完成。API 接受了这个 hint,但在底层被中和。 - 每次穿越都交固定过路费(Every crossing pays a fixed toll):TDX guest 私有内存不能被 GPU DMA 读取,每次 H2D 拷贝都要过加密 staging,实测约 330µs/次 的固定 setup 成本——对小载荷而言比逐字节成本高三个数量级。
由此产生策略反转(policy inversion):一个在非机密 GPU 上能免费带来收益的调度优化,在 CC 下反而有害。
三、技术架构
3.1 桥模型(Bridge Model)
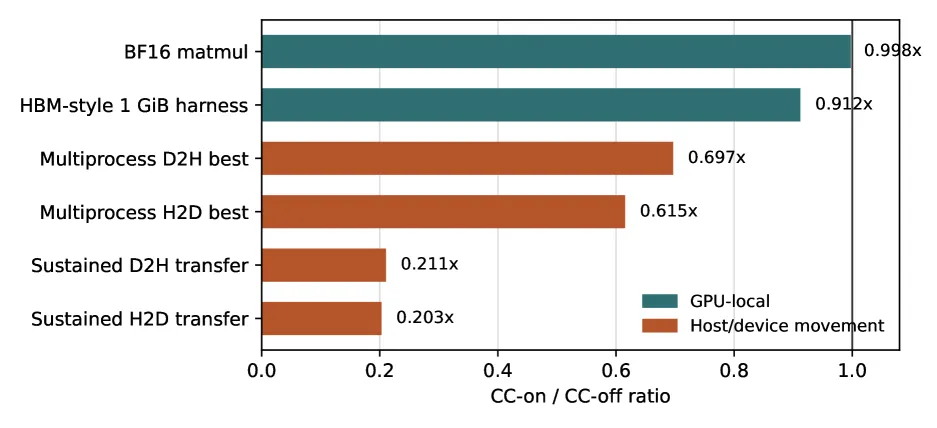
§4.1 计算与 GPU 本地内存处于对等(parity),只有跨桥被征税:
| B300 微基准 | CC-off | CC-on | CC-on / CC-off |
|---|---|---|---|
| BF16 matmul, 8192×8192 | 1573.70 TFLOPS | 1569.81 TFLOPS | 0.998x |
| 96k 链式 matmul(单 CUDA graph) | 7029.49 ms | 7037.80 ms | 1.0012x |
| HBM-style 1 GiB harness | 3156.06 GB/s | 2879.09 GB/s | 0.912x |
| 持续 H2D 传输,单 context | 55.48 GB/s | 11.26 GB/s | 0.203x |
| 持续 D2H 传输,单 context | 57.38 GB/s | 12.08 GB/s | 0.211x |
| 多进程 H2D 最佳 | 55.55 GB/s | 34.18 GB/s | 0.615x |
| 多进程 D2H 最佳 | 57.38 GB/s | 39.98 GB/s | 0.697x |
原因:CPR 内的 GPU 显存靠访问控制防火墙保护,而非逐字节加密,所以 GPU 本地计算/HBM 几乎免费;只有 PCIe staging 路径付密码学和 staging 成本。这一分裂——计算对等、搬运被税——是全文的组织性事实。
3.2 上下文级而非流级并发
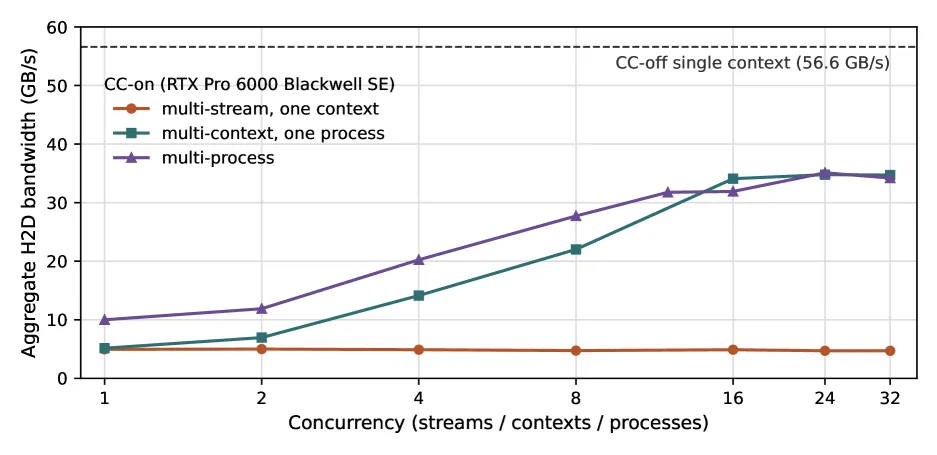
- 单 context 内加流无用:单 primary context 内的多流 harness 无论多少流都停在 4.9–5.0 GB/s H2D。
- 加 context 才扩展:Driver-API context 从 1 个(~5 GB/s)扩到 24 个(~35 GB/s);独立进程同理(10→35 GB/s)。
secure copy channel 是每 context 的资源,context 内一切流量串行化。这与 NVIDIA 运维文档所述的 context 数量上限——“源于 GPU DMA 引擎支持的 secure copy channel 数量的系统级限制”——一致。
H200 边界实验在同样区间落地(H2D 55.32→10.03 GB/s),证明”桥定律”不是 B300 特有:机制在 Hopper 上已存在,Blackwell 只是把它放大成更大的服务惩罚,因为更快的计算暴露了固定桥成本。
3.3 桥模型总结(§4.4)
- CUDA context 内跨设备传输在固定的 secure copy channel 池上串行;CC 下流级重叠是”虚构”。
- 每次穿越交固定 setup 过路费(观测约 330µs),因此许多小穿越比少数大穿越灾难性地更差。
- 额外带宽需要额外 CUDA context,每个都有昂贵的 secure 生命周期(8 worker 实测 5.2s 创建)。
- GPU 本地计算/内存对等,只有穿越被征税。
四、案例研究一:服务运行时的策略反转(§5)
4.1 工作负载相关的服务开销
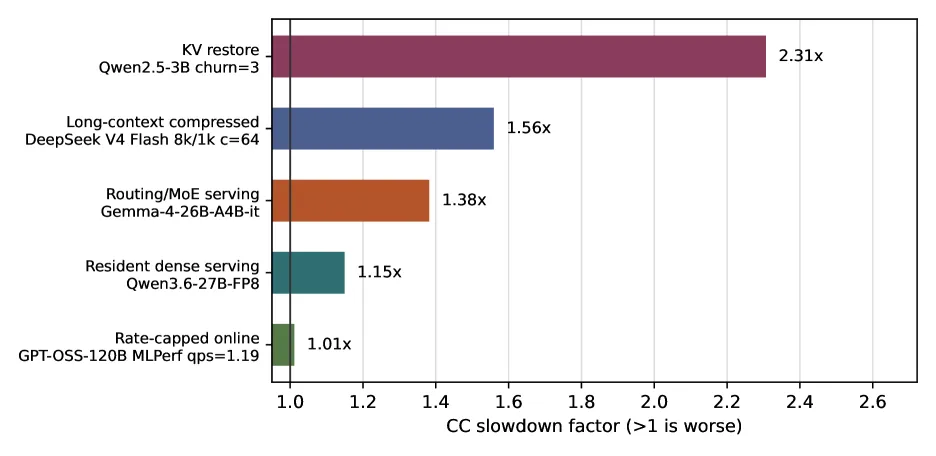
| 工作负载类别 | B300 CC-off | B300 CC-on | Δ |
|---|---|---|---|
| MLPerf 型在线服务,GPT-OSS-120B,qps=1.19 | 1193 tok/s | 1180 tok/s | −1.1% |
| 稠密 decode,Qwen3.6-27B-FP8(服务矩阵行) | 3302 tok/s | 2873 tok/s | −13.0% |
| 稠密 decode,Gemma-4-31B-it,c=128 | 2357 tok/s | 2022 tok/s | −14.2% |
| MoE decode,Qwen3.6-35B-A3B-FP8 | 5282 tok/s | 3981 tok/s | −24.7% |
| MoE decode,Gemma-4-26B-A4B-it | 5583 tok/s | 4040 tok/s | −27.6% |
| KV 恢复,Qwen2.5-3B churn=3 暖 TTFT | 405.4 ms | 935.2 ms | +131% |
结论:不存在单一”CC 开销百分比”——税是”跨桥频率 × 大小”的函数。限速在线服务掩盖了税(桥大多空闲);常驻稠密 decode 中等;MoE 更高(每步更频繁的小跨设备操作);KV 恢复(关键路径上的批量 CPU→GPU 搬运)是极端。
4.2 稠密 decode 差距的归因(§5.2)
在 Qwen3.6-27B-FP8、单 B300、c=128、1k/1k 上剖析:暖态 5070 tok/s(CC-off)vs 3729(CC-on),−26%,TPOT 21.5 vs 30.2ms。先给 GPU 洗清嫌疑(96k 链式 matmul 在同机对上 1.0012x)。PyTorch profiling 把减速归于一类操作:
| 父操作 | 调用数 | CC-off 均值 | CC-on 均值 | 单次减速 |
|---|---|---|---|---|
aten::_to_copy(分配 + H2D) | 1138 | 31.7µs | 1389µs | 44x |
| copy_ 进预分配 tensor | 2628 | 25.1µs | 31.0µs | 1.2x |
| _prepare_inputs pinned helper | 260 | 18.2µs | 18.4µs | 1.0x |
| attention 路径拷贝 | 192 | 27.0µs | 27.8µs | 1.0x |
aten::_to_copy(PyTorch 新 pinned 分配 + 设备传输路径)占 +1561ms 总减速中的 +1545ms。账目闭合:每次 1357µs delta × 1138 次 = 1.54s,正是观测到的 26% 吞吐下降。调用点是 vLLM 每步的 scatter-index / sampling-index 张量:每 decode 步 6 次小的新 pinned H2D 拷贝。这就是桥定律在应用层的体现——许多小穿越,各付约 330µs 过路费,每步新分配无 staging 复用,以 non_blocking 发出却被 CC 撤销了重叠。
4.3 反驳替代原因(§5.3)
用单变量 vLLM patch 逐一排除本地解释:小 H2D 批处理(−1.0ms,封顶)、持久 pinned 目标(+0.7ms,无收益)、去掉 stream/wait_stream(−0.7ms)、init 持久缓冲(−0.5ms)、FULL vs PIECEWISE CUDA graph(略差)。结构性 patch 都把 TPOT 停在 30–31ms,唯一起作用的是调度策略。
vLLM 默认 --async-scheduling 用第 N 步的 D2H 输出 drain 与第 N+1 步的准备/启动重叠:
| CC-off | CC-on | |
|---|---|---|
| DMA 并发 | 充裕 | 一次一个 secure channel |
| 意图重叠 | 真并行 | 虚构——传输仍串行 |
| 尝试开销 | ≈0 | stream setup + 在途传输仲裁 |
| 每步净值 | 省约 +3ms | 亏约 −4ms |
这就是策略反转:优化的全部收益假设并发 DMA,而这正是 secure 桥移除的唯一属性,其开销却仍在。H200 边界:无 CC 时 async 也帮忙(+10%),有 CC 时 async 与 sync 打平(3106 vs 3133 tok/s)——Hopper 是”中和”,Blackwell 是”反转”(默认优化变成错误策略)。
4.4 恢复层级
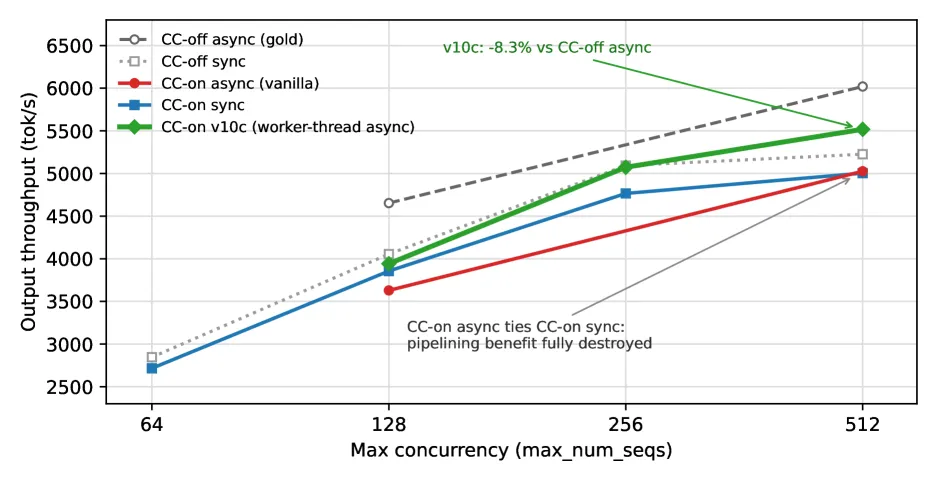
① 同步调度(一行 flag,§5.4):--no-async-scheduling 把模式变成”forward → sample → 一次小 D2H → drain → 继续”,正是桥被设计来处理的顺序 drained 模式。
| Qwen3.6-27B-FP8, c=128 | 吞吐 | TPOT |
|---|---|---|
| CC-off async(gold) | 4522 tok/s | 23.64 ms |
| CC-on async(默认) | 3550 tok/s | 31.10 ms |
| CC-off sync | 4153 tok/s | 26.56 ms |
| CC-on sync | 4104 tok/s | 26.92 ms |
flag 关闭 57% 的 CC 差距;更关键的是残差:CC-on sync vs CC-off sync 只差 0.36ms TPOT(~1%,噪声内)。按流量模式泛化:稠密 decode 恢复 ~100%(残差 ~1%)、KV-churn 暖 TTFT 恢复 ~100%(残差 ~2%)、MoE ~80%(残差 ~5%,因专家路由的小而频繁的不可约桥流量)。
② Worker 线程 drain(~30 行 patch,v10c,§5.5):同步调度放弃了 CC-off 享有的真重叠。关键洞见——被阻塞的 CUDA 调用会释放 GIL,所以把阻塞 drain 移到 Python worker 线程即可在不要求硬件重叠拷贝的前提下恢复流水线。
| c | CC-on 原版 async | CC-on sync | CC-on v10c | CC-off async(gold) | v10c 与 gold 差距 |
|---|---|---|---|---|---|
| 128 | 3629 | 3856 | 3942 | 4653 | −15.3% |
| 256 | – | 4766 | 5073 | – | −13.4% |
| 512 | 5026 | 5004 | 5518 | 6020 | −8.3% |
在 c=512 恢复到 gold 的 8.3% 以内(超过 CC-off sync 的 5226 tok/s)。注:B300 访问窗口在独立复现前关闭,v10c 的 92% 高并发恢复标为”限定结果(qualified)“;论文的 Blackwell 主张建立在跨三类工作负载复现的一行 flag 修复上。同一 worker-thread 思路移植到 H200 vLLM 0.22.1 上带来 +6–7%。
恢复层级(部署视角):一行 CLI flag → 57%(稠密)/~100%(KV churn);~30 行运行时 patch → B300 至多 92%(限定)/ H200 +6–7%;架构级(多步 CUDA graph)→ 其余大部分;平台级(TDISP/TEE-IO 可信设备路径)→ 桥成本本身。
4.5 运行时设计准则(§5.6)
GPU-CC 的传输机制为顺序 drained 传输而设计;现代加速器软件范式(用重叠流和异步拷贝饱和设备)是其”对抗输入”。修复形状通用:先 drain 后 refill,或把阻塞等待移出关键线程。候选场景:多模态输入流水线、参数分片推理、异步 tokenization、RAG 流水线。
五、案例研究二:加载与 KV 状态的搬运工程(§6)
5.1 上下文池化的模型加载
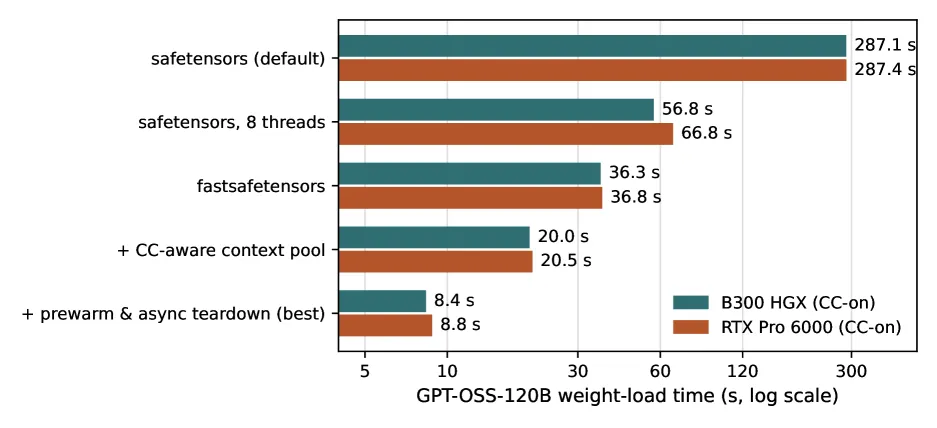
加载 GPT-OSS-120B(59 GiB,15 分片)默认 safetensors 路径在 B300 上要 287.09s、Pro 6000 上 287.41s——两代内存带宽差异下几乎相同的数字说明瓶颈在软件路径(串行解析、staging、单 context secure 传输),而非 GPU。修复直接套用桥定律(带宽在 context 里):把权重分片扇出到一池 worker CUDA context 并行 staging,再用同 GPU peer 拷贝组装。
| GPT-OSS-120B 加载路径 | B300 CC-on | Pro 6000 CC-on |
|---|---|---|
| safetensors 基线 | 287.09 s | 287.41 s |
| safetensors,8 线程 | 56.82 s | 66.79 s |
| fastsafetensors | 36.34 s | 36.83 s |
| + CC-aware context 池,持久 8 worker | 19.99 s | 20.46 s |
| + 预热与异步拆除(最佳,暖) | 8.36 s | 8.80 s |
secure context 昂贵(8 worker 实测 5.20s cuCtxCreate + 3.90s cuCtxDestroy + 0.30s pinned 分配 = 9.4s 生命周期成本),所以要持久池化 + 预热 + 异步拆除把它移出关键路径(否则朴素的每分片一 context 变体要 253.66s)。34x 加速,跨平台 5% 以内。意义:287s 时调度器无法把机密 GPU 容量当弹性资源,8.4s 时可以。
5.2 复用感知的 KV-cache offload
KV 恢复是搬运密集的极端(每请求恢复 1.1 GiB 前缀,B300 暖 TTFT +131%)。两个杠杆:
- 调度(§5.4):仅同步调度就把 B300 churn TTFT 从 935ms 降到 413ms(批量恢复不再与每步调度流量争抢串行通道)。
- 策略:默认 vLLM CPU-offload 溢出远多于恢复(GiB 级 D2H vs MiB 级 H2D)。复用感知过滤(store_threshold=2,只 offload 观测到 ≥2 次的块)把溢出量从 2.3 GiB 降到 2.3 MB,CC-on 暖 TTFT 改善 2.97x(1615→544ms,Pro 6000)。
原则:CC 下每跨桥字节更贵,投机搬运字节的策略(溢出一切、eager 前缀恢复、细粒度流式)必须变为证据驱动。常驻在 CC 下比非 CC 更值钱,Blackwell 更大 HBM 让常驻更便宜。
六、Blackwell 能力:机密多 GPU Fabric 租户(§7)
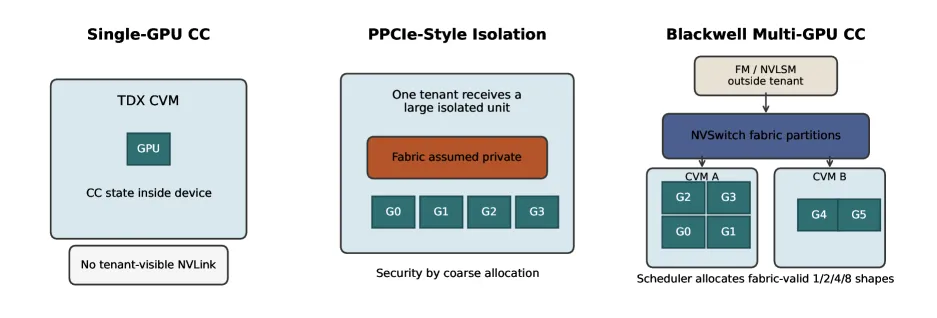
Blackwell B300 相较 Hopper 改变了机密租赁单元。Hopper 的多 GPU 方案是 Protected PCIe(把整个 GPU 复合体私有分配给一个租户);B300 新增:主机管理的 NVSwitch fabric 可把 1/2/4/8 GPU 分区暴露为机密租户,而 fabric 保持共享。
6.1 已验证的 fabric 能力
- 分区词汇表:FM 枚举 15 种分区定义(1 个 8-GPU、2 个 4-GPU、4 个 2-GPU、8 个 1-GPU);激活/去激活 10–20s/租户。
- n=2 机密 NVLink 租户:CUDA 初始化、双向 peer 访问、NVLink 加密(NVLE)多 GPU 模式,
cudaMemcpyPeer在 CVM 内持续 510.4 GB/s——比 CVM–GPU 桥高两个数量级,且不经主机内存。 - n=4 租户:全部 4 GPU 报告健康 fabric、完整 NV18 mesh;CUDA 验证因容器工具链问题推迟(非架构问题)。
- 并发租户隔离:两个同时的 n=2 机密租户在不相交分区上各只见自己的 2 GPU,均报告 CC 开、健康 NV18 fabric、无主机管理 NIC 暴露。
关键点:scale-up fabric 是 GPU-CC 唯一不串行化的数据通路,因此 fabric 租赁是性能特性而非仅容量特性。(对比:NVLink 禁用时 NCCL 回退到 CC 兼容的 TCP 路径,仅约 10 MB/s。)
6.2 调度后果与遗留的 fabric 认证缺口
分区词汇表就是调度 API:控制平面分配 fabric-有效形状(1/2/4/8),不再需要 Protected-PCIe 式整复合体分配。遗留失败模式(陈旧 FM 分区状态表现为 guest FLA remap 校验错误)主张把 fabric 状态健康检查作为调度前置条件。
认证缺口:租户能验证 TDX 证据、GPU-CC 模式与就绪态、GPU 认证报告、guest 可见 fabric 健康与 NVLink 拓扑;但不能验证 Fabric Manager 二进制与配置、NVSwitch 路由表。今天该控制平面是主机可信的——fabric 先作为机密资源工作,才成为可认证资源。路径:把 FM 移入可认证 service VM、签名路由状态、最终 TDISP 式设备接口认证。
七、机密 AI 平台的设计准则(§8)
| # | 准则 | 说明 |
|---|---|---|
| 1 | 把跨桥当作被调度的资源 | 批处理小传输、先 drain 后 refill、把穿越移出关键路径。遵守与否是 1% vs 26% 服务税之差 |
| 2 | 从 context 获取并发,并池化 | 流级重叠在 CC 下无效;context 级并行有效但生命周期昂贵,需池化预热 |
| 3 | 让策略默认值感知 CC 模式 | 无 CC 的最佳默认可能是有 CC 的最差;运行时应检测 GPU-CC 模式并翻转调度/offload/流式默认值 |
| 4 | 购买常驻 | 留在 GPU 上的权重和 KV 免费,搬动的一切被税;更大 Blackwell HBM 提高常驻策略回报 |
| 5 | 调度并认证 fabric | B300 级系统上租户形状是 fabric 分区,应向租户暴露分区身份、fabric 健康、GPU-CC 状态,并推进可认证 fabric 控制 |
TEE-IO/TDISP 位于这条路的尽头:可信设备路径会缩小桥过路费本身,把准则 1–2 从必需变成优化。
八、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| GPU-CC 桥的因果性能模型 | secure copy channel 每 context 串行、异步被撤销、每次穿越固定 setup 主导小传输;计算/本地内存对等 | 双 Blackwell 平台微基准 + 指令集消融 + 链式 graph;H200 复现同一签名 |
| 机密 LLM 服务的根因与恢复 | profiler 账目把稠密 decode CC 差距归于 44x 慢的 alloc-and-copy(1138 次解释 1.54s);单变量 patch 排除替代解释;演示 async 调度的策略反转 | 57% 一行 flag + 至多 92% worker-thread(限定),KV-churn TTFT 从 +131% 到 +2% |
| 跨平台可迁移的 CC 感知搬运工程 | secure-context 池化加载器(生命周期成本模型)+ 复用感知 KV-offload | GPT-OSS-120B 加载 34x(跨平台 5% 内);暖 TTFT 2.97x |
| 首次公开 B300 机密 fabric 租户 | CVM 内 510 GB/s NVLink P2P、并发租户隔离、分区词汇表、剩余 fabric 认证缺口分析 | n=2 带宽 510.4 GB/s;15 分区定义;并发 n=2 隔离 |
九、局限性
- 统计范围:B300 头条数字是时间受限访问窗口内的单次点测量(硬件已归还),只基于大效应下结论(最小解读的头条 delta 是 13% 服务行,机制主张基于 2x–44x 效应);Pro 6000 结果来自更长的重复/扫描活动。
- 机制归因:约 330µs 每穿越 setup 成本从 guest 侧计时和 profiler 归因推断,非驱动/copy-engine 追踪;串行化是行为观测。CUPTI/Nsight 级仪表是下一步。
- 限定恢复幅度:B300 v10c 的 92% 高并发恢复仍为限定;一行 flag 恢复(承载论文 Blackwell 主张)跨三类工作负载复现。
- 覆盖:n=4 fabric 租户结构验证但未跑 CUDA 负载;n=8 被主机 FM 状态 bug 阻塞;NCCL collective 与 CC 开/关 NVLink 开销未测;B300 服务用了比 Pro 6000 更新的 vLLM 镜像(SM100 要求),跨平台服务行是上下文而非受控对比。
- 代际范围:主测量为 Blackwell;H200 边界实验区分机制与 Blackwell 放大,但不是完整 Hopper 性能研究。
十、总结
核心贡献
GPU 机密计算长期被当作”一个数字”来 benchmark,但更应理解为一份变更的契约:计算保持 native,但 CVM 与 GPU 之间的桥变成串行化、高过路费的通道,跨桥的异步被静默撤销。为旧契约构建的软件(即所有软件)把这一变更转化为大的、工作负载相关的损失:稠密 decode 26% 吞吐、KV 恢复 131% 延迟、模型加载 34x 时间。为新契约构建的软件能拿回大部分:一个调度 flag、一个 worker-thread drain、一个池化 context 加载器、一个复用感知 offload 策略——预测损失的桥定律也开出了修复处方,且在两块 Blackwell 平台上成立。
技术影响
Blackwell 的第二个改变是”机密单元是什么”:B300 把 NVSwitch fabric 变成租户资源(CVM 内 510 GB/s GPU-to-GPU 带宽、分区且并发),同时把其控制平面留在租户证据之外。下一代机密 AI 平台将在两个轴上被评判:运行时是否尊重串行化的桥,以及其 fabric 是否像设备一样可认证。
十一、参考资源
- 论文(abs):https://arxiv.org/abs/2606.23969
- HTML 全文:https://arxiv.org/html/2606.23969v1
- PDF:https://arxiv.org/pdf/2606.23969
- 图片索引:
figures/2606.23969-serialized-bridge/README.md