Tmax: A simple recipe for terminal agents
最强开源终端代理 RL 训练方案,通过 TMAX-15K 数据集和 DPPO 训练实现 Terminal-Bench 2.0 上 27% 的最优性能
Tmax: A simple recipe for terminal agents
论文信息: arXiv:2606.23321 [cs.AI] 22 Jun 2026
作者: Hamish Ivison, Junjie Oscar Yin, Rulin Shao, Teng Xiao, Nathan Lambert, Hannaneh Hajishirzi
机构: Allen Institute for AI, University of Washington
代码: https://github.com/hamishivi/tmax
许可: CC BY 4.0
一、论文概述
1.1 研究背景
基于终端的代理编码产品已迅速成为语言模型最受欢迎的应用场景。然而,现有学术工作主要关注 bug 修复或相对简单的终端任务,缺乏对复杂、长周期终端任务的 RL 训练研究。
核心挑战:
| 挑战 | 说明 |
|---|---|
| 基准测试难度大 | Terminal-Bench 等基准要求复杂的长周期终端操作 |
| 数据稀缺 | 缺乏大规模、多样化的终端任务训练数据 |
| 训练不稳定 | 长序列 RL 训练容易崩溃,特别是超过 300 步后 |
| 泛化能力未知 | RL 训练是否能泛化到其他任务和 harness 不确定 |
1.2 核心贡献
| 贡献 | 说明 |
|---|---|
| TMAX-15K 数据集 | 14,600 个 RL 环境实例,比先前数据集大 2.5 倍 |
| 开源终端代理模型 | TMAX-9B 在 Terminal-Bench 2.0 上达到 27%,同规模最优 |
| 可复现的 RL 方案 | 基于 DPPO 的简单训练方案,公开所有代码、模型和数据 |
| 泛化能力验证 | RL 训练能跨任务、跨 harness 泛化,提升 SWE-Bench +5 分 |
二、核心思想
2.1 问题定义
终端代理需要在命令行界面中执行复杂的长周期任务,包括环境设置、模型训练、代码编写等。现有方案存在以下问题:
数据层面:
- 先前数据集偏向单一领域(如 SWE-Smith 95% 为软件工程)
- 缺乏难度控制,任务要么太简单要么太难
- 验证成本高,需要昂贵的教师模型生成验证
训练层面:
- GRPO 在长序列场景下不稳定
- 训练-推理 logprob 不匹配导致崩溃
- 缺乏简单有效的开源训练方案
2.2 解决方案概述
TMAX 提出两个核心组件:
- TMAX-15K 数据集:通过组合式流水线生成,控制难度和多样性
- DPPO 训练方案:使用 FP32 LM head 和大 group size 提高稳定性
三、技术架构
3.1 数据生成流水线
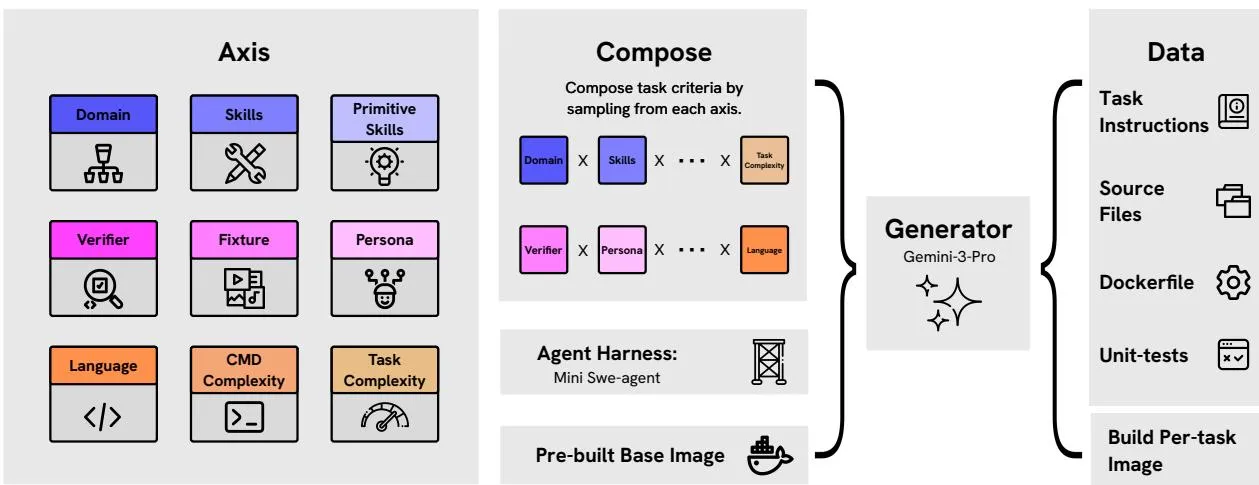 图 2:TMAX 数据流水线。每个任务从 9 个结构化轴层次化采样,然后由数据生成器实例化为 Dockerfile、单元测试验证器、源文件和任务指令。
9 个组合轴:
| 轴 | 来源 | 基数 | 说明 |
|---|---|---|---|
| Domain | Pi et al. (2026) | 9 | security, software_engineering, file_operations 等 |
| Skill type | Pi et al. (2026) | 4-7/域 | Algorithmic, Systems, Data Processing 等 |
| Primitive skills | Pi et al. (2026) | 20-40/域 | 每任务采样 3-5 个原始技能 |
| Persona | 本文贡献 | 6-18/域 | 领域相关的用户角色 |
| Language | 本文贡献 | 8 | Python, C, Bash, C++ 等 |
| Task complexity | 本文贡献 | 4 | short, moderate, complex, intricate |
| Command complexity | 本文贡献 | 3 | bash-only → bash + code + system services |
| Fixture | 本文贡献 | 7 | text_only, image, audio, video 等 |
| Verifier | 本文贡献 | 5 | exact_text, metric_threshold 等 |
3.2 数据集对比
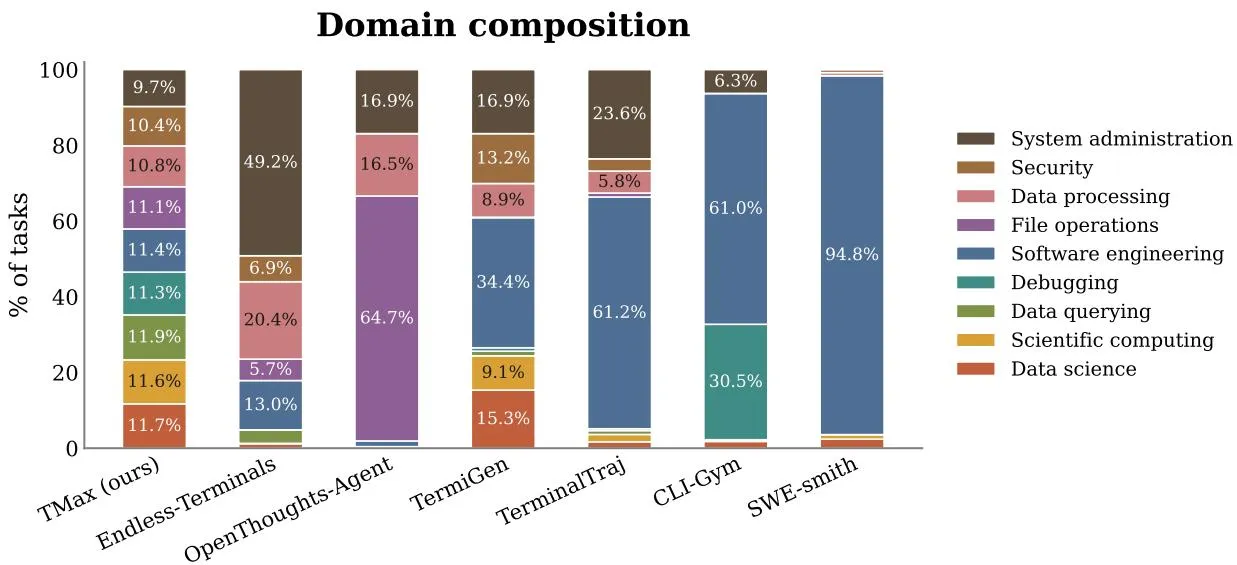 图 3:数据领域分布。先前数据集偏向单一领域,而 TMAX 在 9 个领域均匀分布。
| 数据集 | 规模 | Pass@1 | Pass@8 | 领域平衡度 | 技能平衡度 |
|---|---|---|---|---|---|
| TMAX (本文) | 15k | 42% | 53% | 0.998 | 0.732 |
| Endless Terminals | 2.4k | 92% | 95% | 0.481 | 0.284 |
| Terminal Traj | 5.5k | 54% | 65% | 0.363 | 0.374 |
| CLI-Gym | 1.5k | 41% | 55% | 0.283 | 0.061 |
| SWE-Smith | 59k | 54% | 72% | 0.146 | 0.042 |
关键发现:
- TMAX 是最难的数据集(Pass@8 最低:53%)
- TMAX 领域平衡度最高(0.998),接近完美均匀分布
- Endless Terminals 太简单(Pass@1 92%),不适合 RL 训练
3.3 训练方案
算法选择:DPPO (Divergence Proximal Policy Optimization)
| 组件 | 配置 |
|---|---|
| RL 算法 | DPPO(基于 GRPO 的改进) |
| LM head 精度 | FP32(减少训练-推理 logprob 不匹配) |
| Group size | 32(提高训练稳定性) |
| 最大序列长度 | 65,536 tokens |
| 最大工具调用 | 64 次 |
| 训练步数 | 500 步 |
| 学习率 | 1×10⁻⁶ |
| 优化器 | AdamW |
3.4 Logprob 不匹配问题
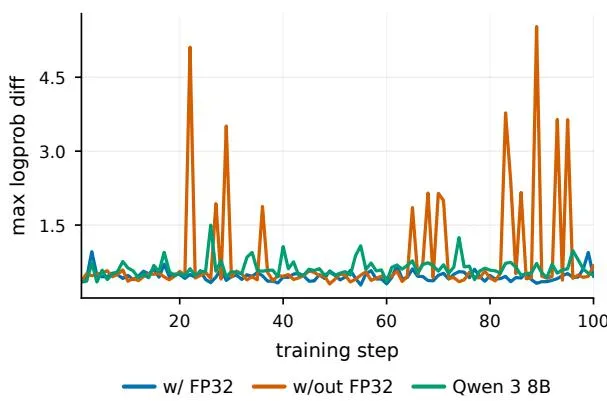 图 4:Qwen 3.5 9B 在 RL 训练前 100 步中推理(vLLM)和训练(HuggingFace)logprobs 的最大差异。使用 FP32 LM head 后差异显著降低。
关键发现:
- Qwen 3.5 不使用 FP32 LM head 时出现更大、更频繁的 logprob 差异峰值
- Qwen 3 8B 即使不使用 FP32 LM head 也不会出现大差异
- FP32 LM head 对 Qwen 3.5 系列模型特别重要
四、核心创新
4.1 创新点总结
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 组合式数据生成 | 9 个结构化轴层次化采样 | 数据集对比实验 |
| 难度控制 | 细粒度复杂度 + 分级验证器 | Pass@k 难度曲线 |
| 多模态 fixtures | 支持图像、音频、视频等输入 | 扩展任务类型 |
| DPPO 训练 | 解决长序列 RL 训练不稳定问题 | 训练稳定性实验 |
| FP32 LM head | 减少训练-推理 logprob 不匹配 | logprob 差异分析 |
4.2 训练稳定性分析
问题:长序列 RL 训练容易在 300 步后崩溃
原因分析:
- Qwen 3.5 的混合架构导致数值不匹配更常见
- 高度多轮特性(常超过 20 步)加剧不稳定性
- 沙箱基础设施的资源竞争导致不稳定
解决方案:
- DPPO 替代 GRPO:更好地限制训练崩溃
- FP32 LM head:减少训练-推理 logprob 差异
- 大 group size (32):提供更稳定的梯度估计
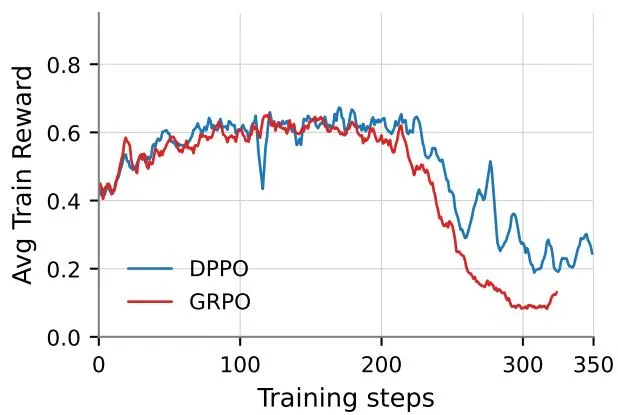 图 7:使用 DPPO 限制训练崩溃。在 TMAX-15K 上使用 GRPO 或 DPPO 进行 RL 训练时的平均训练奖励。
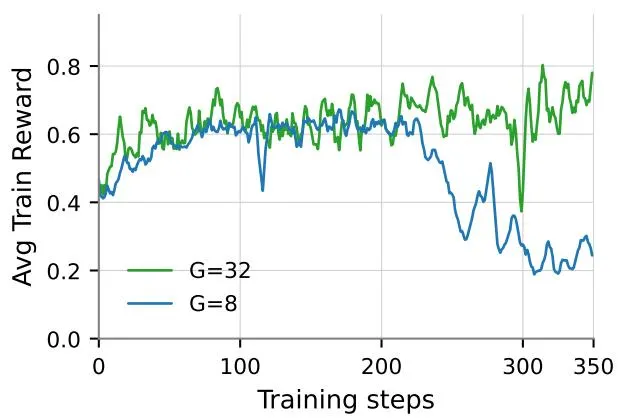 图 8:使用更大的 group size 提高稳定性。使用不同 group size (8, 32) 进行 DPPO RL 训练时的平均训练奖励。
五、代码实现分析
5.1 系统组件
| 组件 | 说明 |
|---|---|
| 数据生成 | 基于 Gemini-3-Pro 的组合式流水线 |
| RL 基础设施 | 基于 open-instruct 的异步训练框架 |
| Rollout 引擎 | vLLM |
| 沙箱后端 | Podman 或 Apptainer |
| 评估后端 | Daytona(推荐)或 Harbor |
5.2 项目结构
- 训练代码: 基于 open-instruct 扩展
- 数据生成: 组合式采样 + Gemini-3-Pro 生成
- 评估: Terminal-Bench 2.0/2.1, SWE-Bench Verified, AIME
六、实验结果
6.1 主要结果
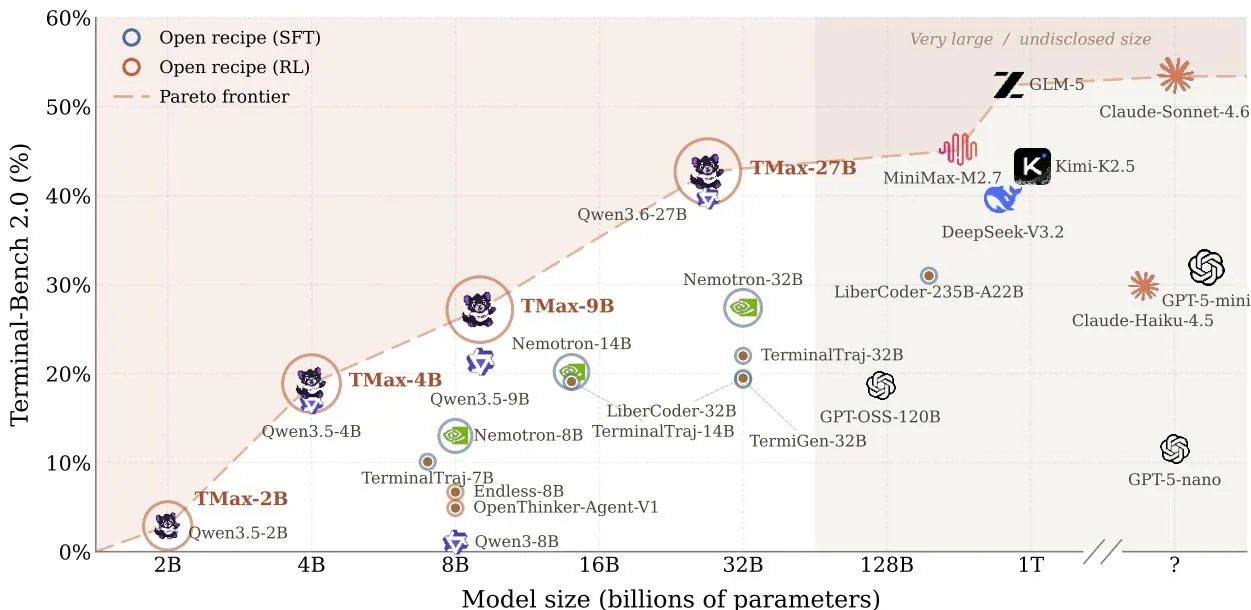 图 1:TMAX 模型与先前工作在 Terminal-Bench 2.0 上的性能对比。
Terminal-Bench 2.0 结果:
| 模型 | 参数量 | TB2.0 (%) |
|---|---|---|
| OpenThinker-Agent-v1 | 8B | 4.9 |
| Nemotron-Terminal | 8B | 13.0 |
| Nemotron-Terminal | 32B | 27.4 |
| EndlessTerminals (OT SFT + RL) | 8B | 6.7 |
| TerminalTraj | 32B | 22.0 |
| TMAX-9B (本文) | 9B | 27.2 |
| TMAX-27B (本文) | 27B | 42.7 |
| Claude Haiku 4.5 | ? | 29.8 |
| GPT-5-mini | ? | 31.9 |
| DeepSeek-v3.2 | 671B | 39.6 |
关键发现:
- TMAX-9B 是 10B 以下最强开源模型
- TMAX-9B 超越 32B 的先前工作(如 Nemotron-Terminal 32B)
- TMAX-9B 性能接近闭源模型(如 Claude Haiku 4.5)
6.2 数据集对比
| RL 数据集 | TB Lite | TB 2.1 |
|---|---|---|
| None (Qwen 3.5 9B) | 41.9 ± 2.7 | 16.1 ± 3.7 |
| TermiGen | 49.4 ± 1.5 | 25.1 ± 1.9 |
| Endless Terminals | 52.6 ± 1.4 | 25.5 ± 1.4 |
| OpenThinker-Agent | 53.0 ± 0.7 | 25.1 ± 3.7 |
| TerminalTraj | 45.8 ± 2.7 | 18.0 ± 0.0 |
| CLI-Gym | 50.7 ± 5.9 | 25.1 ± 1.4 |
| SWE-Smith | 47.2 ± 2.2 | 21.0 ± 0.5 |
| TMAX-15K (本文) | 57.2 ± 2.5 | 28.8 ± 1.4 |
6.3 泛化能力
跨任务泛化:
| 模型 | SBV | AIME |
|---|---|---|
| Qwen 3.5 9B | 44.0 ± 2.0 | 73.3 ± 2.7 |
| + RL (TMAX) | 53.5 ± 0.6 | 91.1 ± 1.6 |
跨 harness 泛化:
| 模型 | Ours | OpenHands | mini-SWE-agent | Terminus-2 |
|---|---|---|---|---|
| Qwen 3.5 9B | 41.9 ± 2.7 | 36.0 ± 2.8 | 44.1 ± 3.3 | 36.4 ± 2.2 |
| TMAX-9B | 57.2 ± 2.5 | 46.9 ± 3.7 | 55.3 ± 4.5 | 45.3 ± 2.4 |
关键发现:
- RL 训练提升 SWE-Bench Verified +5 分
- RL 训练提升 AIME +18 分
- RL 训练在所有 harness 上都提升 9 分以上
- 证明 RL 训练学习的是通用能力,而非 harness 特定行为
6.4 训练动态
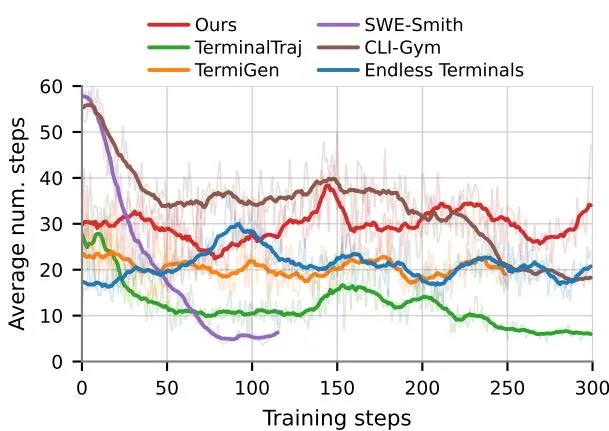 图 5:在不同数据集上训练时的平均步数。在 TMAX-15K 上训练始终使用更高的步数。
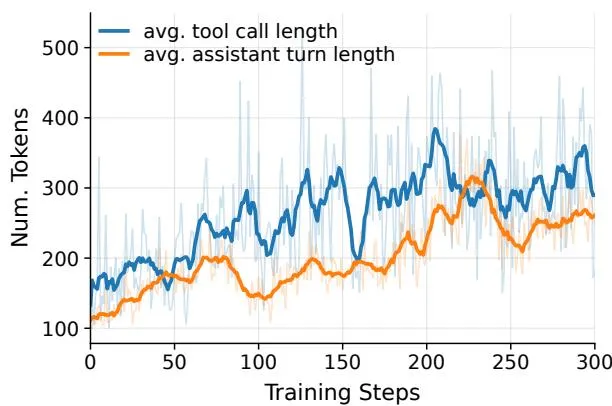 图 6:助手轮次和工具调用的平均长度(token 数)。输出长度在 RL 训练过程中逐渐增加。
关键发现:
- 在 TMAX-15K 上训练时模型平均步数最高,表明数据持续具有挑战性
- RL 训练过程中助手轮次长度逐渐增加,表明模型学习更复杂的推理
- 这类似于单轮数学设置中的推理时计算扩展
6.5 难度分析
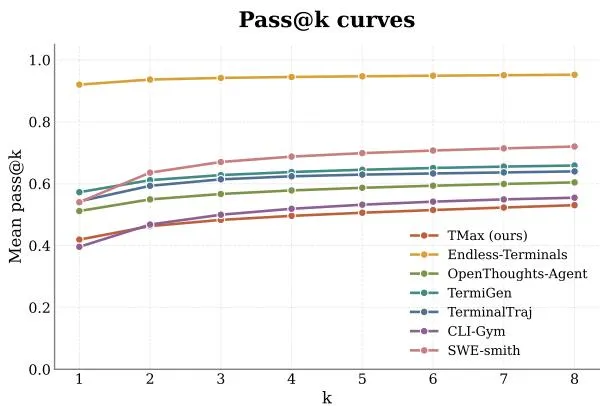 图 9:Pass@k 难度曲线。TMAX 与 CLI-Gym 一起占据最难区间,且在 k 增加时难度持续存在。
关键发现:
- TMAX 是最难的数据集之一(Pass@8 最低)
- Endless Terminals 在 k=1 时就接近上限,几乎没有改进空间
- TMAX 的难度在 k 增加时持续存在,提供有效的学习信号
七、相关工作
7.1 终端代理数据集
| 数据集 | 类型 | 规模 | 特点 |
|---|---|---|---|
| NL2Bash | 自然语言→bash | - | 早期工作,任务简单 |
| Endless Terminals | 合成生成 | 2.4k | 任务太简单 |
| TerminalTraj | 仓库适配 | 5.5k | 偏向软件工程 |
| Nemotron-Terminal | 混合生成 | - | 未公开 RL 环境 |
| TMAX-15K | 组合式生成 | 15k | 最难、最均衡 |
7.2 RL 训练方法
| 方法 | 算法 | 特点 |
|---|---|---|
| Endless Terminals | PPO | 有限上下文长度 (16k) |
| ROME | 定制算法 | 未公开代码 |
| TMAX | DPPO | 简单、可复现、高效 |
八、总结
8.1 核心贡献
- TMAX-15K 数据集:14,600 个 RL 环境,通过组合式流水线生成,控制难度和多样性
- 最强开源终端代理:TMAX-9B 在 Terminal-Bench 2.0 上达到 27%,同规模最优
- 可复现的 RL 方案:基于 DPPO 的简单训练方案,公开所有代码、模型和数据
- 泛化能力验证:RL 训练能跨任务、跨 harness 泛化,提升 SWE-Bench +5 分
8.2 技术影响
- 学术基准:为终端代理研究提供强基线和可复现方案
- 数据生成:组合式流水线可扩展到其他领域
- 训练稳定性:DPPO + FP32 LM head 解决长序列 RL 训练问题
- 泛化能力:证明终端 RL 训练能提升通用模型能力
8.3 局限性
- 数据生成依赖强模型:使用 Gemini-3-Pro 作为生成器,可能限制数据质量上限
- 训练不稳定:尽管有改进,训练仍可能在 300 步后崩溃
- 沙箱成本:运行大量隔离容器仍然昂贵
- 上下文长度限制:使用较短的上下文长度和简单的 harness
九、参考资源
9.1 论文链接
- arXiv: https://arxiv.org/abs/2606.23321
- PDF: https://arxiv.org/pdf/2606.23321
- 代码: https://github.com/hamishivi/tmax
9.2 关键图表
| 图表 | 说明 | 路径 |
|---|---|---|
| 图 1 | 性能对比 | figure-1-performance-comparison.jpg |
| 图 2 | 数据流水线 | figure-2-data-pipeline.jpg |
| 图 3 | 数据领域分布 | figure-3-data-composition.jpg |
| 图 4 | Logprob 差异 | figure-4-logprob-difference.jpg |
| 图 5 | 步数变化 | figure-5-step-count-training.jpg |
| 图 6 | 助手轮次长度 | figure-6-assistant-turn-length.jpg |
| 图 7 | DPPO vs GRPO | figure-7-dppo-vs-grpo.jpg |
| 图 8 | Group Size 影响 | figure-8-group-size-stability.jpg |
| 图 9 | Pass@k 曲线 | figure-9-passk-curves.jpg |
| 图 10 | 完美求解过滤 | figure-10-perfect-solving-filter.jpg |
| 图 11 | 全零样本过滤 | figure-11-allzero-sample-filter.jpg |


9.3 相关论文
| 论文 | 作者 | 年份 | 关系 |
|---|---|---|---|
| Endless Terminals | Gandhi et al. | 2025 | 相关工作 |
| TerminalTraj | Wu et al. | 2026 | 相关工作 |
| Nemotron-Terminal | Pi et al. | 2026 | 相关工作 |
| SWE-Smith | Yang et al. | 2025 | 相关工作 |
| DPPO | Qi et al. | 2026 | 核心算法 |
9.4 关键技术术语
| 术语 | 英文 | 说明 |
|---|---|---|
| 终端代理 | Terminal Agent | 在命令行界面执行任务的 AI 代理 |
| 强化学习 | Reinforcement Learning (RL) | 通过试错学习的训练方法 |
| DPPO | Divergence Proximal Policy Optimization | 基于 GRPO 的改进 RL 算法 |
| Terminal-Bench | Terminal-Bench | 终端代理基准测试 |
| 组合式生成 | Compositional Generation | 通过组合多个轴生成数据 |
| SWE-Bench | SWE-Bench | 软件工程基准测试 |
分析完成时间:2026年6月24日 分析工具:Claude Code + paper-analyzer skill