Unlimited OCR Works
通过Reference Sliding Window Attention实现恒定KV缓存,支持单次前向传播解析数十页文档
Unlimited OCR Works: Welcome the Era of One-shot Long-horizon Parsing
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Unlimited OCR Works: Welcome the Era of One-shot Long-horizon Parsing |
| 作者 | Youyang Yin, Huanhuan Liu, YY, Qunyi Xie, Chaorun Liu, Shiqi Yang, Shaohua Wang, Zhanlong Liu, Hao Zou, Jinyue Chen, Shu Wei, Jingjing Wu, Mingxin Huang, Zhen Wu, Guibin Wang, Tengyu Du, Lei Jia |
| 机构 | Baidu |
| 论文 | arXiv:2606.23050 |
| 代码 | github.com/baidu/Unlimited-OCR |
| 发布 | 2026-06-22 |
| 许可 | CC BY 4.0 |
二、核心思想
问题定义
现有端到端OCR模型(如DeepSeek OCR)在处理长文档时面临根本性瓶颈:随着输出序列增长,KV缓存线性增长导致内存消耗飙升和生成速度下降。目前没有任何模型能够在单次前向传播中解析十页以上的内容,而是采用逐页处理的for-loop方式,在每一步重置内存。这与人类的连续解析能力形成鲜明对比——人类在转录数百页书籍时,不会扫描已写下的全部文本,而是仅查看紧邻的上下文以保持方向。
解决方案概述
本文提出Reference Sliding Window Attention (R-SWA),一种受人类工作记忆启发的注意力机制。R-SWA将注意力约束在双段窗口内:所有参考token(视觉token和prompt)构成全局上下文,而输出token仅关注前n个(默认n=128)已生成token。这种”软遗忘”机制使KV缓存从线性增长变为恒定,使得在标准32K最大长度下单次前向传播可转录数十页文档。
三、技术架构
整体框架图
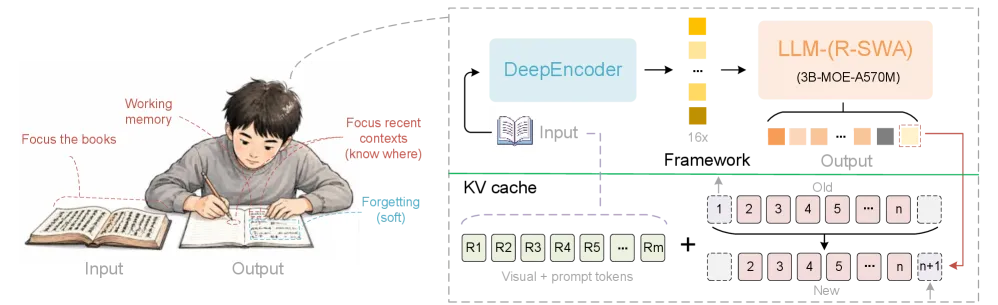
Unlimited OCR以DeepSeek OCR为基线,包含:
- DeepEncoder:级联SAM-ViT与CLIP-ViT,16x token压缩,可将1024x1024 PDF图像压缩为仅256个token
- MoE解码器:总共3B参数,激活参数仅500M
- R-SWA:替换所有标准MHA注意力层,实现恒定KV缓存
核心公式
R-SWA注意力可达集合:
因果滑动窗口:
其中:
- 表示长度为 的前缀段(视觉token+prompt),全局可见
- 表示解码区域上宽度为n的因果滑动窗口
注意力权重计算:
输出表示:
KV缓存管理对比
| 模型 | KV缓存大小 | 随输出长度变化 |
|---|---|---|
| DeepSeek OCR (MHA) | 线性增长 | |
| Unlimited OCR (R-SWA) | 恒定上界 |
缓存比率:
当 时,
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| DeepEncoder | 视觉token编码器,SAM-ViT + CLIP-ViT级联 | 16x压缩,Base模式1024x1024 |
| MoE解码器 | 混合专家LLM | 3B总参数,500M激活 |
| R-SWA | 参考滑动窗口注意力 | 窗口大小n=128 |
| KV Cache | 队列实现,容量m+n | 恒定内存占用 |
训练流程
- 基线模型:DeepSeek OCR
- 训练数据:约200万文档OCR样本(9:1单页:多页比例)
- 训练步数:4,000 steps
- 全局batch size:256
- 最大序列长度:32K tokens
- 硬件:8 × 16 A800 GPUs
- 优化器:AdamW,余弦退火,初始学习率1e-4
- 并行策略:DeepEP,专家并行(EP)=4
- 冻结组件:DeepEncoder(已在DeepSeek OCR中充分优化)
- 推理框架:Transformers + SGLang,支持R-SWA KV缓存管理
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| Reference Sliding Window Attention | 每个token关注所有参考token + 前n个输出token,实现恒定KV缓存 | 模拟人类工作记忆的”软遗忘”机制 |
| 双段窗口设计 | 前缀段全局可见 + 输出段因果滑动,兼顾全局上下文与局部连贯性 | 公式(1)-(4)严格定义注意力范围 |
| 恒定推理性能 | TPS不随输出长度增长而下降,GPU内存使用恒定 | 表4: 6144 tokens时TSP稳定在~7848 |
| 无损性能替换 | 将所有MHA替换为R-SWA后,OCR性能无损失甚至提升 | OmniDocBench v1.5: +6.22%, v1.6: SOTA |
五、代码实现分析
项目结构(基于GitHub仓库推断):
- 基于DeepSeek OCR的代码库进行修改
- 核心修改:将解码器所有MHA注意力层替换为R-SWA
- KV缓存管理:队列实现,容量为m+n
- 推理引擎:SGLang集成R-SWA优化
关键实现细节:
- R-SWA在Transformer库中实现KV缓存管理
- SGLang推理引擎提供相应的优化支持
- 两个推理框架均可在恒定TPS和GPU内存下运行Unlimited OCR
六、实验结果
基准测试
OmniDocBench v1.5 对比
| 模型 | 参数量 | 综合分 | Text Edit↓ | Formula CDM↑ | Table TEDS↑ | Table TEDS-S↑ | Read-order Edit↓ |
|---|---|---|---|---|---|---|---|
| OCRFlux | 3B | 74.82 | 0.193 | 68.03 | 75.75 | 80.23 | 0.202 |
| GPT-4o | - | 75.02 | 0.217 | 79.70 | 67.07 | 76.09 | 0.148 |
| InternVL3 | 78B | 80.33 | 0.131 | 83.42 | 70.64 | 77.74 | 0.113 |
| Qwen2.5-VL | 72B | 87.02 | 0.094 | 88.27 | 82.15 | 86.22 | 0.102 |
| Gemini-2.5 Pro | - | 88.03 | 0.075 | 85.82 | 85.71 | 90.29 | 0.097 |
| DeepSeek-OCR | 3B-A0.5B | 87.01 | 0.073 | 83.37 | 84.97 | 88.80 | 0.086 |
| DeepSeek-OCR 2 | 3B-A0.5B | 89.17 | 0.049 | 86.85 | 85.60 | 90.06 | 0.060 |
| Unlimited-OCR | 3B-A0.5B | 93.23 | 0.038 | 92.61 | 90.93 | 94.07 | 0.045 |
相比DeepSeek-OCR提升:综合+6.22, Text Edit-0.035, Formula CDM+9.24, Table TEDS+5.96
OmniDocBench v1.6 对比
| 模型 | 参数量 | 综合分 | Text Edit↓ | Formula CDM↑ | Table TEDS↑ | Table TEDS-S↑ | Read-order Edit↓ |
|---|---|---|---|---|---|---|---|
| HunyuanOCR | 1B | 89.95 | 0.088 | 87.68 | 91.01 | 92.23 | 0.171 |
| DeepSeek-OCR 2 | 3B-A0.5B | 90.25 | 0.050 | 91.84 | 83.89 | 87.75 | 0.144 |
| dots.ocr | 3B | 90.77 | 0.048 | 89.95 | 87.18 | 90.58 | 0.138 |
| FireRed-OCR | 2B | 93.26 | 0.037 | 95.44 | 88.04 | 91.06 | 0.131 |
| Logics-Parsing-v2 | 4B | 93.33 | 0.041 | 95.65 | 88.42 | 91.98 | 0.137 |
| Qianfan-OCR | 4B | 93.90 | 0.040 | 95.08 | 90.53 | 93.31 | 0.130 |
| Unlimited-OCR | 3B-A0.5B | 93.92 | 0.042 | 95.79 | 90.16 | 93.32 | 0.129 |
达到端到端SOTA(93.92%综合分)
长序列解析性能
| 页数 | 2页 | 5页 | 10页 | 15页 | 20页 | 40+页 |
|---|---|---|---|---|---|---|
| Distinct-20 | 99.76% | 99.78% | 97.49% | 99.92% | 98.73% | 96.08% |
| Distinct-35 | 99.87% | 99.98% | 99.83% | 99.99% | 99.89% | 96.90% |
| Edit Distance | 0.0362 | 0.0452 | 0.0526 | 0.0787 | 0.0572 | 0.1069 |
40+页时Edit Distance仍低于0.11,Distinct-35达97%
效率分析
| 输出长度 | DeepSeek OCR (TPS) | Unlimited OCR (TPS) | 差距 |
|---|---|---|---|
| 256 tokens | 7229.32 | 7229.52 | ~0% |
| 512 tokens | 7468.27 | 7714.78 | +3.3% |
| 1024 tokens | 7422.50 | 7840.94 | +5.6% |
| 2048 tokens | 7166.85 | 7881.11 | +10.0% |
| 4096 tokens | 6430.21 | 7905.18 | +22.9% |
| 6144 tokens | 5822.87 | 7847.71 | +34.8% |
关键发现:
- 256 tokens时两者速度几乎相同
- 随输出增长,DeepSeek OCR的TPS持续下降
- 6144 tokens时Unlimited OCR快35%
- R-SWA的Flash Attention v3内核延迟保持恒定,无延迟尖峰
消融实验
子类别研究(9类文档类型):Unlimited OCR在7/9类文档的Text Edit和Reading Order得分上超越DeepSeek-OCR 2。
R-SWA宽度影响:宽度128在v1.6上验证为”both effective and lossless”。
七、相关工作
| 方法 | 特点 | 与本文对比 |
|---|---|---|
| DeepSeek OCR | 端到端OCR基线,MHA注意力 | Unlimited OCR替换为R-SWA,性能+6.22% |
| 标准SWA (Sliding Window Attention) | 窗口注意力,视觉token参与状态更新 | R-SWA保留视觉token不参与状态转换,避免特征模糊 |
| 线性注意力 | 线性复杂度,循环状态更新 | R-SWA不使用循环状态,避免视觉特征渐进模糊 |
| 逐页for-loop OCR | 外部调度器管理多页处理 | R-SWA支持单次前向传播处理多页 |
八、总结
核心贡献
- 提出R-SWA注意力机制:通过双段窗口设计(全局参考+局部滑动),实现恒定KV缓存,模拟人类工作记忆的”软遗忘”机制
- 实现Unlimited OCR:基于DeepSeek OCR,替换所有MHA为R-SWA,支持单次前向传播解析数十页文档
- 达到端到端SOTA:OmniDocBench v1.6达到93.92%综合分,v1.5相比基线提升6.22%
- 恒定推理性能:TPS不随输出长度增长而下降,GPU内存使用恒定
- 通用性验证:R-SWA适用于OCR、ASR、翻译等所有基于参考的长序列任务
技术影响
- 推理效率革命:将KV缓存从线性增长变为恒定,突破长序列推理的内存瓶颈
- 端到端OCR新范式:从逐页处理的for-loop转向单次前向传播的连续解析
- 人类认知启发设计:证明”软遗忘”机制在AI系统中的有效性
- 多任务通用性:R-SWA可扩展至ASR、翻译等更多基于参考的任务
局限性
- 上下文长度限制:32K最大长度限制了prefill阶段可处理的页数
- 视觉编码分辨率:Base模式1024x1024导致小字体识别误差
- 未来方向:短期训练128K上下文模型,长期构建prefill pool实现真正无限解析
九、参考资源
- 论文:arXiv:2606.23050
- 代码:github.com/baidu/Unlimited-OCR
- 基线模型:DeepSeek OCR
- 推理引擎:SGLang (R-SWA优化支持)
- 评测基准:OmniDocBench v1.5/v1.6