ScalingAttention: Discovering Intrinsic Sparse Attention Topology for Video Diffusion Transformers
ScalingAttention:通过权重编码的内在稀疏注意力拓扑发现机制(WEST)与保真度感知的稀疏度自适应调节(FAST)以及位级块稀疏注意力内核(crm kernel),实现视频扩散Transformer的高效训练无关推理加速
ScalingAttention: Discovering Intrinsic Sparse Attention Topology for Video Diffusion Transformers
一、论文概述
| 属性 | 内容 |
|---|---|
| 论文标题 | ScalingAttention: Discovering Intrinsic Sparse Attention Topology for Video Diffusion Transformers |
| 论文编号 | arXiv:2606.23019 |
| 作者 | Ruiliang Zhou, Xuecheng Wu, Kang He, Guangyun Han, Bin Liu, Qinqin Chen, Wende Xu, Qingjie Zhao, Chengru Song |
| 机构 | KlingAI Research, Beijing Institute of Technology, NVIDIA, Tsinghua University |
| 提交日期 | 2026-06-22 |
| 页数 / 图表 | 18 页 / 9 幅图 |
| 类别 | cs.CV, cs.AI |
摘要:本文提出 ScalingAttention——一个训练无关的视频扩散 Transformer 加速框架。核心发现是:尽管 Video DiT 中每个注意力头的个体激活随输入变化,但高注意力质量区域在所有 prompt 上的并集迅速收敛为一个稳定、与 prompt 无关的”内在稀疏拓扑”。该拓扑由权重编码、尺度不变且易于提取。ScalingAttention 通过三个协同设计的组件实现该发现:(1) WEST(Weight-Encoded Sparse Topology)离线提取块稀疏先验掩码以消除运行时搜索;(2) FAST(Fidelity-Aware Sensitivity Tuning)基于扩散保真度需求自适应调节每个头的稀疏度;(3) crm kernel——硬件对齐的位级块稀疏注意力内核,将结构化稀疏高效映射到 Tensor Core。在 Wan2.1-1.3B / 14B 与 HunyuanVideo 上的实验显示最高 1.90× 端到端加速且保持更优保真度,确立了新的帕累托前沿。
二、研究背景与动机
2.1 视频扩散 Transformer 的计算瓶颈
扩散 Transformer(DiT)在图像与视频生成中取得显著成功,但在视频生成中依赖 3D 时空自注意力——其相对于 token 数量呈二次复杂度 。例如,使用 Wan2.1-14B 生成一段 5 秒(81 帧)的视频,单 GPU 需近 30 分钟,其中超过一半的端到端时间被 3D 注意力主导。
2.2 现有稀疏注意力方法的两难困境
| 类别 | 代表方法 | 优势 | 缺陷 |
|---|---|---|---|
| 动态剪枝 | SVG2, AdaSpa, Sparse-vDiT | 选择准确、token 粒度细 | 运行时选择开销大、不规则访存、Tensor Core 利用率低 |
| 静态启发式 | Radial, PARO, Sliding Window | 硬件友好 | 固定模式无法捕捉内容自适应结构、视觉质量下降 |
现有方法的根本问题在于错误前提:将稀疏模式视为纯输入依赖、瞬时变化。
2.3 核心观察:内在稀疏拓扑的存在
作者通过实证发现:Video DiT 中虽然个体注意力激活随输入变化,但每个头的高质量注意力区域的并集在不同 prompt 间迅速收敛为一个稳定结构。该结构称为 Intrinsic Sparse Topology(内在稀疏拓扑),具有三个关键属性:
- Intrinsic Structure(内在结构):个体 prompt 触发不同激活,但其高质量区域的并集收敛为稳定、prompt 无关的边界
- Asymptotic Stability(渐近稳定):并集掩码密度不会无限增长,而是饱和于低水平
- Scale Invariance(尺度不变):在 480p 代理分辨率提取的掩码与原生 720p 掩码 > 96% 召回率对齐
理论解释:Functional Support Envelope(功能支持包络)。每个头在训练中被迫编码足够参数以支持一致的功能偏置(如运动一致性、对象持久性),这自然诱导出一个有界支持包络,对应该头跨输入可能被激活的最大范围。推理时具体 prompt 仅激活该包络的子集。
三、问题形式化
3.1 现有方法的根本缺陷
现有工作未拆分两个正交问题:
- Topology(拓扑):注意力在哪里发生?
- Sensitivity(敏感度):可容忍多大稀疏度?
未解耦导致要么低效要么保真度损失。
3.2 三大观察
| 观察 | 描述 | 解决方案 |
|---|---|---|
| 观察 1:权重编码拓扑 | 稀疏注意力具有内在、由权重编码的拓扑 | WEST 离线提取 |
| 观察 2:敏感度通过熵减演化 | 扩散过程从高熵噪声到结构化内容,稀疏容忍度逐步提高 | FAST 自适应 |
| 观察 3:稀疏-效率鸿沟 | 理论稀疏难以转化为实际加速,因 Tensor Core 需要 128×128 对齐密集数据块 | crm kernel |
四、技术架构
4.1 三阶段协同设计
| 阶段 | 组件 | 执行时机 | 作用 |
|---|---|---|---|
| 一 | WEST | Once per Model | 离线构建权重编码的静态拓扑先验 |
| 二 | FAST | Once per Setting | 在给定全局密度下调制时空保真度表面 |
| 三 | crm kernel | Reuse for All Prompts | 硬件对齐的位级块稀疏执行 |
4.2 框架总览
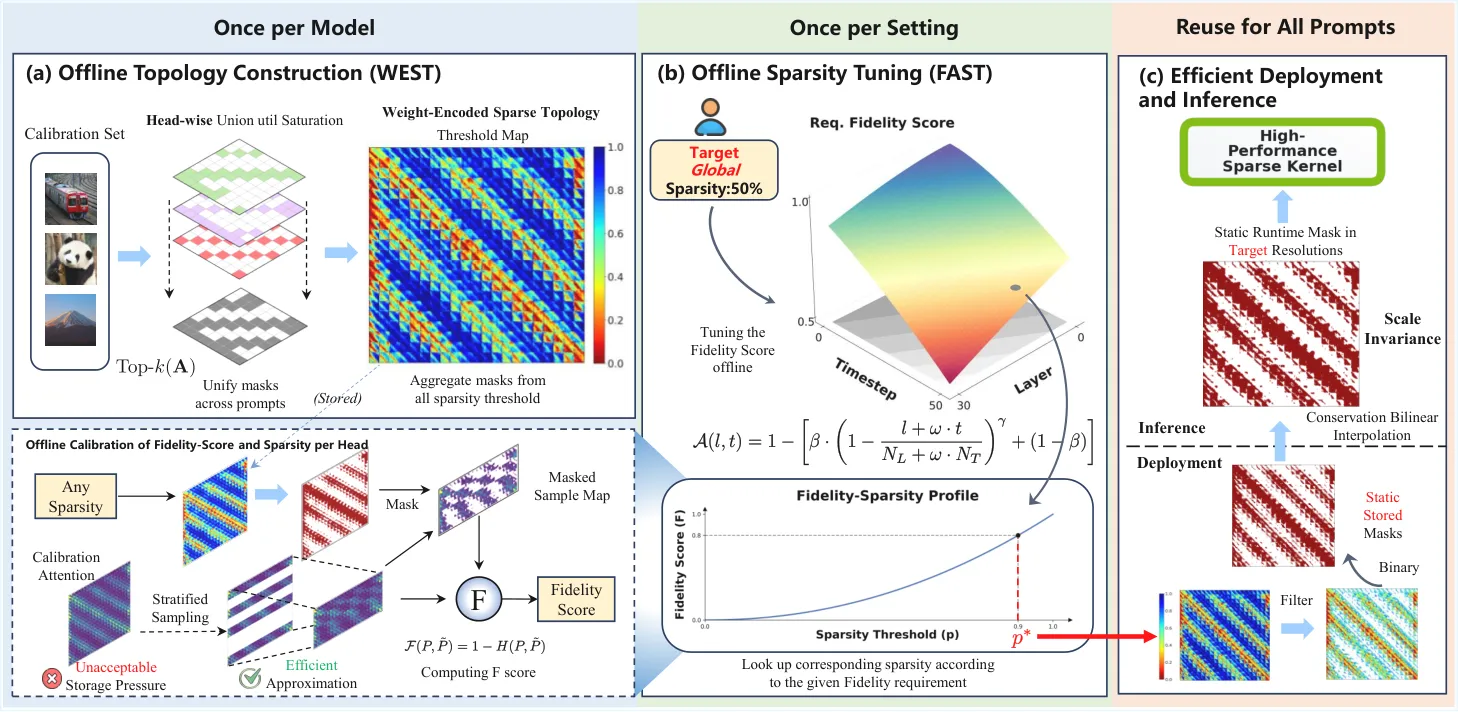
图 3. ScalingAttention 框架总览。方法将稀疏注意力解耦为三个阶段:(a) Once per Model (WEST):从校准集合聚合内在注意力模式,构造编码完整稀疏层次的静态阈值图;(b) Once per Setting (FAST):给定全局稀疏度目标,调节时空保真度表面,通过分层采样与预计算的保真度-稀疏度映射确定最优阈值 ;(c) Reuse for All Prompts:通过保守双线性插值实现分辨率可扩展的静态掩码,由 crm kernel 执行。
五、WEST:权重编码的稀疏拓扑提取
5.1 块级拓扑提取
给定校准集,为每个头计算注意力矩阵 。为与硬件对齐,将 划分为 块(),并聚合为块显著性矩阵 :
其中 、 分别表示第 个 query 块与第 个 key 块的 token 索引。该聚合过滤 token 级噪声、保留稳定且硬件友好的结构依赖。
5.2 阈值图构建
为捕捉跨输入的内在拓扑,定义 Threshold Map 。对每个块 , 记录使该块进入所有校准 prompt 活动区域并集所需的最小稀疏阈值 :
该表示编码完整稀疏层次。推理时,通过轻量比较 即时实例化任何目标密度 的二值掩码,解耦拓扑发现与动态稀疏控制,实现 掩码生成。
5.3 拓扑发现的视觉证据
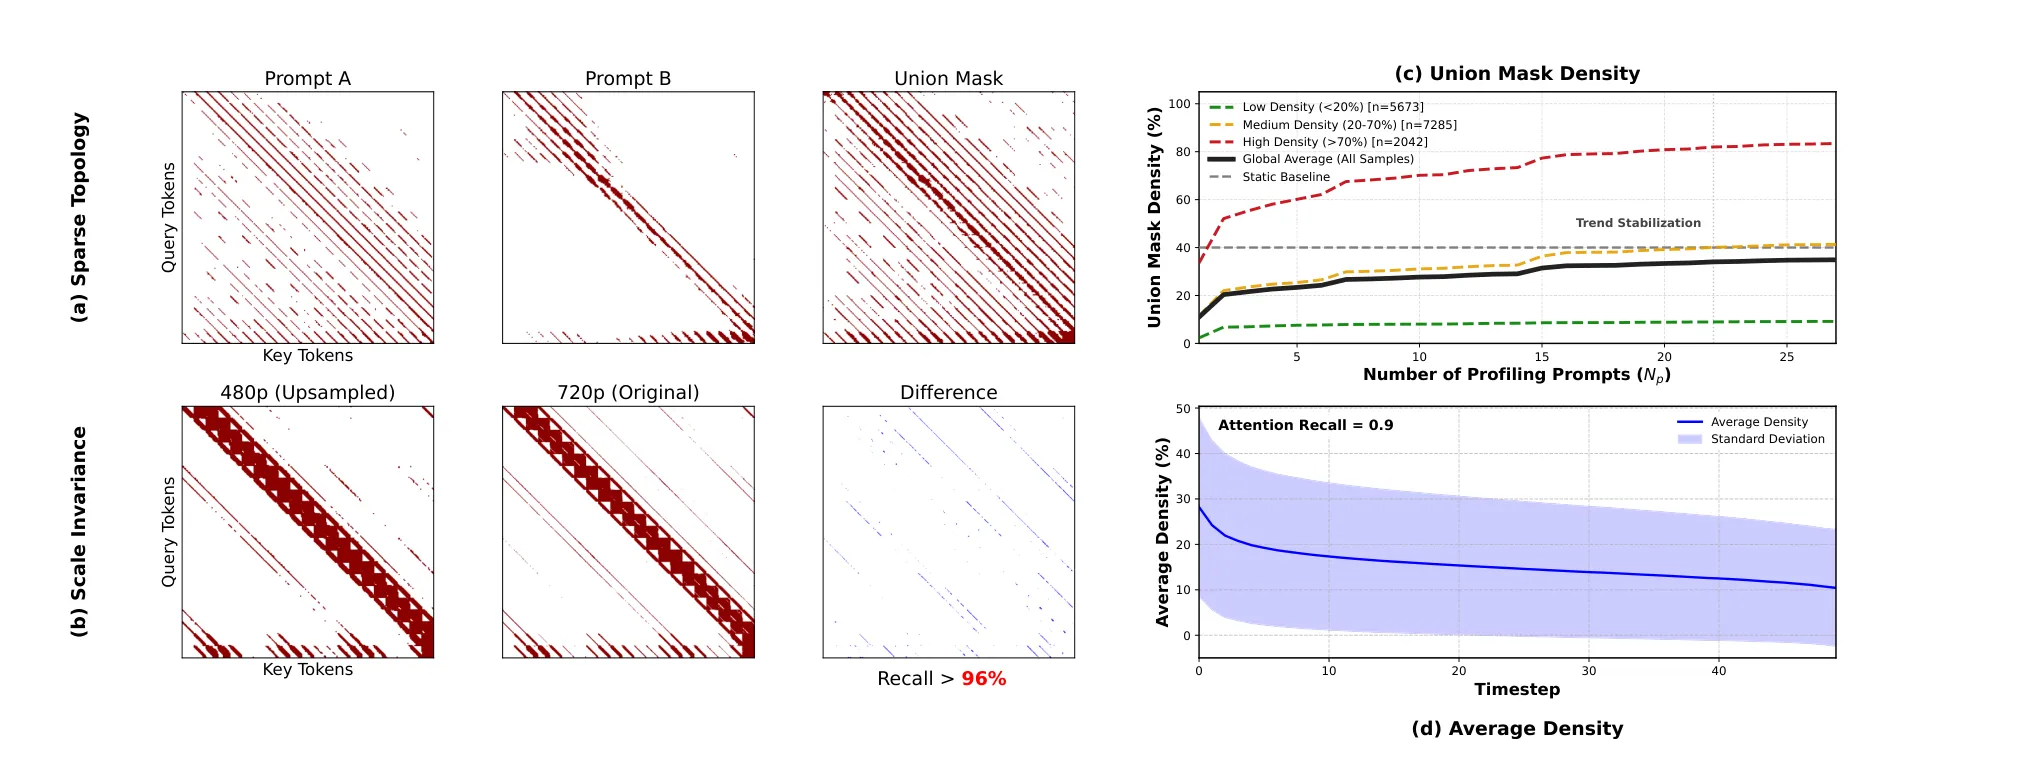
图 2. 内在稀疏拓扑的实证发现。(a) Sparse Topology(左上):不同 prompt(A vs B)激活不同子区域,但其并集收敛为稳定、prompt 无关的边界;(b) Scale Invariance(左下):480p 代理掩码与原生 720p 掩码对齐 (>96% 召回);(c) Calibration Stability(右侧):并集掩码密度在约 20 个 prompt 内饱和。
六、FAST:保真度感知的稀疏度自适应
6.1 Hellinger 距离作为保真度度量
为在动态稀疏控制中量化密集注意力 与稀疏近似 之间的差异,放弃余弦相似度——其在注意力图(高维、重尾)上会过早饱和接近 1.0,仅测角度对齐而无法感知结构失真。
Hellinger 距离定义:
平方根变换衰减极值,使度量对分布质量变化更敏感。相比 KL 散度,Hellinger 距离对称、有界、在零质量条目下良定义(稀疏注意力中普遍存在)。相比全变差距离,其平方根几何在渐进稀疏化下提供更平滑的敏感度。
Fidelity Score 定义为:
6.2 度量对比
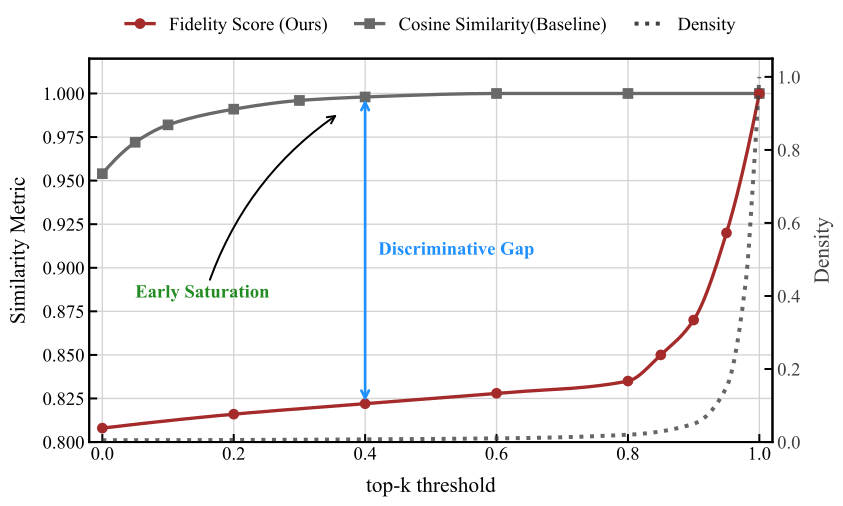
图 4. 度量对比。**余弦相似度(橙)**随稀疏度增加过早饱和,无法捕捉结构损失;**Fidelity Score(蓝)**保持平滑、单调响应,可实现精确校准。
6.3 时空保真度分配
定义参数化目标保真度函数 ,覆盖 Transformer 层 与去噪时间步 :
其中 、 分别为总层数与总时间步数。 平衡空间与时间贡献,(基线保真度)与 (过渡曲率)离线优化以满足给定约束(如 50% 全局稀疏度),而非手工调参。
对每个位于 的头,选择满足如下约束的最大稀疏阈值:
结合 WEST 的阈值图,产生推理时静态稀疏掩码,无运行时自适应。
6.4 分层采样高效 Profiling
直接在 注意力全图上计算保真度离线存储与计算开销过大。采用块级分层采样:将注意力图划分为均匀行块,每块随机采样少量行。实证仅采样 16 行(约 0.05% 全图)即可以 < 0.001 误差近似真实 Hellinger 距离(与全图真值相关性 > 0.999),使 profiling 成本降低数个数量级。
七、crm Kernel:位级块稀疏注意力执行
7.1 分辨率可扩展性
稀疏模式由模型权重而非序列长度决定,因此 ScalingAttention 在基础分辨率(如 )下构造一次稀疏拓扑,并跨尺度复用。推理时,通过保守双线性插值(ceiling rule)将基础阈值图调整为目标分辨率:
该规则保证任何与活动区域的重叠得以保留,使任意分辨率推理的存储成本恒定。
7.2 CRM 位级编码
高效块稀疏注意力需要同时支持紧凑存储与快速遍历活动 KV 块的运行时表示:
| 格式 | 缺陷 |
|---|---|
| Index-based(CSR) | 元数据流量不可忽略、内存访问不规则 |
| 密集布尔掩码 | 空间开销过大 |
CRM (Compressed Row Mask) 格式将每行注意力编码为对齐的 uint32 数组位掩码,每个位指示一个 KV 块的激活状态。单次 uint32 加载可同时解码 32 个块状态。块大小 128×128 时,即便长序列(256k token)每行仅需数十次掩码加载(256k token 需 64 次),使掩码开销相对注意力计算可忽略。
活动 KV 块通过原生 GPU 位运算(bit scan、bit clear)遍历,常数时间推进且无需显式索引解码。该迭代器直接替代 FlashAttention 的密集块迭代器,产生保留密集 Tensor Core 计算的块稀疏变体。
7.3 关键伪代码(Algorithm 2 - CRM Forward Iterator)
| 步骤 | 操作 |
|---|---|
| INIT | 加载 row_ptr,状态 S{ptr, end, val, base},base = -32 |
| ADVANCE | while S.val == 0 且未到末尾:加载下一段 S.ptr++,base += 32 |
| NEXT | 清除最低位(S.val & (S.val-1)),若归零则 ADVANCE |
| INDEX | 通过 CTZ(Count Trailing Zeros)获取全局 KV 块索引,返回 base + bit |
八、实验评估
8.1 实验设置
| 项 | 详情 |
|---|---|
| 模型 | Wan2.1-T2V-1.3B (480p), Wan2.1-I2V-14B (720p), HunyuanVideo (480p) |
| Token 配置 | Wan2.1-1.3B: 21 帧 × 1560 token; Wan2.1-14B: 3600 token; HunyuanVideo: 33 帧 × 1350 token |
| 保真度指标 | PSNR, SSIM, LPIPS, VBench (Smoothness, Consistency) |
| 效率指标 | Global Density = 稀疏注意力 FLOPs / 全注意力 FLOPs |
| 基线 | SVG (Sparse VideoGen), SVG2 (Sparse VideoGen2) |
| 实现 | 自定义 CUDA kernel,GPU 时钟锁定 1545 MHz |
| WEST 校准 | 个多样化校准 prompt |
| FAST profiling | 1 个 prompt(实践中已足够) |
| 关键超参 | 块大小 128×128,无 dense warm-up(基线需 warm-up) |
8.2 质量评估(Table 1)
| Model | Config | PSNR ↑ | SSIM ↑ | LPIPS ↓ | Smoothness ↑ | Consistency ↑ | Density ↓ | Speedup ↑ |
|---|---|---|---|---|---|---|---|---|
| Wan 2.1 1.3B 480P T2V | Dense | - | - | - | 98.46 | 96.07 | 100% | 1× |
| SVG | 19.71 | 0.7314 | 0.2684 | 97.87 | 92.58 | 50% | 1.27× | |
| SVG2 | 24.44 | 0.8387 | 0.1249 | 98.25 | 92.46 | 50% | 1.31× | |
| Ours | 26.61 | 0.8734 | 0.0986 | 98.31 | 93.16 | 50% | 1.65× | |
| Wan 2.1 14B 720P I2V | Dense | - | - | - | 98.96 | 98.46 | 100% | 1× |
| SVG | 22.34 | 0.7385 | 0.1597 | 98.62 | 95.54 | 52% | 1.47× | |
| SVG2 | 23.33 | 0.7474 | 0.1431 | 98.50 | 95.75 | 52.5% | 1.56× | |
| Ours | 24.15 | 0.7778 | 0.1191 | 98.65 | 96.00 | 52.5% | 1.90× | |
| HunyuanVideo 480P T2V | Dense | - | - | - | 98.87 | 91.59 | 100% | 1× |
| SVG | 26.4696 | 0.8592 | 0.1125 | 98.94 | 91.76 | 55% | 1.68× | |
| SVG2 | 28.3100 | 0.8853 | 0.0860 | 98.89 | 91.26 | 55% | 1.69× | |
| Ours | 28.8844 | 0.8996 | 0.0756 | 98.85 | 91.45 | 55% | 1.73× |
关键发现:ScalingAttention 在三个模型上同时取得最高 PSNR、SSIM、LPIPS 与 Speedup,确立新的帕累托前沿。Wan2.1-14B 上 1.90× 加速、52.5% 密度下 PSNR 仍达 24.15 dB。
8.3 整体性能对比
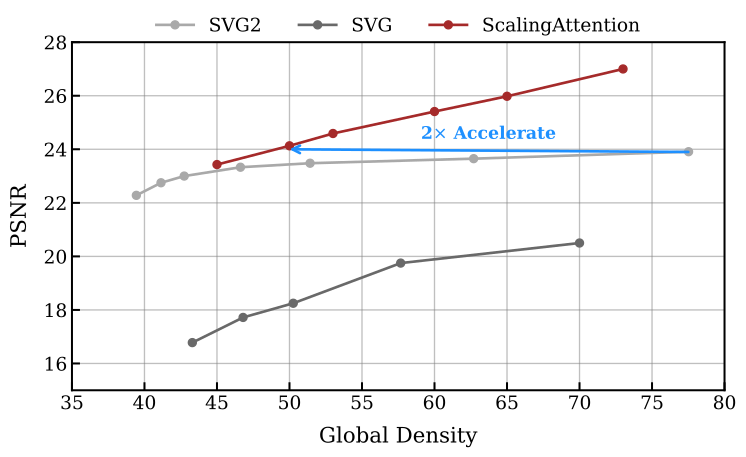
图 1. ScalingAttention 与 SVG/SVG2 在 Video DiT 上的性能对比。相同 PSNR 下 ScalingAttention 注意力 FLOPs 最多减少 2×(即更低密度),相比 SVG2 展现更优的效率-保真度权衡。密度定义为 ,表示活动注意力块的比例。
8.4 核级效率基准(Figure 5)
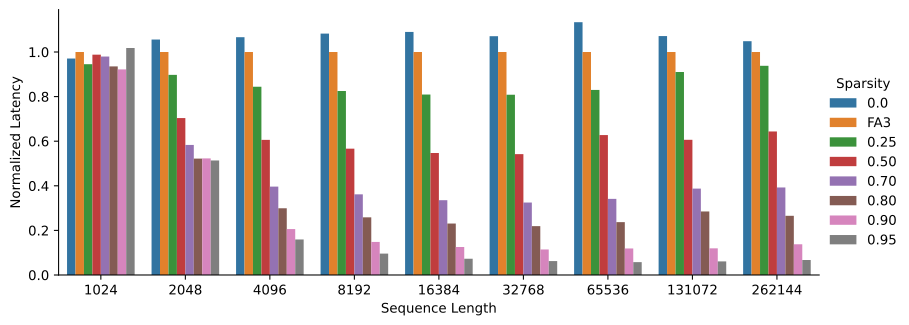
图 5. 核级效率基准。比较 crm kernel 与 FlashAttention-3(FA3)在 1K 到 262K 序列长度上的归一化延迟。橙条为 FA3 基线(1.0)。即使 0% 稀疏度(蓝),核开销 < 10%(得益于高效位掩码加载);稀疏度提升(绿到灰)时延迟显著下降,展现线性可扩展性。50% 稀疏度时延迟降低 40-60%;极端稀疏(>90%)时 > 10× 加速。
8.5 短序列密集开销(Figure 6)
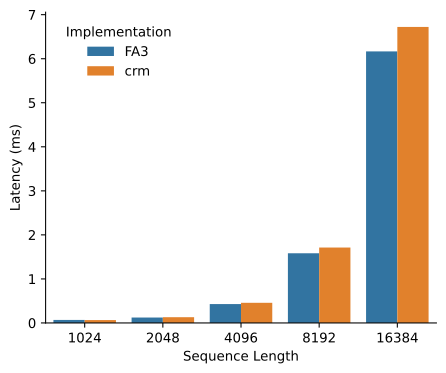
图 6. 短序列密集核开销。在 0% 稀疏度的密集设置下比较 crm kernel 与 FA3 的绝对延迟(ms)。即使在通常 kernel launch 开销更明显的短序列上,crm kernel 保持与 FA3 可比的延迟曲线,最大开销仅 9.0% at N=16384。
8.6 FAST 模块消融(Table 5 - Appendix B)
| Method | 45% 密度 | 50% 密度 | 60% 密度 | 74% 密度 |
|---|---|---|---|---|
| Static Uniform (w/ 30% Warm-up) | 17.83 | 20.50 | 24.39 | 25.78 |
| ScalingAttention (Ours, 0% Warm-up) | 23.43 | 24.13 | 25.41 | 27.19 |
关键发现:在 45% 低密度下,静态均匀基线 PSNR 崩溃至 17.83 dB,而本文方法保持 23.43 dB。这证实静态阈值无法捕捉扩散过程的演化敏感度,而 FAST 有效将计算预算与模型内在时间动态对齐。本文方法无需 dense warm-up。
8.7 与正交技术的组合性(Table 4)
| Method | Density | PSNR ↑ | SSIM ↑ | LPIPS ↓ |
|---|---|---|---|---|
| Ours + FastWan (3-step distilled) | 54.0% | 24.61 | 0.8848 | 0.0732 |
| + PARO token permutation | 53.7% | 24.92 | 0.8904 | 0.0680 |
结论:(1) ScalingAttention 与外部加速策略无缝集成,不引起不成比例的误差累积;(2) token permutation 是缓解 128×128 粗粒度瓶颈的实用方案。
8.8 离线一次性成本(Table 3 - HunyuanVideo-13B)
| Stage | Time (s) | Storage |
|---|---|---|
| WEST sampling (one prompt) | 2228 | 17 GB |
| FAST sampling (one prompt) | 340 | 96 GB |
| Threshold map + Fidelity Score 构造 | 759 | 8.6 GB |
| Density search | 330 | - |
| One target-density mask | 118 | 8.2 GB |
注意:HunyuanVideo-13B 生成单个 5s 720P 视频已需近 2300 s,故一次性 profiling 流水线在复用下可行。中间张量大但可跨后续推理运行摊销。
九、敏感度分析
9.1 校准集大小 影响
WEST 的拓扑结构快速饱和。 时并集掩码密度已稳定,8-10 个多样化 prompt 即足够近似最优拓扑(性能损失可忽略)。
9.2 分层采样比率(Table 6 - Appendix D)
| Sampled Rows (N) | Mean Consistency | Worst-case Consistency |
|---|---|---|
| 2 | 0.999 | 0.980 |
| 4 | 1.000 | 0.985 |
| 8 | 1.000 | 0.983 |
| 16 | 1.000 | 0.999 |
| 32 | 1.000 | 0.999 |
| 64 | 1.000 | 1.000 |
N=16 时与全图真值相关性 > 0.999,采用 N=16 以最小化离线 profiling 成本。
9.3 FAST 对 Profiling Prompt 的鲁棒性(Table 2)
| Profiling Prompt | Density | Δ Density | IoU | Scale Err. |
|---|---|---|---|---|
| Aggregate ref. | 39.05% | - | - | - |
| sci-fi | 38.80% | 0.24% | 94.53% | 1.62 |
| action | 38.01% | 1.03% | 91.10% | 2.81 |
| scenery | 37.22% | 1.83% | 91.90% | 2.80 |
| object | 40.94% | 1.89% | 93.63% | 1.98 |
所有单一 prompt 与聚合参考的 IoU > 91%、密度偏差 < 1.89%,证实单 profiling prompt 即可实用。sci-fi prompt 近似最佳(密度差 0.24%,IoU 94.53%)。
9.4 宽高比鲁棒性
在 Wan2.1 上测试 与 输入,即使相同 prompt 产生显著不同语义布局,注意力分布仍共享几乎相同的稀疏支持模式与高召回率。WEST 捕获的是可复用支持包络,主要由模型决定而非具体输入布局。实践中采用混合校准策略,从多个宽高比采样 prompt 以略微提升覆盖(无运行时开销)。
十、阈值图视觉画廊(Appendix F)
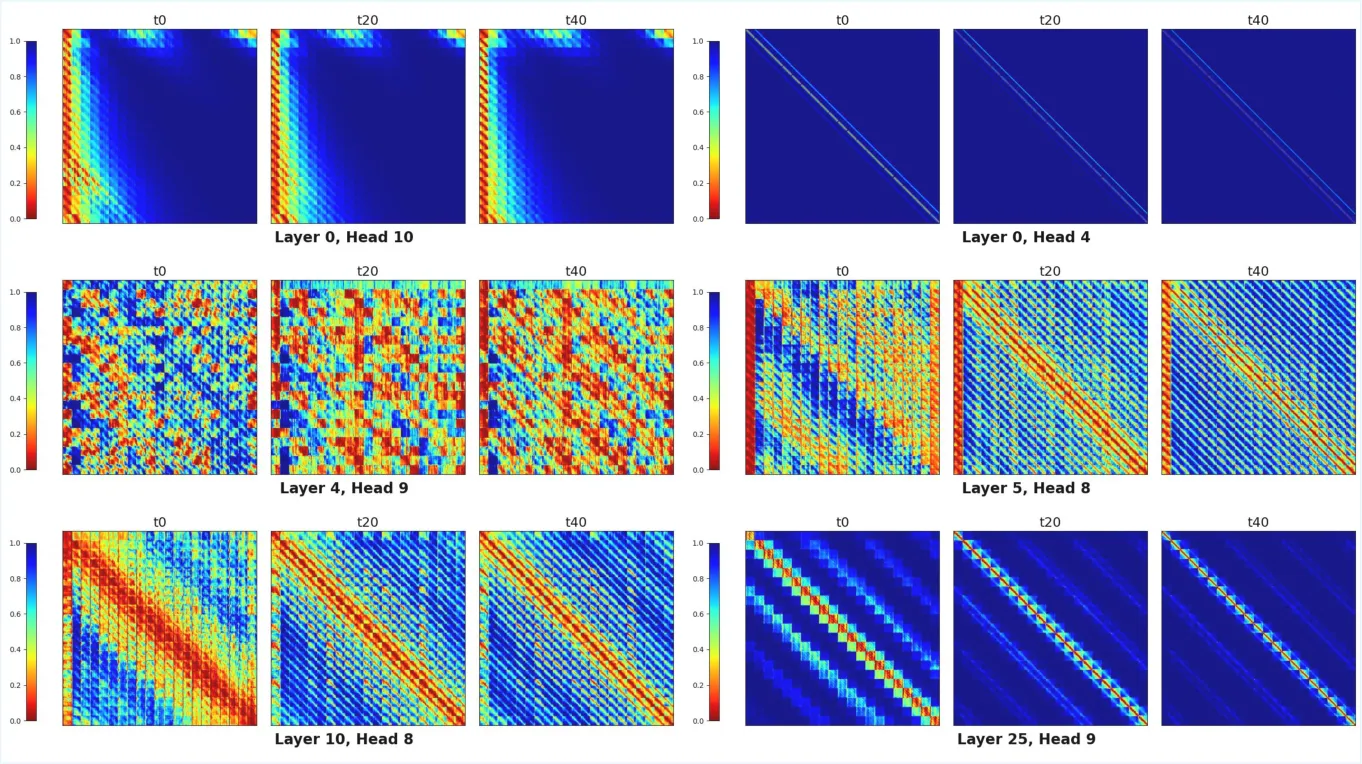
图 7. WEST 阈值图画廊。可视化跨层/头与扩散时间步()的代表注意力结构。尽管 per-prompt 激活多样,WEST 捕获的稳定支持包络保持一致,支撑内在、权重编码稀疏拓扑的存在。
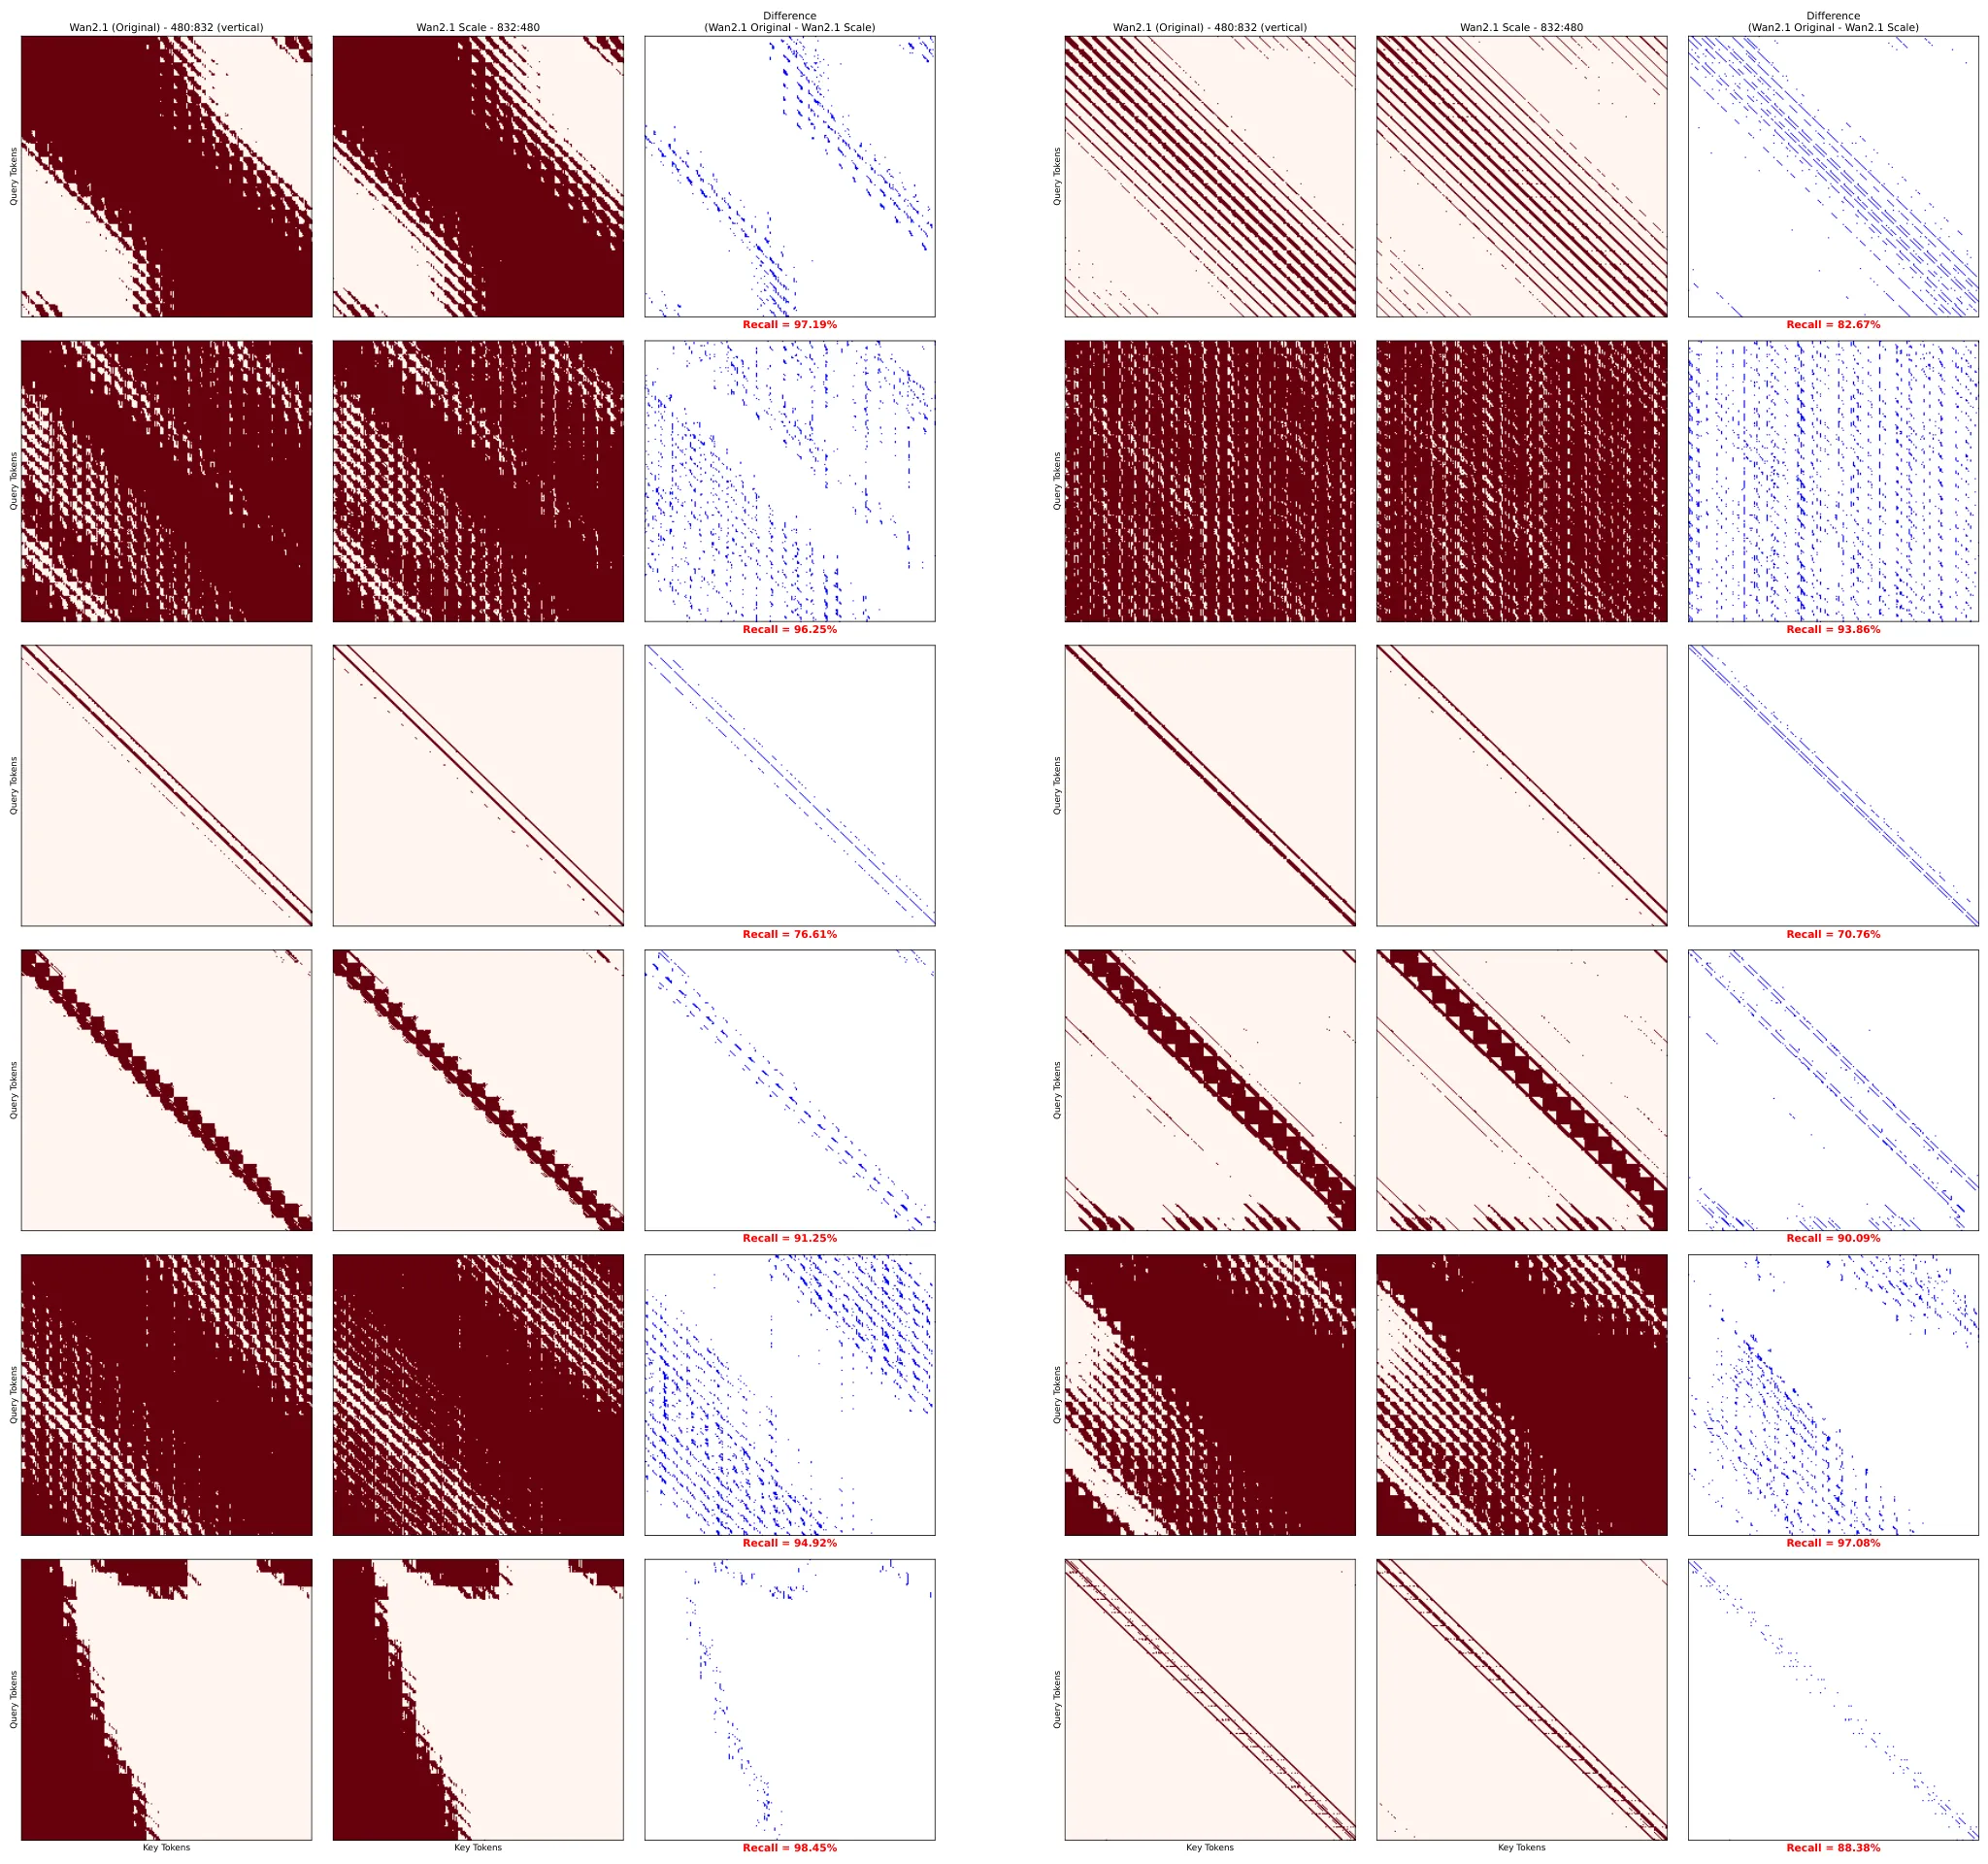
图 8. 宽高比鲁棒性可视化。同一 prompt 在不同宽高比设置下生成视频呈现显著语义布局差异,但恢复的稀疏注意力支持几乎不变。这进一步说明 Intrinsic Sparse Topology 主要由权重编码而非输入特定。
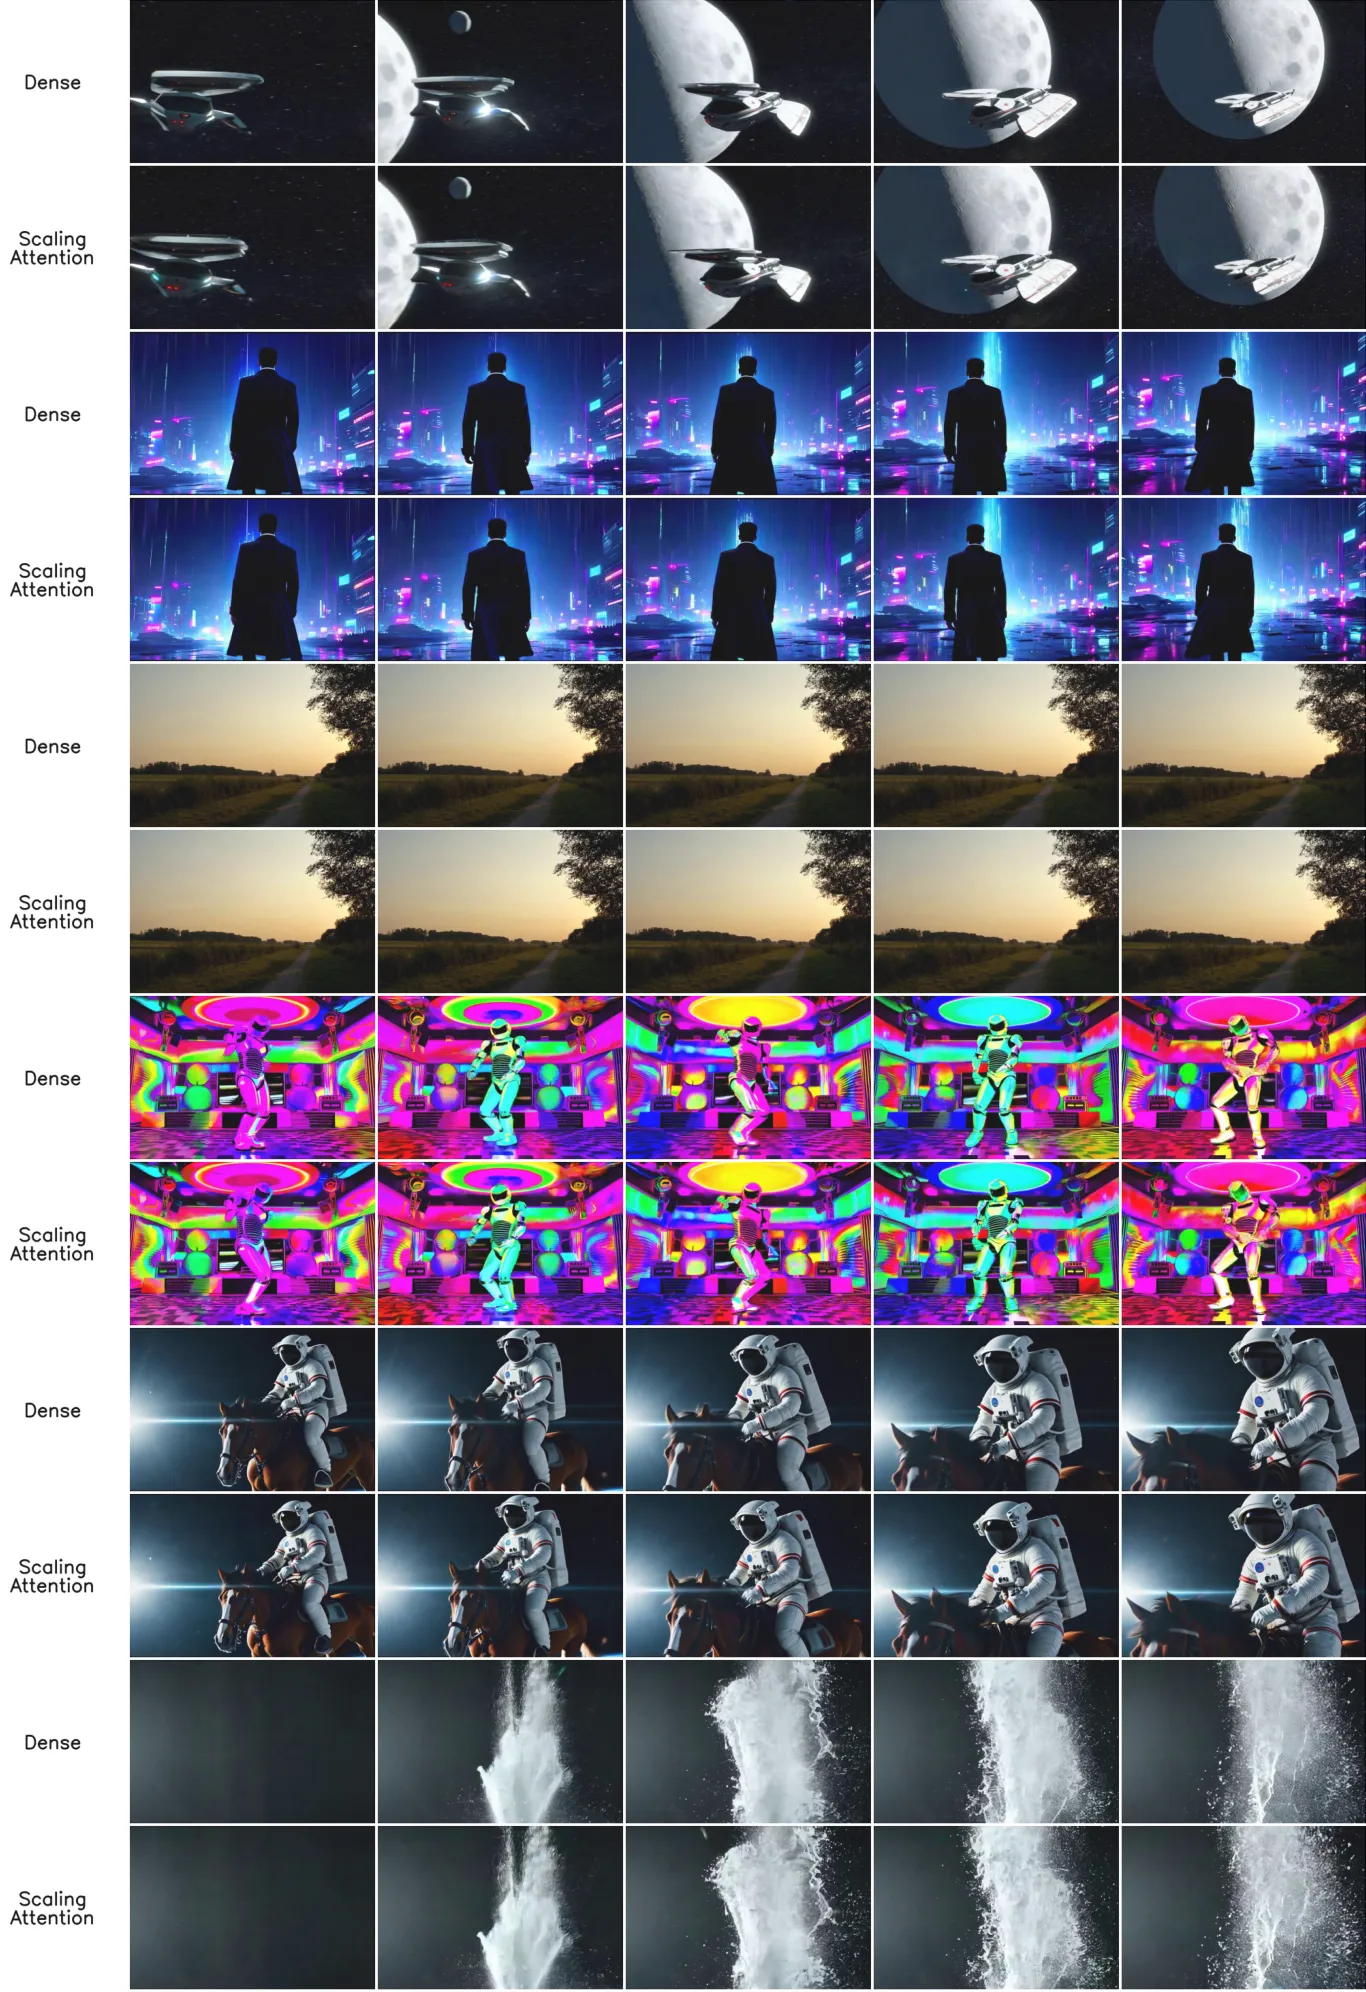
图 9. HunyuanVideo 定性对比。密集注意力与 55% 全局密度 ScalingAttention 的并排帧。
十一、核心创新总结
| 创新点 | 描述 |
|---|---|
| Intrinsic Sparse Topology 发现 | 首次系统揭示 Video DiT 注意力拓扑由权重编码、prompt 无关、尺度不变 |
| WEST 算法 | 离线构造阈值图,实现 掩码生成、消除运行时搜索 |
| Hellinger Fidelity Score | 用 Hellinger 距离替代余弦相似度,提供平滑、单调保真度度量 |
| 时空保真度分配 | 参数化 函数动态分配稀疏预算至敏感区域 |
| CRM Kernel | 位级块稀疏编码与 FlashAttention 集成,硬件对齐 Tensor Core |
| 分辨率可扩展性 | 保守双线性插值使单次构造跨分辨率复用 |
十二、局限性与未来工作
| 局限性 | 描述 | 缓解方向 |
|---|---|---|
| 粒度瓶颈 | 128×128 块大小限制极端稀疏(<40%)下的细粒度剪枝 | 与 token permutation (PARO) 组合 |
| 静态包络冗余 | WEST 提取活动区域并集,保留的 token 多于动态 oracle | 未来 token 重排机制 |
| 单模型通用性 | 不同模型/数据集需重新校准阈值图 | 进一步研究跨模型迁移 |
十三、参考资源
- arXiv: https://arxiv.org/abs/2606.23019
- HTML 版本: https://arxiv.org/html/2606.23019
- PDF 版本: https://arxiv.org/pdf/2606.23019v1
- 作者机构: KlingAI Research, Beijing Institute of Technology, NVIDIA, Tsinghua University
- 实验模型: Wan2.1-1.3B / 14B (Alibaba), HunyuanVideo (Tencent)
- 基线: SVG, SVG2 (Sparse VideoGen series)
- 依赖: FlashAttention-3 (Shah et al., 2024), Wan2.1 (Wan et al., 2025), HunyuanVideo (Kong et al., 2025)