LiveServe: 面向实时全模态 LLM 的交互感知服务系统
首个交互感知(interaction-aware)的实时 Omni-LM 服务系统:把播放进度、语音活动、barge-in 事件暴露给调度与 KV 管理。调度器用 U0/U1/U2 三级紧急度优先 first-audio 与近欠载会话、限制超前播放前沿的生成;KV 管理器用 next-use 感知驱逐替代 LRU、并在用户说话时预加载可能需要的 KV 以隐藏 reload 延迟。基于 vLLM-Omni,在两个 Omni-LM 与混合负载上把 P90 音频 TTFP 平均降 1.55×(至多 2.21×),完成请求吞吐平均升 1.15×(至多 1.56×),把大部分 KV reload 移出下一轮关键路径
LiveServe: Interaction-Aware Serving for Real-Time Omni-Modal LLMs
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | LiveServe: Interaction-Aware Serving for Real-Time Omni-Modal LLMs |
| 作者 | Xiangyu Zhi, Peiqi Yin, Sheng Guan, Chenguang Zheng, James Cheng, Xiao Yan |
| 论文 | https://arxiv.org/abs/2606.22983 |
| HTML | https://arxiv.org/html/2606.22983v1 |
| 发布 | 2026-06-22(v1) |
| 分类 | cs.DC(分布式与集群计算) |
| 平台 | 单台 8×H200 服务器(2× Intel Xeon Platinum 8480C,2.0 TiB DRAM);基于 vLLM 0.20.0 + vLLM-Omni 0.20.1 |
| 代码规模 | 约 6000 行 Python |
二、核心思想
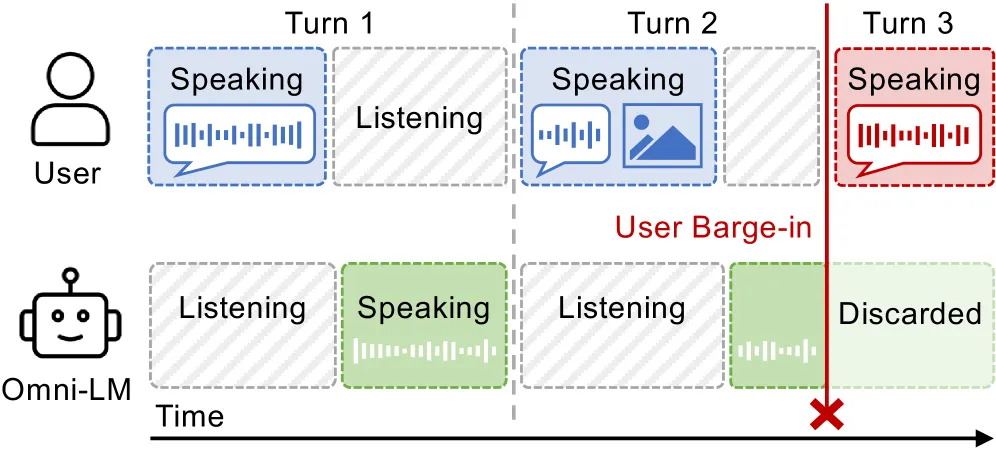
全模态大模型(Omni-LMs,又称 any-to-any 模型)支持以语音为中心的对话:用户流式输入语音/图像/视频,听生成的音频,并可随时打断(barge-in)。代表模型如 Qwen3-Omni、Ming-Omni、Nemotron VoiceChat,通常采用多阶段流水线:编码器 → 语言 backbone(thinker,理解与回复规划)→ 语音合成(talker 生成语音 token + vocoder 重建波形)。
现有 Omni-LM 服务系统(vLLM-Omni、SGLang-Omni)仍沿用面向吞吐的 LLM 调度与 LRU KV offload。这些策略在 session 级缺乏全局视图,忽略两个关键交互语义:
问题定义
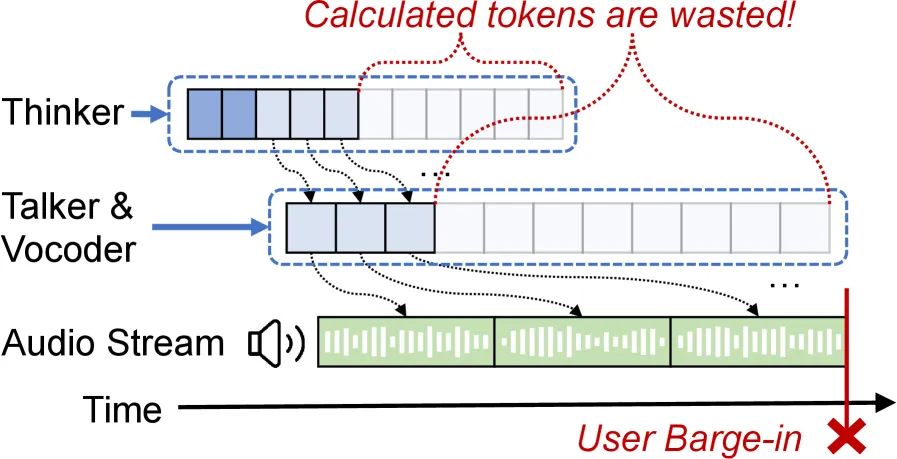
① 过度生成(Excessive generation):客户端以固定速率播放音频,而 thinker/talker 持续以远超已听内容的速度解码合成。stage-local 调度器只偏好更快的 token 产出,即使缓冲已足够仍不断拉大生成领先。一旦用户 barge-in,超前生成但尚未播放的 token 全部作废。用户真正关心的是音频**首包时间(audio TTFP)**和播放是否流畅,而非 TBT——音频一旦开始且无卡顿,进一步降 TBT 并不改善体验。
② 被动缓存管理(Passive cache management):多轮 session 需在每个 stage 保留历史轮次的 KV 供当前轮复用,音频/视频输入产生的大 KV cache 加剧 HBM 压力。LRU 反映”最近访问”而非”下一轮时机”——一个在用户播放期间安静的 session 可能被误判为冷而驱逐,尽管其 KV 下一轮很可能被需要;且被驱逐的 KV 只在当前轮已开始时才恢复,reload 时间直接推高 TTFP。
解决方案概述
LiveServe 是首个交互感知的实时 Omni-LM 服务系统。它保留 vLLM-Omni 的 stage-oriented 执行模型,但把运行时分为交互平面(interaction plane)与数据平面(data plane):交互平面追踪流式到达、播放进度、barge-in 等实时 session 信号,并将其暴露给调度器与 KV 管理器,使引擎级控制决策能响应用户交互而不改变模型流水线。
三、技术架构
3.1 系统架构
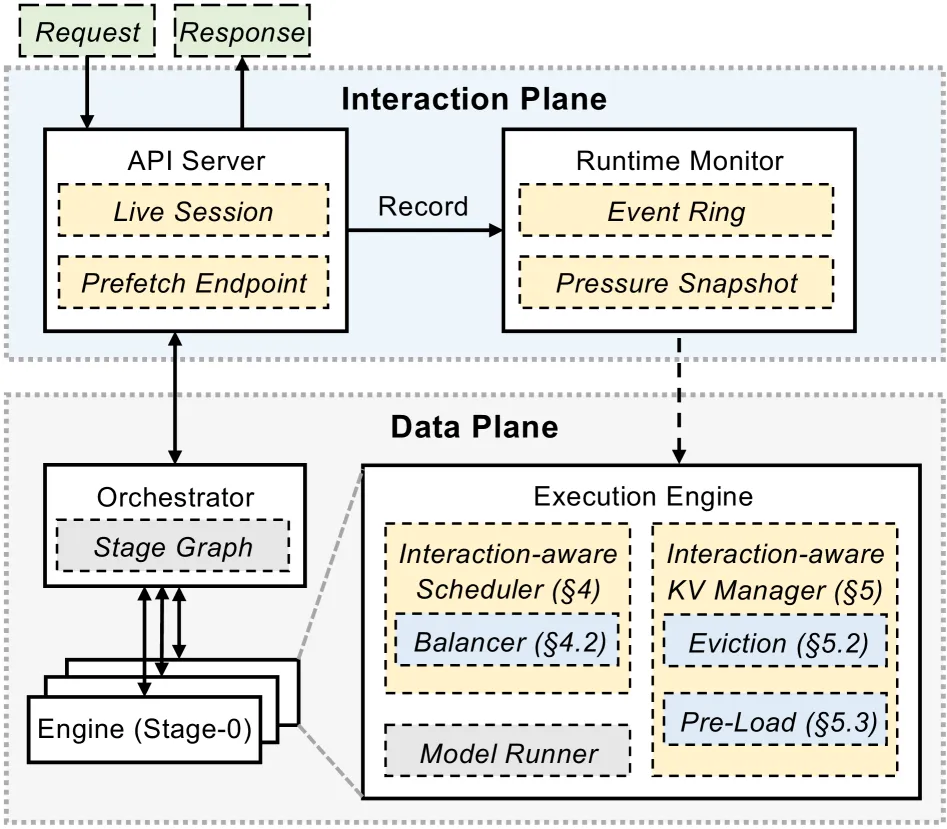
- 面向 session 的交互层:API server 是实时多模态 session 入口,转发流式输入、返回生成音频,并暴露 prefetch 端点(历史预热与当前轮 prefill,与延迟关键的解码分开标记)。轻量 runtime monitor 把客户端信号(播放是否正常推进、是否被打断)转成紧凑的运行时视图(事件环 event ring + 压力快照 pressure snapshot),供引擎策略读取而不与 session 协议耦合。
- 交互感知执行引擎:每个模型 stage(thinker/talker/vocoder)作为一个引擎运行,内含交互感知调度器 + 交互感知 KV 管理器 + model runner。monitor 的 session 状态喂入这两个组件。
- stage-oriented 编排:沿用 vLLM-Omni 的 orchestrator 与 stage graph 连接各引擎,保留已有的解耦执行基底。
- barge-in 处理:播放时客户端上报已消费音频量,VAD 检测新话语。barge-in 到达时 orchestrator 通知服务当前响应的引擎——中止在途计算、丢弃播放点之后的 token、清理临时状态;同时 monitor 记录中断供后续调度/KV 决策观察。
3.2 交互感知调度:U0/U1/U2 三级紧急度
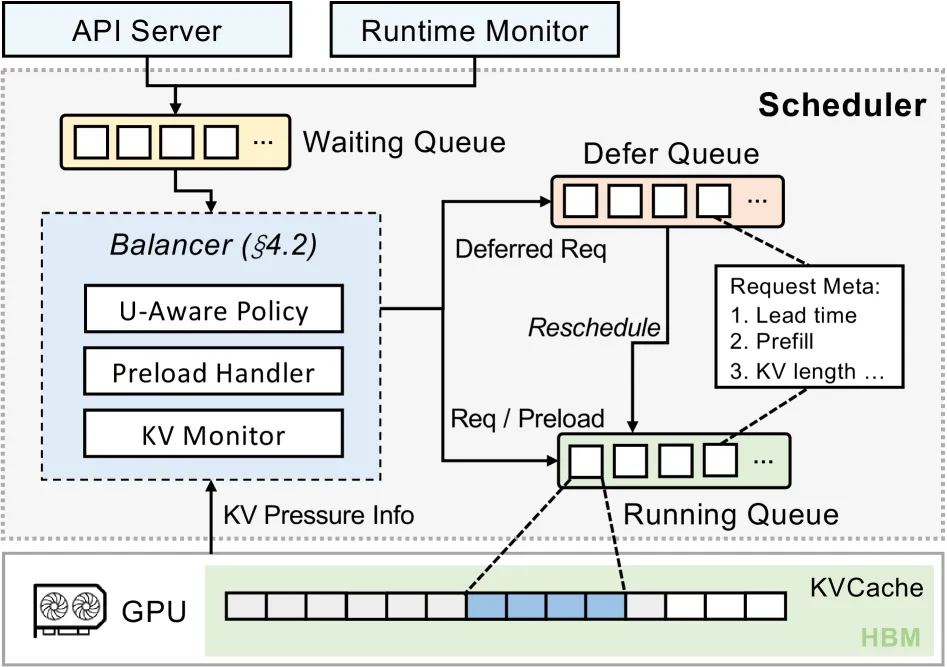
LiveServe 用交互感知策略替代 FCFS。核心信号是 stage-aware 播放缓冲 (估计 stage 已产出超过下游当前所需的量);令 为识别播放风险的最小安全缓冲。每个请求分到紧急度类 (越小越紧急):
- U0 播放紧急:已开始播放但缓冲很小(),最紧急——延迟会导致可听卡顿。按播放缓冲升序排(最接近欠载者先服务)。
- U1 首音频紧急:尚未产出首个可播放音频包,在 audio TTFP 关键路径上。按 ready age 排序(保留 FCFS 老化)。
- U2 效率调度:已产出首音频且缓冲充足,用一个平衡 KV 压力缓解与超前生成的 utility 排序。
U2 效率策略(公式 1):
其中 barge-in 暴露成本(公式 2)惩罚过大的播放缓冲(超前但未听的工作在打断时可能被丢弃):
是 KV 压力收益(当 stage KV 池接近满时,偏好已占用大量 KV 的请求,使其尽快完成释放 HBM)。 离线在 mock 负载上扫描确定,取”丢弃工作”与”KV 压力停顿”的最佳折衷。
调度流程(Algorithm 1):每轮刷新交互状态、估计 、分类 (仅 U2 需算 );分别对 U0(按 升序)、U1(按 age 降序)、U2(按 降序)排序后按 U0-U1-U2 顺序拼接扫描;在 token 预算与可用 KV 块预算内逐个 admit,超预算即停。实时请求对效率工作有严格优先权。
3.3 交互感知 KV 管理
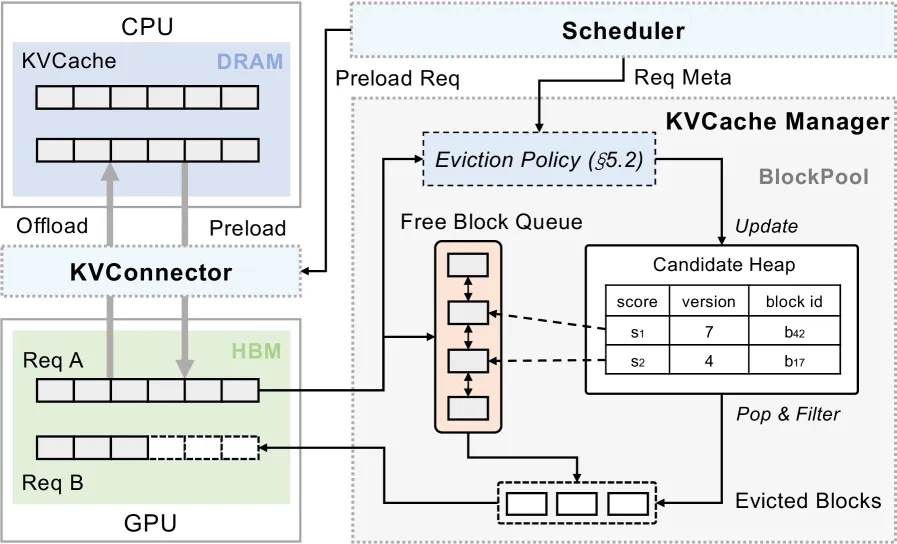
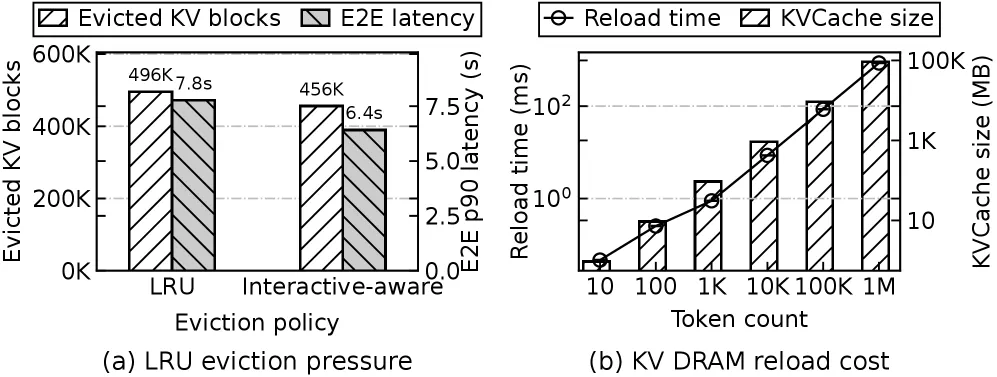
① Next-use 感知驱逐(替代 LRU):LRU 的弱点在于会话间播放进度差异——刚完成 LLM stage 的会话可能还有长音频待播(KV 短期不会复用),而另一会话 KV 更旧但接近播放完成(下一轮更可能)。LiveServe 保留块级 KV 分配,但按下次使用时间估计排序驱逐候选(公式 4):
是剩余播放时长, 用 per-session 移动平均(或 workload 级先验)估计从播放完成到下一轮输入的间隔。该估计仅用于排序,无需精确 wall-clock。若 monitor 报告语音开始或 barge-in,则视为即时复用、保护其 KV 免于常规驱逐。HBM 压力下按 降序扫描(下次使用最远者先驱逐);会话内后缀块优先于前缀块驱逐(前缀被更多未来轮共享、重建成本更高)。
② 语音触发的 KV 预加载:next-use 驱逐减少不必要的换入换出,但无法消除必要 reload 的延迟。若 offload 的 KV 只在下一轮请求到达 LLM stage 后才加载,DRAM→HBM 传输会延迟 prefill、推高 TTFP。LiveServe 在语音开始或 barge-in 时(在完整用户输入到达模型前)就启动预加载,用说话间隔重叠 KV 传输。预加载作为best-effort 后台工作:仅当剩余到 LLM-stage 执行的时间足够隐藏传输成本时才准入异步 DRAM→HBM 传输;准入失败则跳过,回落到正常 LLM-stage 加载路径。预加载不改变正确性——若传输未完成/取消/被驱逐,下一轮回落到同步加载。
四、实现(§6)
基于 vLLM-Omni 实现,约 6000 行 Python,三大组件:交互感知调度器、monitor 驱动的请求状态路径、层次化 KV 管理器。fail-closed 设计:所有机制运行时可选,缺失元数据或禁用策略即回落到原始服务行为——缺播放缓冲遥测则禁用交互感知排序,缺 U2 utility 输入则 U2 退化为 ready-age 排序,稀疏驱逐元数据回落默认 LRU,预加载准入失败回落同步加载。KV 管理器把策略元数据存在附加于请求/会话/KV 块的**旁路表(side tables)**中,不改上游块布局;驱逐用索引候选堆(indexed heap),保留原 LRU 分配器作 fallback,索引路径可 logging-only 或仅在元数据可用时替换 LRU。
五、实验结果(§7)
5.1 实验设置
- 数据集:ShareGPT 中英 90K 语料(单轮,短/长上下文压测首 token 延迟);交互 trace(多轮,含 session ID、时间戳、query/response 长度、轮索引);StreamingBench + 混合 Omni 数据(视频 + 语音)。
- 负载:Poisson 合成到达 + 트레이스驱动 BurstGPT(捕捉短期负载尖峰);barge-in 建模为客户端 Bernoulli 概率 (默认 0,敏感性用 {0.0,0.3,0.7,1.0})。
- 基线:vLLM-Omni-wo(无 KV offload)+ vLLM-Omni(启用 vLLM 式 LRU KV offload,默认)。
- 模型:Qwen3-Omni(三阶段,thinker DP=4 + talker DP=4)、Ming-Flash-Omni 2.0(两阶段,thinker TP=2/DP=2 + talker DP=4)。
- 指标:音频 TTFP(默认 P90)、RTF(<1 表示快于实时)、播放连续性(gap <100ms 为连续)、有用 RPS(满足连续性 SLO 的最高负载)。
5.2 主结果
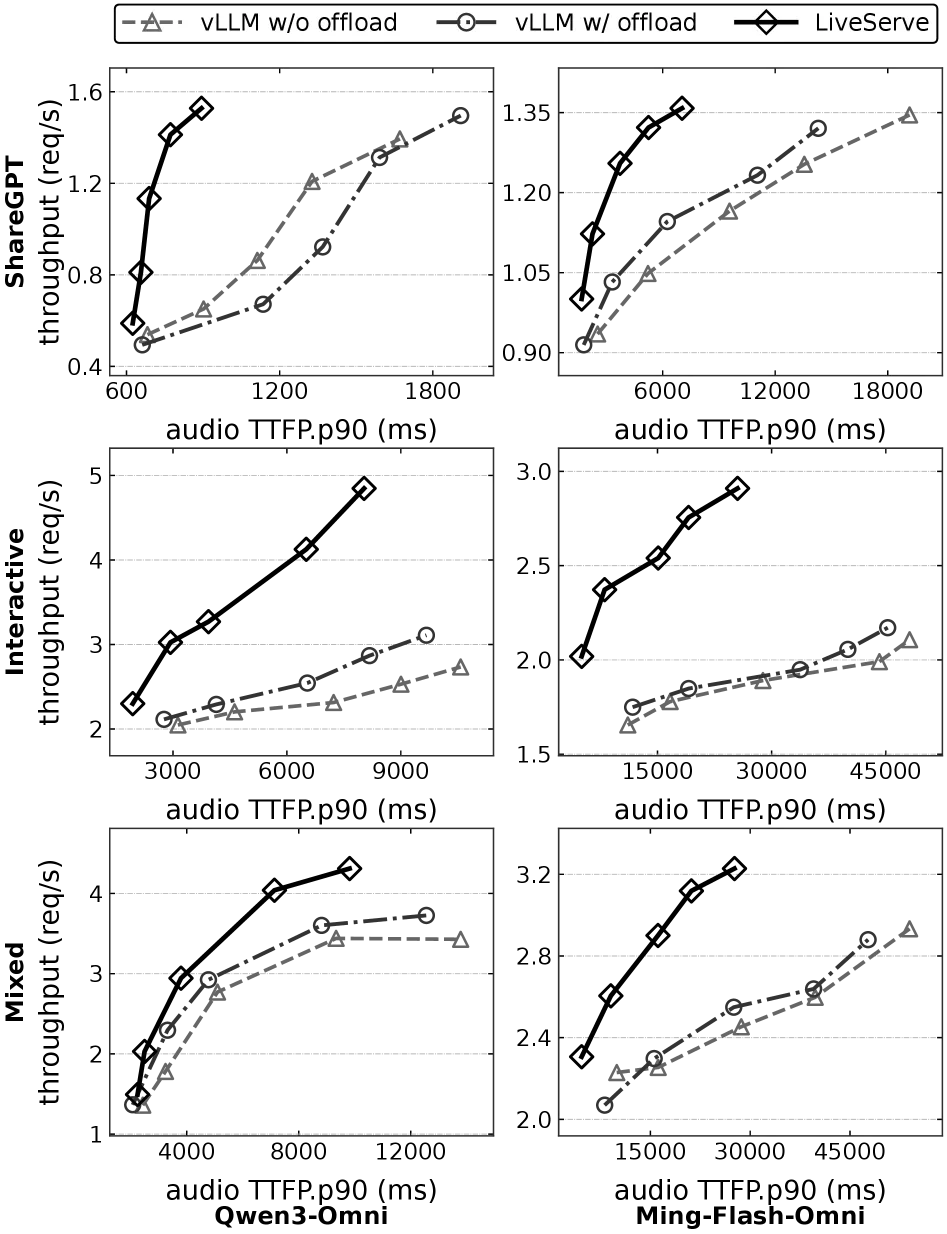
吞吐-延迟前沿(Figure 10,两 Omni-LM × 三负载,越靠左上越好):LiveServe 在所有组合上持续改进前沿。
| 场景 | 关键结果 |
|---|---|
| ShareGPT(单轮,KV 复用少) | 峰值吞吐相当或更高,高并发 P90 音频 TTFP 在两模型上均降约 2× |
| 交互 trace(多轮,KV 压力大) | Qwen3-Omni 峰值吞吐超基线 56–78%;中等并发吞吐 +28.5%、P90 TTFP −39.8%(对 offload 基线) |
| 混合负载 | 最大并发下吞吐超最佳基线 12–16%,P90 TTFP 大幅降(Ming 上约 −42%) |
尾延迟分布(Figure 11 左,Qwen3-Omni ShareGPT,c=8 无 barge-in):中位数 0.86s→0.53s,P90 1.38s→0.84s,P95 1.45s→0.92s。
播放连续性(Figure 11 右):c=12 时 91.8%(vs offload 基线 81.3%);c=16 时 87.5%(vs 76.6% 和 70.3%)。
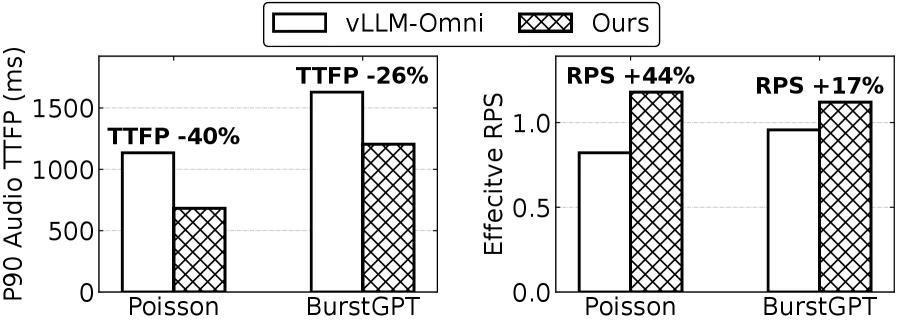
到达分布(Figure 12,c=8):Poisson 下 P90 TTFP 1.13s→0.68s、有效吞吐 0.82→1.18 RPS;BurstGPT 下 P90 TTFP 1.63s→1.20s、吞吐 0.96→1.12 RPS。
barge-in 敏感性(Figure 13,c=8):有效 RPS 全程超基线, 时吞吐 2.6×、 时 2.0×。
5.3 分析
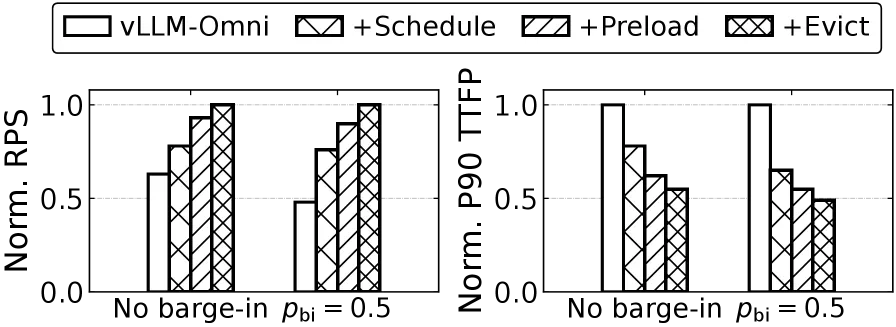
组件消融(Figure 14,Qwen3-Omni):无 barge-in 时全系统 P90 TTFP −29.8%、RPS +8.8%;启用 后增益扩大到 P90 TTFP −39.8%、RPS +28.5%。调度、预加载、驱逐三者互补而非冗余。
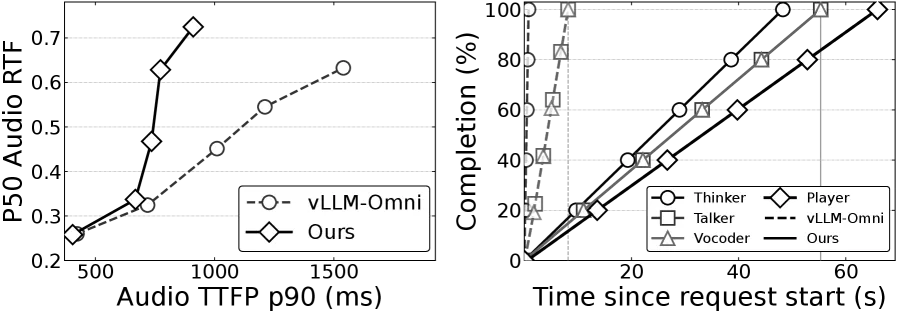
RTF-延迟权衡(Figure 15):LiveServe 不追求尽快生成语音。长时程例子中,基线约 8.2s 完成模型侧生成而播放器耗时约 65.9s,累积大量可被丢弃的缓冲;LiveServe 把生成”拉长”到约 55.3s(贴近播放进度),既保连续性又释放解码能力给 U1 首音频请求。c=8 时 P90 音频 TTFP 从 1.54s 降到 0.91s,中位 RTF 仍 <1。
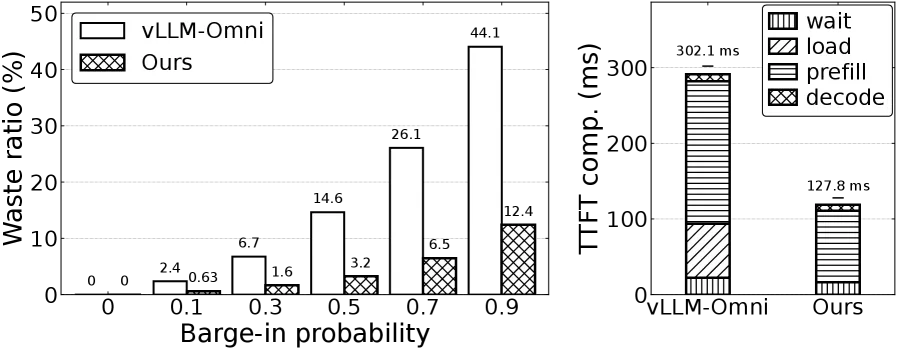
barge-in token 浪费(Figure 16 左):无 barge-in 时两系统均零浪费;随 增大,vLLM-Omni 浪费比率升至 44.06%,LiveServe 靠 U2 barge-in 暴露项把浪费限制在至多 12.38%,消除约 72–78% 的浪费 token。
reload 压力下的首 token 关键路径(Figure 16 右):offload 基线在路径上花 71.0ms KV reload、文本 TTFP 达 302.1ms;LiveServe 命中暖预取后消除 reload 段,文本 TTFP 降到 127.8ms(−57.7%)。
5.4 微基准
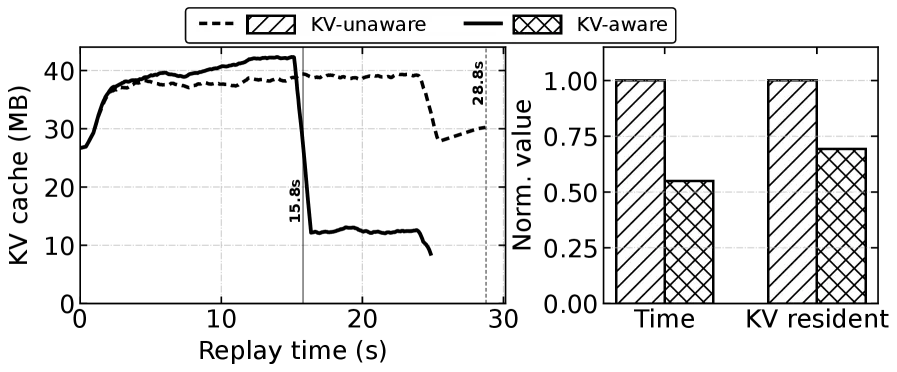
- KV 驻留时间线(Figure 17):KV 压力下 KV-aware 排序偏好驻留的长上下文请求,使其更早完成释放 HBM,归一化驻留 KV 足迹更低。
- 驱逐索引开销(Table 1,交互多轮无 barge-in):堆式驱逐索引把平均开销从 5.31ms 降到 0.093ms、P90 从 8.27ms 降到 0.222ms,有效 QPS 从 1.97 升到 2.63——避免 next-use 驱逐成为调度瓶颈。
核心 takeaway:内存管理目标不是始终最小化 KV 驻留,而是在下一轮到来前保持正确的会话 KV 驻留;音频调度应保足够播放缓冲以维持连续性,同时不累积过多可丢弃音频。
六、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| 交互平面/数据平面分离 | 把播放进度、语音活动、barge-in 暴露给引擎级控制,不改模型流水线 | runtime monitor + 事件环/压力快照 |
| U0/U1/U2 交互感知调度 | 优先 first-audio 与近欠载会话,U2 用 utility 限制超前播放前沿的生成 | 浪费 token 从 44% 降到 ≤12.38%;播放连续性 c=16 时 87.5% vs 70.3% |
| Next-use 感知 KV 驱逐 | 用 替代 LRU,前缀优先保留 | KV-aware 排序更早释放 HBM |
| 语音触发 KV 预加载 | 语音开始/barge-in 即预取,用说话间隔隐藏 DRAM→HBM 延迟 | 文本 TTFP −57.7%(消除 71ms on-path reload) |
| 堆式驱逐索引 | O(log n) 候选选择,避免 next-use 驱逐成为瓶颈 | 平均开销 5.31ms→0.093ms |
| fail-closed 工程 | 所有机制可选,缺元数据回落原生行为,保正确性 | 旁路表 + LRU fallback |
七、相关工作与总结
核心贡献
- 指出现有 Omni-LM 服务系统的两大问题:面向吞吐调度导致超前播放的过度生成(barge-in 后浪费),LRU KV offload 忽略多轮复用时机(错误驱逐 + reload 上关键路径)。
- 提出 LiveServe——交互感知服务系统,通过交互平面暴露播放/语音/barge-in 信号,实现 U0/U1/U2 调度、next-use 驱逐、语音触发预加载。
- 基于 vLLM-Omni 实现(约 6000 行),在两 Omni-LM 与三负载上:P90 音频 TTFP 平均降 1.55×(至多 2.21×),完成请求吞吐平均升 1.15×(至多 1.56×),把大部分 KV reload 移出下一轮关键路径。
技术影响
将”用户实际听到什么”(播放前沿)作为服务系统的一等调度信号,是实时语音/全模态交互服务的范式转变——它揭示了传统 LLM 服务的 TTFT/TBT/吞吐指标与实时音频交互体验(audio TTFP、播放连续性)之间的错位。
局限性
- 依赖客户端上报播放进度与 VAD barge-in 信号的准确性(缺失时回落到 progress counter / 原生行为)。
- 需离线在 mock 负载上扫描,跨新负载可能需重调。
- 用移动平均/先验估计,对话模式突变时可能不准(仅用于排序,容错)。
- 评测限于单台 8×H200、语音导向 Omni-LM;扩展到多机或图像/视频生成(DiT)输出的普适性未充分验证。
八、参考资源
- 论文(abs):https://arxiv.org/abs/2606.22983
- HTML 全文:https://arxiv.org/html/2606.22983v1
- PDF:https://arxiv.org/pdf/2606.22983
- 图片索引:
figures/2606.22983-liveserve/README.md