Load Testing for Machine Learning Model Serving Systems at Scale
本文提出工业级 ML 推理容量测试框架 Vanguard:基于自适应反馈搜索(dampening / spike tolerance / convergence detection)、多指标健康评估状态机、以及流量回放的负载生成器,为 GPU 上多类别模型(推荐/排序/视觉/NLP)精确估计可持续吞吐量。14 个工业模型上估计误差中位 5.2%,与实测容量 R²=0.94,单个模型 GPU 减配 49–83%。
Load Testing for Machine Learning Model Serving Systems at Scale
一、论文概述
| 字段 | 内容 |
|---|---|
| 标题 | Load Testing for Machine Learning Model Serving Systems at Scale |
| 作者 | Amr S. Abdelfattah, Nakul Tirumalai, Indu Mohanan, Xiao Li, Pengchao Wang, Dinakar Dhurjati, Eric Sung |
| 机构 | 工业界 ML 服务团队(论文明确 “industrial framework”,作者按工程栈风格与 UVM / 部署流水线细节推断为大型互联网/推荐团队;论文未点名雇主,以其”生产系统”表述为准) |
| 论文链接 | https://arxiv.org/abs/2606.22013 |
| HTML | https://arxiv.org/html/2606.22013v1 |
| https://arxiv.org/pdf/2606.22013 | |
| 发布 | 2026-06-20 |
| 分类 | cs.LG(primary)、cs.PF |
| 系统别名 | Vanguard |
二、核心思想
问题定义
ML 推理服务已成为公司 GPU 基础设施的头号消费者,但容量规划仍靠拍脑袋:欠配额会造成 SLO 违规和线上事故,超配额则大量浪费 GPU。传统 Web 负载测试工具(JMeter/Locust/k6)与离线基准(MLPerf Inference)都无法处理 ML 推理特有的以下问题:
- Model warmup:JIT 编译、CUDA kernel cache、模型权重加载导致最初 2–5 min 的吞吐/延迟不能代表稳态。
- Dynamic batching:延迟对并发的非线性依赖,与 Web 服务的”独立请求”假设完全不同。
- 架构异构:亚毫秒 embedding 到多秒生成模型都需要不同的测试策略。
- 硬件敏感:不同 GPU 代际、显存配置、co-location 模式会带来系统性偏差。
论文核心问题:如何在保证 SLO 的前提下,自动、可复现地估计 ML serving 部署的最大可持续吞吐(IPS/QPS)。
解决方案概述
Vanguard 是一个分布式工业负载测试框架,提供:
- 自适应反馈驱动搜索(Adaptive Feedback-Driven Search):dampening + spike tolerance + convergence detection 三机制的组合。
- 多指标健康评估引擎:weighted health score + 五态状态机 + hysteresis,避免”flapping”。
- ML-aware 负载回放:录制真实流量,开环生成(避免 coordinated omission),warmup 期自动排除。
三、技术架构/方法
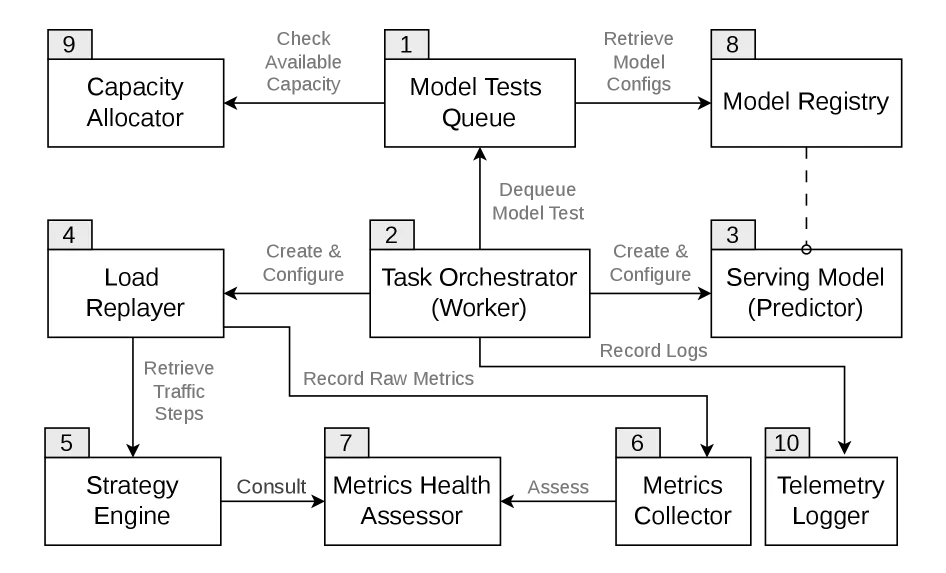
系统架构(10 组件)
- Model Tests Queue:优先级感知的测试任务队列。
- Task Orchestrator (Worker):生命周期管理,原子式 dequeue 避免竞争。
- Serving Model (Predictor):被测模型服务;提供 REST/gRPC。
- Load Replayer:受控 QPS 发送器,支持 linear ramp、warmup、开环生成,规避 Gil Tene 提到的 coordinated omission。
- Strategy Engine:策略模式实现,每个策略暴露统一接口
next_rate(metrics) → rate;可插拔。 - Metrics Collector:聚合 latency percentiles、throughput、error rate、GPU util。
- Metrics Health Assessor:多指标 + 持续违规判定。
- Model Registry:版本化模型元数据 + SLO 定义。
- Capacity Allocator:静态/动态 GPU/CPU 资源分配。
- Telemetry Logger:全部结果写入数据仓库支持复现与趋势分析。
五种测试策略
Vanguard 内置 5 种策略:
- Multi-Rate Sweep(等距扫描)。
- Binary Search,收敛复杂度 。
- Direct Controller Integration(复用生产 autoscaler 决策)。
- Constant-Rate Stability Testing(1–4 小时恒定 QPS 稳定性)。
- Adaptive Feedback-Driven Search(论文主要贡献)。
Adaptive Feedback-Driven Search(Algorithm 1)
初始 ,步长 ,遍历最多 次:
RunAtRate(q, duration)得到指标 ,AssessHealth得健康状态 。- Healthy:更新最优,。
- Warn:更新最优,
step ← step × α(dampening),。 - Unhealthy 但 spike 数 ≤ τ:视为噪声,
q ← q + step × α(spike tolerance)。 - 否则:backtrack,,
step ← step × α。 - 若近 3 个 best 的 CV < ,则convergence detection 提前返回。
默认参数 ,。
Health Assessment Engine
多指标加权健康分:
其中 为指标 的 SLO 阈值。得分映射到五个状态:
- → Healthy
- – → Warn
- – → Unhealthy
- – → Critical
- → Overloaded
引入 hysteresis:升级方向 n=2 窗口即触发(快速降级检测),降级方向 n=3 窗口才回落(稳健恢复);实测将 false positive 减约 40%。

四、核心创新
| # | 创新点 | 说明 |
|---|---|---|
| 1 | ML-aware 自适应搜索 | dampening + spike tolerance + convergence detection 三机制,覆盖 ML serving 特有的非线性 capacity cliff |
| 2 | 多指标加权 + hysteresis 健康评估 | 五态状态机避免 flapping;升级快、降级慢 |
| 3 | 开环 + 流量回放 | 避免 coordinated omission;用真实特征分布替代 synthetic requests(准确率巨大差异) |
| 4 | 系统化实验 + 影响分析 | 14 个工业模型(80M–1.5B)横跨 4 类架构,含 A100/H100,多维回归误差成因 |
| 5 | 6 条落地经验(L1–L6) | 从”表征 > 算法”到 co-location 修正因子的全面工程指南 |
五、实验结果
复现性(Table 3)
- 相同硬件、同时间窗:ICC = 0.96,CV = 2.9%。
- 跨硬件(A100 → H100):ICC = 0.90,系统性偏差 +4.9%。
- 工作日 vs. 周末:均值差 1.3%,不显著()。
RQ1 消融(Table 4,MAE %)
| 配置 | MAE (%) | Δ (%) | p-value |
|---|---|---|---|
| Full Vanguard | 5.2 | — | — |
| −Warmup handling | 27.4 | +22.2 | <0.001 |
| −Recorded replay | 31.6 | +26.4 | <0.001 |
| −GPU health monitoring | 12.8 | +7.6 | <0.001 |
| −Multi-metric SLO | 9.1 | +3.9 | 0.003 |
| −Batching awareness | 14.3 | +9.1 | <0.001 |
| −Open-loop generation | 18.7 | +13.5 | <0.001 |
| Baseline B1 Naive linear scaling | 42.1 | +36.9 | <0.001 |
| Baseline B2 Offline benchmark | 28.5 | +23.3 | <0.001 |
| Baseline B3 Legacy tool | 18.1 | +12.9 | <0.001 |
关键结论:Warmup 处理与Recorded replay 是最高杠杆的两个特性;两者缺失即退化到通用工具水平。
RQ2 预测精度(Figure 3)
- 52 组 (估计, 实测) 对;bias = −2.1%(95% CI: [−3.8%, −0.4%])——轻微保守估计(更利于运维)。
- 95% 一致性上下限:[−14.8%, +10.6%]。
- ,Spearman 。
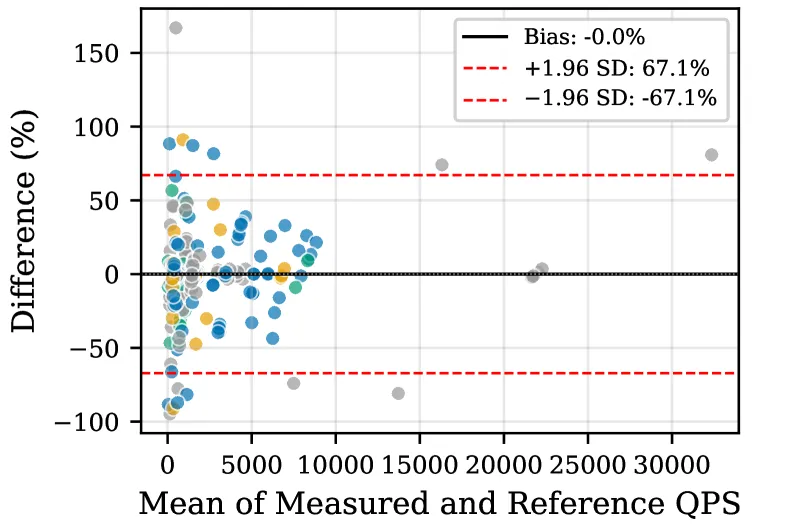
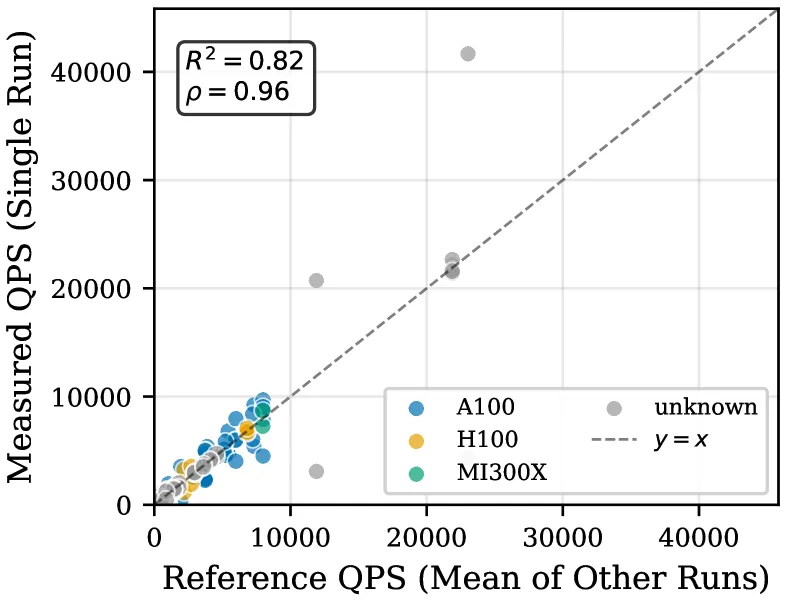
Table 5 的多元回归显示 co-location density 是第二大误差预测因子();GPU 内存争用/缓存干扰可导致 10–25% 吞吐下降。
工业影响(14 个 case studies)
- 单模型 GPU 减配 49–83%,同时降低 under-provisioning 事故率。
- 从 synthetic 换到 recorded replay 后误差从 30% 降到 2–6%。
- Compiler lowering 验证发现 69% 吞吐改进。
- UVM 参数系统化探索优化了 caching。
6 条经验(L1–L6)
- L1:workload representativeness > strategy sophistication。
- L2:warmup handling 是最高杠杆的 ML-specific 特性。
- L3:adaptive feedback 防止 nonlinear capacity boundary 超调。
- L4:co-location 效应显著且难复现。
- L5:持续测试可在数小时内捕获回归。
- L6:health assessment 需 hysteresis 而非单点阈值。
六、总结
核心贡献
- 提出 Vanguard——首个面向 ML 推理容量估计的工业级负载测试框架,覆盖 14 个真实模型(推荐/排序/视觉/NLP,80M–1.5B)。
- 设计 adaptive feedback-driven 搜索:dampening + spike tolerance + convergence detection,应对 dynamic batching 造成的非线性 capacity cliff。
- 提出多指标加权健康评估 + 五态状态机 + 非对称 hysteresis,flapping 减少 40%。
- 系统化消融量化:Warmup 与 Recorded replay 是最大杠杆(分别 +22.2%、+26.4% MAE)。
- 单模型减配 49–83% 的部署证据;bias 、 的容量预测精度。
技术影响
- 为 GPU 集群容量规划提供了可复现、可自动化的方法学基线。
- 5 种策略 + 可插拔 Strategy Engine,方便集成到已有生产运维流水线。
- 提出的 “warmup + replay + adaptive + health” 组合已经被 6 条 lessons 系统化,方便其他企业复用。
局限性
- 当前策略针对定输入/定输出模型,未覆盖生成式 LLM 的 token-level 吞吐、KV cache 压力、可变输出长度;论文明确 preliminary 实验中生成模型的复现性更差。
- 跨硬件仍需要 4.9% 修正因子;未来需要硬件特定的迁移模型。
- Co-location 干扰只能事后监控修正,测试环境难以模拟真实混部。
- 未提供公开基准;生态标准化仍是开放问题。
七、参考资源
- arXiv 摘要页:https://arxiv.org/abs/2606.22013
- HTML 全文:https://arxiv.org/html/2606.22013v1
- PDF:https://arxiv.org/pdf/2606.22013
- 图表索引:
figures/2606.22013-vanguard/README.md - 相关工作:Clipper (NSDI’17)、Orca (OSDI’22)、AlpaServe (OSDI’23)、Clockwork (OSDI’20)、InferLine (SoCC’20)、Sarathi-Serve (2024)、vLLM (SOSP’23)、Gil Tene 关于 coordinated omission 的观察