WiSP: A Working-Set View of Mixture-of-Experts Serving on Extremely Low-Resource Hardware
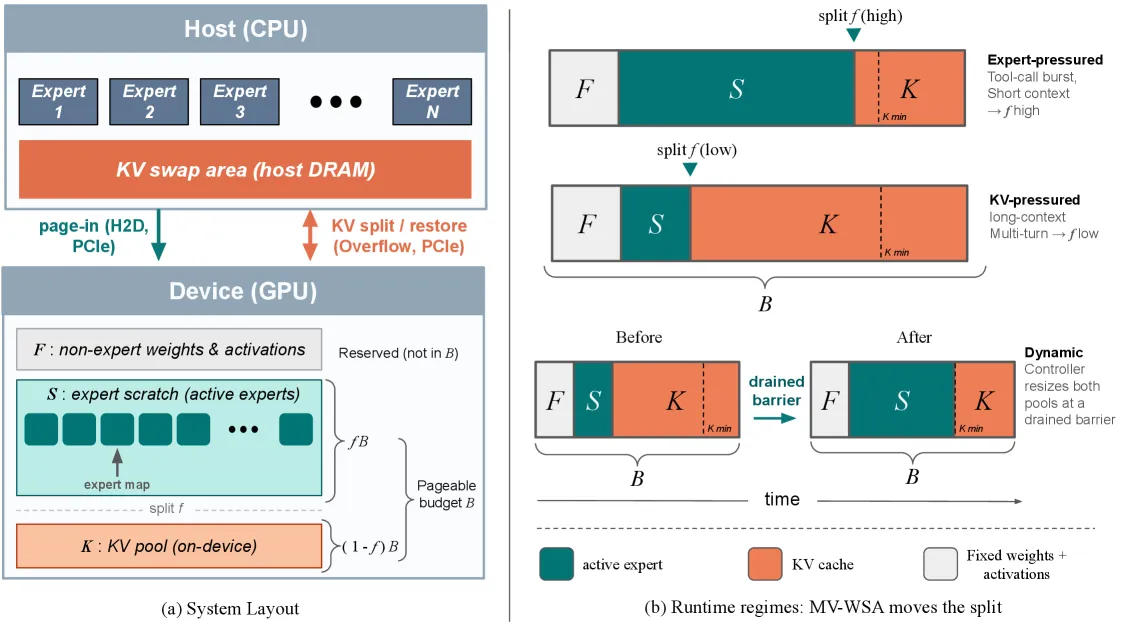
WiSP 将低资源 MoE serving 建模为专家权重与 KV 缓存两条 working-set 争夺同一 VRAM 的问题。核心是 routing-aware expert pager(基于 expert_map 的 LRU 分页,字节等价输出)加 MV-WSA 边际价值分配器,联合分配 expert scratch 与 KV pool。iso-VRAM 下相对 vLLM static offload 解码吞吐最高提升 1.95×,Jamba-52B/MiniMax-M2-229B 等 baseline 无法启动的模型上也能可服务,且揭示单流 decode 中 routing 预测只能省显存不能省延迟。
WiSP: A Working-Set View of Mixture-of-Experts Serving on Extremely Low-Resource Hardware
一、论文概述
| 字段 | 内容 |
|---|---|
| 标题 | WiSP: A Working-Set View of Mixture-of-Experts Serving on Extremely Low-Resource Hardware |
| 作者 | Jiamu Zhang, Liang Wu, Mayank Darbari, Liangjie Hong |
| 机构 | 论文未在正文披露单位;作者背景与工作方向常见于工业界 MoE 服务团队 |
| 论文链接 | https://arxiv.org/abs/2606.21868 |
| HTML | https://arxiv.org/html/2606.21868v1 |
| https://arxiv.org/pdf/2606.21868 | |
| 发布 | 2026-06-20 |
| 分类 | cs.LG |
| 系统别名 | WiSP(Working-Set Paging),核心分配器 MV-WSA |
二、核心思想
问题定义
现代 MoE 模型(Mixtral-8×7B、Qwen3-30B-A3B、DeepSeek-V3、MiniMax-M2 229B FP8 等)把大部分参数放在专家层,但每 token 只激活极少专家;然而所有专家权重仍必须驻留在 GPU 可访问的位置。低资源硬件上典型做法是 layer-level CPU offload(如 vLLM --cpu-offload-gb),它每步会把整层的所有专家从 host 通过 PCIe 拉一次,浪费了 MoE 的稀疏性。
作者观察到:在 低并发、小 batch、模型放不下 VRAM 的场景下,问题的本质是经典的 working-set 问题:
- GPU 内存 = 有限的快速存储,host 内存 = backing store。
- 专家权重 = 一条 routing 依赖的引用流;KV cache = 一条 token 依赖的引用流。
- 两条流共享同一 VRAM 预算,任何”给专家一字节”就等于”KV 少一字节”。
解决方案概述
WiSP 由两部分组成:
- Routing-aware Expert Pager:利用现代 fused-MoE kernel 已有的
expert_map间接层 ,把逻辑 expert id 映射到小尺寸 GPU scratch 中的物理 slot。宿主策略维护 LRU;kernel 完全不修改;输出与 unpaged 版本 byte-identical。 - MV-WSA(Marginal-Value Working-Set Allocation):把可分页预算 划为 (专家 scratch)与 (KV 池)。启动时作为 configurator、运行时作为 online controller,通过在线 reuse-distance histogram 估计两条流的边际价值,把字节挪向”当前更省时延”的一侧,配合 admission floor 保证调度器不 deadlock。
三、技术架构/方法
符号与预算
模型有 MoE 层、每层 专家、每 token 选 专家。单个专家占 字节,全层驻留成本 。扣除非专家权重、激活、CUDA context 后,可分页预算:
expert scratch 容量 ( 是所有层驻留一个专家的字节),KV 容量 ( 是一块 KV block 跨层字节)。 是核心控制变量。
Expert Pager 与 Algorithm 1
每层每步 WispLayer.Step(R):
- 计算 miss 集合 ;
- 按 LRU tick 选出 victim 集合 ;
copy_async从 CPU masterW^{cpu}拉入 GPU scratch ,同时更新 ;- 调用 unmodified
FusedMoE(hidden, W=S, expert_map=π_dev)。
两大不变量:
- P1 Bit-identical outputs:kernel 未改,权重字节相同。
- P2 Single-stream ordering:
copy_async与 kernel dispatch 用同一 CUDA stream,天然保证顺序,无需 barrier。
Pager 的目标是极小化 fault 字节数:
LRU 与精确 miss 曲线
对任意引用流,LRU 的 miss 数由 reuse distance (自上次引用以来见过的不同项数)决定。给定 cap :
对专家流与 KV 流各自成立,是 allocator 优化的对象。
Expert ↔ KV Split(Section 3.3)
在 split 下,,。两侧 miss cost 不同:
- Expert miss = PCIe roundtrip,。
- KV miss = prefill 重算,。
延迟:
内部最优点满足 equimarginal 条件:
Admission floor:连续批调度器必须能装下并发 batch 全部 KV,否则会 preempt/refuse start:
MV-WSA 强制此约束,KV-blind 的 expert-proportional baseline(Flux-prop)在真正装不下的模型上会直接失败。
MV-WSA 配置器与在线控制器(Algorithm 2)
- Startup Configurator:从 reuse-distance histogram 估 ,含 admission floor,落地为一次
vllm serve启动配置。 - Online Controller:drained barrier 处物理 resize 两个池,保持 byte-identical 输出(D2 属性);通过 decayed 直方图动态跟踪 workload 转移。
关键洞见:预测是”内存杠杆”而非”速度杠杆”(Section 4)
作者构造了一个 online co-activation predictor(无参数、无标注、逐用户学习),达到 ≈ 0.5 next-expert precision。但在单流 decode:
- 开启 speculative prefetch 反而使 decode 吞吐下降 46–55%,TTFT 大约翻倍。
- 主题一致的会话相对故意多样化的会话没有额外的吞吐收益。
原因:batch-1 decode 下 MoE GEMM 太小,无 compute 可与 PCIe 传输重叠;PCIe 就是瓶颈墙。Qwen3-30B-A3B 上相邻 decode 步的 top-8 专家仅 44–48% 重合,即使完美缓存也必须每步流 ≈ 1.8 GiB 权重,PCIe 4.0 下上限约 16 tok/s,PCIe 5.0 下 32 tok/s;WiSP 满 cap 已达 27 tok/s,接近 PCIe-5 天花板。
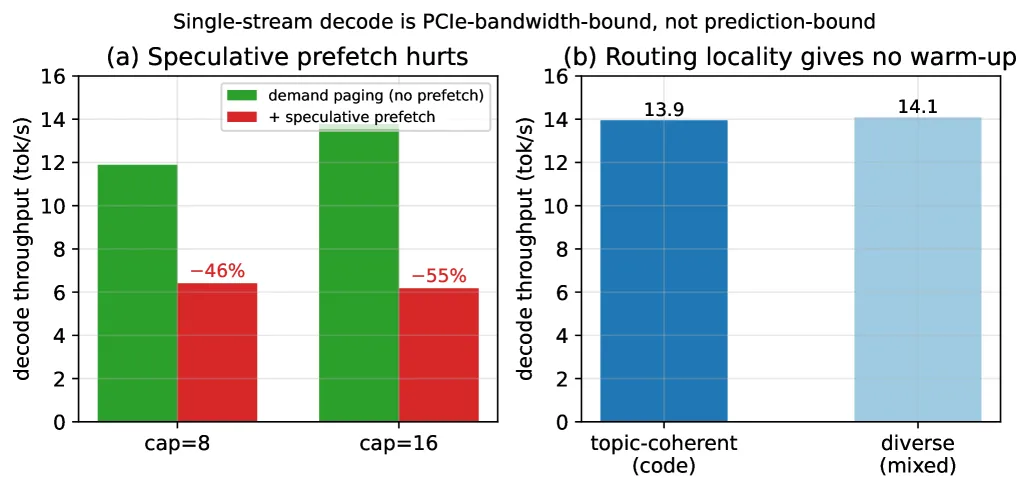
结论:routing signal 的用法应是估计工作集大小并按用户 right-size cap,从而把节省下来的 VRAM 交给 KV 池。
四、核心创新
| # | 创新点 | 说明 |
|---|---|---|
| 1 | Working-set 视角统一 expert / KV | 首次把 MoE offload 与 KV 管理放进同一 VRAM 分配问题 |
| 2 | Byte-identical Expert Pager | 复用 expert_map 间接层,无新 kernel、无精度改变,输出与 unpaged 逐字节相同 |
| 3 | MV-WSA 边际价值分配器 | 用精确 LRU miss 曲线 建模、equimarginal 分割 + admission floor |
| 4 | 揭示 prediction 是”内存杠杆” | 单流 decode 下 speculative prefetch 反而更慢;PCIe 是硬墙 |
| 5 | 跨架构通用性 | 同一 pager 覆盖 MoE LLM、MoE VLM、Hybrid SSM–MoE (Jamba)、MoE diffusion (DiT-MoE / LLaDA-MoE),包括 KV 缺席的模态 |
五、实验结果
环境与作者的诚实边界
- 硬件:单卡 NVIDIA H100 NVL 95,830 MiB (~94 GiB),vLLM 0.11.2,eager 模式,温度 0 贪心确定。
- “real”:MiniMax-M2 (229B FP8)、Jamba-v0.1 (52B) 在 94 GiB H100 上确实装不下。
- “sim / iso-VRAM”:Qwen3-30B-A3B、Kimi-VL 通过
gpu-memory-utilizationcap 模拟小卡。 - 论文明确声明大部分数字是”模拟受限”,物理小卡验证留作 follow-up。
5.1 正确性
温度 0 下 WiSP 输出与 unpaged engine 完全一致。DiT-MoE latent 与 unpaged 最大绝对差 = 0;LLaDA-MoE 生成 token 完全一致。
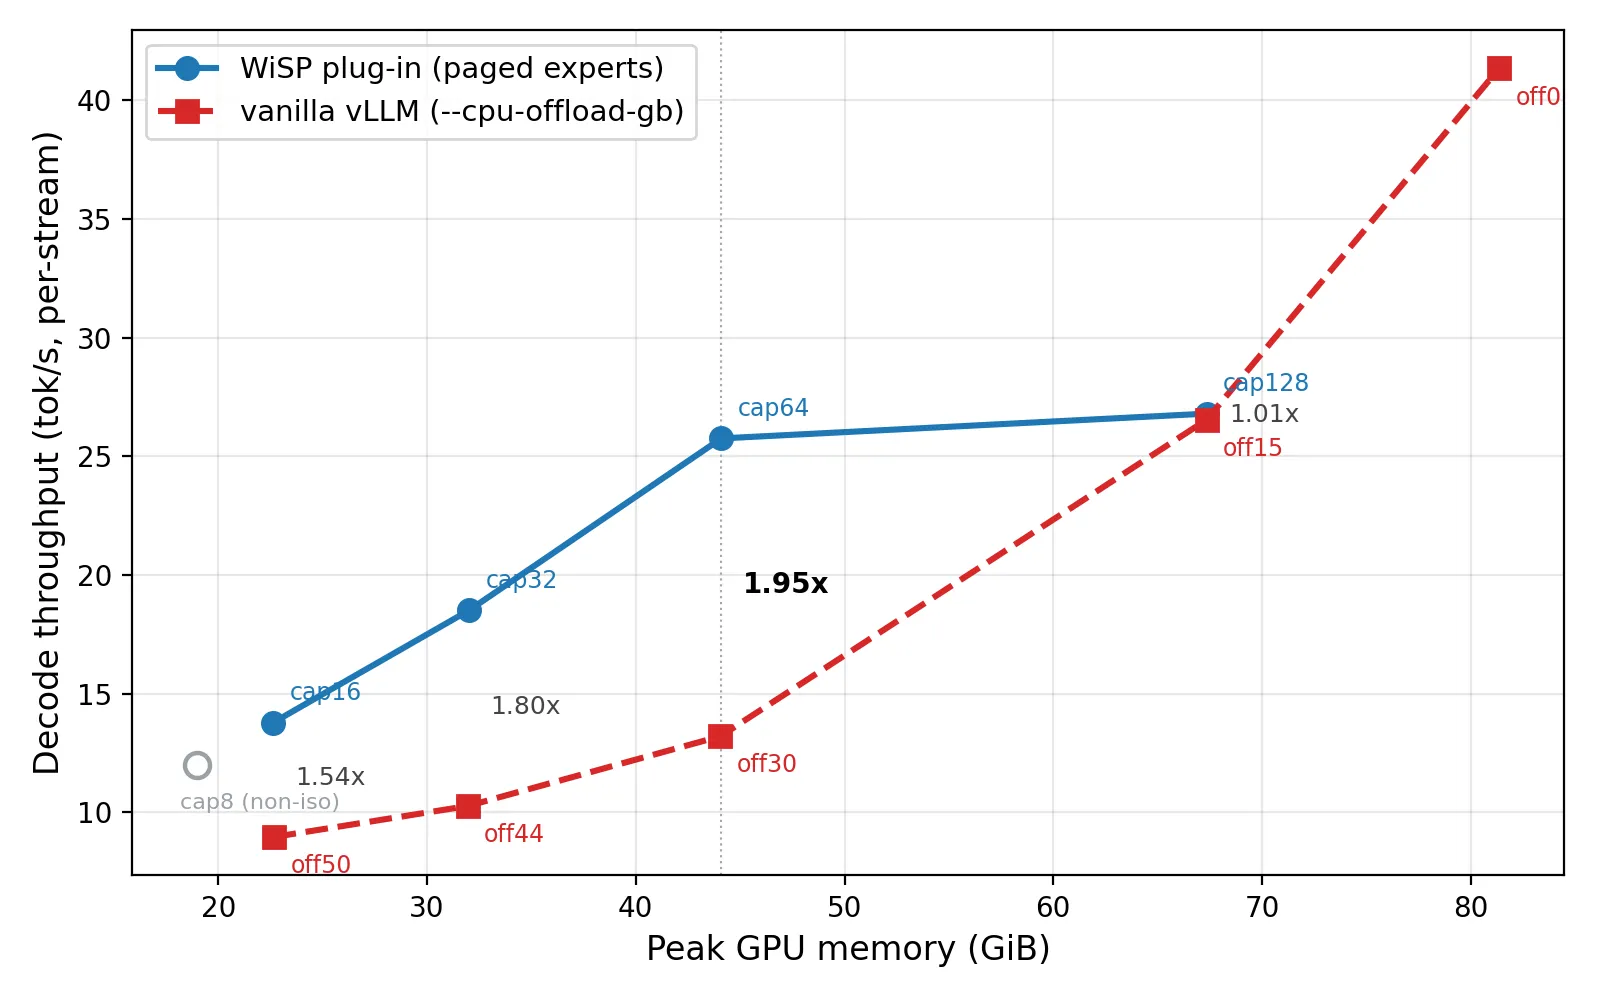
5.2 Iso-VRAM 解码吞吐(Table 2 / Figure 3)
Qwen3-30B-A3B(128 专家 top-8,BF16):
| GPU 预算 | Naive offload | WiSP | 加速 |
|---|---|---|---|
| ~23 GiB | 8.96 tok/s | 13.79 tok/s (cap 16) | 1.54× |
| ~32 GiB | 10.27 | 18.51 (cap 32) | 1.80× |
| ~44 GiB | 13.21 | 25.75 (cap 64) | 1.95× |
| ~67 GiB | 26.53 | 26.79 (cap 128) | 1.01× (交叉点) |
- Kimi-VL-A3B(MoE VLM)在 16.7 GiB / 10.7 GiB 预算下分别 1.18× / 1.21×。
- Jamba-v0.1 (52B) 一张 94 GiB 卡:naive 全驻留 OOM,vLLM 静态 offload 因 recurrent state 不支持而直接 assertion;WiSP 分别在 cap 4/8 下达 5.73 / 9.80 tok/s,属capability claim(能不能服务)。
- MiniMax-M2 (229B FP8):WiSP 在 32 cap 下 3.70 tok/s(14 GiB 专家);naive offload 需 ≥ 180 GiB pin 到 256 GiB host cgroup 触发 host OOM。
Expert ↔ KV Trade (Table 3)
Qwen3-30B-A3B,固定 48.7 GiB VRAM,128 专家:
| expert cap | GPU KV (tok) | max conc @4096 | serves? |
|---|---|---|---|
| 8 | 375,792 | 91.75 | ✓ |
| 16 | 338,928 | 82.75 | ✓ |
| 32 | 265,200 | 64.75 | ✓ |
| 64 | — | — | × (no KV room) |
expert cap 从 32 降到 8 换来 KV tokens +41.7%、并发 +41.7%;cap=64 直接越过联合可行边界。
5.3 MV-WSA 分配器
Static Configurator(Table 4) OLMoE-1B-7B,8 GiB 预算,AgentInstruct_os,concurrency 4:
| Arm | cap | KV (GiB) | TTFT (s) | decode (tok/s) | turn wall (s) |
|---|---|---|---|---|---|
| MV-WSA | 21 | 2.6 | 2.9 | 40.6 | 6.3 |
| 50-50 | 18 | 3.2 | 2.9 | 29.2 | 7.0 |
| Flux-prop | 35 | 0.5 | 19.8 | 56.2 | 22.0 |
| Naive offload | — | — | 21.3 | 30.7 | 25.5 |
MV-WSA 是唯一 TTFT 与 decode 都接近最佳的方案。Flux-prop KV-blind 导致 TTFT 崩溃;50-50 KV-heavy decode 慢;naive offload 两轴皆输。
Online 仿真(Table 5):AgentInstruct 中 per-workflow oracle split 分布在 0.22–0.99;MV-WSA 收敛到 oracle 内 +3.9%,而 50-50 差 +19.7%、Flux-prop +21.3%;workflow 在会话内漂移(os → db → webshop)时,MV-WSA 比最优单一 static 还好 -4.7% 到 -16.3%。
Live Dual-resize(Table 6):Qwen3-30B-A3B 24 GiB,36 turns。dynamic 相较 best offline:
- TTFT 40.35s → 31.51s(1.28×)
- decode 13.37 → 14.35 tok/s(1.07×)
- e2e 448.1s → 371.8s(1.20×)
同一模型对 resize cycle 后输出仍 byte-identical(D2 属性)。
5.4 Routing 信号 = 内存杠杆
- 单个 decode burst 的专家 union:Qwen3-30B-A3B 上 0.53、OLMoE 0.78。
- 相邻 burst 重叠 0.80–0.90,会话累计 footprint 0.77(稳定子集)。
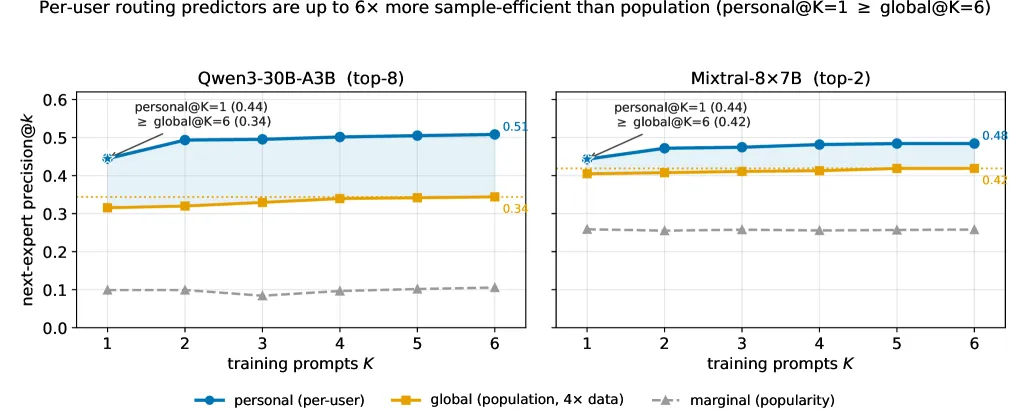
- per-user co-activation predictor 用单会话训练即匹配/超过 4× 数据的 population predictor,两会话内饱和。
5.5 跨架构
- Kimi-VL-A3B(MoE VLM):byte-identical text,1.18–1.21× 加速。
- Jamba-v0.1(52B Hybrid Mamba+Attention+MoE):baseline 完全无法服务;WiSP 可服务且正确。
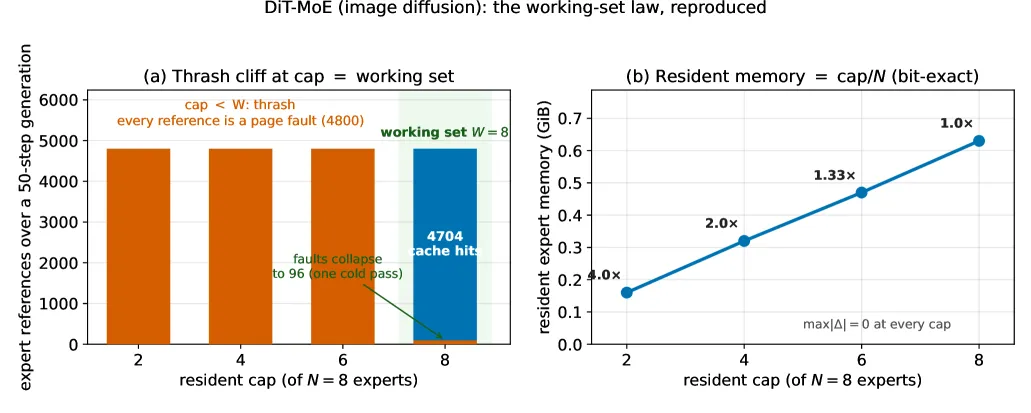
- DiT-MoE:无 KV,前向激活全体专家;仍能靠 paging 把 resident 专家显存降 4×,生成 latent 与 full-residency 完全一致。
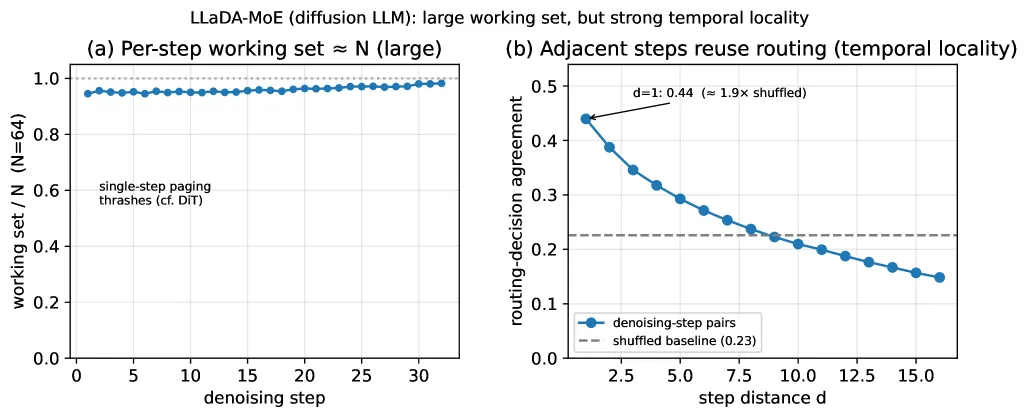
- LLaDA-MoE-7B:diffusion LLM,denoising step 间存在时间局部性;paging 令生成 token 一致。
六、总结
核心贡献
- 首次把 MoE serving 的专家 offload 与 KV cache 管理统一为一个 working-set 分配问题,并给出精确的 LRU miss 曲线建模 。
- 提出 byte-identical 的 Expert Pager:复用
expert_map,drop-in 到 vLLM,无新 kernel、无精度损失、无模型改动。 - 提出 MV-WSA:equimarginal 边际价值分配 + admission floor,含离线 configurator 与 online resize controller,理论与实现完整。
- 首次量化证明:低并发单流 decode 下 routing prediction 不买速度(-46 到 -55% throughput),只能买内存;PCIe 是硬墙。
- 跨架构大规模验证:MoE LLM / VLM / Hybrid SSM–MoE / MoE diffusion 全部通吃,包含 Jamba/MiniMax-M2 等 baseline 无法启动的情形。
技术影响
- 为边缘/桌面 GPU 上运行现代 MoE 模型提供了一条不改精度的实用路径;直接以 plug-in 形式落地 vLLM。
- 让 KV cache 管理与专家管理进入同一账本,为后续任何 sparsity + attention memory 联合调度问题提供了框架。
- 对 diffusion MoE、Hybrid SSM–MoE 等新兴模态给出可复用的 pager 参考。
局限性
- 大量 iso-VRAM 结果通过 H100 上
gpu-memory-utilizationcap 模拟小卡,未在物理小卡(RTX 4060/MIG slice)上验证。 - 单流 decode 场景下 prediction 无速度收益;在多并发/多轮 agent 场景下 controller 与 predictor 组合的收益尚未完全实测。
- 目前只保证 byte-identical 输出,未探索允许精度轻微退化的量化路径。
- 需要 engine 暴露
expert_map类间接层;对不支持该 API 的服务栈需额外适配。
七、参考资源
- arXiv 摘要页:https://arxiv.org/abs/2606.21868
- HTML 全文:https://arxiv.org/html/2606.21868v1
- PDF:https://arxiv.org/pdf/2606.21868
- 图表索引:
figures/2606.21868-wisp-moe/README.md - 相关工作:Denning working-set (1968/1970)、PagedAttention (Kwon et al., SOSP’23)、MoE-Lightning (ASPLOS’25)、Pre-gated MoE (ISCA’24)、SiDA (MLSys’24)、ktransformers、llama.cpp