Does Mixture-of-Experts Actually Help Inference on Consumer and Edge Hardware? An Empirical Study
边缘/MoE 推理实证:OLMoE-1B-7B 在 Jetson Orin Nano 上比同 active 参数量 Dense 模型慢 31%,能耗高 2.1 倍;边缘带宽受限硬件上推理成本跟随总参数而非激活参数
边缘硬件上的 MoE 推理:是福音还是陷阱?—— OLMoE-1B-7B 实证研究
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Does Mixture-of-Experts Actually Help Inference on Consumer and Edge Hardware? An Empirical Study |
| 作者 | Alfarizy Alfarizy, Hung Truong Thanh Nguyen, René Richard, Roozbeh Razavi-Far, Hung Cao |
| 机构 | Analytics Everywhere Lab |
| 论文 | arXiv:2606.21428 |
| 代码 | https://github.com/Analytics-Everywhere-Lab/edge-moe |
| 发布 | 2026-07-09 (v3) |
| 页数 | 18 pages, 7 tables, 4 figures |
二、核心思想
Mixture-of-Experts (MoE) 语言模型常被宣传为资源受限设备的理想选择:每个 token 只激活少量专家,理论 FLOP 与更小的稠密模型相当。然而,这种 FLOP 优势在实践中是否成立?
核心研究问题(4 个):
- RQ1:MoE 在消费级和边缘硬件上的吞吐量(tokens/s)是否优于同 active 参数量的稠密模型?
- RQ2:MoE 的峰值内存占用是否如预期远低于稠密基线?
- RQ3:MoE 的路由开销是否使其对 prompt 长度更敏感?
- RQ4:在边缘设备上,MoE 每生成 token 的能耗是多少?
核心结论:取决于设备。在 Apple M2 Pro 上部分实现(仅落后 ~10%),但在边缘设备 NVIDIA Jetson Orin Nano 上完全消失(落后 ~31%,能耗为 2.1×),因为带宽受限边缘硬件上推理成本跟踪的是总参数而非激活参数。
三、技术架构
实验设置
硬件平台:
| 角色 | 设备 | 内存 | 用途 |
|---|---|---|---|
| 消费级目标 | Apple MacBook Pro M2 Pro | 16 GB unified | 全部 M2 测量 |
| 边缘目标 | NVIDIA Jetson Orin Nano 8 GB | 8 GB unified | 全部 Jetson 测量 |
| 开发机 | NVIDIA DGX Spark | 128 GB unified | 仅构建环境 |
后端:统一使用单个 llama.cpp tag,M2 启用 -DGGML_METAL=ON,Jetson 启用 -DGGML_CUDA=ON -DCMAKE_CUDA_ARCHITECTURES=87,所有 transformer 层卸载到设备加速。
模型(Q4_K_M 量化):
| 角色 | 模型 | Active (B) | Total (B) | 文件大小 (GB) |
|---|---|---|---|---|
| MoE | OLMoE-1B-7B-0924-Instruct | 1.3 | 6.9 | 4.21 |
| Dense (active-match) | Llama-3.2-1B-Instruct | 1.0 | 1.0 | 0.81 |
| Dense (active-match) | Qwen2.5-1.5B-Instruct | 1.5 | 1.5 | 0.99 |
| Dense (memory-anchor) | Gemma-2-2B-Instruct | 2.0 | 2.0 | 1.71 |
评估协议:12 个 prompt(QA、推理、编码、摘要等)× 3 次重复 = 45 runs/cell。温度=0.0,top_p=1.0,max_new_tokens=256。Jetson 启用 15W 模式 + jetson_clocks,每次重复间冷却 30 秒。
核心发现一:吞吐量(RQ1)
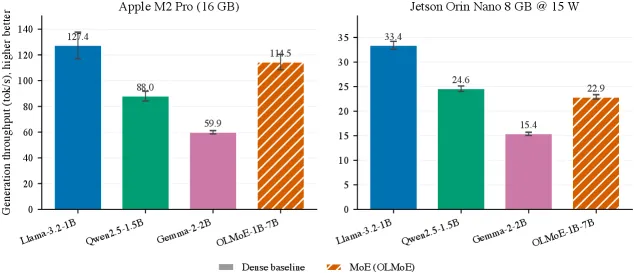
图 1. 各模型在 M2 Pro 与 Jetson Orin Nano 上的生成吞吐量(每 cell 45 次运行,误差棒为 ±1 标准差)。OLMoE(斜纹填充)落在两个同 active dense 基线之间,且相对最快 dense 模型的差距从 M2 到 Jetson 扩大。
数据(Table 3):
| 设备 | 模型 | Active | Total | 均值 (tok/s) | 中位数 (tok/s) |
|---|---|---|---|---|---|
| M2 | Llama-3.2-1B | 1.0 | 1.0 | 127.4 | 130.7 |
| M2 | OLMoE-1B-7B | 1.3 | 6.9 | 114.5 | 116.2 |
| M2 | Qwen2.5-1.5B | 1.5 | 1.5 | 88.0 | 89.5 |
| M2 | Gemma-2-2B | 2.0 | 2.0 | 59.9 | 60.4 |
| Jetson | Llama-3.2-1B | 1.0 | 1.0 | 33.4 | 33.0 |
| Jetson | Qwen2.5-1.5B | 1.5 | 1.5 | 24.6 | 24.5 |
| Jetson | OLMoE-1B-7B | 1.3 | 6.9 | 22.9 | 23.0 |
| Jetson | Gemma-2-2B | 2.0 | 2.0 | 15.4 | 15.4 |
- M2 上 OLMoE 比同 active Llama-3.2-1B 慢 ~10%
- Jetson 上差距扩大到 ~31%
- 跨设备定性顺序一致,但 gap 向边缘设备恶化
核心发现二:峰值内存(RQ2)
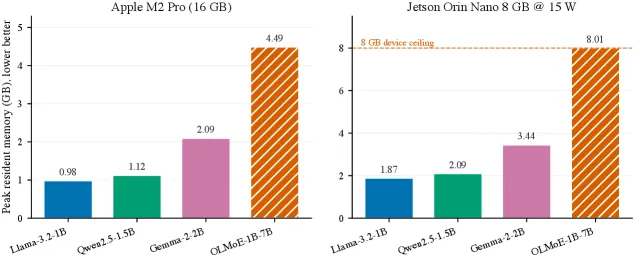
图 2. 各模型在两设备上的峰值常驻内存。OLMoE(斜纹填充)恰好顶在 Jetson 的 8 GB 物理天花板,是测试集中唯一触及上限的模型。
数据(Table 4):
| 设备 | 模型 | Total (B) | 文件大小 (GB) | 峰值 RSS (GiB) | 峰值/文件比 |
|---|---|---|---|---|---|
| M2 | Llama-3.2-1B | 1.0 | 0.81 | 0.98 | 1.21 |
| M2 | OLMoE-1B-7B | 6.9 | 4.21 | 4.49 | 1.07 |
| Jetson | Llama-3.2-1B | 1.0 | 0.81 | 1.87 | 2.31 |
| Jetson | OLMoE-1B-7B | 6.9 | 4.21 | 8.01 | 1.90 |
- OLMoE 在 M2 上消耗 4.5 GB,在 Jetson 上达到 8.0 GiB 物理天花板(仅靠 zram swap 勉强运行)
- 同 active 参数的稠密模型仅需 0.8–1.0 GB,OLMoE 的内存占用是它的 5–10 倍
- Jetson 峰值/文件比(~2.0×)高于 M2(~1.1–1.2×),因为 CUDA 路径需要额外的 device-side 分配
核心发现三:提示长度敏感性(RQ3)
| 设备 | 模型 | Short | Medium | Long | Δ(long−short)/short |
|---|---|---|---|---|---|
| M2 | Llama-3.2-1B | 134.4 | 130.2 | 107.8 | −19.7% |
| M2 | OLMoE-1B-7B | 119.2 | 115.0 | 103.8 | −12.9% |
| M2 | Qwen2.5-1.5B | 90.6 | 89.2 | 80.7 | −10.9% |
| M2 | Gemma-2-2B | 60.7 | 60.3 | 57.4 | −5.4% |
| Jetson | Llama-3.2-1B | 34.3 | 32.8 | 32.8 | −4.4% |
| Jetson | OLMoE-1B-7B | 23.3 | 22.9 | 22.2 | −4.7% |
| Jetson | Gemma-2-2B | 15.7 | 15.4 | 14.8 | −5.4% |
关键发现:OLMoE 的吞吐量随提示长度增长的退化幅度并不比稠密基线更大——理论预期的 MoE 对 prompt 长度更敏感的假设在该参数规模下不成立。
核心发现四:每 token 能耗(RQ4,仅 Jetson)
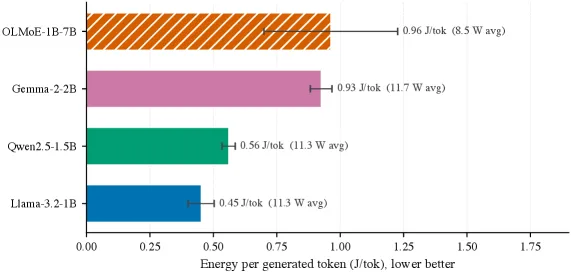
图 3. Jetson 15W 功耗档下每生成 token 的能耗(升序排列)。标注显示每 token 平均焦耳数与生成期间平均墙上功率。OLMoE 的每 token 能耗约为同 active count 的 Llama-3.2-1B 的 2.1 倍。
数据(Table 6):
| 模型 | 均值 J/tok | 中位数 J/tok | 平均功耗 (W) | 峰值功耗 (W) | 峰值 SoC °C |
|---|---|---|---|---|---|
| Llama-3.2-1B | 0.45 | 0.44 | 11.31 | 12.89 | 53.2 |
| Qwen2.5-1.5B | 0.56 | 0.56 | 11.32 | 12.30 | 53.3 |
| Gemma-2-2B | 0.93 | 0.91 | 11.67 | 12.74 | 55.5 |
| OLMoE-1B-7B | 0.96 | 0.86 | 8.49 | 10.97 | 55.1 |
- OLMoE 每 token 能耗是同 active dense 基线的 2.1 倍
- 尽管 OLMoE 的平均功耗更低(8.5W vs 11.3–11.7W),但其更长的推理时间导致每 token 能耗更高
- 峰值 SoC 温度 53–56°C,远低于热节流阈值
核心发现五:路由开销分解(Section 4.6)
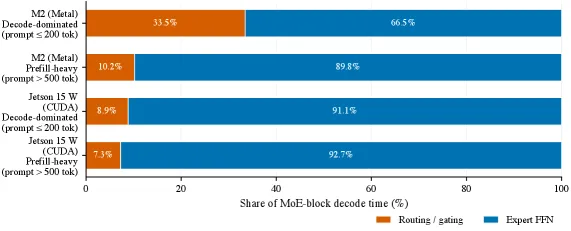
图 4. MoE 内部路由 vs expert FFN 时间占比,按后端与 prompt 分层拆解。Expert FFN 在所有场景占主导。M2 decode-dominated 的 33.5% 路由占比被 Metal 更重的 per-node cb_eval 同步开销放大;Jetson 的 8.9% 是更干净的估计。
数据(Table 7):
| 后端 | 场景 | 路由占比 (within-MoE-block) |
|---|---|---|
| Jetson (CUDA, 15W) | Decode-dominated | ~8.9% |
| Jetson (CUDA, 15W) | Prefill-heavy | ~7.3% |
| M2 (Metal) | Decode-dominated | ~33.5%(含严重同步膨胀) |
| M2 (Metal) | Prefill-heavy | ~10.2% |
- 路由算术本身不是瓶颈:在更可信的 Jetson 测量中,路由仅占 MoE block 计算的 ~8–9%
- 真正的瓶颈是:(1) 总参数内存带宽,(2) 每 token expert dispatch 结构开销,(3) KV-cache 在内存受限设备上的压力
四、核心创新
| 创新点 | 说明 |
|---|---|
| 首次 MoE 边缘推理实证基准 | 系统性测量 OLMoE vs 稠密模型在 M2 Pro 和 Jetson Orin Nano 上的吞吐量、内存、能耗 |
| 设备-依赖发现 | 证明”MoE 更适合边缘”的直觉在带宽受限边缘硬件上不成立:推理成本跟踪总参数而非激活参数 |
| 路由开销量化 | 通过 patched llama.cpp 逐节点计时,证明路由算术仅占 ~9% MoE 计算,打破”路由慢”的朴素假设 |
| 全开源可复现 | 发布完整测量 harness 和逐次运行数据,45 runs/cell,支持后续研究 |
五、代码实现分析
- 代码库:https://github.com/Analytics-Everywhere-Lab/edge-moe
- 使用 llama.cpp 统一推理后端,GGUF Q4_K_M 量化格式
- 发布包含:每个 JSONL 行记录 git rev、GGUF SHA-256、llama-cli 命令字符串
- 发布 router-overhead 分析 patch:
scripts/patches/router_overhead_b4404.patch - 性能数据:
model_overall_summary.csv、jetson_energy_summary.csv、sequence_length_summary.csv等
六、实验结果
吞吐量(Table 3)
| 设备 | 模型 | Mean (tok/s) | 相对 Llama-3.2-1B |
|---|---|---|---|
| M2 | Llama-3.2-1B | 127.4 | 1.00× |
| M2 | OLMoE-1B-7B | 114.5 | 0.90× |
| M2 | Qwen2.5-1.5B | 88.0 | 0.69× |
| M2 | Gemma-2-2B | 59.9 | 0.47× |
| Jetson | Llama-3.2-1B | 33.4 | 1.00× |
| Jetson | OLMoE-1B-7B | 22.9 | 0.69× |
| Jetson | Qwen2.5-1.5B | 24.6 | 0.74× |
| Jetson | Gemma-2-2B | 15.4 | 0.46× |
稳定性(Section 4.4)
- 45 runs/cell 的变异系数:Jetson 2.0–2.4%,M2 三模型 ≤ 5.2%
- Llama-3.2-1B 在 M2 上 CV=8.1%(异常值),归因于超短运行(~2s)易受调度抖动影响
路由开销绝对时间(Section 4.6)
| 后端 | Prompt stratum | 路由时间 (s) | Expert FFN 时间 (s) |
|---|---|---|---|
| M2 | Decode-dominated | ~3.0 | ~5.6 |
| M2 | Prefill-heavy | ~3.0 | ~27.8 |
| Jetson | Decode-dominated | ~0.7 | ~6.5 |
| Jetson | Prefill-heavy | ~0.7 | ~8.7 |
路由时间在两个后端内相对稳定,而 expert FFN 时间随 prompt 长度线性缩放,符合 O(top_k · N_tokens · d²) 预期。
七、相关工作
| 工作 | 方向 | 与本文关系 |
|---|---|---|
| MoE-CAP [13] | 数据中心 S-MBU/S-MFU 指标 | 本文可视为其边缘投影,用 S-MBU 视角解释实测结果 |
| MELT [16] | 移动端 LLM 测量框架 | 本文沿用其方法论至 Jetson 边缘设备 |
| PowerInfer-2 [27] | 移动端 MoE 部署 | 未来工作方向之一 |
| PagedAttention [15] | 数据中心 KV-cache 管理 | 边缘设备因无独立 host memory,问题更严峻 |
| MobileLLM [18] | 移动端优化稠密模型 | 对比基线选择需扩展 |
八、总结
核心贡献
- 实证证明边缘 MoE 的局限性:OLMoE-1B-7B 在 Jetson Orin Nano 上比同 active Llama-3.2-1B 慢 31%,能耗高 2.1 倍,峰值内存触及 8GB 物理天花板
- 打破”MoE 因低 FLOP 适合边缘”的朴素直觉:带宽受限边缘硬件上推理成本跟踪总参数,稀疏激活无法弥补
- 精确量化路由开销:路由算术仅占 MoE block 计算的 ~9%(Jetson),非瓶颈
- 完整可复现基准:45 runs/cell,开源所有数据、代码和 measurement harness
局限性与未来方向
- 局限:仅测试单一 MoE 模型(OLMoE-1B-7B)和两款设备,推广性受限
- 未来方向 1:扩展到手机级硬件(Snapdragon/A-series),使用 PowerInfer-2 部署
- 未来方向 2:扩大 MoE 覆盖面(Qwen3-MoE, DeepSeek-V2-Lite-MoE, Mixtral-class)
- 未来方向 3:开发 cache-aware routing,考虑哪些 expert 驻留内存 vs 磁盘