HumanScale: Egocentric Human Video Can Outperform Real-Robot Data for Embodied Pretraining
系统研究表明,经过精心筛选和标注的拟人视角(egocentric)人类视频作为具身基础模型预训练数据源,可显著超越遥操作真实机器人数据
HumanScale: Egocentric Human Video Can Outperform Real-Robot Data for Embodied Pretraining
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | HumanScale: Egocentric Human Video Can Outperform Real-Robot Data for Embodied Pretraining |
| 作者 | Juncheng Ma*, Jianxin Bi*, Yufan Deng, Xuanran Zhai, Kewei Zhang, Ye Huang, Bo Liang, Shukai Gong, Jiankai Tu, Xiaotian Tang, Jiaxin Li, Kaiqi Chen, Duomin Wang, Yuqi Wang, Bingyi Kang, Eric Huang, Zhiyang Dou, Zhen Dong, Enze Xie, Wojciech Matusik, Tat-Seng Chua, Daquan Zhou† |
| 机构 | PKU (北大), NUS (新国大), MIT, UCSB, NVIDIA |
| 论文 | arXiv:2606.20521 |
| 代码 | https://github.com/DAGroup-PKU/HumanNet/ |
| 发布 | 2026-06-18 |
| 许可 | arXiv 非独占分发许可 |
二、核心思想
问题定义
具身基础模型(Embodied Foundation Models)如视觉-语言-动作模型(VLA)和世界-动作模型(WAM)期望像大语言模型一样从数据扩展中获益,但其数据瓶颈远为严峻。当前遥操作真实机器人轨迹(teleoperated real-robot trajectories)是主导的预训练数据源,因其提供精确的动作监督和具身对齐,但可扩展性受限于高昂的采集成本、获取难度和低行为多样性。
拟人视角(egocentric)人类视频作为一种可扩展、低成本、高多样性的替代方案受到关注,但其相对于遥操作真实机器人数据的有效性尚未得到系统研究。
解决方案概述
HumanScale 提出了一种分工协作的具身训练范式:
- 预训练阶段:使用拟人视角人类视频进行大规模预训练,学习通用的世界表示
- 后训练阶段:使用少量标注的真实机器人数据进行动作空间对齐
核心发现:在相同预训练数据量下,基于拟人数据的预训练模型在真实机器人任务上的表现显著优于基于真实机器人数据的预训练模型。
动机与洞察
有效的预训练需要覆盖度(Coverage)——对场景、物体、交互和行为的广泛暴露;而后训练需要对齐度(Alignment)——与目标具身系统的运动学匹配。拟人视频在覆盖度上占优,而遥操作机器人在对齐度上占优。问题的关键是:在受控比较下,预训练阶段的覆盖度优势能否战胜对齐度劣势?
三、技术架构
整体框架图
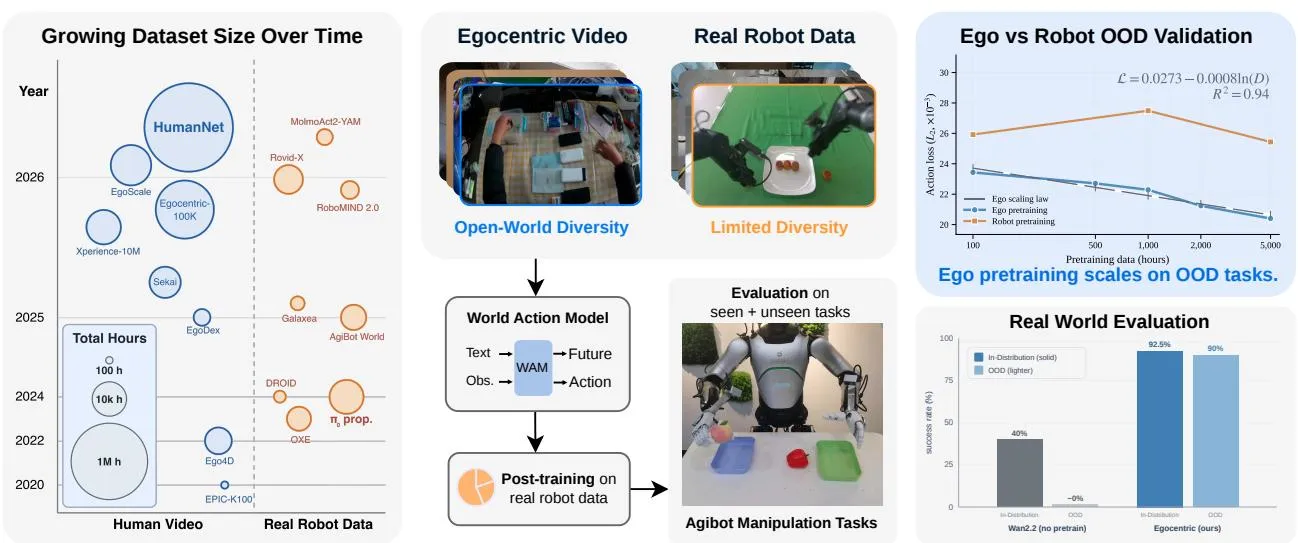
核心公式
Scaling Law — 对数线性缩放规律:
其中 为后训练动作损失(L2), 为预训练数据量(小时数)。
- Seen tasks: ,
- Unseen tasks: ,
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| Video Expert | 视频预测专家,初始化自 Wan 2.2 | 开源视频生成模型 |
| Action Expert | 动作预测专家,通过插值初始化 | — |
| Mix-of-Transformers (MoT) | 统一的视频动力学预测和动作推理架构 | 自回归世界-动作模型 |
| Pseudo-Action Labels | 从人体手部姿态重映射估计的每 clip 末端执行器位姿和夹爪状态 | 将拟人视频放入与机器人数据相同的动作空间 |
训练流程
Stage 1 — 预训练数据:
两个预训练集在 5,000 小时尺度上匹配,但来源不同:
- 拟人视角(Egocentric):从 HumanNet [9] 的拟人部分筛选,按物体、技能和环境多样性选择。每个 clip 的末端执行器位姿和夹爪状态通过重映射的手部姿态信号估计为伪动作标签。
- 真实机器人(Real-Robot):多具身轨迹,具有精确的末端执行器位姿和夹爪状态,从各种真实机器人数据集聚合。
Stage 2 — 后训练数据:
从 AgiBot World [2] 中选择 15 个操控任务,每个任务 100 条专家演示,共 1,500 条轨迹。
Stage 3 — 评估:
- Seen Tasks(分布内):来自后训练任务的保留轨迹,衡量分布内鲁棒性
- Unseen Tasks(分布外):25 个未在后训练中出现的任务,衡量分布外泛化能力
数据多样性对比
| 维度 | 拟人视频 | 真实机器人 |
|---|---|---|
| 归一化抖动 (Normalized Jerk) | 更低(更平滑) | 较高 |
| 空闲时间比例 | ~10% | ~30% |
| 工作空间覆盖 (XZ) | 更广 | 受限 |
| 会话间方差 | 更大 | 更小 |
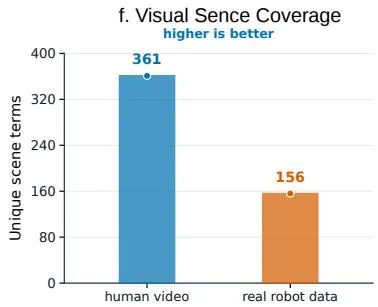
| 独特动宾对数量 | 2,744 | 107 |
| 独特场景术语数量 | 361 | 156 |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 首次受控对比 | 在固定架构、数据规模、后训练数据和评估协议下,直接比较拟人视频和真实机器人数据作为预训练源 | 方法学创新 |
| 分工协作范式 | 预训练用拟人视频获取覆盖度,后训练用真实机器人数据实现对齐度 | 理论分析 + 实验验证 |
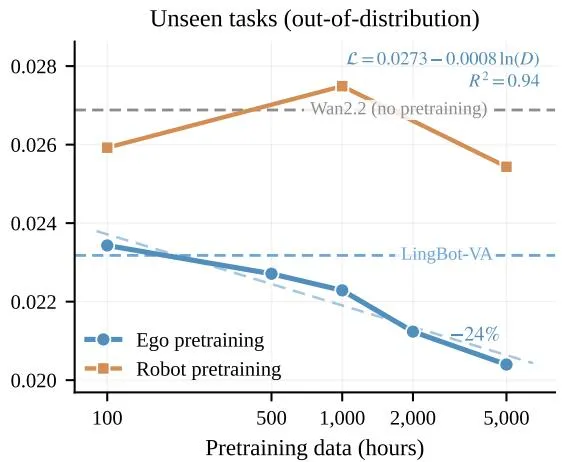
| 对数线性缩放律 | 拟人预训练在 seen/unseen 任务上均遵循 ,且在 5,000 小时仍未饱和 | |
| OOD 泛化优势 | 在未见任务上,拟人预训练的缩放持续改善,而机器人预训练几乎停滞 | 20% 更低损失 |
| 信息密度优势 | 1 小时拟人视频包含约 45,000 条轨迹,而同等时长真实机器人仅约 8,000 条 | 信息密度 5.6× |
五、实验结果
Scaling Behavior(缩放行为)
| 预训练数据量 | Seen 损失 | Unseen 损失 |
|---|---|---|
| 100h | 0.0080 | 0.0234 |
| 500h | — | — |
| 1,000h | — | — |
| 2,000h | — | — |
| 5,000h | 0.0067 | 0.0204 |
- 从 100h 到 5,000h,seen 任务损失下降 16.3%(0.0080 → 0.0067)
- unseen 任务损失下降 12.8%(0.0234 → 0.0204)
- 相比无预训练的 Wan2.2 基线,分别降低 35% 和 24%
Ego vs Robot Pretraining(拟人 vs 机器人预训练)
| 预训练方式 | 5,000h Seen 损失 | 5,000h Unseen 损失 |
|---|---|---|
| 拟人预训练 | 0.0067 | 0.0204 |
| 真实机器人预训练 | 0.0071 | 0.0254 |
| Wan2.2 (无预训练) | — | — |
| LingBot-VA (20k h 机器人) | — | — |
- 在 seen 任务上两者接近(0.0067 vs 0.0071)
- 在 unseen 任务上,拟人预训练显著优于机器人预训练(0.0204 vs 0.0254,约 20% 降低)
- 机器人预训练在 unseen 任务上损失随数据量增长几乎不变(~0.025)
后训练损失曲线
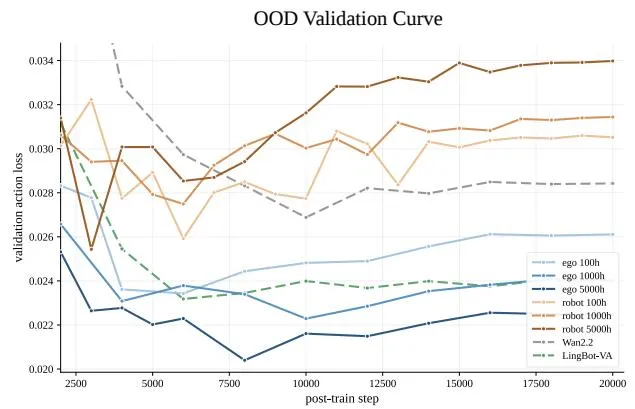
完整的后训练验证动作损失曲线显示,拟人预训练在所有数据规模(100h, 1000h, 5000h)下均优于真实机器人预训练,尤其在 unseen 任务上差距最为显著。
真实机器人实验
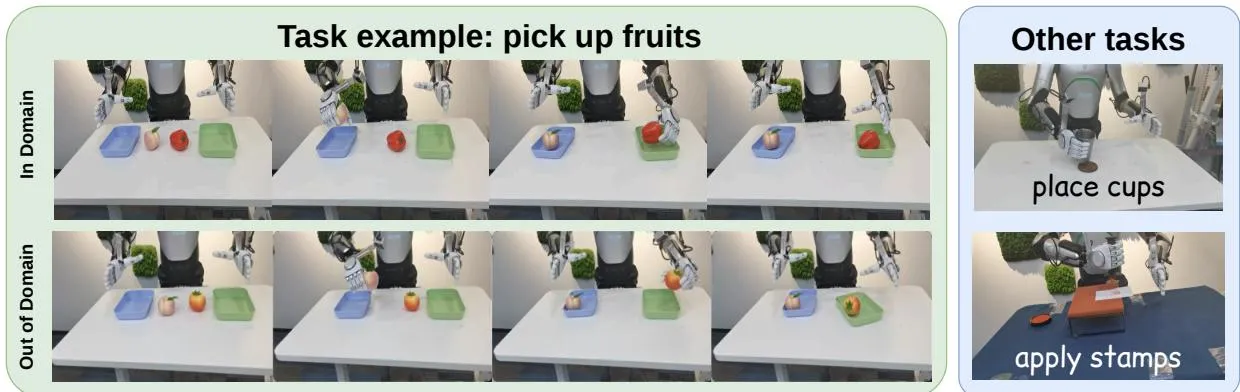
| 预训练 | 分布内成功率 | 分布外成功率 |
|---|---|---|
| Wan2.2 (基线) | 40.0% | 0.0% |
| 拟人预训练 (Ours) | 92.5% | 90.0% |
- 拟人预训练在分布外设置下仅下降 2.5 个百分点
- 基线模型在分布外设置下完全崩溃(40% → 0%)
- 在三个真实任务(放置杯子、果蔬分类、盖章)上进行了验证
后训练收敛曲线
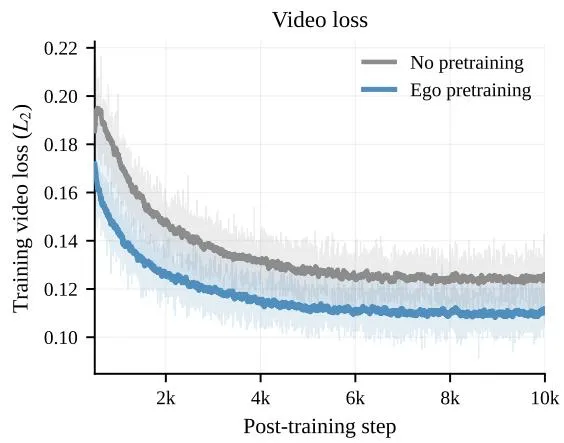
在果蔬分类任务上,拟人预训练的初始化损失显著低于无预训练基线,且收敛到约 2.4 倍更低的动作损失。
六、相关数据集概览
Table 1 列出了 landmark 公开数据集的规模对比:
拟人视频语料库
| 语料库 | 时长 | 获取方式 | 覆盖范围 |
|---|---|---|---|
| EgoDex [14] | 829h | 消费级头显,原生手部姿态 | 194 桌面操作任务 |
| Ego4D [12] | 3,670h | 931 摄像头佩戴者,日常生活 | 74 地点,9 国家 |
| Sekai [21] | 5,000+h | 网络抓取(拟人视角) | 步行/探索,全球 |
| Xperience-10M [31] | 10,000h | 可穿戴捕获,10M 交互 | 开放世界日常经验 |
| EgoScale [39] | 20,854h | 聚合 + 手部重映射 | 灵巧操作 |
| Egocentric-100K [6] | 100,405h | 14,228 工人,头戴眼镜 | 工业/工厂操作 |
| HumanNet [9] | 1,000,000h | 网络策展,拟人+第三人称 | 开放世界,长尾交互 |
遥操作真实机器人语料库
| 语料库 | 时长 | 获取方式 | 覆盖范围 |
|---|---|---|---|
| DROID [18] | 350h | 50 采集者,12 个月 | 564 场景,84 任务 |
| Galaxea Open-World [16] | 500h | 单具身,野外 | 家庭、厨房、零售、办公室 |
| MolmoAct2 Bimanual [11] | 720+h | 双臂 YAM 机械臂 | 最大开源双臂发布 |
| RoboMIND 2.0 [15] | 1,000+h | 双臂移动遥操作,310K+ 轨迹 | 双臂协调任务 |
| Open X-Embodiment [29] | ~2,000-3,000h | 60 数据集池化,1M+ 轨迹 | 22 种具身,527 技能 |
| AgiBot World [2] | 2,976h | 100 机器人车队,1M+ 轨迹 | 217 任务,106 场景,5 领域 |
| RoVid-X [10] | 10,000+h | 开源聚合,4M 机器人视频 | 1,300+ 细粒度机器人技能 |
| Being H-0.5 [25] | ~35,000h | OXE + AgiBot + RoboMIND + … | 30 种具身,含仿真 |
七、相关工作
基于真实机器人数据的具身学习扩展
遥操作数据是具身基础模型的主导数据源。Open X-Embodiment 联合了 22 种具身的超过 100 万条轨迹,展示了跨具身混合提高了鲁棒性和零样本迁移能力 [29]。RT-1/RT-2 建立了扩展机器人小时数和微调 web 预训练 VLM backbone 产生语义泛化的结论 [5, 40]。DROID [18]、π₀ [4]、GR00T [28] 和 AgiBot World [2] 推动了规模、多样性和新具身形式的发展。这些数据与部署策略运动学对齐,但采集成本限制了供给量,导致背景、物体和交互同质化,以及脆弱的分布外行为。
拟人数据用于机器人预训练
拟人语料库如 EPIC-KITCHENS [8]、Ego4D [12] 和 Ego-Exo4D [13] 长期以来支持识别和表示学习,具身迁移是间接应用。近期一条研究路径直接将拟人视频作为预训练底物:EgoMimic 联合训练人类和机器人数据 [17];EgoScale 扩展到 20,000+ 小时并报告了灵巧操作的日志线性缩放规律 [39];Being-H0 为仿人机器人蒸馏了手部轨迹先验 [24];HumanEgo 展示了数分钟的拟人演示可以替代更长的遥操作 [34]。然而,此前没有任何工作在有控制的后续训练基准上将拟人和真实机器人预训练进行正面比较。
具身智能架构
具身策略学习围绕两大架构家族组织:
- VLA 模型:在预训练视觉-语言 backbone 上添加动作头,如 RT-2 [40]、π₀ [4]、GR00T [28]、OpenVLA [19]、RDT [23] 和 LingBot-VLA [35]
- 世界-动作模型(WAM):联合建模未来状态和动作,使用视频生成作为控制下世界演化的密集表示。DreamZero [36] 在单个扩散过程中联合去噪未来视频和动作,LingBot-VA [20] 顺序预测它们。Fast-WAM [37] 保留了视频联合训练但在推理时跳过未来生成,表明视频建模的好处主要在于训练期间塑造表示而非测试时想象未来
八、总结
核心贡献
- 系统对比研究:首次在固定后训练和评估协议下,系统比较了拟人视频和遥操作真实机器人数据作为具身基础模型预训练数据源
- 新范式验证:验证了”预训练用拟人视频学习通用世界表示 + 后训练用少量真实机器人数据对齐动作空间”的可扩展范式
- 缩放律发现:建立了首个自回归世界-动作模型在拟人预训练上的对数线性缩放曲线
- OOD 泛化优势:在分布外泛化上,拟人预训练显著超越真实机器人预训练(24% 更低验证损失,90% vs 0% 分布外成功率)
- 数据质量评估指导:为昂贵的机器人数据采集提供了数据质量评估的指导
技术影响
HumanScale 的结果挑战了具身学习领域的一个基本假设——即精确的具身对齐(embodiment alignment)是预训练的首要条件。相反,结果表明覆盖度(diversity and scale)对于预训练阶段更为重要,而对齐度可以通过后训练来弥补。这一发现为具身基础模型的数据策略提供了新的设计原则。
局限性
- 当前训练方案限制在 5,000 小时,随着更多真实机器人数据的可用,拟人语料库和预训练预算将进一步扩展
- 目前评估主要基于世界-动作模型(WAM),以 Wan2.2 作为视频生成 backbone
- 正在评估基于 VLA 模型的拟人数据缩放行为,跨更广泛的机器人具身系统
- 拟人视频的伪动作标签精度可能不如真实机器人数据
九、参考资源
- arXiv: 2606.20521
- GitHub: https://github.com/DAGroup-PKU/HumanNet/
- HumanNet: arXiv:2605.06747