ARGUS: Production-Scale Tracing and Performance Diagnosis for over 10,000-GPU Clusters
针对万卡 GPU 集群的低开销、细粒度、常开追踪与实时分析系统,总开销 <2%,内核事件压缩 3,700x
ARGUS: Production-Scale Tracing and Performance Diagnosis for over 10,000-GPU Clusters
论文信息: arXiv:2606.20374 [cs.DC] 18 Jun 2026
作者: Jiasheng Zhou, Longbin Zeng, Clavis Chen, Ruiming Lu, Qinwei Yang, Leyi Ye, Ray Ying, Key Zhang
会议: 2026 ACM SIGOPS Annual Technical Conference (ATC)
许可: arXiv 非独占分发许可
一、论文概述
1.1 研究背景
大规模 LLM 训练需要全天候、细粒度的可观测性来进行有效的性能诊断。粗粒度的资源监控器无法定位根本原因,而细粒度的分析器会带来 5%-30% 的开销和海量追踪数据,使得在大型生产集群中常开部署变得不切实际。
核心挑战:
| 挑战 | 说明 |
|---|---|
| Fail-slow 问题 | 性能降级拖慢整个训练作业,但不触发显式错误 |
| 开销权衡 | 细粒度分析器开销 5%-30%,无法常开部署 |
| 数据量爆炸 | 10,000 GPU 集群每小时产生数百 GB 原始追踪数据 |
| 诊断复杂性 | 随规模增长,诊断难度超线性增加 |
1.2 核心贡献
| 贡献 | 说明 |
|---|---|
| 低开销监控 | 三层次分解监控,总开销 <2% |
| 数据压缩 | 内核事件压缩约 3,700x(10 MB → 2.7 KB/rank/step) |
| 渐进式诊断 | 五级诊断框架,自动隔离异常窗口、落后 rank 和退化内核 |
| 生产验证 | 在 10,000+ GPU 集群部署超过 6 个月 |
| 案例研究 | 覆盖计算落后者、链接退化、流水线气泡等典型异常 |
二、核心思想
2.1 问题定义
在 10,000+ GPU 的大规模 LLM 训练集群中,任何一个组件的性能降级都会拖慢整个同步训练作业,但不会触发显式错误。这种 “fail-slow” 问题具有隐蔽性、随机性和难以复现的特点,严重限制了大规模训练效率。
Fail-slow 现象示例:
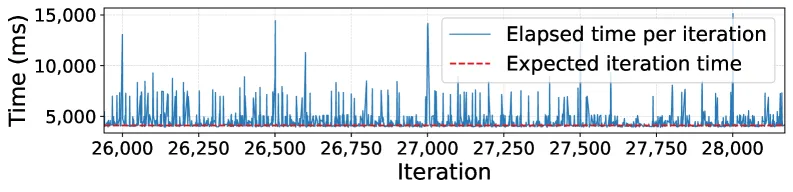 图 1(a):4096-GPU 训练作业中的迭代时间尖峰
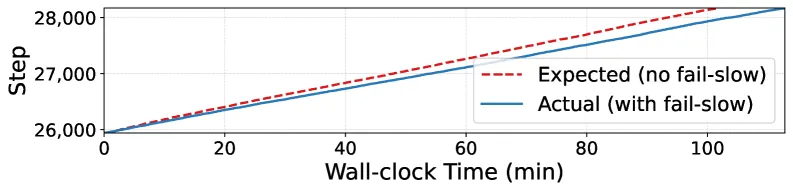 图 1(b):累计进度损失,浪费约 23,758 GPU 小时(7% 总训练计算)
2.2 现有系统局限
| 系统类型 | 代表系统 | 局限性 |
|---|---|---|
| 常开监控 | Greyhound, Holmes, C4, Minder | 只能定位到机器或链路,无法回答哪个内核变慢及原因 |
| 细粒度分析 | MegaScale, EROICA, FLARE | 开销 5%-30%,无法常开部署;或依赖事后手动分析 |
2.3 解决方案概述
ARGUS 通过以下创新解决上述挑战:
- 分解观察:沿训练调用层次分解为 CPU 调用栈、框架语义和 GPU 内核执行三个互补信号
- 在线统计压缩:基于 KDE 聚类的内核事件压缩,压缩比达 3,700x
- 渐进式诊断:五级诊断框架,从异常时间窗口逐步缩小到具体内核
三、技术架构
3.1 整体框架图
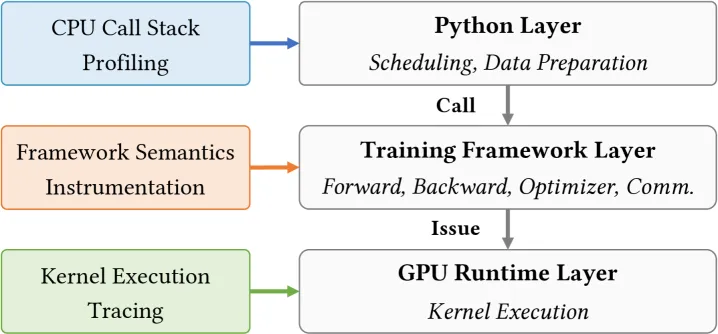 图 2:训练执行的层次结构,展示 CPU 调用栈、框架语义和 GPU 内核执行三个层次
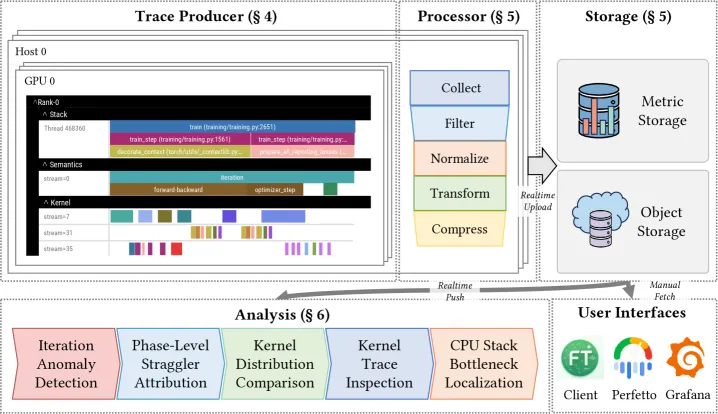 图 3:ARGUS 整体架构,包含 Trace Producer、Processor、Storage 和 Analysis 四个组件
架构组件:
| 组件 | 说明 | 功能 |
|---|---|---|
| Trace Producer | 部署在每个训练进程中 | 持续产生三种互补观察:CPU 调用栈、框架语义、内核执行 |
| Processor | 每个主机一个独立进程 | 过滤、归一化、转换事件为 Perfetto 格式;在线统计压缩内核追踪 |
| Storage | 分层存储 | Metric Storage 支持 Grafana 可视化;Object Storage 持久化完整追踪 |
| Analysis | 诊断分析服务 | 自动检测异常窗口、落后 rank 和退化内核 |
3.2 数据流水线
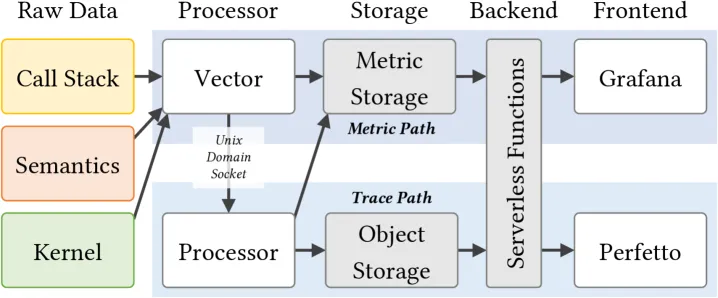 图 4:数据流水线架构,展示 Vector 摄取、处理和存储流程
数据流:
- Vector 摄取三种本地观察日志
- 路径分离:Trace 路径(原始事件流)和 Metrics 路径(可量化指标)
- Processor 处理原始追踪,转换为 Perfetto 格式
- 在线统计压缩内核追踪,写入 Metric Storage
- Metrics 通过 Prometheus Remote Write 协议写入 Metric Storage
3.3 核心公式
KDE 密度估计:
其中 是高斯核函数,带宽 由 Scott’s rule 自动确定:
CDF 重建(对数正态假设):
对于每个聚类 ,构建对数正态分量:
- 位置参数:
- 尺度参数:
Wasserstein-1 距离:
用于衡量两个 rank 之间内核执行时间分布的差异:
3.4 内核事件压缩
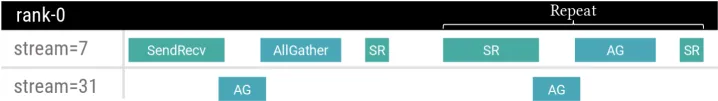 图 5:重复内核执行模式,展示内核事件的统计特性
压缩原理:
- 分布式训练中内核执行具有高度规律的重复模式
- 同一 rank 上相同位置的内核持续时间高度一致
- 相同并行角色的 rank 执行相同的内核序列
压缩流程:
- 时间窗口分割:将内核事件按时间窗口分割
- KDE 谷值检测:使用核密度估计检测聚类边界
- 统计摘要:每个聚类生成结构化统计摘要
- 压缩比:约 3,700x(10 MB → 2.7 KB/rank/step)
3.5 渐进式诊断框架
| 级别 | 数据源 | 模式 | 目的 | 延迟 |
|---|---|---|---|---|
| L1 | 迭代时间序列 | 自动 | 异常时间窗口分类 | 秒级 |
| L2 | 语义阶段持续时间 | 自动 | 落后 rank 和瓶颈阶段 | 秒级 |
| L3 | 内核统计摘要 | 自动 | 退化内核识别 | 分钟级 |
| L4 | 执行追踪 | 手动 | 关键路径和根因确认 | 按需 |
| L5 | CPU 调用栈 | 手动 | 主机侧停顿定位 | 按需 |
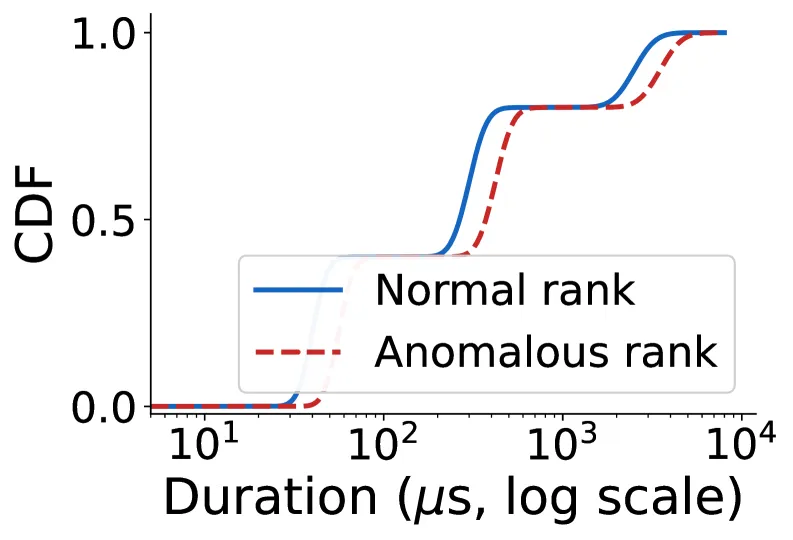 图 7(a):CDF 重建
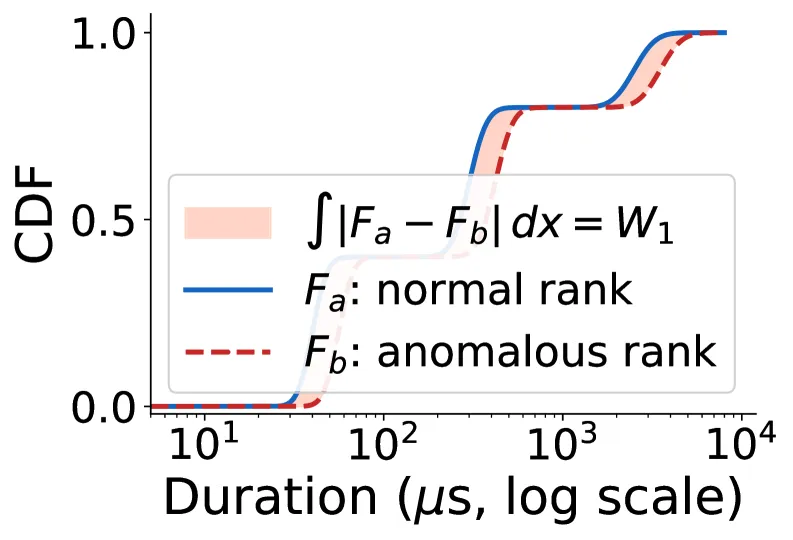 图 7(b):Wasserstein-1 距离
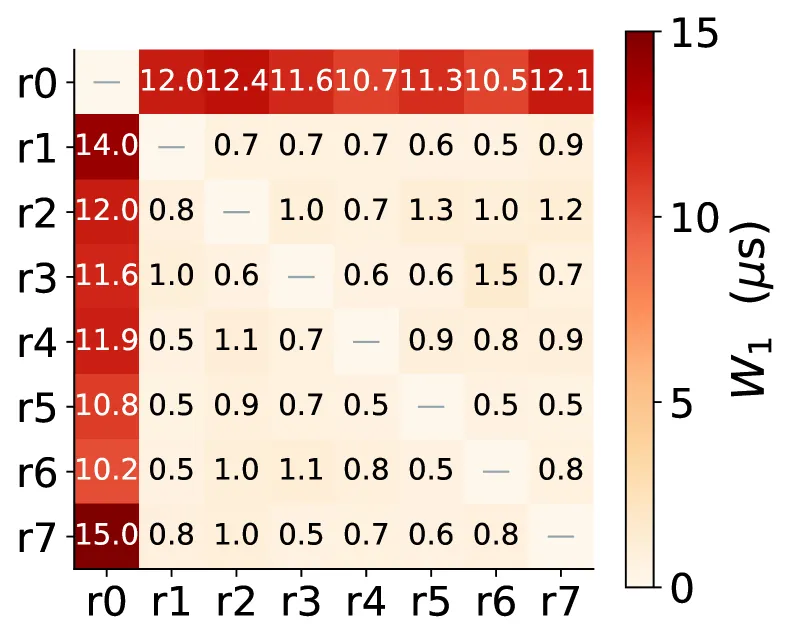 图 7(c):距离矩阵
诊断流程:
- L1:检测异常时间窗口(滑动窗口比率门控 + 全扫描变化点检测)
- L2:定位落后 rank 和瓶颈阶段(CV 分析语义事件)
- L3:识别退化内核(内核统计摘要对比)
- L4/L5:手动深度分析(执行追踪 + CPU 调用栈)
四、核心创新
4.1 创新点总结
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 分解观察 | 三层次互补监控 | CPU 调用栈 + 框架语义 + GPU 内核 |
| 在线统计压缩 | 基于 KDE 聚类的内核事件压缩 | 压缩比 3,700x,保持诊断能力 |
| 渐进式诊断 | 五级诊断框架 | 从异常窗口到具体内核的逐步缩小 |
| 并行组感知路由 | 基于并行维度的事件路由 | DP/EP/PP 组内比较,避免误报 |
| 流式架构 | 无累积的内存管理 | 内存开销恒定,不受训练时长影响 |
4.2 技术细节
并行组感知路由规则:
| 事件类型 | 比较组 |
|---|---|
gated_mla_self_attention, self_attention | DP group |
moe_layer, moe_experts | EP group |
dp-allreduce, dp-reduce-scatter | DP group |
ep-alltoall | EP group |
五、代码实现分析
5.1 实现概览
| 组件 | 语言 | 代码量 |
|---|---|---|
| Trace Producer (内核追踪) | C++ | ~2K lines |
| Trace Producer (语义插桩) | Python + C++ | ~3K lines |
| Processor | Go | ~7.3K lines |
| Analysis 服务 | Python | ~24K lines |
| FT-Client (用户界面) | - | - |
5.2 部署架构
- Trace Producer:CUDA_INJECTION64_PATH 环境变量注入
- Processor:每个主机一个独立进程
- Analysis:诊断分析服务
- FT-Client:统一诊断接口,集成 Grafana 和 Perfetto
六、实验结果
6.1 运行时开销
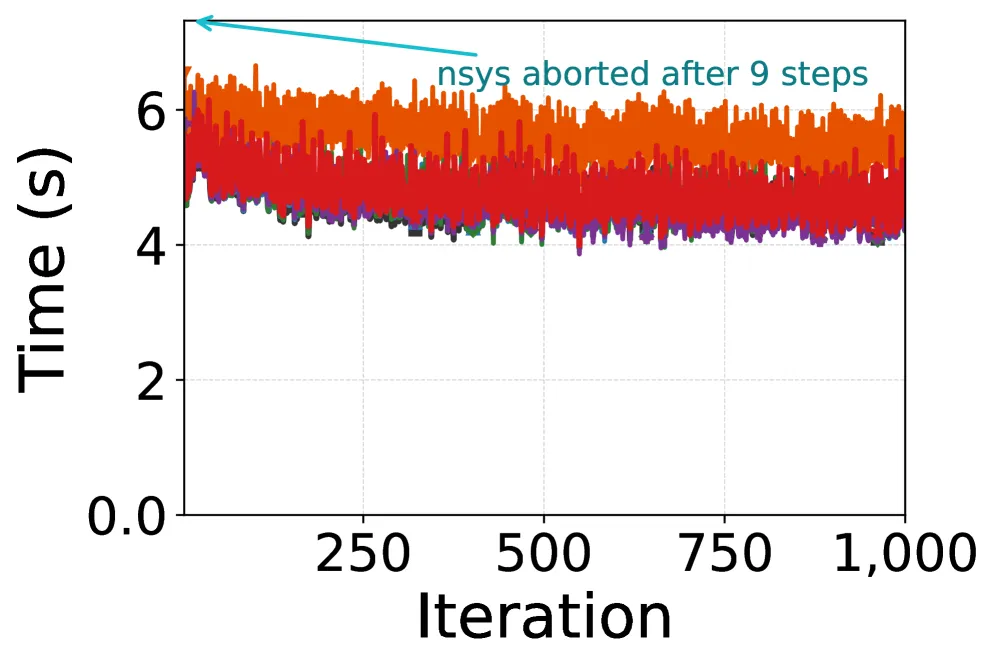 图 8(a):8-GPU 训练时间对比
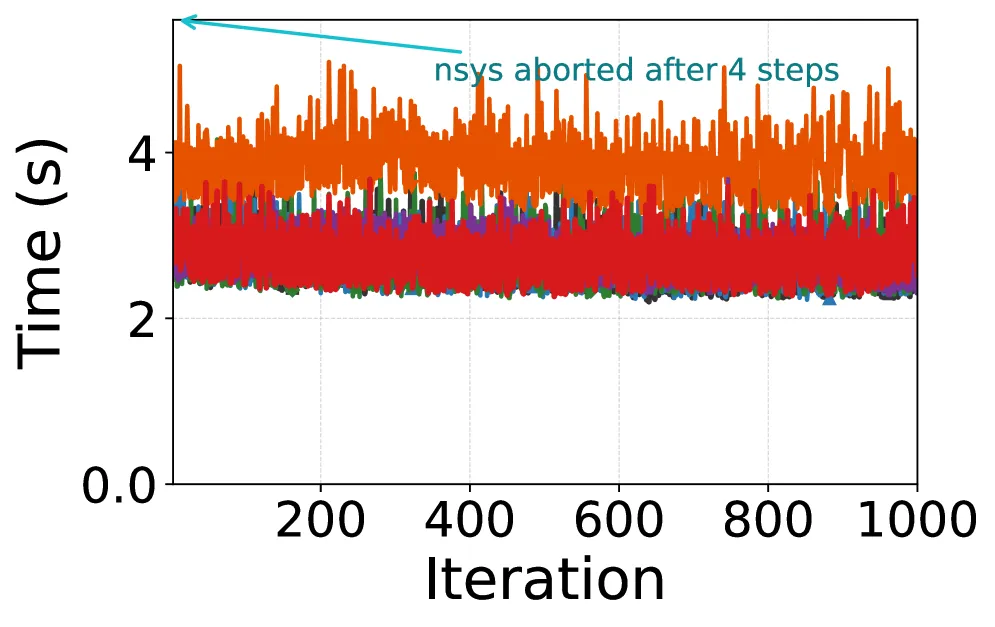 图 8(b):32-GPU 训练时间对比
| 工具 | 开销 | 内存 | 稳定性 |
|---|---|---|---|
| ARGUS | <2% | +2GB (8-GPU), +10GB (32-GPU) | 稳定,无 OOM |
| PyTorch Profiler | 20%-44% | 持续增长至 OOM | 不稳定,最终 OOM |
| nsys | N/A | 高 | 训练失败 (NaN/Hang) |
关键发现:
- ARGUS 语义插桩和栈采样开销可忽略
- 内核执行追踪 (CUPTI) 开销约 1%-2%
- 三者结合总开销 <2%
- 随模型增大,GPU 计算主导,开销进一步降低
6.2 内存占用
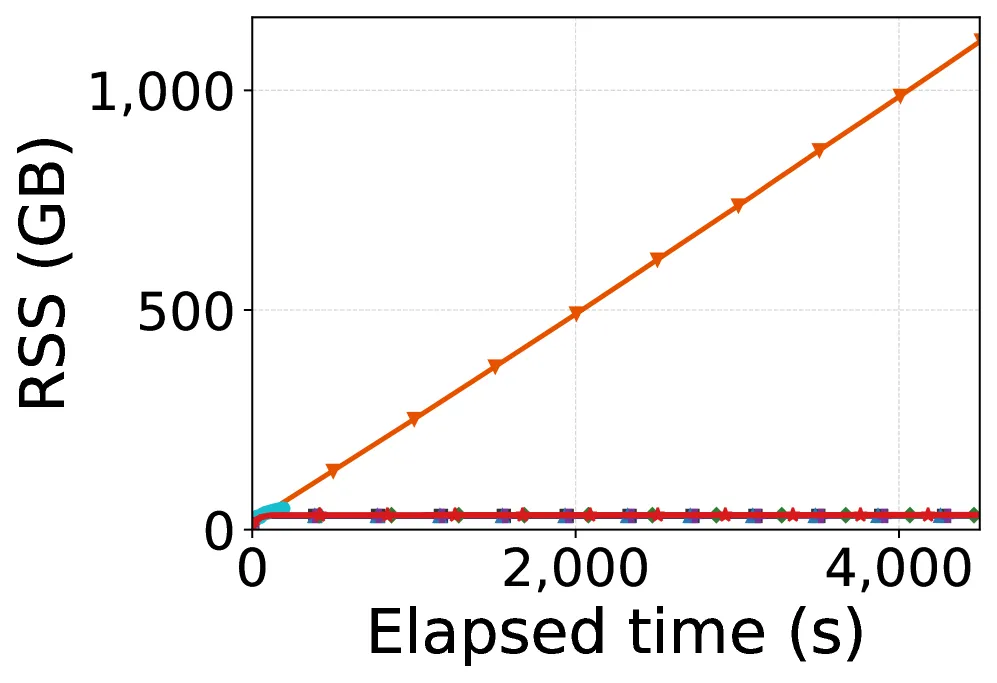 图 9(a):8-GPU 内存占用
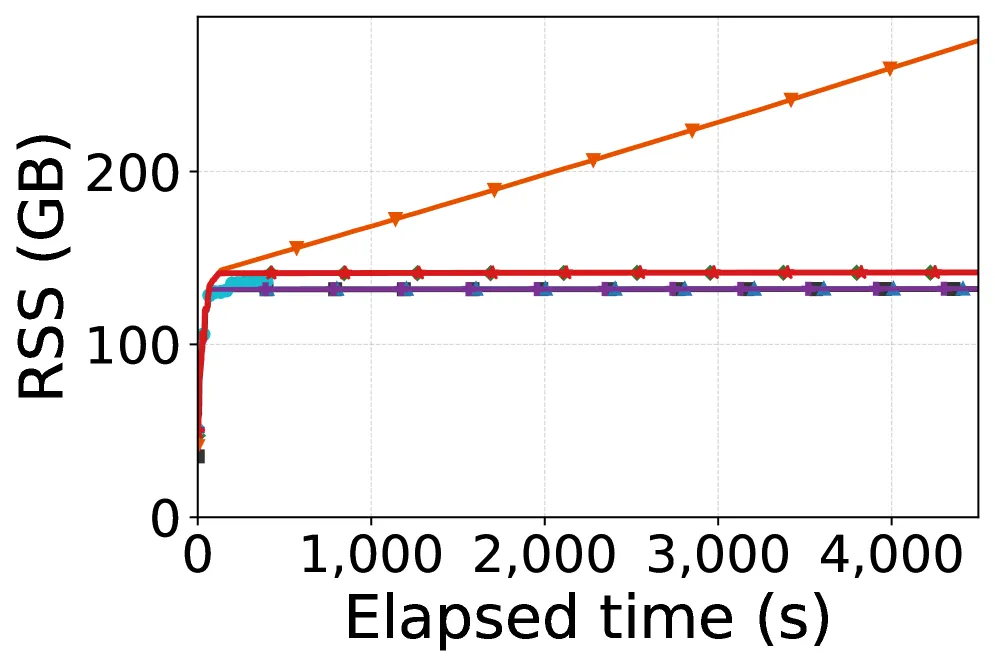 图 9(b):32-GPU 内存占用
关键发现:
- ARGUS 内存占用稳定,不受训练时长影响
- PyTorch Profiler 内存持续增长,最终 OOM
- nsys 内存占用高,导致训练失败
6.3 数据量与压缩
| 处理阶段 | 每 rank 每步数据量 |
|---|---|
| 原始内核事件 | ~10 MB |
| 统计压缩后 | ~2.7 KB |
| 压缩比 | ~3,700x |
七、案例研究
7.1 案例1:计算落后者定位
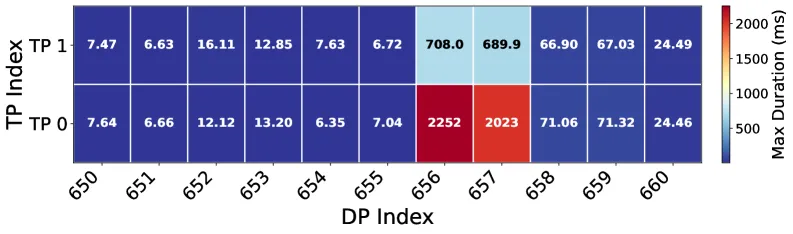 图 10(a):self_attention 持续时间热力图
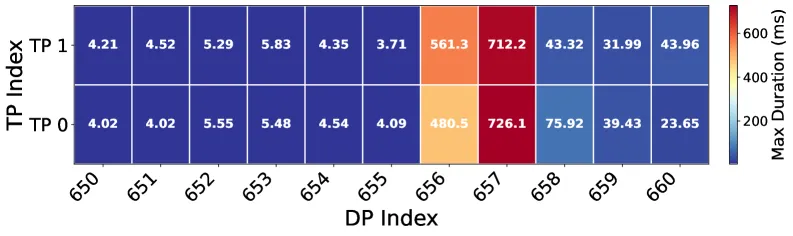 图 10(b):mlp / grouped_mlp 持续时间热力图
| 项目 | 详情 |
|---|---|
| 作业规模 | 4,096 GPU,TP=2,EP=8 |
| 异常现象 | 迭代时间从 4s 增加到 200s+ |
| 诊断结果 | DP=656,657 的 self_attention 退化 150x |
| 根因 | 本地 GPU 计算降级,非同步延迟 |
| 解决方案 | 排除受影响节点,训练恢复正常 |
7.2 案例2:通信链接退化
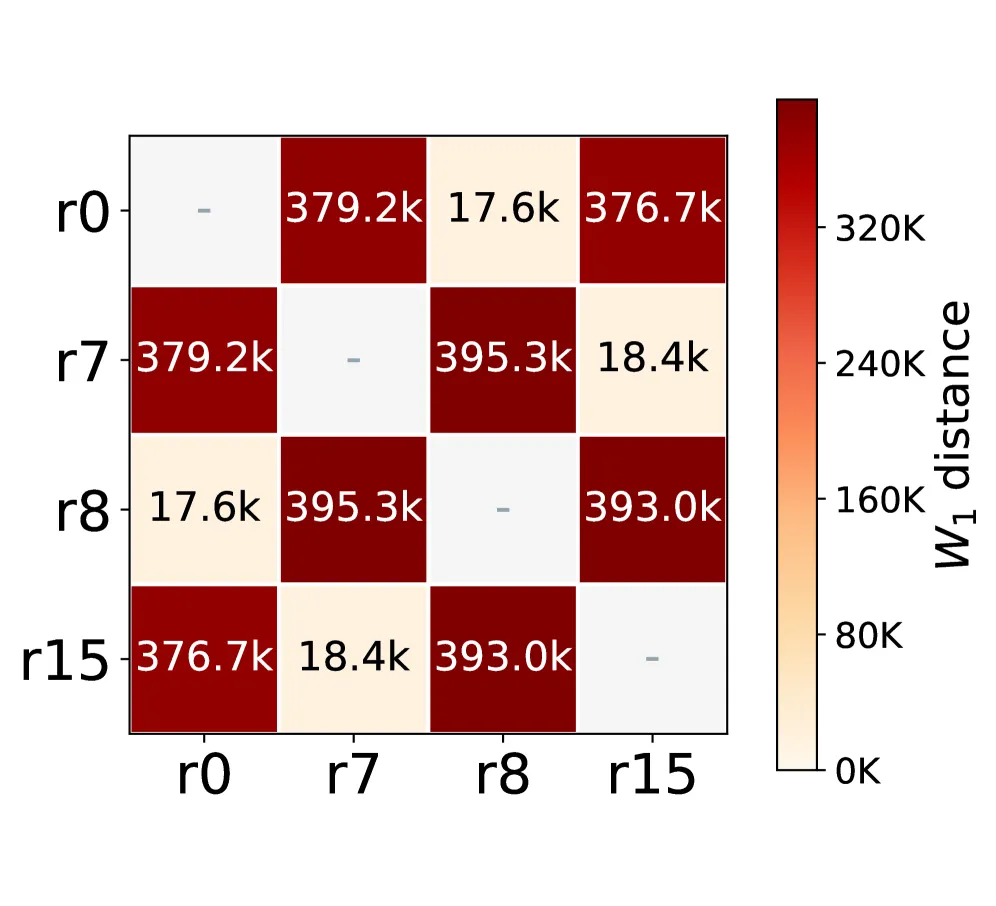 图 11(a):AllReduce 距离矩阵
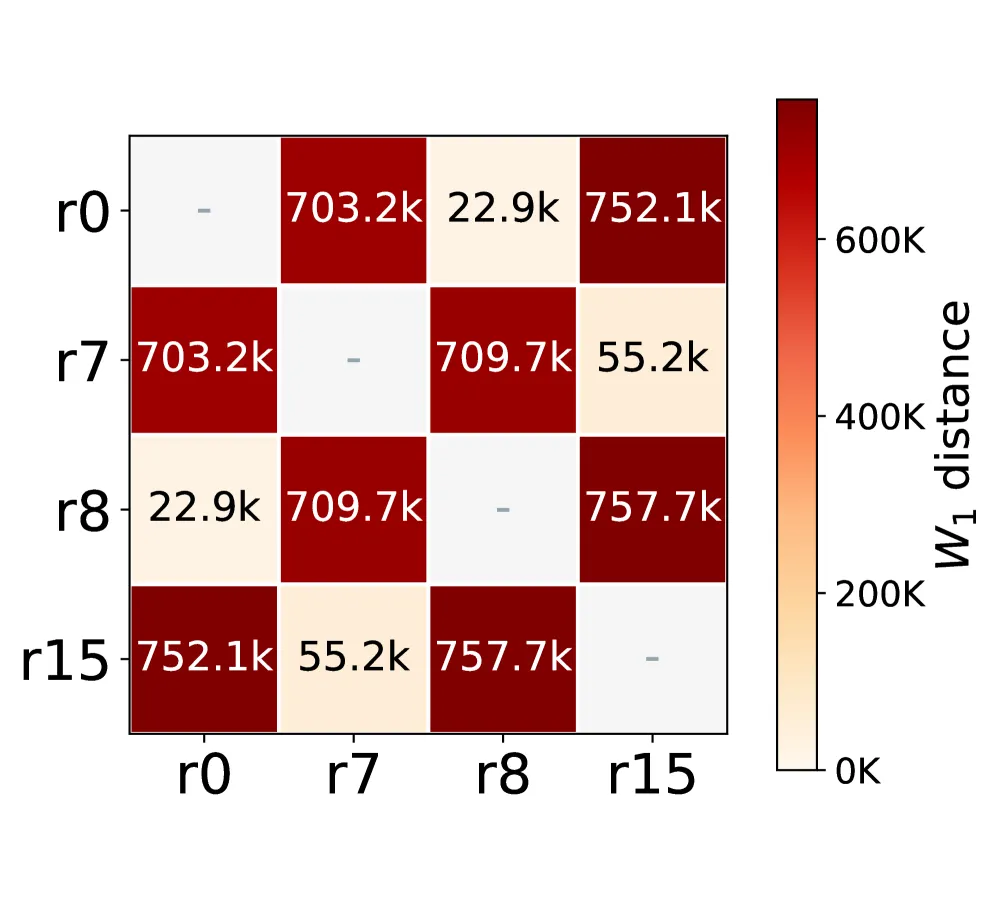 图 11(b):AllGather 距离矩阵
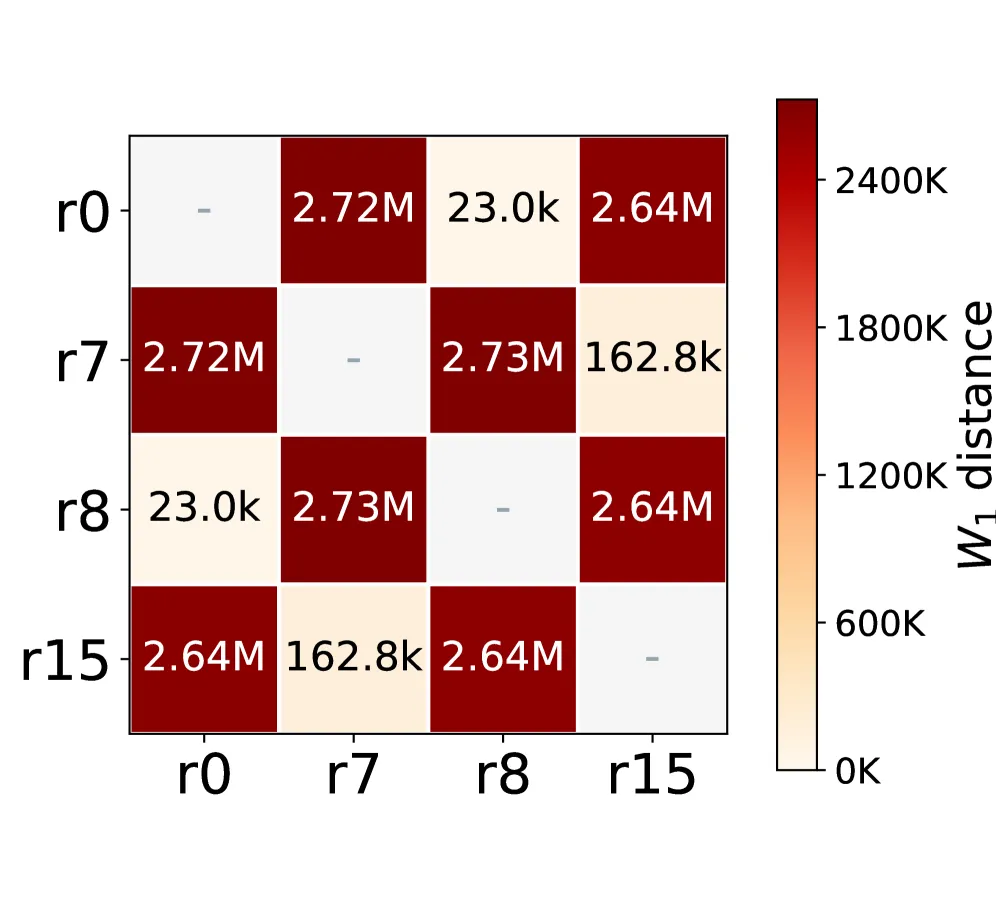 图 11(c):ReduceScatter 距离矩阵
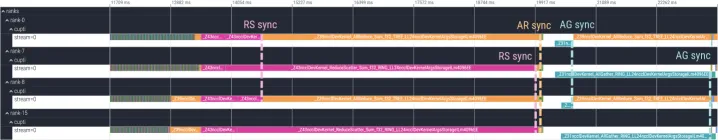 图 12:L4 Perfetto 追踪,展示 rank 7 的通信内核异常
| 项目 | 详情 |
|---|---|
| 作业规模 | 512 GPU,EP=8 |
| 异常现象 | 迭代时间稳定,但吞吐量持续低于基线 |
| 诊断结果 | L3 检测到三个通信内核类型的分布偏移 |
| 根因 | EDP 组内通信链接系统性降级 |
| 特征 | 组内距离小 (17-23k),组间距离大 (376k-2.73M) |
7.3 案例3:流水线气泡放大
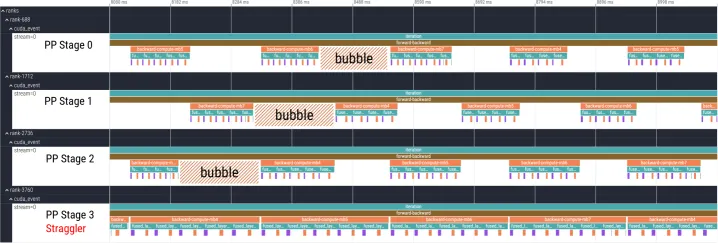 图 13:PP 组内 L4 Perfetto 追踪,展示气泡放大模式
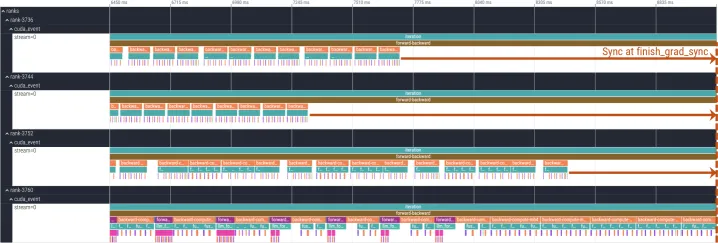 图 14:跨 PP 组对比,展示 rank 3760 的反向计算更密集
| 项目 | 详情 |
|---|---|
| 异常现象 | 迭代时间增加约 40% |
| 诊断结果 | rank 3760 的反向计算事件密集,气泡小 |
| 根因 | 流水线并行气泡放大效应 |
| 特征 | 上游 rank 的气泡被放大,导致整体延迟 |
7.4 案例4:FlashAttention JIT 编译停顿
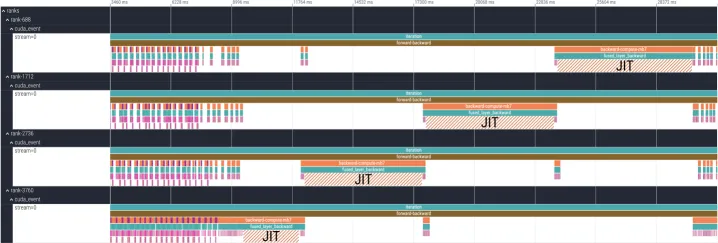 图 15:L4 Perfetto 追踪,展示 FlashAttention JIT 编译停顿
| 项目 | 详情 |
|---|---|
| 异常现象 | 单步迭代时间异常增加 |
| 诊断结果 | backward-compute-mb7 持续时间增加约 40x |
| 根因 | FlashAttention JIT 编译导致主机侧停顿 |
| 特征 | 稀疏内核启动,主机侧空闲 |
7.5 案例5:计算落后者被通信掩盖
| 项目 | 详情 |
|---|---|
| 异常现象 | 带外指标(如 GPU 利用率)显示正常 |
| 诊断结果 | 计算落后者被通信同步掩盖 |
| 根因 | 传统监控工具无法检测此类隐蔽异常 |
| 意义 | 证明了细粒度内核级监控的必要性 |
八、相关工作
8.1 现有系统对比
| 系统 | 类型 | 粒度 | 开销 | 常开 | 实时分析 |
|---|---|---|---|---|---|
| Greyhound | 监控 | 迭代级 | 低 | 是 | 否 |
| Holmes | 监控 | 链路级 | 低 | 是 | 否 |
| C4 | 监控 | 机器级 | 低 | 是 | 否 |
| MegaScale | 分析 | 阶段级 | 高 | 否 | 否 |
| EROICA | 分析 | 内核级 | 5-30% | 否 | 部分 |
| FLARE | 分析 | 内核级 | 5-30% | 否 | 部分 |
| ARGUS | 混合 | 内核级 | <2% | 是 | 是 |
8.2 技术差异
| 特性 | ARGUS | 其他系统 |
|---|---|---|
| 观察分解 | 三层次互补 | 单一或有限层次 |
| 压缩方法 | 在线 KDE 聚类 | 无或简单采样 |
| 诊断框架 | 五级渐进式 | 事后手动分析 |
| 部署模式 | 常开生产部署 | 按需或实验环境 |
九、总结
9.1 核心贡献
- 低开销监控:三层次分解监控,总开销 <2%,实现常开部署
- 高效压缩:基于 KDE 聚类的在线统计压缩,压缩比 3,700x
- 渐进式诊断:五级诊断框架,从异常窗口逐步缩小到具体内核
- 生产验证:在 10,000+ GPU 集群部署超过 6 个月
- 案例覆盖:成功诊断计算落后者、链接退化、流水线气泡、JIT 停顿等多种异常
9.2 技术影响
- 运维效率:大幅减少大规模训练集群的性能诊断时间
- 资源利用率:通过及时发现和修复性能问题,提高 GPU 资源利用率
- 可观测性标准:为大规模分布式训练系统树立了新的可观测性标准
9.3 局限性
- 诊断深度:L4/L5 仍需手动分析,自动化程度有限
- 异常类型:主要针对 fail-slow 问题,对其他类型异常的覆盖有限
- 部署复杂度:需要在训练代码中集成插桩,增加部署复杂度
十、参考资源
10.1 论文链接
10.2 关键图表
| 图表 | 说明 | 路径 |
|---|---|---|
| 图 1 | Fail-slow 现象展示 | figure-1-fail-slow-a.png, figure-1-fail-slow-b.png |
| 图 2 | 训练执行层次结构 | figure-2-hierarchical-structure.png |
| 图 3 | ARGUS 整体架构 | figure-3-architecture.png |
| 图 4 | 数据流水线架构 | figure-4-data-pipeline.png |
| 图 5 | 重复内核执行模式 | figure-5-kernel-patterns.png |
| 图 6 | KDE 聚类可视化 | figure-6-kde-clustering-a.png, figure-6-kde-clustering-b.png |
| 图 7 | 内核统计异常检测 | figure-7-anomaly-detection-a.png, figure-7-anomaly-detection-b.png, figure-7-anomaly-detection-c.png |
| 图 8 | 训练时间对比 | figure-8-training-time-a.png, figure-8-training-time-b.png |
| 图 9 | 内存占用对比 | figure-9-memory-footprint-a.png, figure-9-memory-footprint-b.png |
| 图 10 | 案例1:计算落后者 | figure-10-case1-straggler-a.png, figure-10-case1-straggler-b.png |
| 图 11 | 案例2:距离矩阵 | figure-11-case2-distance-a.png, figure-11-case2-distance-b.png, figure-11-case2-distance-c.png |
| 图 12 | 案例2:L4 追踪 | figure-12-case2-l4-trace.png |
| 图 13 | 案例3:流水线气泡 | figure-13-case3-pipeline-bubble.png |
| 图 14 | 案例3:跨组对比 | figure-14-case3-cross-group.png |
| 图 15 | 案例4:JIT 停顿 | figure-15-case4-jit-stall.png |


10.3 相关论文
| 论文 | 作者 | 年份 | 关系 |
|---|---|---|---|
| Greyhound | Wu et al. | 2025 | 性能诊断 |
| Holmes | Yao et al. | 2025 | 异常检测 |
| C4 | Dong et al. | 2025 | 集群监控 |
| MegaScale | Jiang et al. | 2024 | 大规模训练 |
| EROICA | Guan et al. | 2026 | 性能分析 |
| FLARE | Cui et al. | 2026 | 故障诊断 |
| Perfetto | 2024 | 追踪可视化 |
10.4 关键技术术语
| 术语 | 英文 | 说明 |
|---|---|---|
| Fail-slow | Fail-slow | 性能降级但不触发错误 |
| 分解观察 | Decomposed Observation | 三层次互补监控 |
| 渐进式诊断 | Progressive Diagnosis | 五级诊断框架 |
| 内核事件压缩 | Kernel Event Compression | 在线统计压缩 |
| 观察者效应 | Observer Effect | 分析工具影响被观察系统 |
| KDE 聚类 | KDE Clustering | 核密度估计聚类 |
| Wasserstein 距离 | Wasserstein Distance | 分布差异度量 |
分析完成时间:2026年6月22日 分析工具:Claude Code + paper-analyzer skill + agent-browser