ViCoStream: Streaming VideoLLMs Can Run Beyond 100 FPS with Stage-Wise Coordinated Inference
通过阶段式协调推理架构,实现流式 VideoLLM 在单 A100 GPU 上达到 134 FPS 吞吐量和低于 50ms TTFT
ViCoStream: Streaming VideoLLMs Can Run Beyond 100 FPS with Stage-Wise Coordinated Inference
论文信息: arXiv:2606.19849 [cs.CV] 18 Jun 2026
作者: Yang Tan, Junlong Tong, Linan Yue, Hao Wu, Pengfei Fang, Xiaoyu Shen
代码: https://github.com/EIT-NLP/ViCoStream
许可: CC BY 4.0
一、论文概述
1.1 研究背景
流式 VideoLLM 需要持续处理传入视频流,同时保持低查询延迟。现有的 VideoLLM 加速方法主要关注单个模块(如视觉编码、token 裁剪或 KV 缓存压缩),但缺乏对系统是否能维持实时流式性能的洞察。
核心挑战:
| 挑战 | 说明 |
|---|---|
| 吞吐量瓶颈 | 视频流处理速度必须快于视频到达速度 |
| 延迟增长 | 随着流长度增加,查询延迟(TTFT)持续增长 |
| 资源限制 | 单 GPU 场景下需同时处理视觉编码和 LLM 推理 |
| 注意力开销 | 全历史注意力机制导致内存和计算开销线性增长 |
1.2 核心贡献
| 贡献 | 说明 |
|---|---|
| 阶段式协调流水线 | 将推理分解为 4 个阶段:视觉预处理、视觉编码、token 裁剪、LLM 推理 |
| 有界视觉注意力 | 限制每 chunk 的可视视觉历史,防止延迟增长 |
| 134 FPS 吞吐量 | 在单 A100 GPU 上实现 134 FPS 视频处理速度 |
| 低延迟响应 | TTFT 低于 50ms,支持实时交互 |
二、核心思想
2.1 问题定义
现有流式 VideoLLM 存在两种范式:
| 范式 | 特点 | 问题 |
|---|---|---|
| 延迟流式 | 积累帧直到查询到达 | 延迟和内存随流长度增长 |
| 连续流式 | 增量处理视频帧 | 瓶颈在阶段间迁移,整体吞吐量受限 |
ViCoStream 的核心思想:将流式 VideoLLM 推理视为协调的多阶段流水线,通过控制每个阶段来保证整体性能。
2.2 解决方案概述
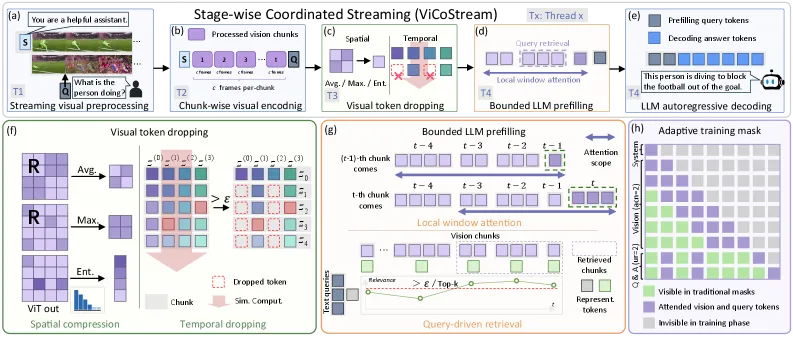 图 2:ViCoStream 阶段式协调流式架构概览。
ViCoStream 的四个核心控制:
- Chunk-wise 执行:将视频流分割为非重叠 chunks,提高 GPU 利用率
- CUDA Stream 重叠:视觉预处理与模型推理并行执行
- 视觉 Token 控制:空间和时间维度的 token 裁剪
- 有界视觉注意力:限制每 chunk 的可视视觉上下文大小
三、技术架构
3.1 流水线架构
图 2:ViCoStream 阶段式协调流式架构。(a)-(e) 展示从流式输入到自回归解码的主并行流水线。
四个推理阶段:
| 阶段 | 功能 | 关键优化 |
|---|---|---|
| 视觉预处理 | 解码、缩放、归一化帧 | CUDA Stream 重叠 |
| 视觉编码 | ViT 编码帧为视觉特征 | Chunk-wise 批处理 |
| Token 裁剪 | 投影并移除冗余 token | 空间+时间裁剪 |
| LLM 推理 | 视觉 token 注入 + 查询预填充 | 有界注意力 + 检索 |
3.2 核心公式
流水线吞吐量:
最大流式帧率:
其中 是 chunk 大小, 是最慢阶段的处理时间。
时间 Token 裁剪:
对于位置 ,计算帧对间的余弦相似度:
当所有相似度超过阈值 时,裁剪该位置的 token:
3.3 符号说明
| 符号 | 含义 |
|---|---|
| Chunk 大小(帧数) | |
| 视觉预处理延迟 | |
| 视觉编码延迟 | |
| Token 裁剪延迟 | |
| LLM 推理延迟 | |
| 时间相似度阈值 | |
| 注意力上下文大小 |
四、核心创新
4.1 创新点总结
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 阶段式协调 | 4 个阶段独立优化并协调 | 流水线吞吐量理论分析 |
| 有界视觉注意力 | 限制可视视觉历史大小 | 延迟稳定性实验验证 |
| 视觉 Token 控制 | 空间+时间维度裁剪 | 准确率-效率权衡分析 |
| 瓶颈迁移分析 | 系统研究瓶颈如何在阶段间迁移 | 详细的延迟分解实验 |
4.2 技术细节
内存与延迟稳定性验证:
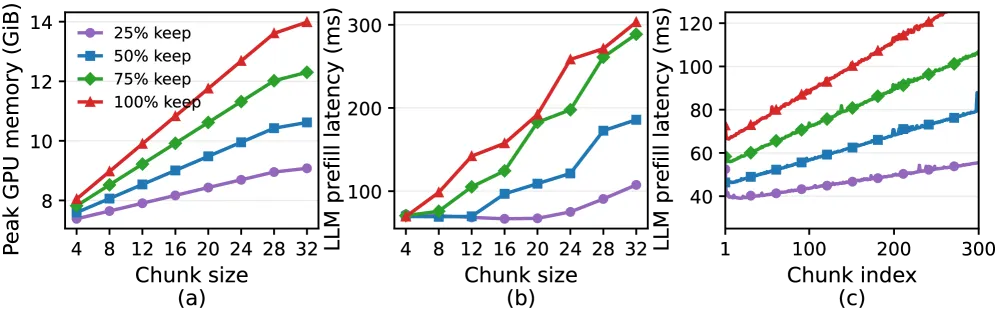 图 1:全历史流式注意力下的内存和延迟缩放。
关键发现:
- Token 裁剪减少 (a) 峰值 GPU 内存和 (b) LLM 预填充延迟
- 但 (c) 预填充延迟仍随流索引增长,因为可视视觉历史累积
- 证实仅靠 token 裁剪无法保证长时间延迟稳定性
有界注意力效果:
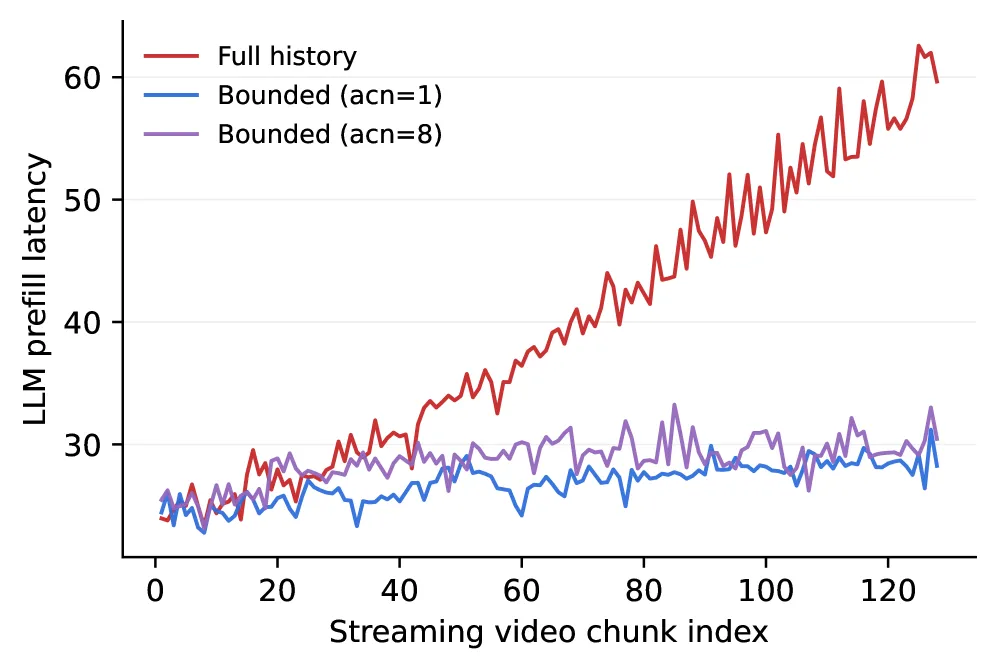 图 4:长流上 LLM 预填充延迟。全历史注意力增长,而有界注意力保持稳定。
延迟-准确率权衡:
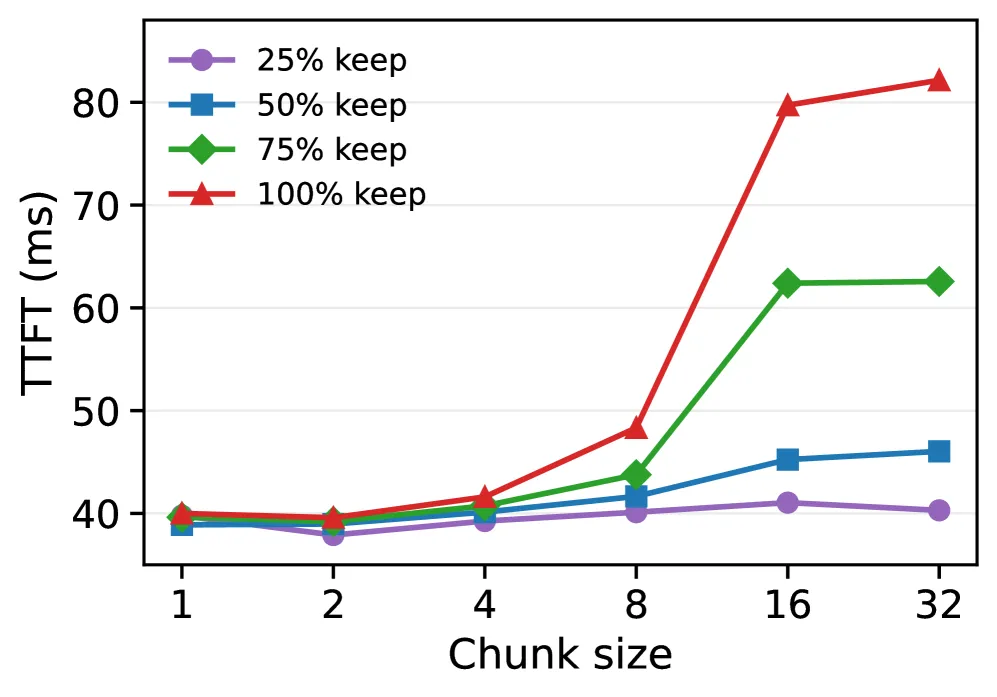 图 5:有界交叉注意力下的延迟和准确率。(左) 不同 token 保留率和检索预算下的查询响应延迟。(中) 查询侧预填充 TTFT。(右) 不同设置下的准确率比较。
五、代码实现分析
5.1 实现概览
| 组件 | 说明 |
|---|---|
| ViCoStream 框架 | 基于 PyTorch 的流式推理框架 |
| CUDA Stream 管理 | 视觉预处理与模型推理并行 |
| Token 裁剪模块 | 支持空间池化和时间相似度裁剪 |
| 有界注意力掩码 | 限制可视视觉上下文大小 |
| 查询侧检索 | 基于检索的查询响应机制 |
5.2 部署架构
- 训练:最多 4x H100 GPU
- 推理:单 A100 GPU
- 基座模型:Qwen2.5-VL-3B-Instruct, Qwen2.5-VL-7B-Instruct
- 训练数据:LLaVA-Video-100K + TimeChat-Online-139K
六、实验结果
6.1 效率与准确率分析
Token 裁剪 vs 准确率:
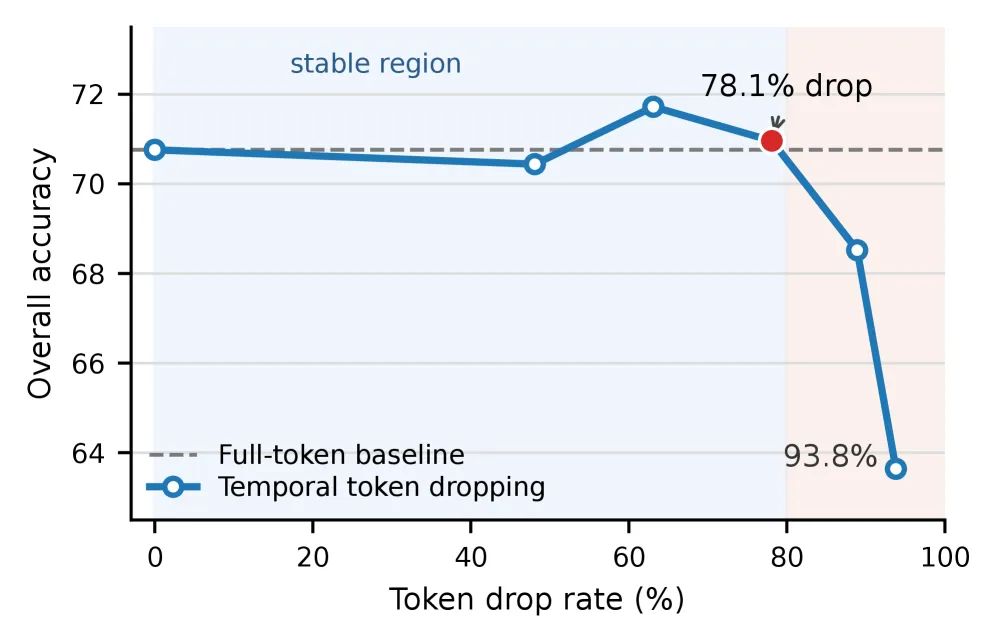 图 3:StreamingBench 上训练的 Qwen2.5-VL-3B 在全注意力下的 token 裁剪率与准确率关系。
关键发现:
- 裁剪 78.1% 的视觉 token 仍能保持接近全 token 基线的准确率
- 仅在更激进的压缩下准确率才显著下降
延迟分解与瓶颈迁移:
| Chunk 大小 | Token 保留率 | VP | ViT | Drop | LLM Prefill | FPS |
|---|---|---|---|---|---|---|
| 1 | 30% | 5ms | 30ms | 6ms | 38ms | 26 |
| 4 | 30% | 37ms | 40ms | 12ms | 44ms | 91 |
| 8 | 30% | 73ms | 64ms | 24ms | 44ms | 110 |
| 16 | 30% | 113ms | 119ms | 44ms | 42ms | 134 |
| 32 | 30% | 248ms | 235ms | 87ms | 69ms | 129 |
| 1 | 50% | 5ms | 30ms | 6ms | 38ms | 26 |
| 4 | 50% | 47ms | 41ms | 12ms | 45ms | 86 |
| 8 | 50% | 82ms | 64ms | 23ms | 45ms | 98 |
| 16 | 50% | 160ms | 119ms | 45ms | 64ms | 100 |
| 32 | 50% | 317ms | 236ms | 87ms | 124ms | 101 |
关键发现:
- 最优配置:chunk=16, token 保留率 30% → 134 FPS
- 瓶颈在不同配置下在 ViT、Drop、LLM Prefill 间迁移
- Chunk 大小影响 VP 和 ViT 延迟,而非均匀缩放所有阶段
6.2 准确率比较
Qwen2.5-VL-3B 准确率:
| 模型 | acn | ur | s | StreamingBench | OvO-Bench | StreamBench | RVS-E | RVS-M |
|---|---|---|---|---|---|---|---|---|
| 基线 | ∞ | ∞ | – | 70.32 | 47.13 | 48.37 | 34.59 | 33.91 |
| ViCoStream† | 4 | 64 | 0.25 | 70.44 | 45.30 | 49.72 | 35.22 | 31.97 |
| ViCoStream† | 8 | 64 | 0.25 | 70.52 | 46.35 | 49.06 | 34.12 | 31.55 |
| ViCoStream† | 4 | 64 | 0.1 | 68.32 | 42.19 | 46.35 | 34.40 | 29.04 |
关键发现:
- ViCoStream 在大多数基准测试上保持与全历史基线相当的准确率
- 在 30% token 保留率和 64 帧检索预算下,StreamingBench 准确率提升 0.12
- 仅在非常激进的压缩(0.1s 更新率)下准确率才显著下降
6.3 Token 裁剪可视化
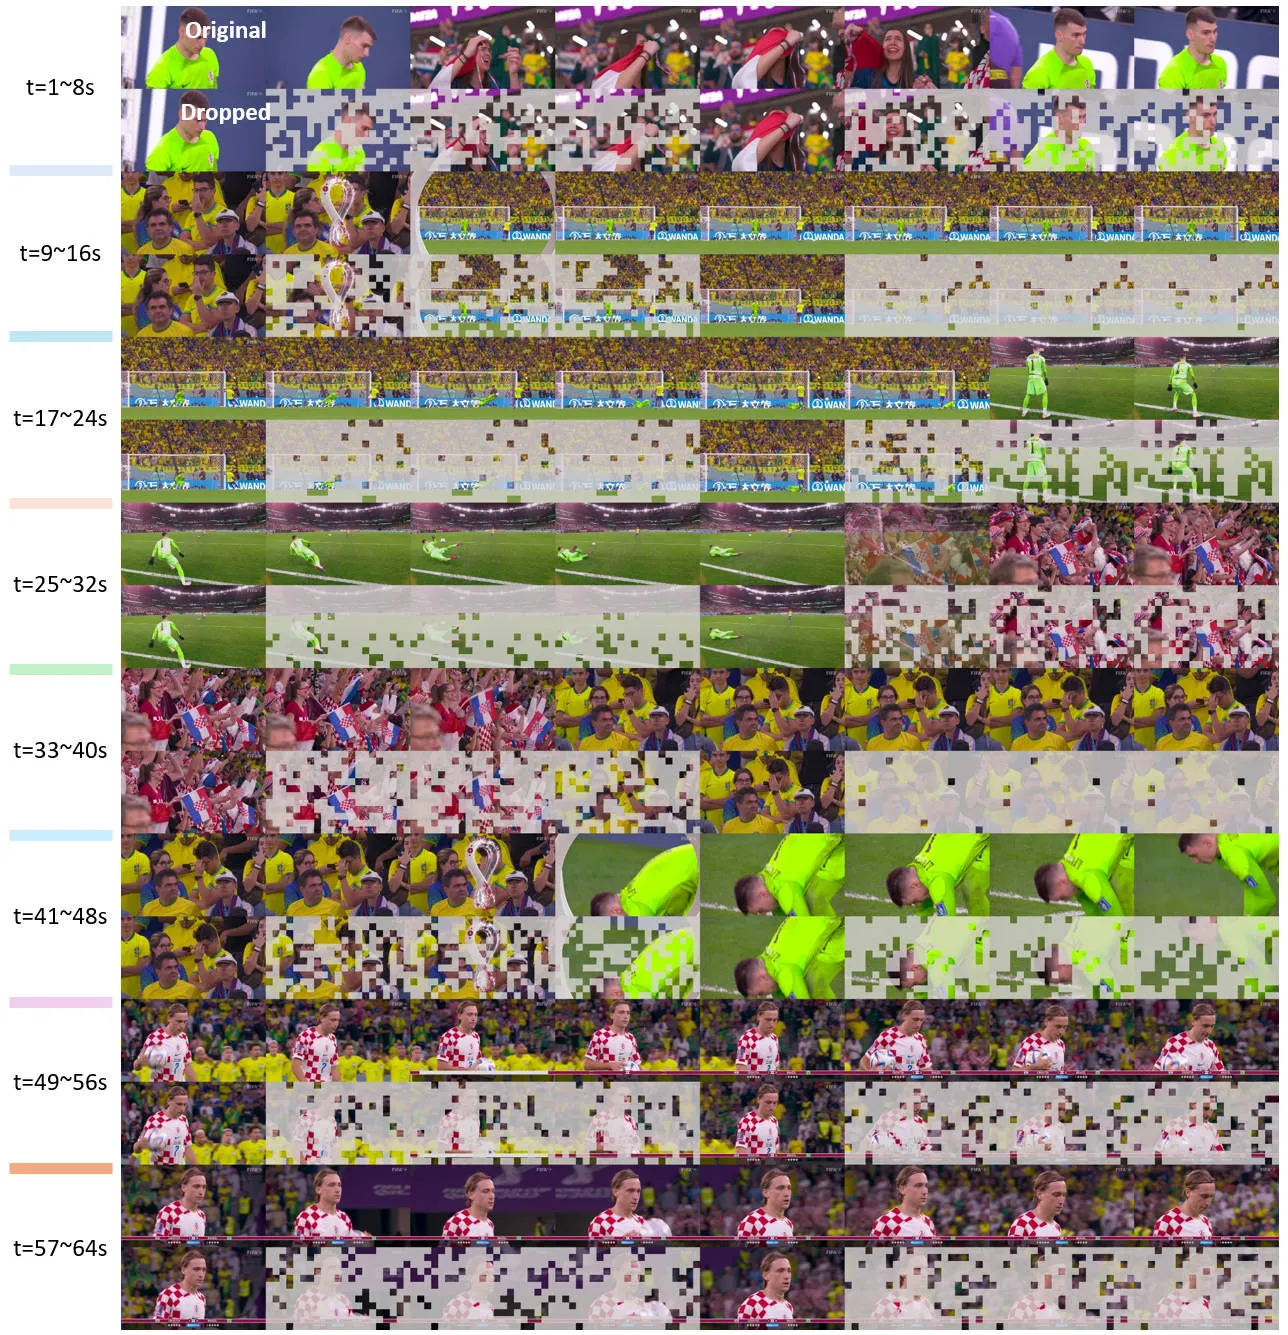 图 7:StreamingBench 上 chunk 内时间 token 裁剪的可视化。白色区域表示被裁剪的视觉 token。
七、相关工作
7.1 流式 VideoLLM 方法
| 方法 | 类型 | 特点 |
|---|---|---|
| 延迟流式 | 积累-查询 | 简单但延迟随流长度增长 |
| 连续流式 | 增量处理 | 需要协调多阶段 |
| ViCoStream | 阶段式协调 | 统一优化吞吐量和延迟 |
7.2 视觉 Token 优化
| 方法 | 技术 | 特点 |
|---|---|---|
| Token Merging | 空间合并 | 减少 token 数量 |
| StreamingToM | 时间裁剪 | 流式 token 压缩 |
| ViCoStream | 空间+时间 | 组合优化 |
八、总结
8.1 核心贡献
- 阶段式协调流水线:将流式推理分解为 4 个阶段,识别瓶颈迁移
- ViCoStream 框架:组合 chunk-wise 执行、CUDA stream 重叠、token 控制和有界注意力
- 瓶颈分析:系统研究 chunk 大小、token 保留率、注意力局部性和检索范围的影响
- 高性能实现:134 FPS 吞吐量 + <50ms TTFT,保持竞争性准确率
8.2 技术影响
- 实时视频理解:支持长时间视频流的实时问答
- 资源效率:单 GPU 即可处理 100+ FPS 视频流
- 系统设计:为流式 VideoLLM 提供统一的分析框架
- 实用部署:适用于监控、直播等实时应用场景
8.3 局限性
- 资源受限并行:假设每阶段处理一个 chunk,未考虑多副本或异构加速器
- 准确率-延迟权衡:某些任务对压缩视觉历史敏感
- 训练依赖:需要流式数据微调以适应有界注意力
九、参考资源
9.1 论文链接
- arXiv: https://arxiv.org/abs/2606.19849
- PDF: https://arxiv.org/pdf/2606.19849
- 代码: https://github.com/EIT-NLP/ViCoStream
9.2 关键图表
| 图表 | 说明 | 路径 |
|---|---|---|
| 图 1 | 内存与延迟缩放 | figure-1-memory-latency-scaling.png |
| 图 2 | 架构概览 | figure-2-overview-pipeline.png |
| 图 3 | Token 裁剪 vs 准确率 | figure-3-token-drop-accuracy.png |
| 图 4 | 预填充延迟稳定性 | figure-4-prefill-latency-stability.png |
| 图 5 | 延迟-准确率权衡 | figure-5-latency-accuracy-bounded.png |
| 图 7 | Token 裁剪可视化 | figure-7-token-drop-visualization.jpg |


9.3 相关论文
| 论文 | 作者 | 年份 | 关系 |
|---|---|---|---|
| VideoLLM-Online | Chen et al. | 2024 | 连续流式 VideoLLM |
| Flash-VStream | Zhang et al. | 2024 | 快速流式视频理解 |
| LLaVA-Video | Zhang et al. | 2024 | 视频-语言预训练 |
| Qwen2.5-VL | Qwen Team | 2024 | 基座视觉语言模型 |
9.4 关键技术术语
| 术语 | 英文 | 说明 |
|---|---|---|
| 流式 VideoLLM | Streaming VideoLLM | 持续处理视频流的 VideoLLM |
| 阶段式协调 | Stage-Wise Coordination | 多阶段流水线优化 |
| Token 裁剪 | Token Dropping | 移除冗余视觉 token |
| 有界视觉注意力 | Bounded Visual Attention | 限制可视视觉历史大小 |
| 时间到首个 token | Time to First Token (TTFT) | 查询响应延迟 |
| Chunk-wise 执行 | Chunk-wise Execution | 将视频分割为 chunks 处理 |
分析完成时间:2026年6月22日 分析工具:Claude Code + paper-analyzer skill