RouteBalance: Fused Model Routing and Load Balancing for Heterogeneous LLM Serving
针对异构 LLM 服务栈的两层调度割裂(router 忽略实例负载,load balancer 忽略质量)问题,将模型路由与负载均衡融合为对具体模型实例的在线赋值。对每批请求求解 quality-latency-cost 三维单纯形加权得分:batched MiniLM+KNN 一次估算 prompt 内在的 quality/output-length,per-tier XGBoost TPOT + dead-reckoning 在线估计延迟,按 LPT 顺序贪心分派。在 13 实例 28 GPU 异构集群、四种模型规模上,单套栈只调权重就能横跨 quality-cost-throughput 前沿;平衡预设在 2.8 s 端到端延迟与 30 req/s 下领先增强版 BEST-Route 2.6-4.1×,最高质量 DeepEval 0.419(+0.013 优于最强基线)。
RouteBalance: Fused Model Routing and Load Balancing for Heterogeneous LLM Serving
一、论文概述
| 项目 | 内容 |
|---|---|
| 论文标题 | RouteBalance: Fused Model Routing and Load Balancing for Heterogeneous LLM Serving |
| 作者 | Wei Da, Evangelia Kalyvianaki |
| 提交日期 | 2026-06-16 |
| arXiv ID | 2606.17949 |
| 学科分类 | cs.DC |
二、核心思想
问题定义
异构 LLM 服务集群通常把大模型放在高端 GPU、小模型放在便宜 GPU,追求 cost/latency/quality 三维平衡。现有系统把调度拆成两层,各自独立优化:
- Model router(Avengers-Pro、BEST-Route、RouteLLM)从 quality 与 cost 信号选模型,忽略实例负载。
- Serving load balancer(vLLM 内部调度)优化实例队列,忽略质量差异。
作者在 13 实例集群上量化了脱耦的代价:quality-only router 在 arrival rate 从少量 req/s 涨到 30 req/s 时,均端到端延迟从 2.3 s 飙升到 60+ s(把流量全塞到几个高质量副本);纯 load-only balancer 则损失 0.04-0.05 DeepEval quality。两层都无法单独占据 trade-off 前沿的好区间。
解决方案概述
提出 RouteBalance:服务感知的调度层,把 routing 与 load balancing 融合为一次在线赋值,直接分配请求到具体的模型实例(而非模型名)。在 3-simplex 上加权评分,可以通过一个权重向量在同一部署栈中扫过 Quality / Latency / Cost 各命名操作点。
三、技术架构/方法
系统架构
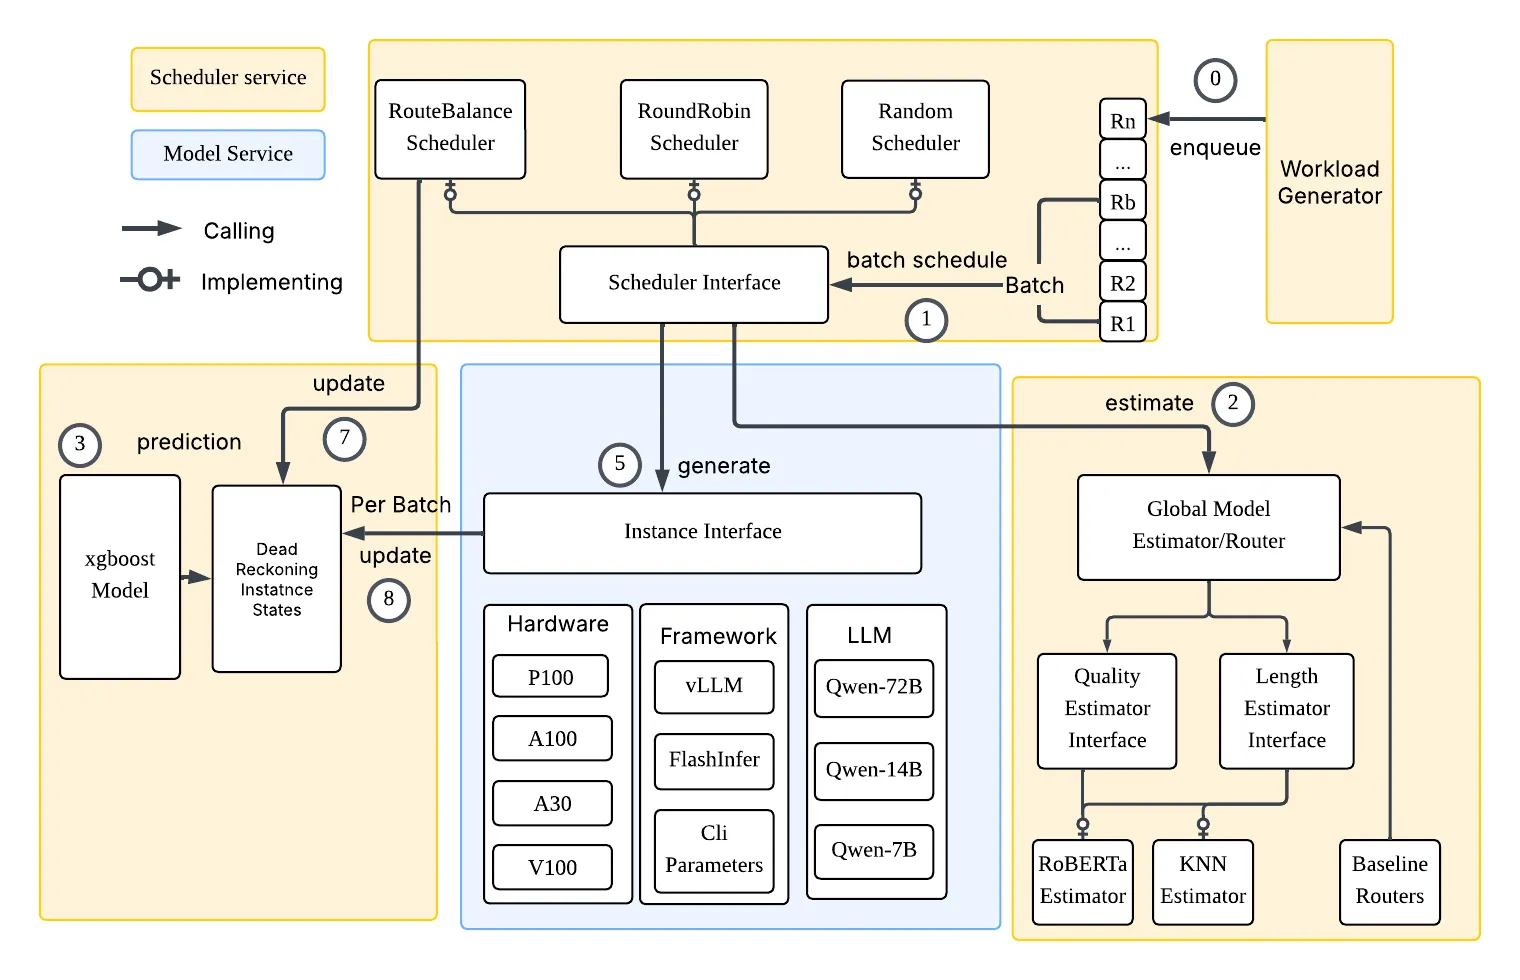
RouteBalance 位于客户端与异构 serving cluster 之间。运行时组件:batched predictor stack(in-process)+ dead-reckoned instance state。整体决策成本约 32 ms(12 req/s)。
批调度与贪心 LPT 分配
批调度器每次触发时,把等待中的请求聚为一批 ,在下批开始前把每个请求分配到实例。四大属性:
- Predictors 每批只跑一次(成本摊薄)。
- 批内 scoring 用批内最大值归一化 latency/cost。
- 每次批内 dispatch 更新本地实例视图,避免 herding。
- 按预测输出长度 LPT 排序(Graham 的 4/3 makespan 保证)。
贪心目标(每步最大化):
约束 。Cost 与 latency 用批内最大值归一化,使得 更便宜的候选按比例贡献而不是被裁为 0/1。
复杂度 。作者用 offline replay 验证:与 Hungarian 匹配的分配差异 15.6%,但实测质量差 −0.002,可忽略。
估算器(Estimators)
- Quality/length(prompt 内在,per-batch 一次):CPU 上 all-MiniLM-L6-v2 encoder 对 batch 内所有 prompt 一次 embedding;FAISS KNN()查询 14,919-prompt 训练集索引,返回每个候选模型的预测质量与预期输出长度。Quality 标签用 DeepEval G-Eval 离线对齐(judge = Llama-3.1-8B-Instruct,位于 Qwen 池之外)。
- Latency(state-dependent,per-dispatch dead-reckoning):每个 (model, GPU) tier 一个 XGBoost TPOT head,从该 tier head-node 的 QPS sweep 训练;分派时并行查询所有 tier head。端到端延迟解析式估算:
其中 为待 decode token 数, 为当前 decode batch 大小。
- 成本: embeddings + 向量化 scoring;scoring-loop 在 分别为 12.8 / 14.3 / 22.5 µs。
Adaptive batching + vanishing batch bubble
自适应 batch 大小:忙时更大(更多摊薄),闲时更小。附加等待建模:
饱和时 被 吸收(反正要排队),轻载时 batch 小, 本身就小。这使 batch bubble 在真正会 hurt 的时候消失。
四、核心创新
| 创新点 | 描述 | 效果 |
|---|---|---|
| 融合 routing + load balancing | 单次在线赋值直接选具体模型实例(而非模型名) | 单栈横跨 3D 前沿 |
| 3-simplex 加权评分 | ,按 batch max 归一化 | 权重可平滑地在命名操作点间切换 |
| Batched MiniLM+KNN 质量估算 | Prompt 内在信号 per-batch 一次估 | 与 online 每 request 打分相比避免 collapse |
| Per-tier XGBoost TPOT + dead-reckoning | State-dependent latency 无需 kernel simulator | 前向兼容 vLLM engine 升级 |
| LPT 贪心分派 | 4/3 makespan guarantee,$O( | R_B |
| Vanishing batch bubble | 自适应 batch size 让附加等待在饱和/闲载都收敛 | 5× 负载增长仅 1.8× 决策 residual |
五、实验结果
实验设置
- 集群:13 实例、28 GPU、四种 Qwen2.5 模型(含 72B、14B 用 TP=4)。
- Harness:vLLM serving-benchmark;泊松到达 rate req/s。
- 数据集:18,608 prompts,来自 7 个公开数据集;每 prompt 对 4 个 Qwen2.5 候选广播;14,919 train / 3,634 test。
- 质量标签:DeepEval G-Eval,judge Llama-3.1-8B-Instruct。
- 基线:Avengers-Pro()、BEST-Route()、passthrough router、vLLM Semantic-Router。每种搭配 round-robin/shortest-queue 分派。
- 规模:442 configurations,约 1.5M requests。
主要结果
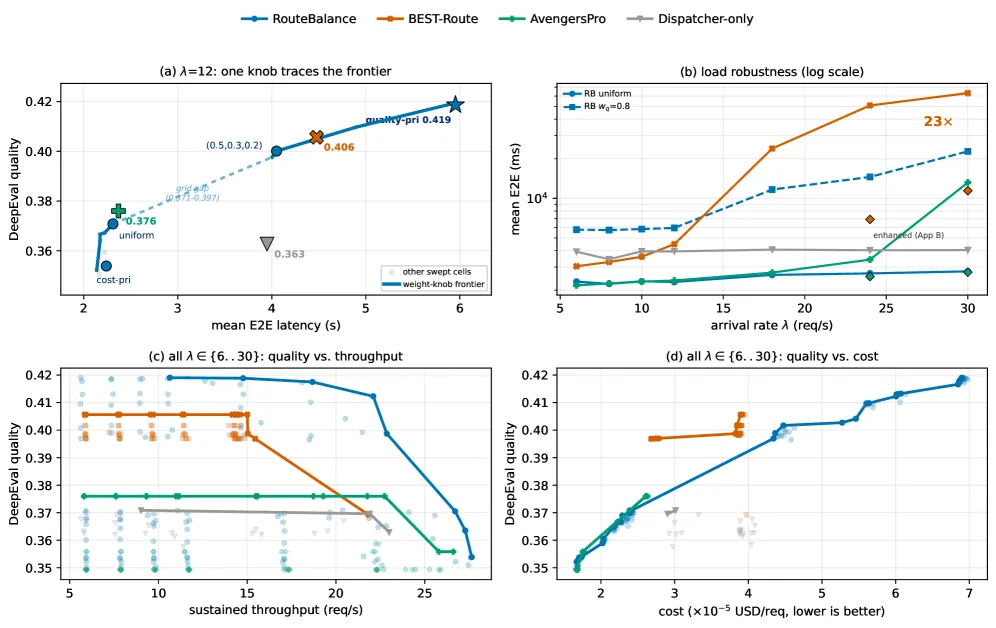
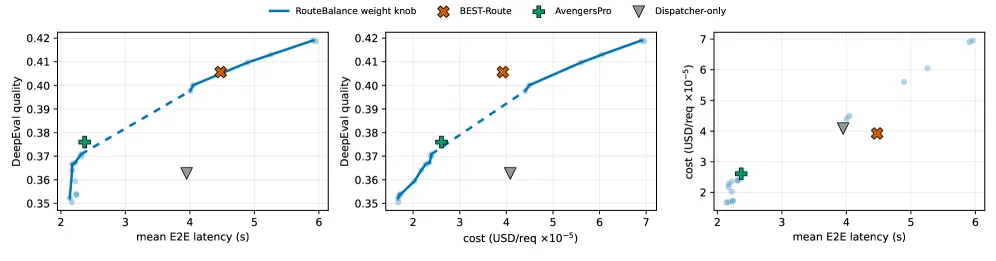
Quality–Latency 前沿():仅调整权重向量,RouteBalance 单调扫过:
- Cost-priority 预设:2.2 s,quality 0.354
- Uniform:2.3 s,0.371
- Mid-band:4.1 s,0.397
- 上限:5.9 s,0.419(+0.013 优于最强 BEST-Route 0.406,+0.043 优于 Avengers-Pro 0.376)
- 差距通过 per-prompt bootstrap 显著(95% CI )
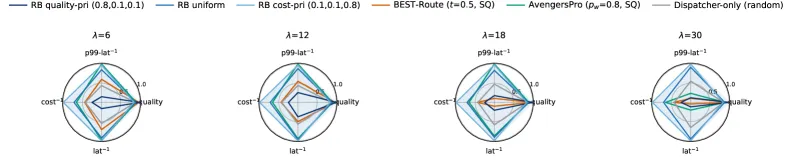
Load robustness:Router engineering 均衡化后(concurrent scoring 变体),RouteBalance uniform 预设在整个 扫描中保持 2.3–2.8 s:
- –30 领先增强版 BEST-Route 2.6–4.1×(后者 6.9 / 11.4 s)。
- 若把 BEST-Route 按 published 部署(每 prompt 一次序列打分), 时 collapse 到 63 s(23× uniform 的 2.8 s)。
- 吞吐上限:RouteBalance 27.6 req/s vs BEST-Route 21.8 req/s。
- 最低服务成本: USD(与 Avengers-Pro 并列最低),BEST-Route 最便宜仅到 。
调度开销
- Per-request off-instance residual: 时 129 ms → 时 231 ms(5× 负载增长仅 1.8× residual)。
- MiniLM+KNN 决策 ≈ 27 ms,且随 load 下降(32.3 → 28.2 ms)通过 intra-batch 摊薄。
- 对比基线:BEST-Route residual 在 达 57.9 s(router queue 饱和)。
消融实验
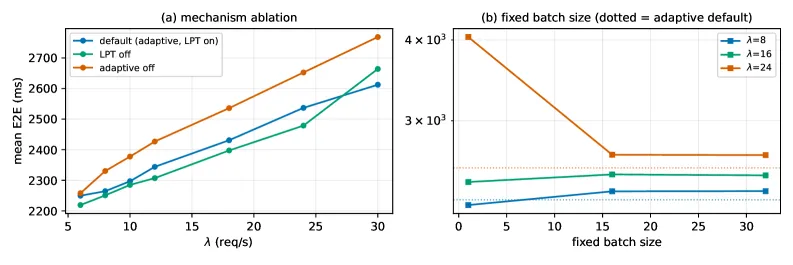
- LPT-off 与 adaptive-off 在高 下端到端明显退化。
- 固定 batch size 扫描显示 adaptive sizing 的必要性。
部署阶梯(Deployment Ladder)分离
| 部署方式 | 表现 |
|---|---|
| (i) Serial scoring(BEST-Route shipped) | 49.5–64.2 s collapse |
| (ii) Micro-batched co-located | 214 / 238 s (98% router queueing) |
| (iii) vLLM-SR external CPU service | 起 collapse |
| (iv) Enhanced concurrent scoring | 6.9 / 11.4 s(仍慢 2.6-4.1×) |
作者以此证明 BEST-Route 的 collapse 不仅是部署 artifact,policy 层面也有本质差距。
六、总结
核心贡献
- 首次把 model routing 与 serving load balancing 融合到单一在线赋值,实例级而非模型级决策。
- 提出 3-simplex 加权 scoring ,让单套部署栈只调权重就能穿越 quality-cost-throughput 前沿。
- 通过 prompt-intrinsic vs state-dependent 的信号分离,实现 per-batch amortization + per-dispatch dead-reckoning。
- 用 LPT 贪心 + adaptive batching 让 batch bubble 在饱和/闲载都收敛。
- 大规模评测(442 配置、~1.5M 请求)与 engineering-equalized 基线对比:quality 上限 0.419(+0.013),高负载领先 2.6–4.1×。
技术影响
- 把”router-then-balancer”的分层假设打破,证明在 model selection 时刻 pricing latency 是关键收益源。
- 释放数据集(18,608 prompts、predictor)与代码,便于 artifact evaluation 与后续研究。
局限性
- 目前只在 Qwen2.5 家族与固定拓扑上验证;作者提到下一步移植 Llama/Gemma。
- 依赖泊松/gamma 到达模型,需要在生产 trace 上验证。
- SLO-driven 自动调整权重的控制器仍是 open direction。
七、参考资源
- arXiv: https://arxiv.org/abs/2606.17949
- HTML 全文:https://arxiv.org/html/2606.17949v1
- 相关系统:Avengers-Pro、BEST-Route、RouteLLM、vLLM Semantic-Router、INFaaS、Cocktail、Tabi
- 基线依赖:DeepEval G-Eval、Llama-3.1-8B-Instruct judge、FAISS KNN、all-MiniLM-L6-v2、XGBoost