LUMEN: Coordinated Failure Recovery for Distributed LLM Serving
针对分布式 LLM 服务中 worker 故障同时丢失 KV cache 与服务容量的问题,提出以负载感知协调决策来做故障恢复的 LUMEN。三大机制:负载感知 KV checkpointing(用 $h(r)=\arg\min_w(q_w+\lambda p_w(r))$ 把 checkpoint 分散到低负载 worker)、局部性感知恢复调度(先按 checkpoint holder 路由再按 average-based 规则重平衡)、投机辅助渐进恢复(在恢复 worker 上加载 draft model,通过 fused batch 单次前向验证辅助最拥堵的存活 worker)。SGLang 原型上,Qwen3-32B/14B 相比 Stop-and-Restart 降低 TTFT 44.4%/29.6%、recovery time 50.0%/64.1%;大规模模拟中在 64 worker、25% 故障率下仍有 46.8-51.2% TTFT 降幅。
LUMEN: Coordinated Failure Recovery for Distributed LLM Serving
一、论文概述
| 项目 | 内容 |
|---|---|
| 论文标题 | LUMEN: Coordinated Failure Recovery for Distributed LLM Serving |
| 作者 | Zhang Cao, Shujie Han, Juncheng Zhang, Yuanming Ren, Yongkun Li, Patrick P. C. Lee |
| 提交日期 | 2026-06-16 |
| arXiv ID | 2606.17787 |
| 学科分类 | cs.DC |
| 原型基线 | SGLang + Vidur simulator |
二、核心思想
问题定义
现代 LLM 服务将模型副本分布在 10000+ GPU 集群上,每副本由一个 worker 进程管理。生产 trace 显示每天多次硬件事件,LLM serving 平均每几小时遇一次故障。当 worker 崩溃时,同时丢失两样东西:GPU 上的 KV cache 与 服务容量。存活 worker 既要吸收被中断请求的重跑,又要承担被重定向的常规流量。
现有方案有两类:
- Stop-and-Restart(KServe、TGI、Triton、vLLM/k8s 默认):重跑被中断请求。作者测得单 worker 故障下 TTFT 增加 4.0×、TPOT 增加 1.6×(4-64 worker 均存在)。
- Fixed-Checkpointing(DéjàVu):把每个请求的 KV 流式检查点到静态邻居 worker。避免重跑,但 checkpoint holder 不管当前负载,恢复流量易集中在忙 worker;且恢复期间 recovering worker 空闲等待 model reload。

解决方案概述
将故障恢复形式化为负载感知协调问题,围绕三个决策点:
- 失效前 checkpoint 放在哪
- 失效时被中断请求路由到哪
- model reload 期间如何利用 recovering worker
对应三大机制:load-aware KV checkpointing + locality-aware recovery scheduling + speculation-assisted progressive recovery。
三、技术架构/方法
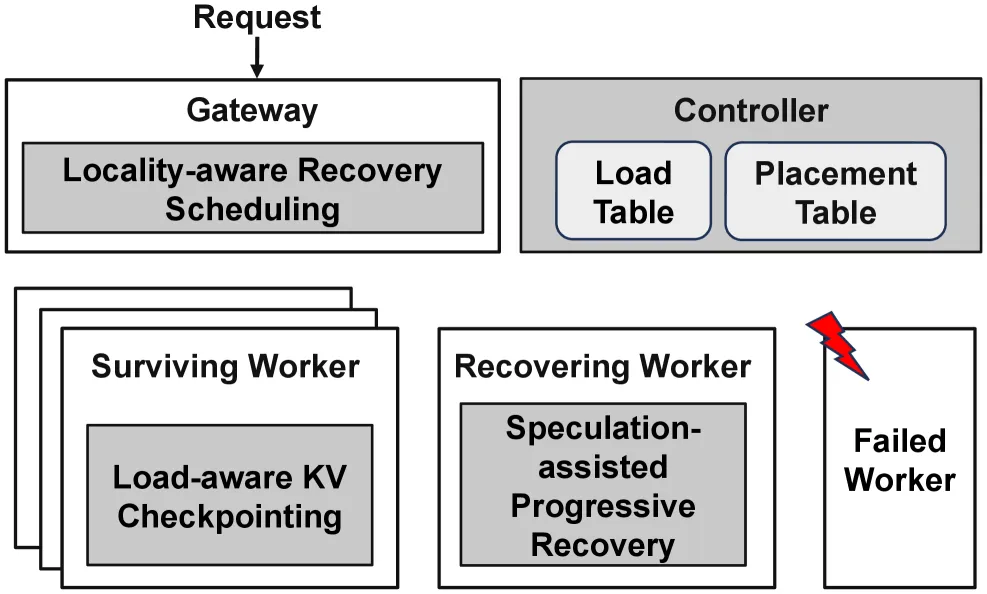
LUMEN 在现有 SGLang 上增强 gateway(保留每 in-flight 请求的完整 token 历史:prompt + 累积 output token ID),并引入中心 controller,维护:
- Load table:per-worker 队列/容量信号(三项:可用 checkpoint-store 容量、queueing delay、reserved KV checkpoint footprint)
- Placement table:每请求 → checkpoint holder 映射
Controller 事件驱动更新(避免轮询),仅交换轻量元数据(request ID、capacity、queueing delay),大 KV 页直接 worker-to-worker peer 传输,绕过 controller。
4.2 Load-aware KV Checkpointing
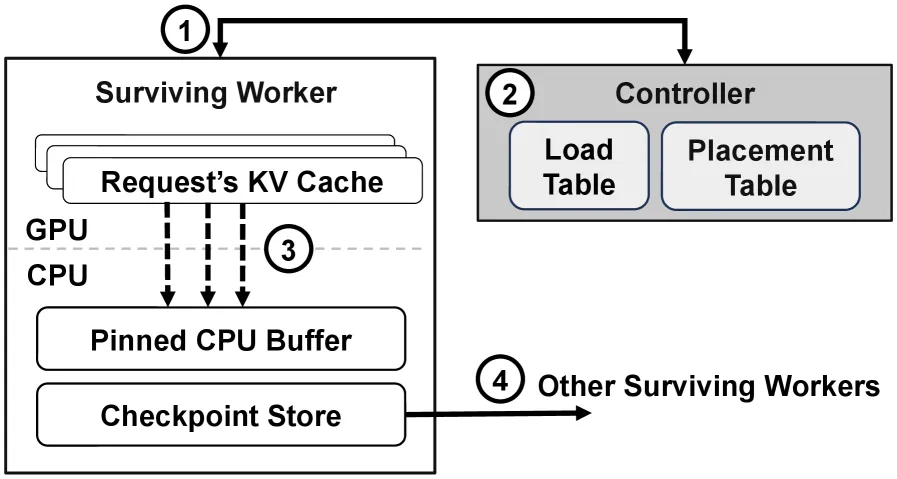
每请求指定唯一 checkpoint holder,需满足其可用 host memory ≥ 请求的 reserved KV footprint(按 max context length 保守估计)。
对每个候选 worker ,两个指标:
- :worker 上从到达到 prefill 启动的平均等待
- :请求 分配到 后的期望 KV restore 延迟 = 上已持有 checkpoint 的平均 reserved footprint / host-to-GPU 带宽
Checkpoint holder 选择:
为除当前服务 worker 之外的候选集(保证单 worker 故障不同时丢失活跃 KV 与 checkpoint)。 默认 1。
Host memory 预算:Qwen3-14B 每 worker 80 GB,Qwen3-32B 160 GB(与 DéjàVu 相同)。选定 后 KV page 持续 streaming 直至请求终止。非对称策略:主动把未来恢复负载导向空闲更多的 worker。
4.3 Locality-aware Recovery Scheduling
失效检测后:
- Recovery dispatch:controller 先把每个被中断请求 routed 到其 checkpoint holder(最大化 KV 复用)。若 holder 也失效,标记 recomputation → 最闲存活 worker。
- Load rebalancing:按 average-based request-count rule 找出超均值的 checkpoint holder,从其”最小实际 checkpoint 前缀”的请求开始迁移(重启开销最小)到最闲 worker。迭代直到无 worker 超过 cluster 均值。
- KV-reuse recovery:holder 从请求 token 历史确定性重建 page tag,找出 local store 中最长连续 checkpoint 前缀,加载至 GPU;若前缀不完整,对未 checkpoint 后缀做 partial prefill,然后恢复自回归 decode。
4.4 Speculation-assisted Progressive Recovery
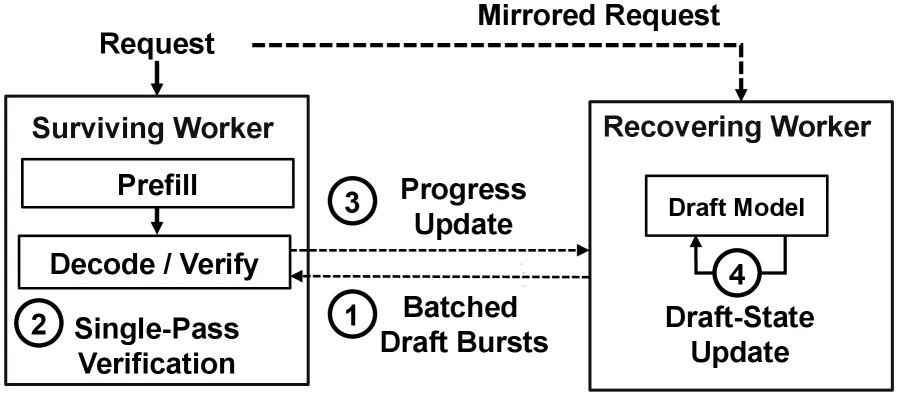
Recovering worker 走四态:LOADING_DRAFT → ASSIST → HOTSWAP → FULL_SERVICE。
- Draft-worker pairing:进入 ASSIST 后与 queueing delay 最高的存活 worker 一对一配对,让所有 draft token 汇入一个 batch 摊薄验证开销。配对 worker 对每个 in-flight 请求发送 mirror request(token 复制,仅供 draft 参考不产生 user output)。
- Single-pass verification:不再一 iteration 两次前向。构造统一形状 position 的 fused batch:第 1 位是最近 committed token,后 位是 draft token(辅助请求)或 placeholder(未辅助请求)。整个 batch 一次 CUDA graph 前向;未辅助请求只用第 1 位输出,placeholder 输出丢弃。辅助请求走标准 speculative decoding(Leviathan et al.),接受最长有效前缀。
- Draft-state alignment:每 decode step 后配对 worker 发 progress update(新 committed tokens + mirror request output 长度);recovering worker 按 sequence position 对齐 draft KV,从首个不匹配位置起截断并 replay。
- Background loading & final switch:ASSIST 期间后台把 target-model weights 加载到 host memory,隐藏磁盘 I/O;HOTSWAP 只做 host-to-GPU 传输。
四、核心创新
| 创新点 | 描述 | 效果 |
|---|---|---|
| 负载感知 KV checkpoint 放置 | ,非对称分散到低负载 worker | 避免 fixed neighbor 造成的恢复热点 |
| Reserved KV footprint 预算 | 按 max context length 保守预留,防 host memory 用尽 | 恒定 steady-state 内存开销 |
| Locality-first + average-based rebalancing | 先按 holder 路由再从”小 checkpoint 前缀”起卸载 | 最小化 recomputation 损失 |
| Speculation-assisted 渐进恢复 | Draft model 加载到 recovering worker,辅助最拥堵存活 worker | Reload 期间不再空闲 |
| Fused-batch single-pass verification | 统一形状 + placeholder,一 CUDA graph 完成辅助与非辅助请求 | 避免两次前向的验证开销 |
| Background target-model load + HOTSWAP | 磁盘 I/O 与 ASSIST 重叠 | 只留 host-to-GPU 到 critical path |
五、实验结果
实验设置
- 原型:SGLang,四 worker(Qwen3-32B)与八 worker(Qwen3-14B)。
- 模拟器:基于 Vidur,扩展到 64 worker。
- 基线:Stop-and-Restart、Fixed-Checkpointing (DéjàVu)。
原型端到端结果

| 设置 | vs Stop-and-Restart | vs Fixed-Checkpointing |
|---|---|---|
| 4-worker Qwen3-32B | TTFT −44.4%,TPOT −15.9%,recovery time −50.0% | TTFT −7.1%,TPOT −7.0%,recovery time −34.9% |
| 8-worker Qwen3-14B | TTFT −29.6%,TPOT −7.1%,recovery time −64.1% | TTFT −15.9%,TPOT −4.2%,recovery time −63.9% |
微观分解

模拟器 (64 worker) 关键结论


LUMEN 增益在三种条件下最显著:
- 高故障严重度:原型 1 故障 → 4 故障时 TTFT 相对 SR 从 29.6% → 82.7%;模拟器上 12.2% → 63.6%。
- 高集群负载:近饱和队列下 TTFT 相对 SR 领先 42.7%。
- 成比例大故障率:4-64 worker 固定 25% 故障率,TTFT 稳定低于 SR 46.8-51.2%。
Steady-state 开销:无可测量的 TTFT/TPOT 影响(checkpoint 走 off-GPU critical path)。
六、总结
核心贡献
- 系统性刻画 worker 故障对 LLM serving 的影响:单 worker 故障导致 TTFT 4×、TPOT 1.6× 上升,Fixed-Checkpointing 因静态 holder 导致热点。
- 将恢复问题形式化为负载感知协调,覆盖三个决策点:checkpoint 放置、请求重路由、恢复期容量利用。
- 三大核心机制: 负载感知 checkpoint、average-based 重平衡、fused-batch speculation-assisted 渐进恢复。
- SGLang + Vidur 双实现,最高 TTFT 降 82.7%、recovery time 降 64.1%,无 steady-state 开销。承诺开源。
技术影响
- 首个把”故障恢复”、“负载均衡”、“投机解码”三条独立线索融合的 LLM serving 容错设计。
- 为 10000+ GPU 生产集群提供了实际可落地的低干扰恢复方案。
局限性
- Checkpoint holder 单副本策略:若 holder 与 primary 同时失败,仍需 recompute(虽有 fallback 但增益减少)。
- 当前投机解码只覆盖 K+1 统一形状;变长 K 与多 draft 尚未研究。
- 大规模评测部分在 Vidur 模拟器上,真实网络与硬件故障多样性有限。
七、参考资源
- arXiv: https://arxiv.org/abs/2606.17787
- HTML 全文:https://arxiv.org/html/2606.17787v1
- 相关系统:DéjàVu (Fixed-Checkpointing)、SGLang、Vidur、KServe、TGI、Triton、vLLM
- 相关技术:Speculative decoding (Leviathan et al., 2023; Chen et al., 2023)