CacheWise: Understanding Workloads and Optimizing KVCache Management for Efficiently Serving LLM Coding Agents
首个针对真实编码 Agent(Claude Code)负载的系统研究:会话闭环、上下文持续膨胀、工具触发主导;CacheWise 在 vLLM 上以约 2500 行代码扩展前缀感知调度 + 基于工具元数据的预测式 KVCache 驱逐,评测中 KV 驱逐减少 2–2.6×,session 完成时间最高降低 3.5×,token goodput 提升 1.64–2×。
CacheWise: Understanding Workloads and Optimizing KVCache Management for Efficiently Serving LLM Coding Agents
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | CacheWise: Understanding Workloads and Optimizing KVCache Management for Efficiently Serving LLM Coding Agents |
| 作者 | Shubham Tiwari, Tapan Chugh, Nash Rickert, Simon Peter, Ratul Mahajan, Haiying Shen |
| 发表日期 | 2026-06-15 (arXiv) |
| arXiv | 2606.16824 |
| 分类 | cs.DC, cs.OS |
| 系统名 | CacheWise(基于 vLLM 的 KVCache 管理层) |
| 数据集 | CATraces(真实 Claude Code 会话) |
二、核心思想
问题定义:编码 Agent(如 Claude Code)是一种快速兴起的 LLM 应用,以「LLM 生成 ↔ 外部工具执行」的长时闭环运行。它们与聊天工作负载有本质差异,但既往缺乏真实 trace 与专门的 serving 研究。作者收集 CATraces 并发现:
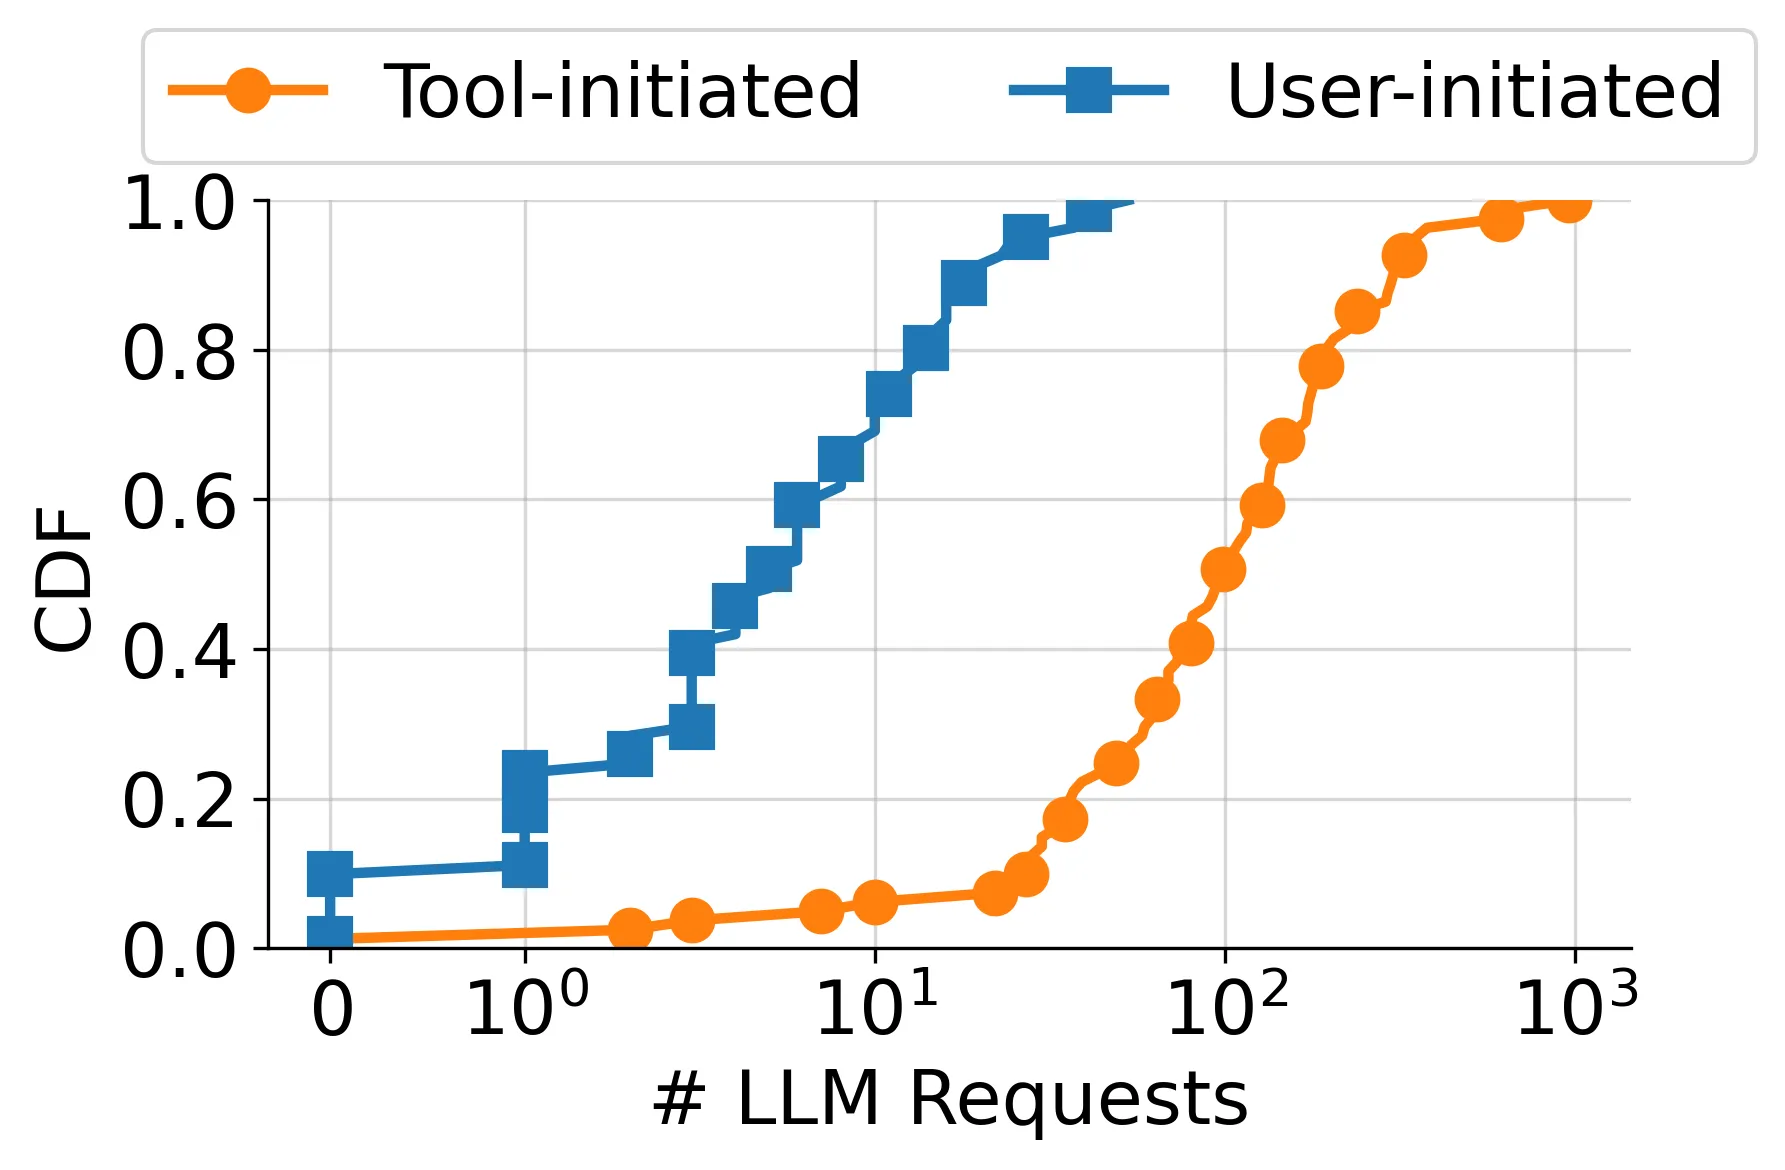
- Closed-loop 会话:绝大部分请求由工具完成触发,而非用户输入。
- 前缀不断膨胀:多轮会话累积巨大共享前缀,反复复用 KVCache。
- 工具时长跨数量级差异:不同工具、不同参数的执行时长差 orders of magnitude。
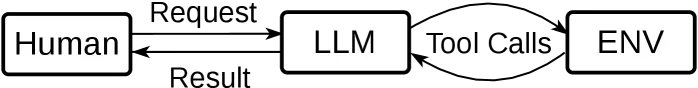
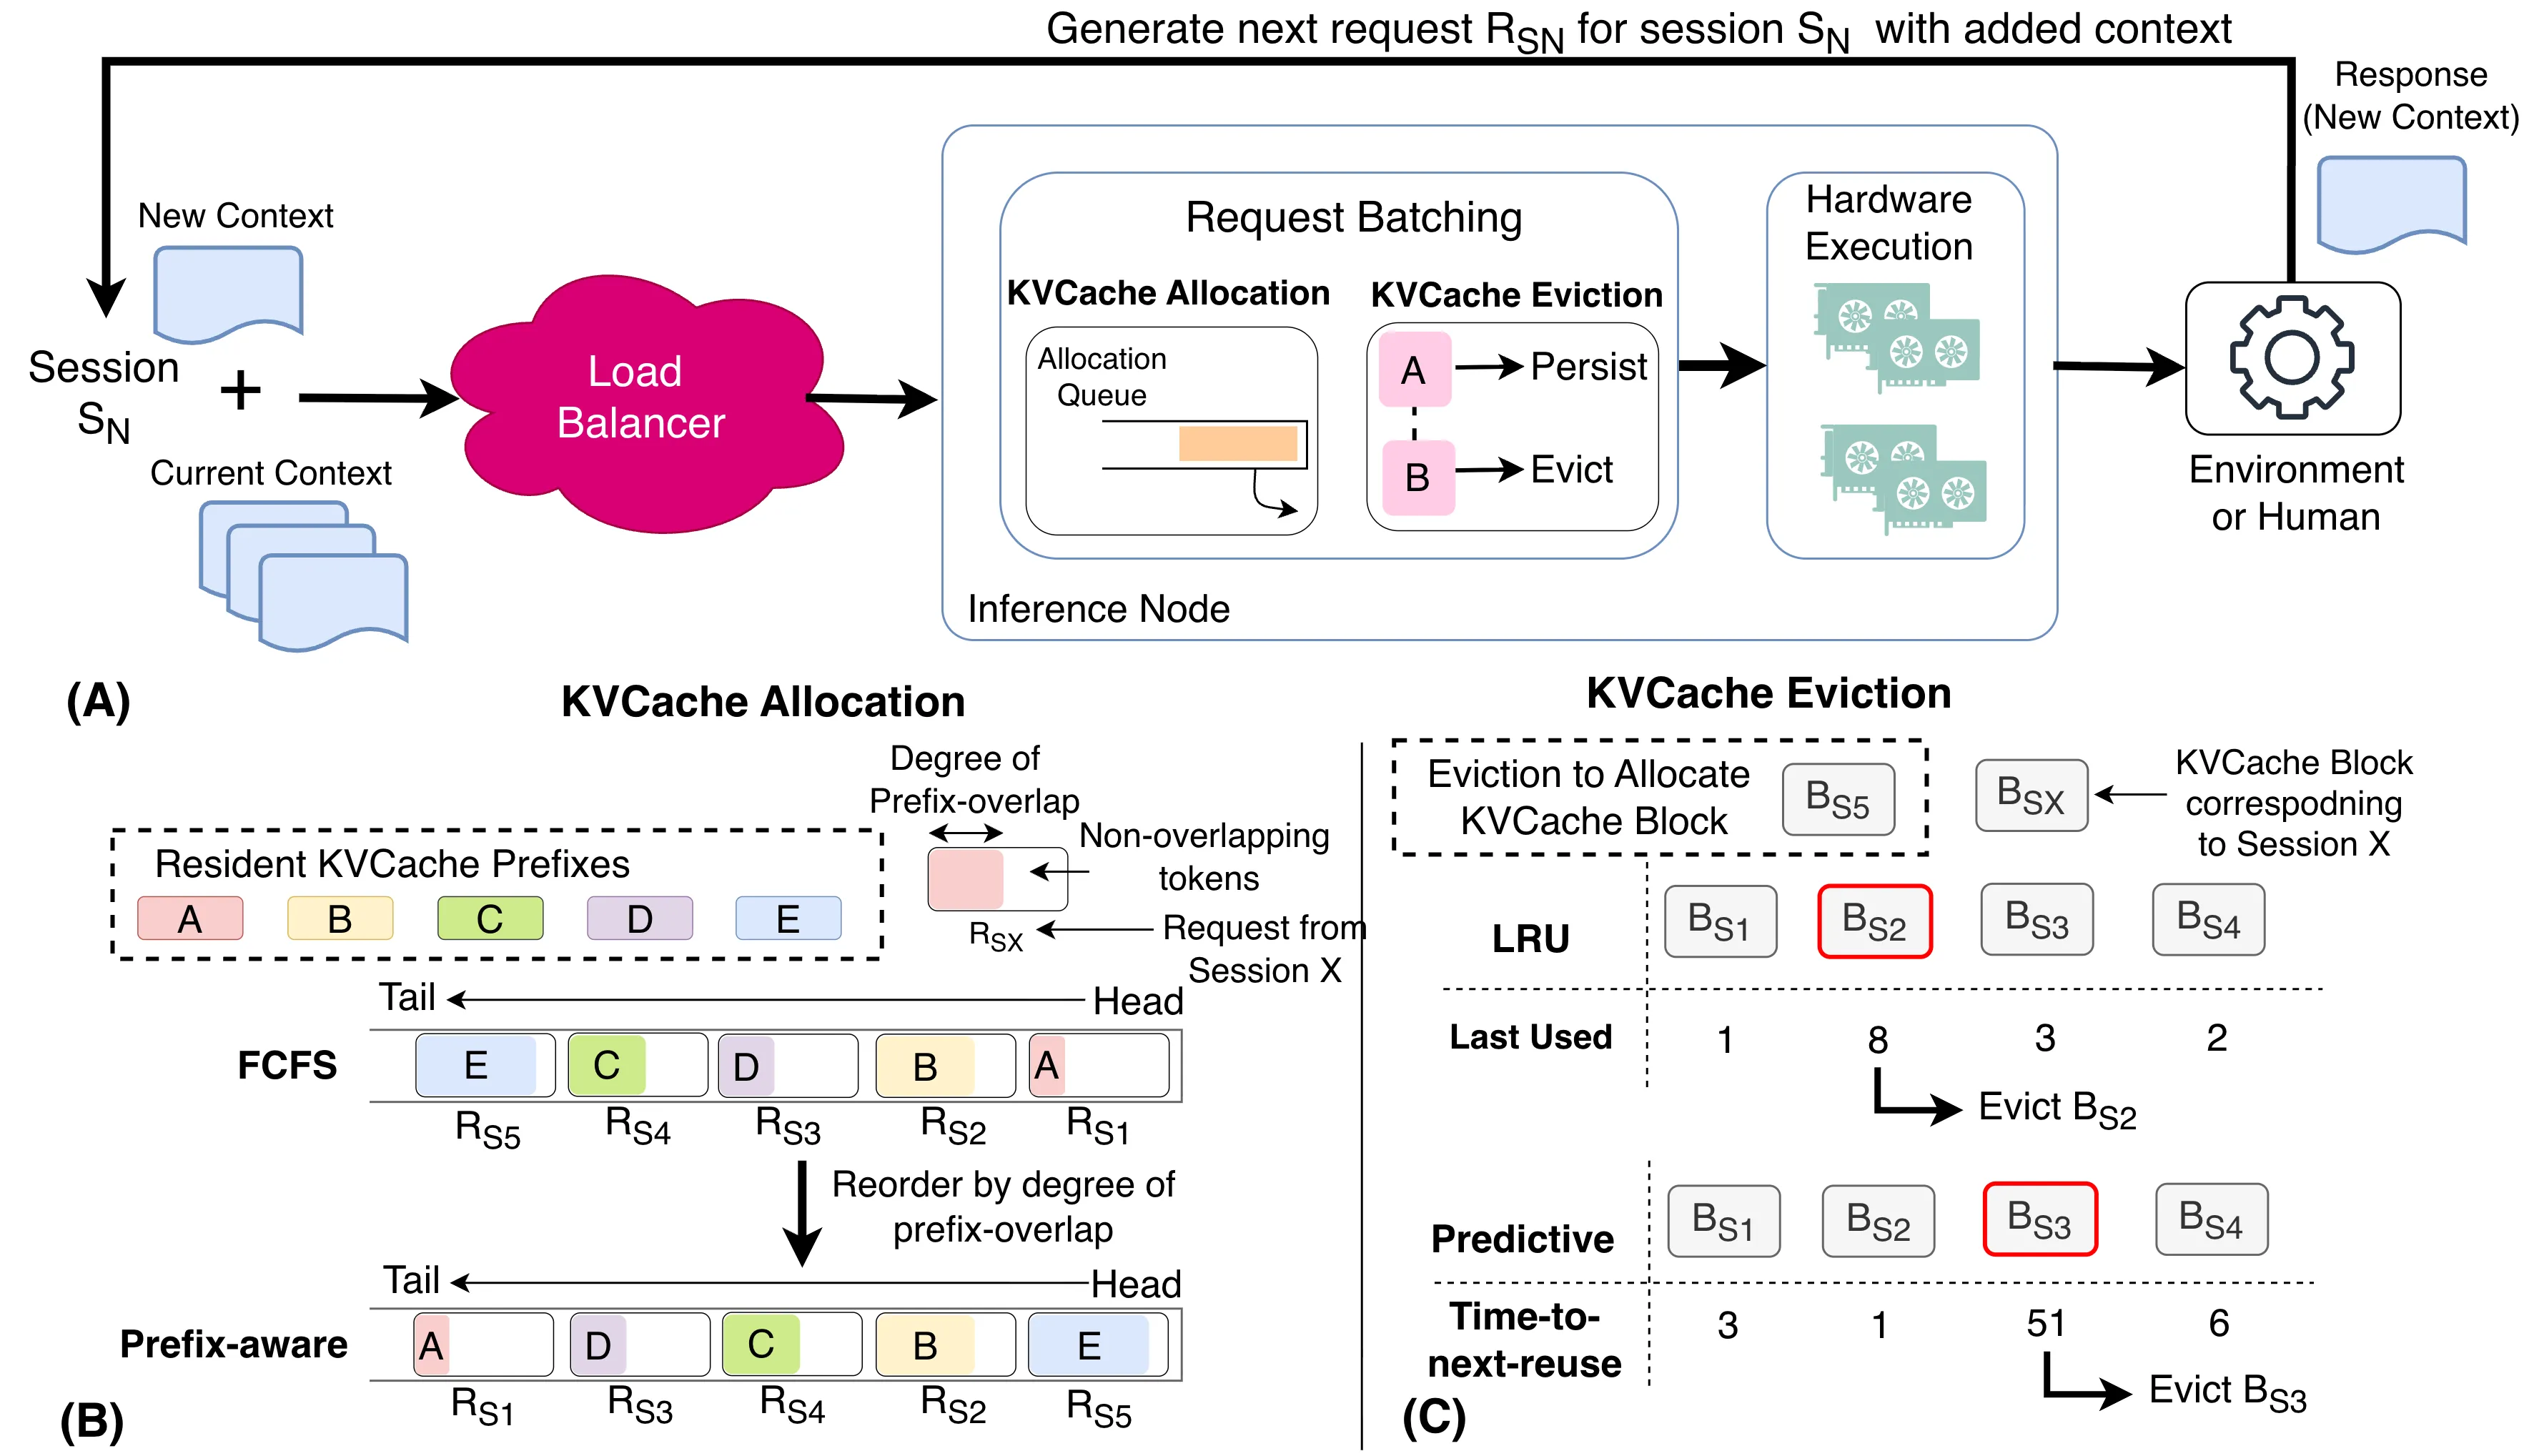
传统 vLLM/SGLang/InferCept 等系统按请求粒度独立调度,采用 LRU 驱逐 + FCFS 准入,未针对 session 级复用与工具时长感知优化,导致 KVCache 频繁抖动。
解决方案:CacheWise 是 vLLM 上的 KVCache 管理层,结合:
- 前缀感知调度(Prefix-aware Scheduling):优先调度 KVCache 常驻多的请求。
- 预测式驱逐(Predictive Eviction):从工具调用元数据估计下一次复用时间,逼近 Belady 最优。
三、技术架构/方法
3.1 工作负载表征(CATraces)
关键观察:
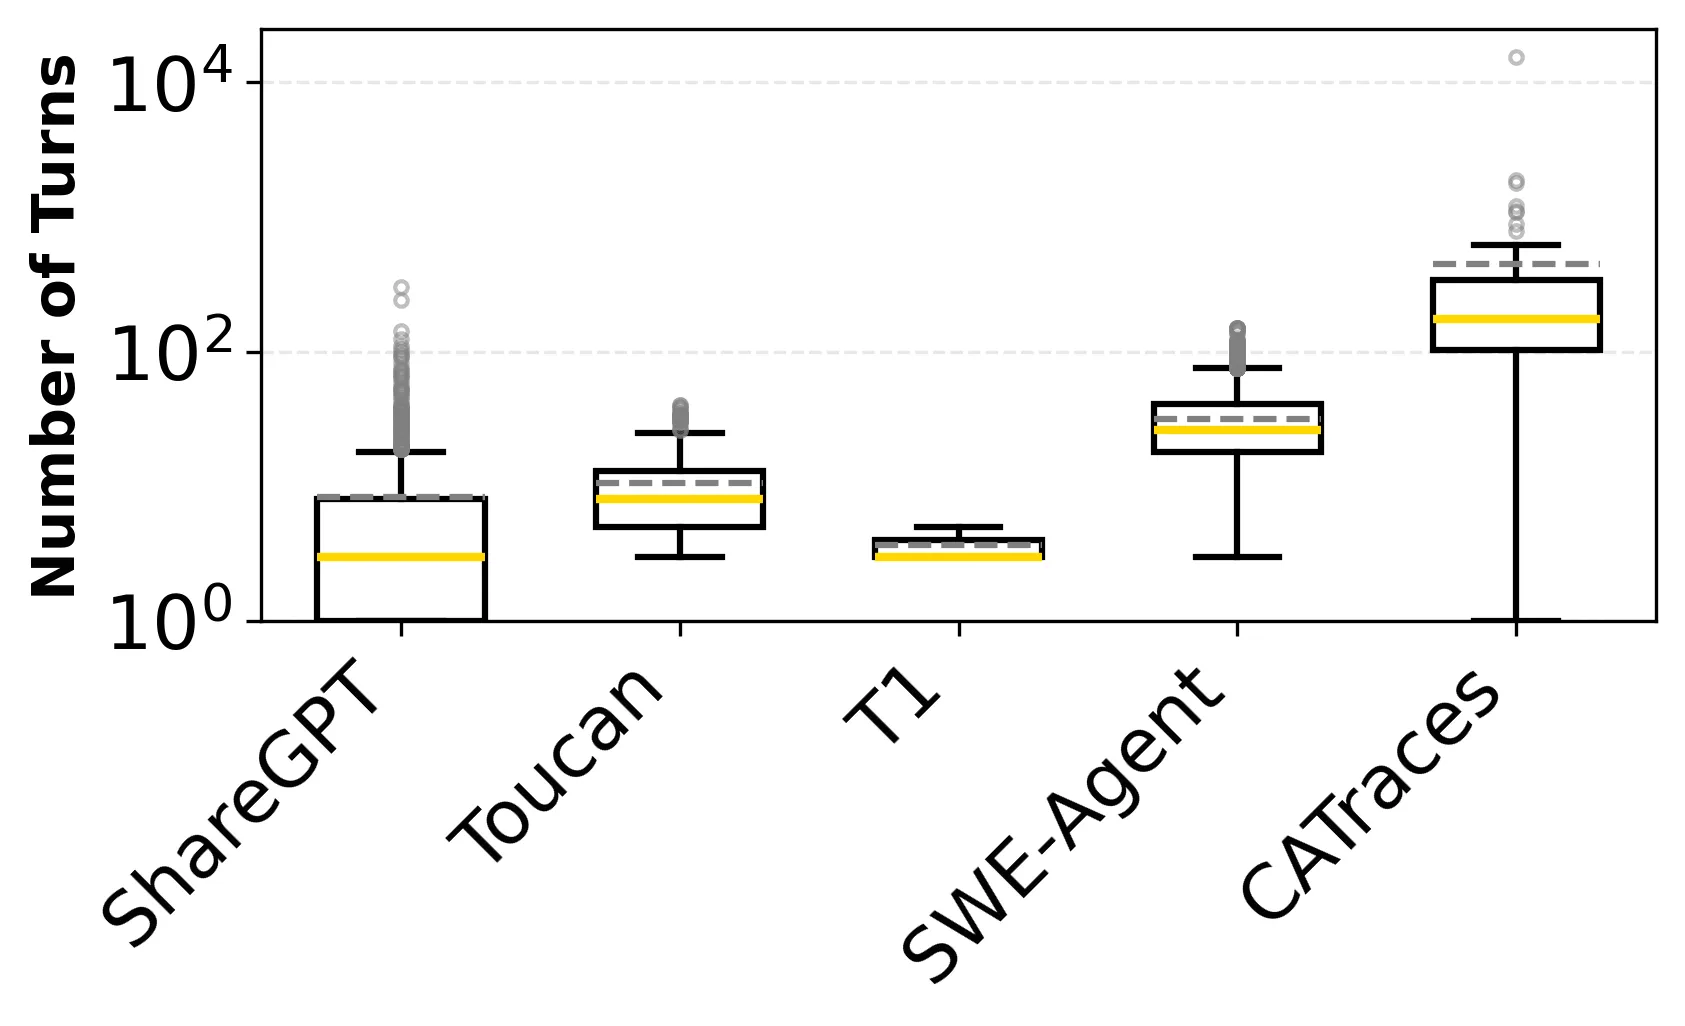
- Coding-agent 会话轮数比 chat 多几个数量级。
- 大部分请求由工具触发而非用户触发:
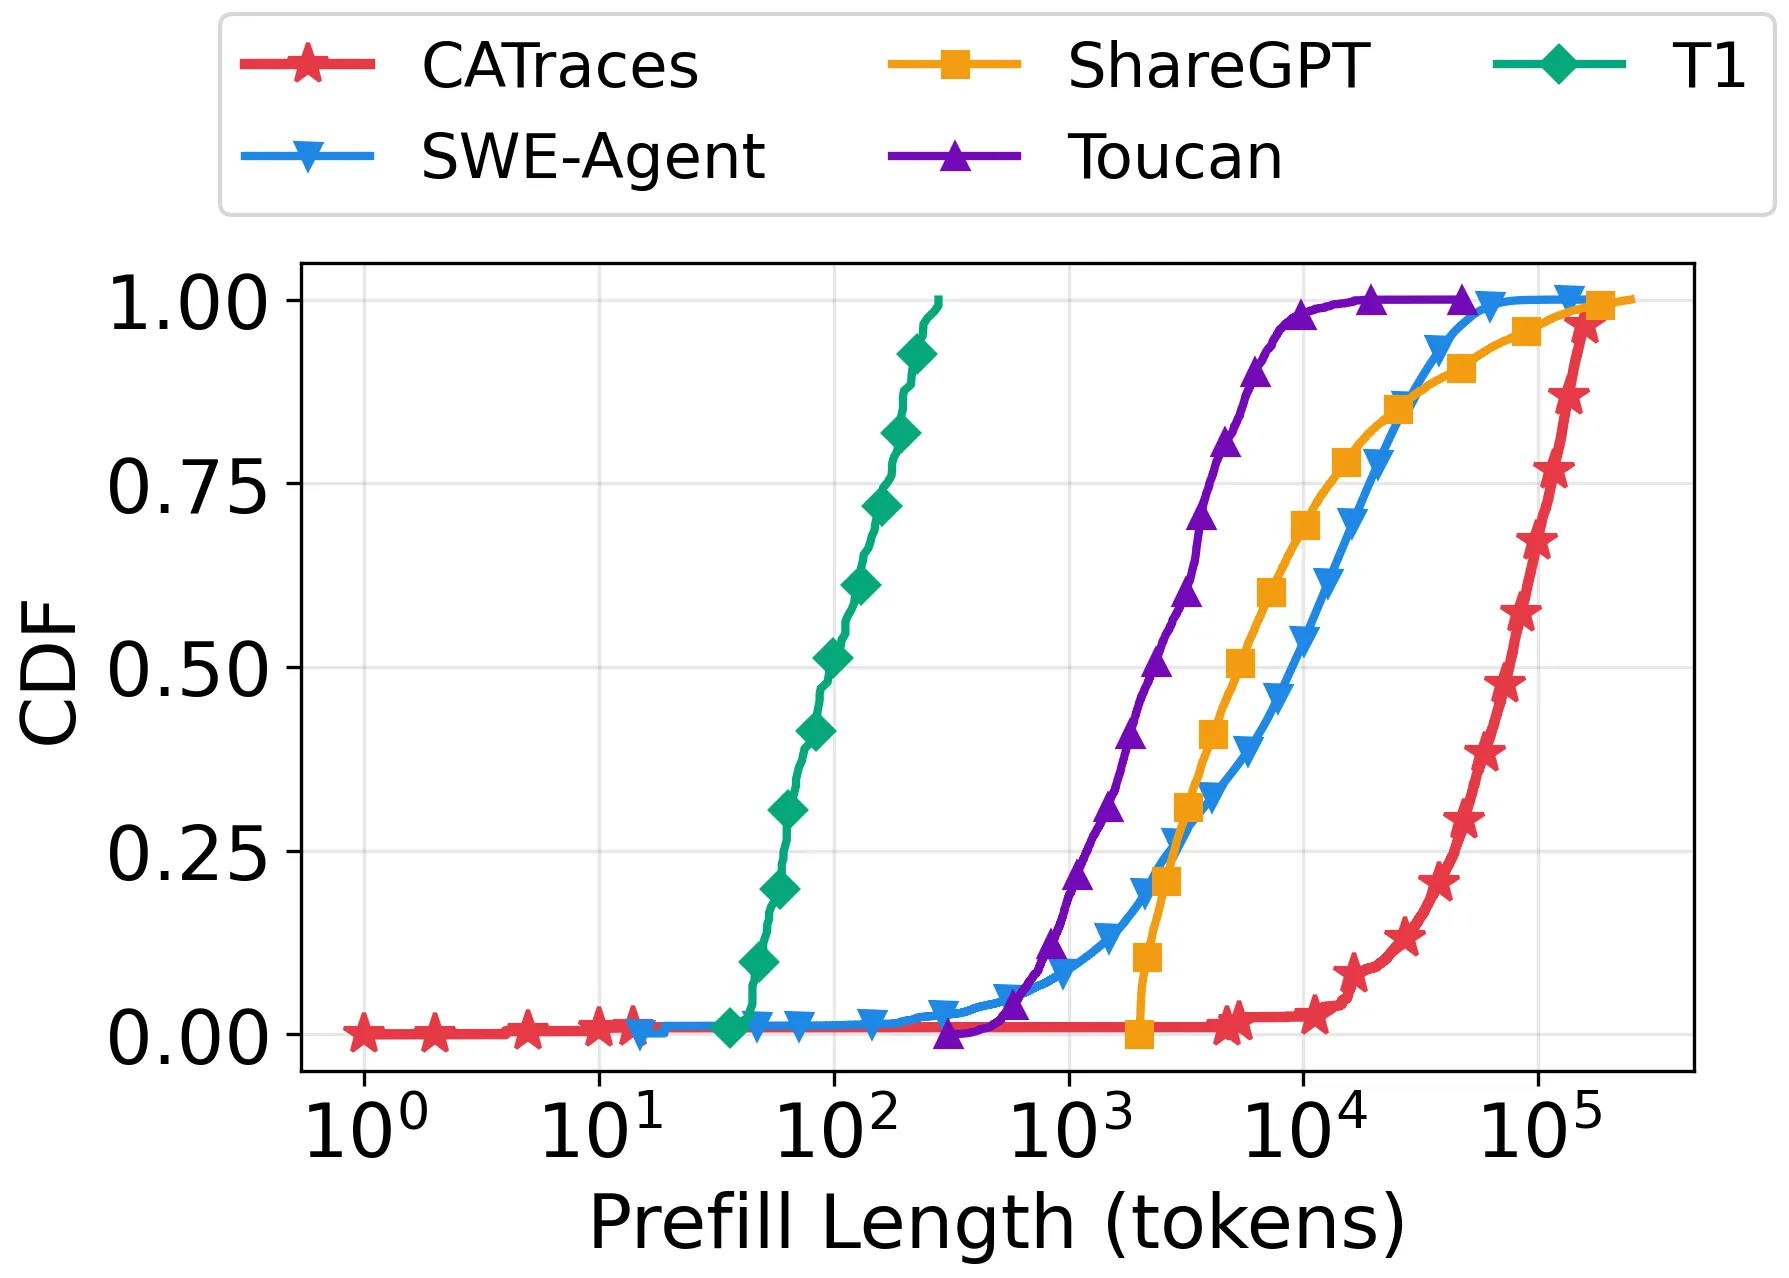
- Prefill 长度显著大于 ShareGPT/合成集:
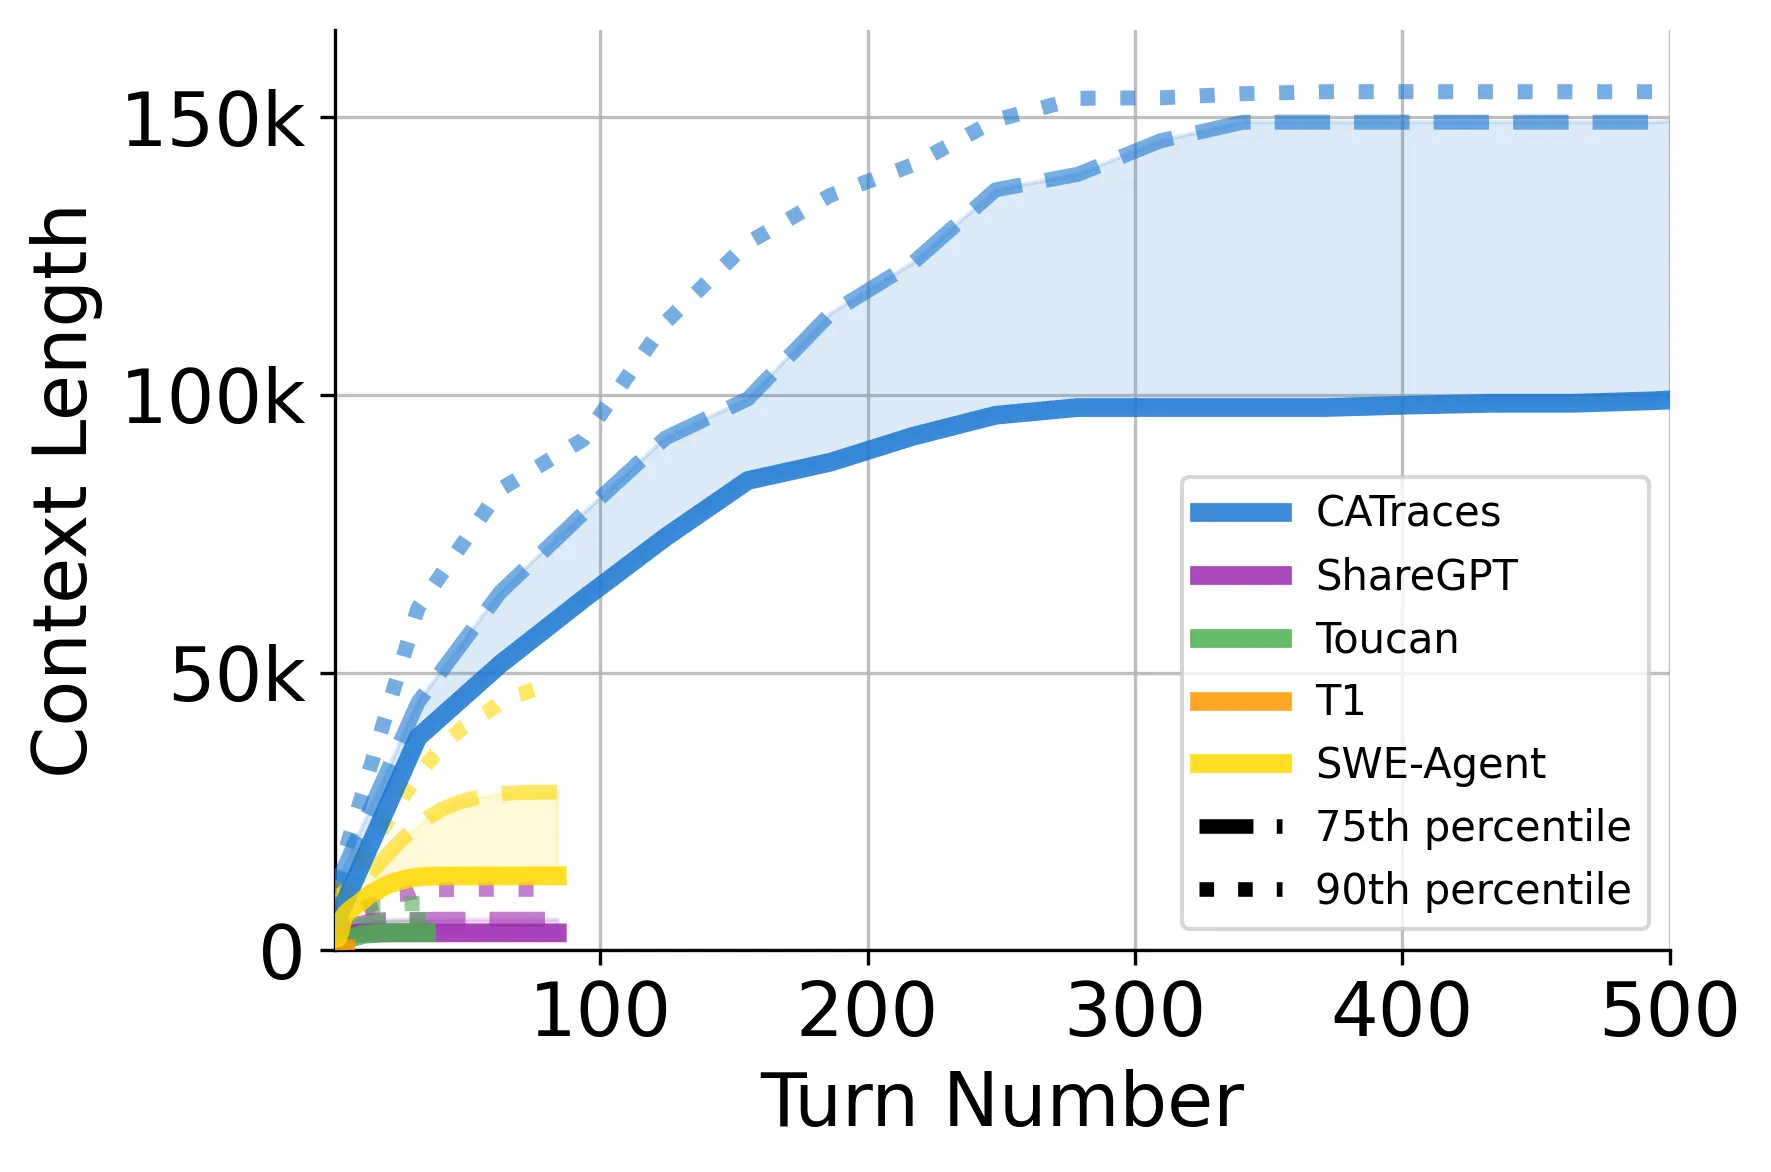
- 上下文长度随会话推进单调增长:
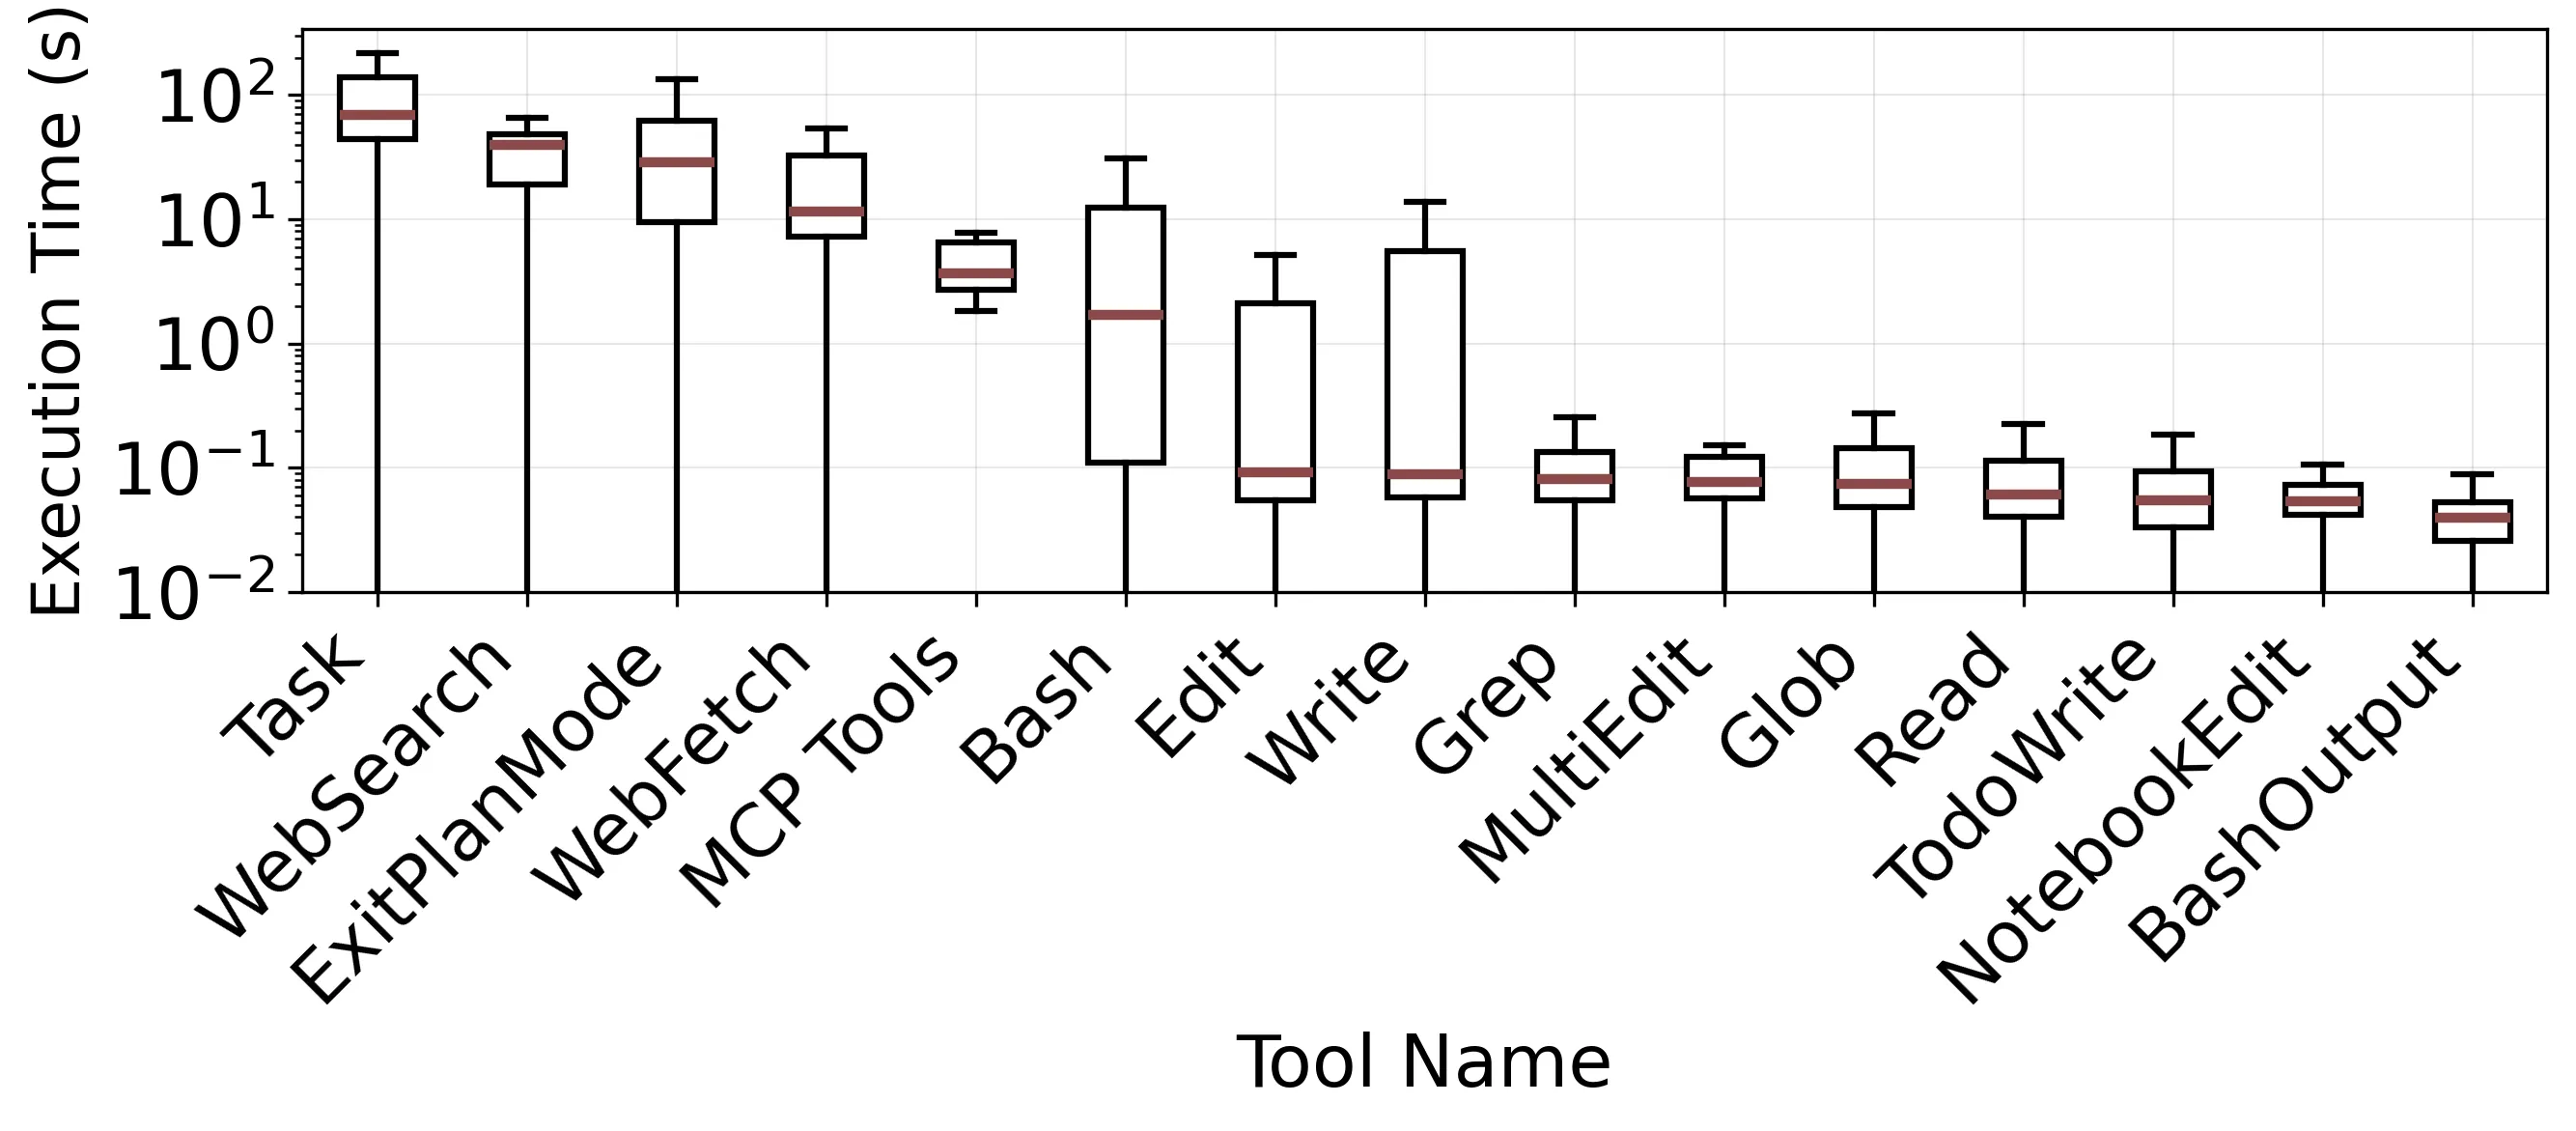
- 工具执行时长分布差异极大:
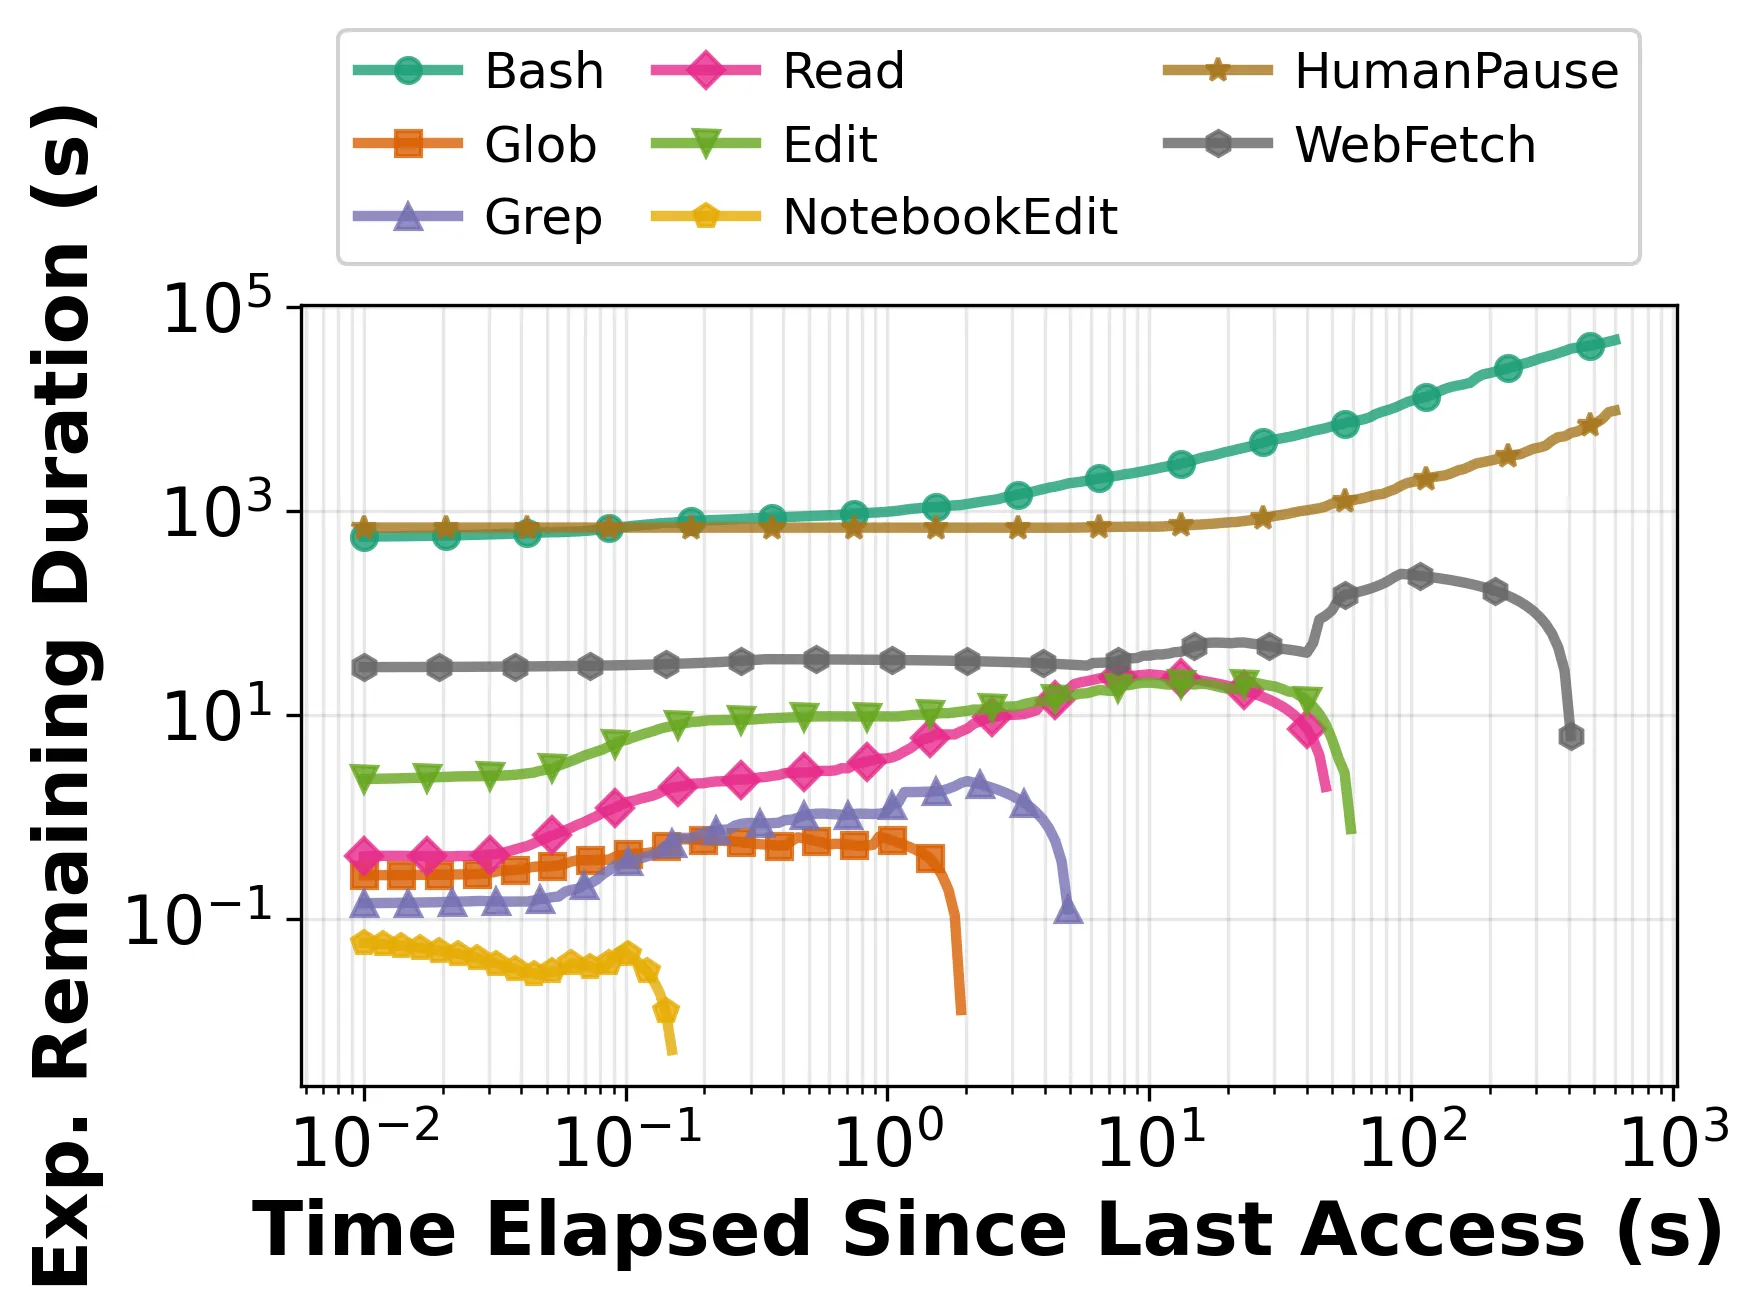
- Tool 距上次访问时间与执行时长强相关(激励基于 aging 的预测):
3.2 形式模型
设节点 KVCache 容量 ,时刻 活跃 session 集合 ,每个 session 前缀 、驻留块数 。工作集:
新请求 需 个块,复用 ,需新增分配:
当 时触发驱逐;理想驱逐遵循 Belady 规则:驱逐下一次访问时间 最远的块。
3.3 前缀感知调度
CacheWise 每次选择 最小(即最多复用驻留 KV)的请求 。这本质上近似 SJF 调度:由于闭环 agent 优化目标是 session 完成时间而非单请求 TTFT/TBT,最小化 同时减少总体队列长度,也降低对其他 session 的抖动。
3.4 预测式 KVCache 驱逐
-
目标:按 降序驱逐,逼近 Belady。
-
关键观察:只需相对次序即可正确决策。
-
预测器:对 tool call 从历史相似分布估计条件期望
-
分位/聚类:按 tool_args 做 20/50/100 桶聚类(C20/C50/C100),仅名字级别不够精细。
-
定期重估:每 次引擎迭代重建驱逐堆,实测 平衡新鲜度与开销。
3.5 实现
基于 vLLM,约 2500 行 Python;扩展 batch scheduler 与 KVCache block manager:
- 每个 KV block 附带
(tool_name, tool_args, T_i)session-level 元数据。 - 引用计数归零后进入驱逐堆,按预测 作优先级。
- 同一 session 多 block 复用同一预测,摊销开销。
四、核心创新
| 创新点 | 说明 |
|---|---|
| CATraces 数据集 | 首个真实编码 Agent 的公开级别 trace 数据集,包含 tool 调用、tokens、时间戳、干预标注 |
| Closed-loop 分析框架 | 从 session 级别而非请求级别定义 serving 效率指标 |
| 前缀感知 SJF 式调度 | 以 排序调度,同时减少抖动与队列长度 |
| 元数据驱动的预测驱逐 | 以 tool_name/args + aging 逼近 Belady,突破 LRU 与 InferCept 的会话内均值预测 |
| Session 级 KV 元数据管理 | vLLM block manager 内嵌 session metadata,重建堆保证预测新鲜 |
五、实验结果
5.1 设置
- 硬件:2× H200 GPU(TP=2,共 282 GB)+ AMD EPYC 9534 64C。
- 模型:Qwen2.5-Coder-32B-Instruct,chunked-prefill(512 tokens/chunk)。
- 训练/测试:CATraces 中 80% 用于 predictor 训练,其余重放。
- 基线:vLLM(LRU + FCFS)、InferCept(session-local moving average)。
5.2 端到端性能
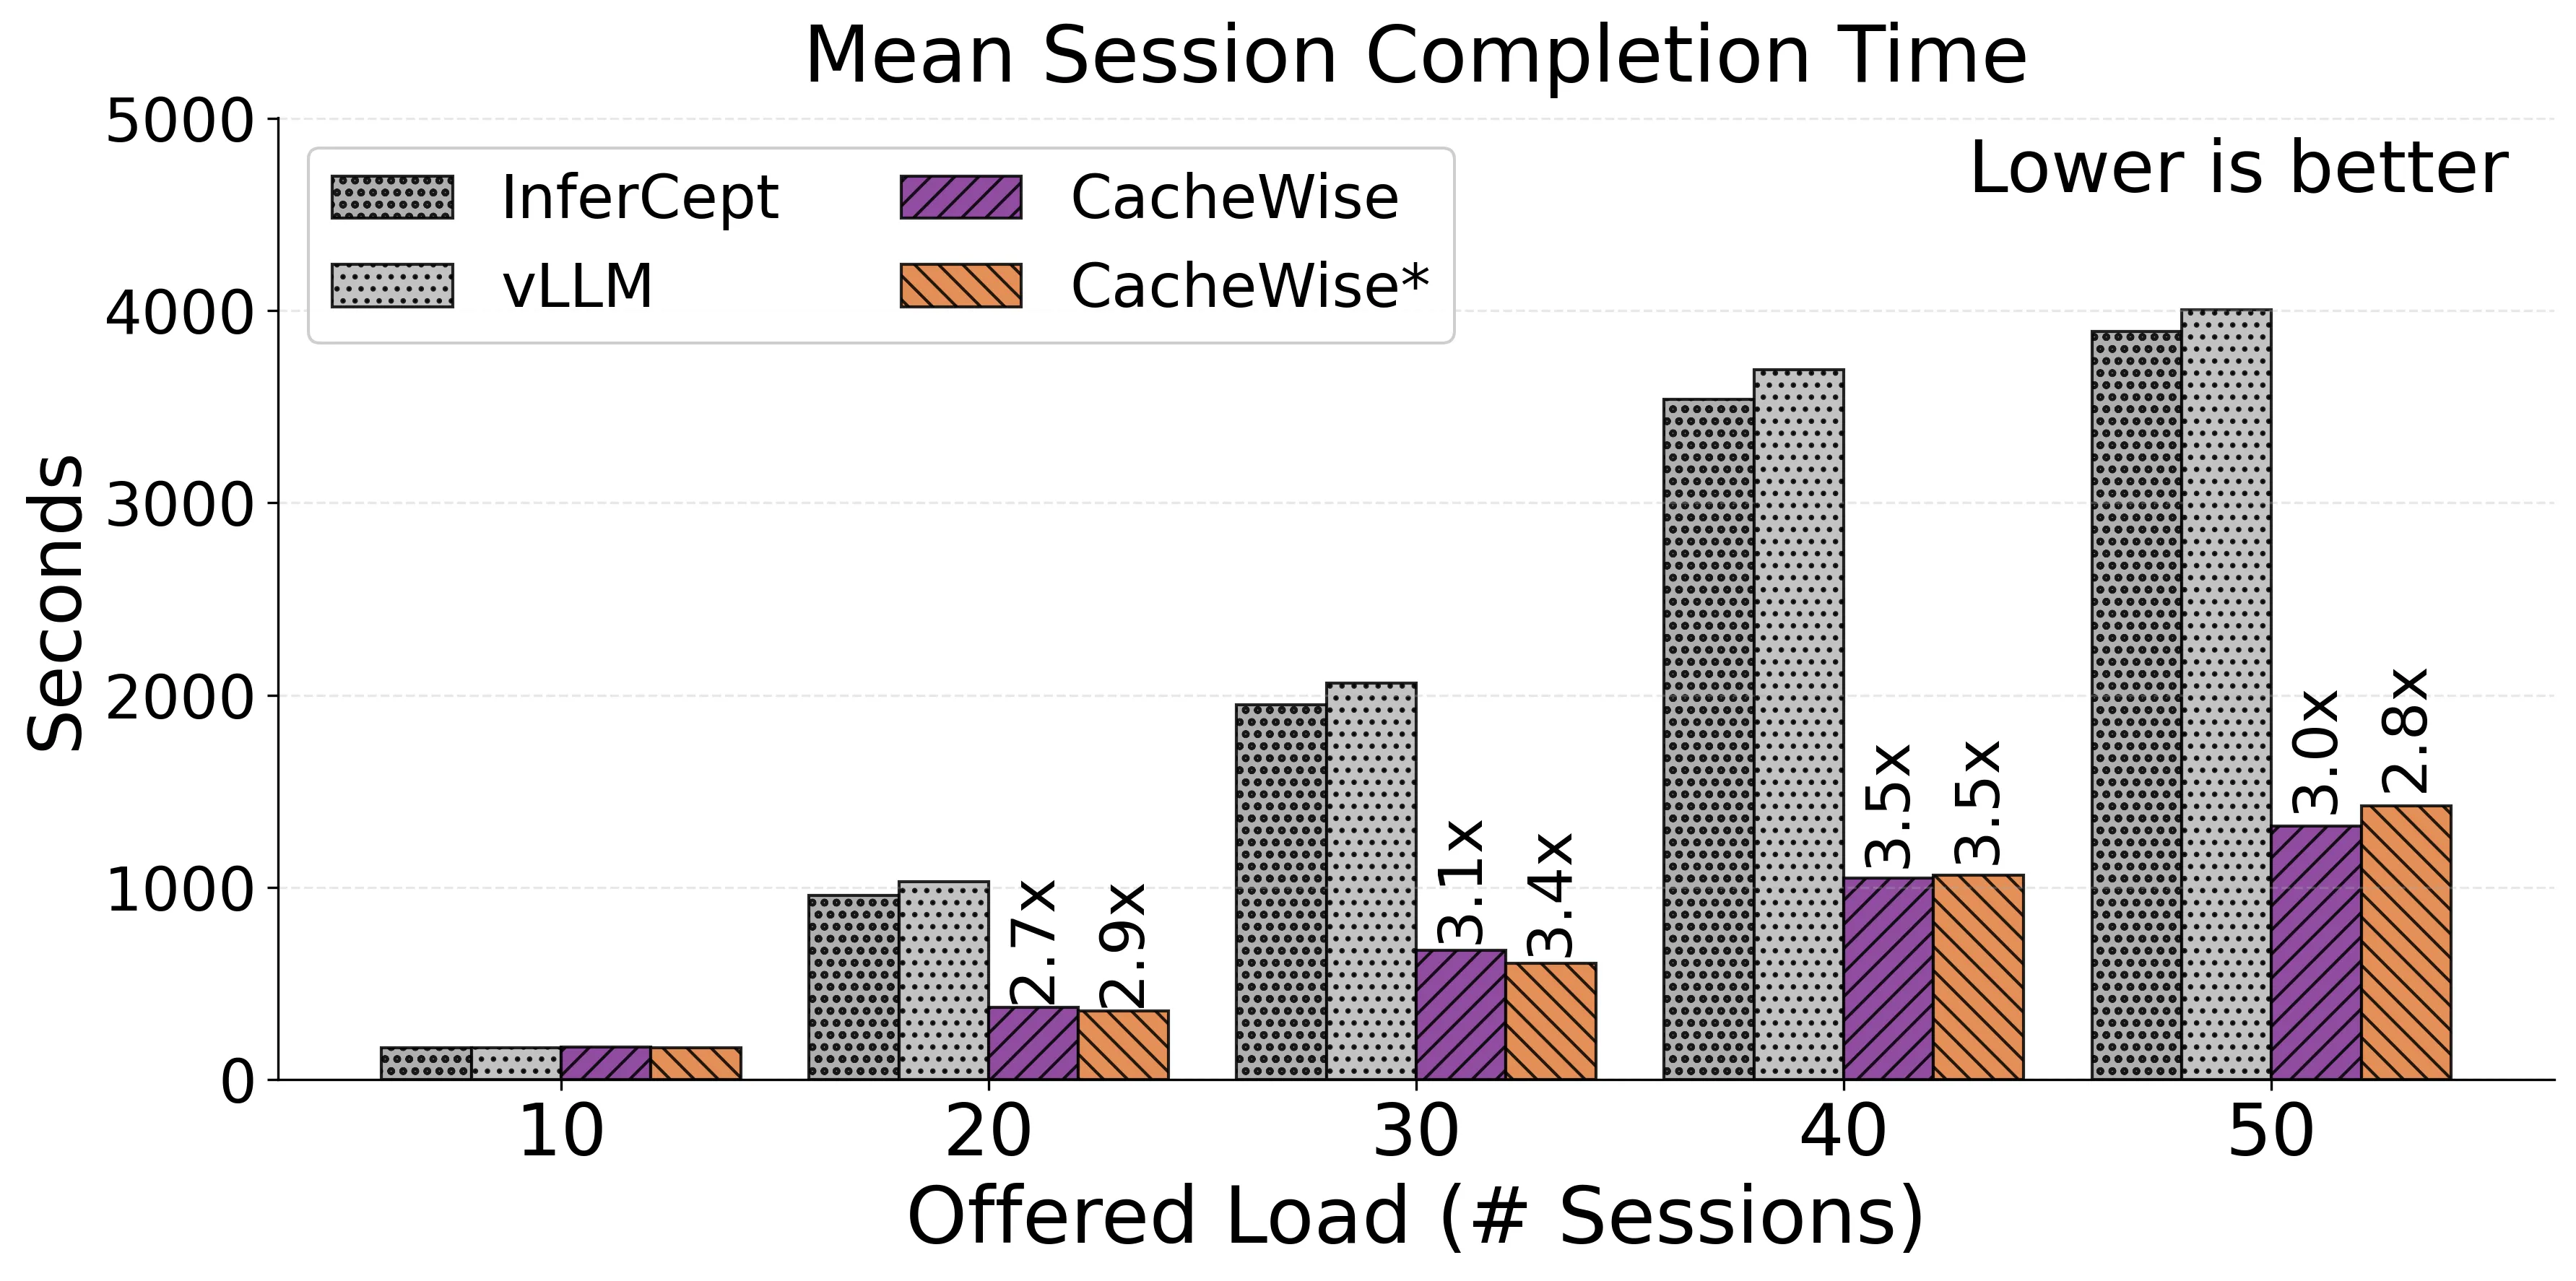
- 低负载()三者接近;高负载()CacheWise 相较 vLLM/InferCept 快 2.7×–3.5×。
- CacheWise 与使用 ground-truth 工具时长的 CacheWise* 表现接近,说明轻量估计器已足够。
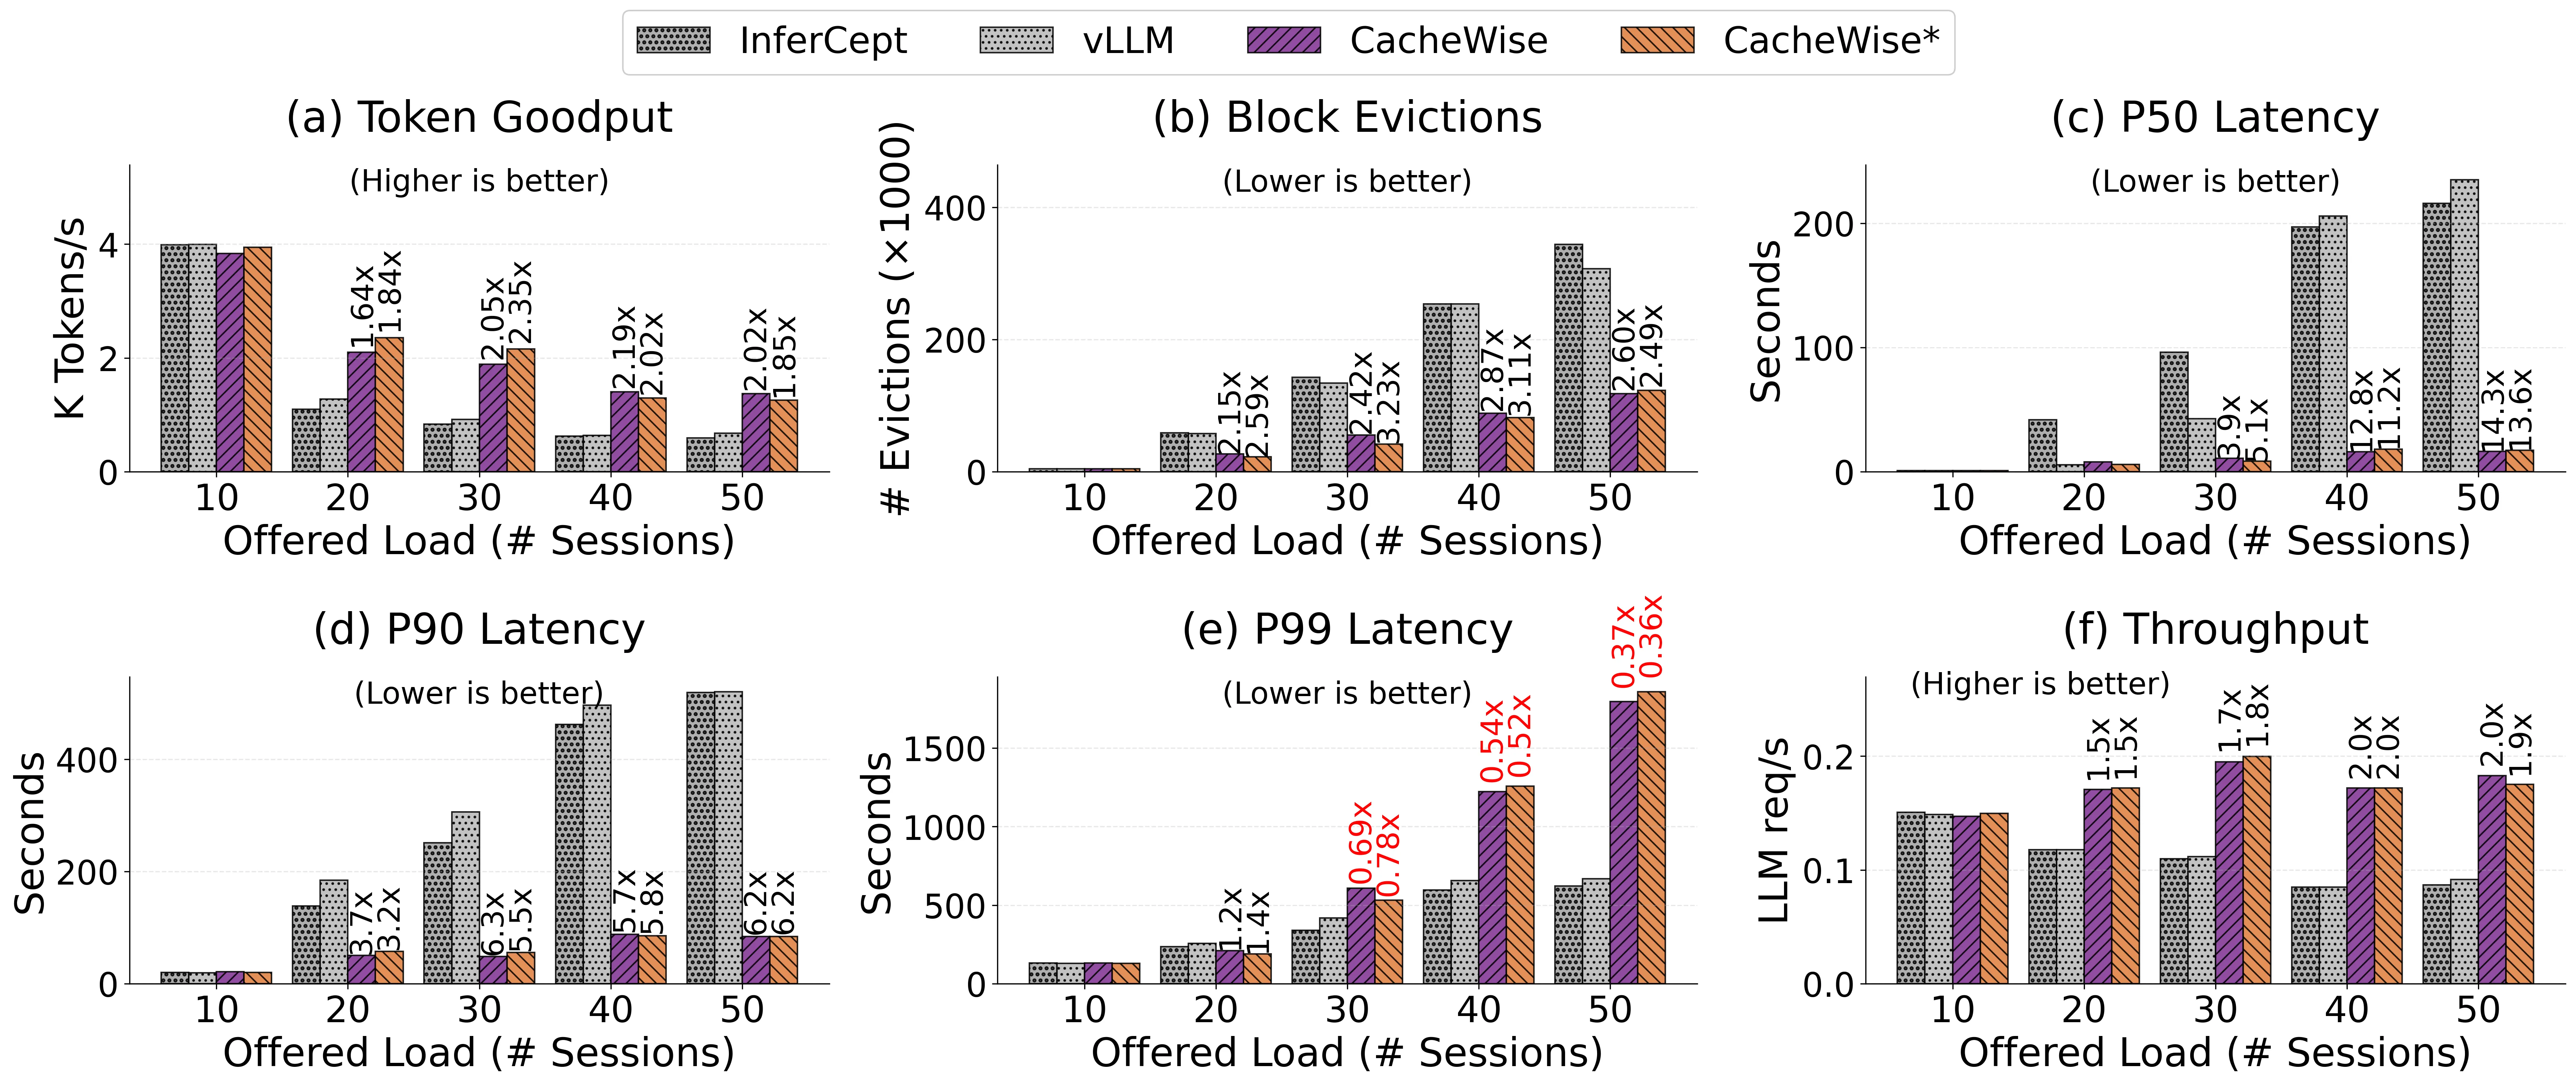
- Token goodput:+1.64×–2×。
- KV 块驱逐:降低 2–2.6×。
- 请求吞吐:+1.5×–2×。
- 请求延迟:P50 提升最高约 13–14×。
5.3 消融
- 仅预测驱逐(都开启 Prefix-aware):goodput +1.2×–1.6×,session 完成时间 ~1.7×–2×。
- 仅前缀感知调度: 时 goodput +1.38×–1.64×, 时 +1.6×–1.7×;session 完成时间 快 1.8×–2.35×, 快 1.85×–2.66×。
- 两项优化正交且可叠加。
5.4 KVCache 数据移动
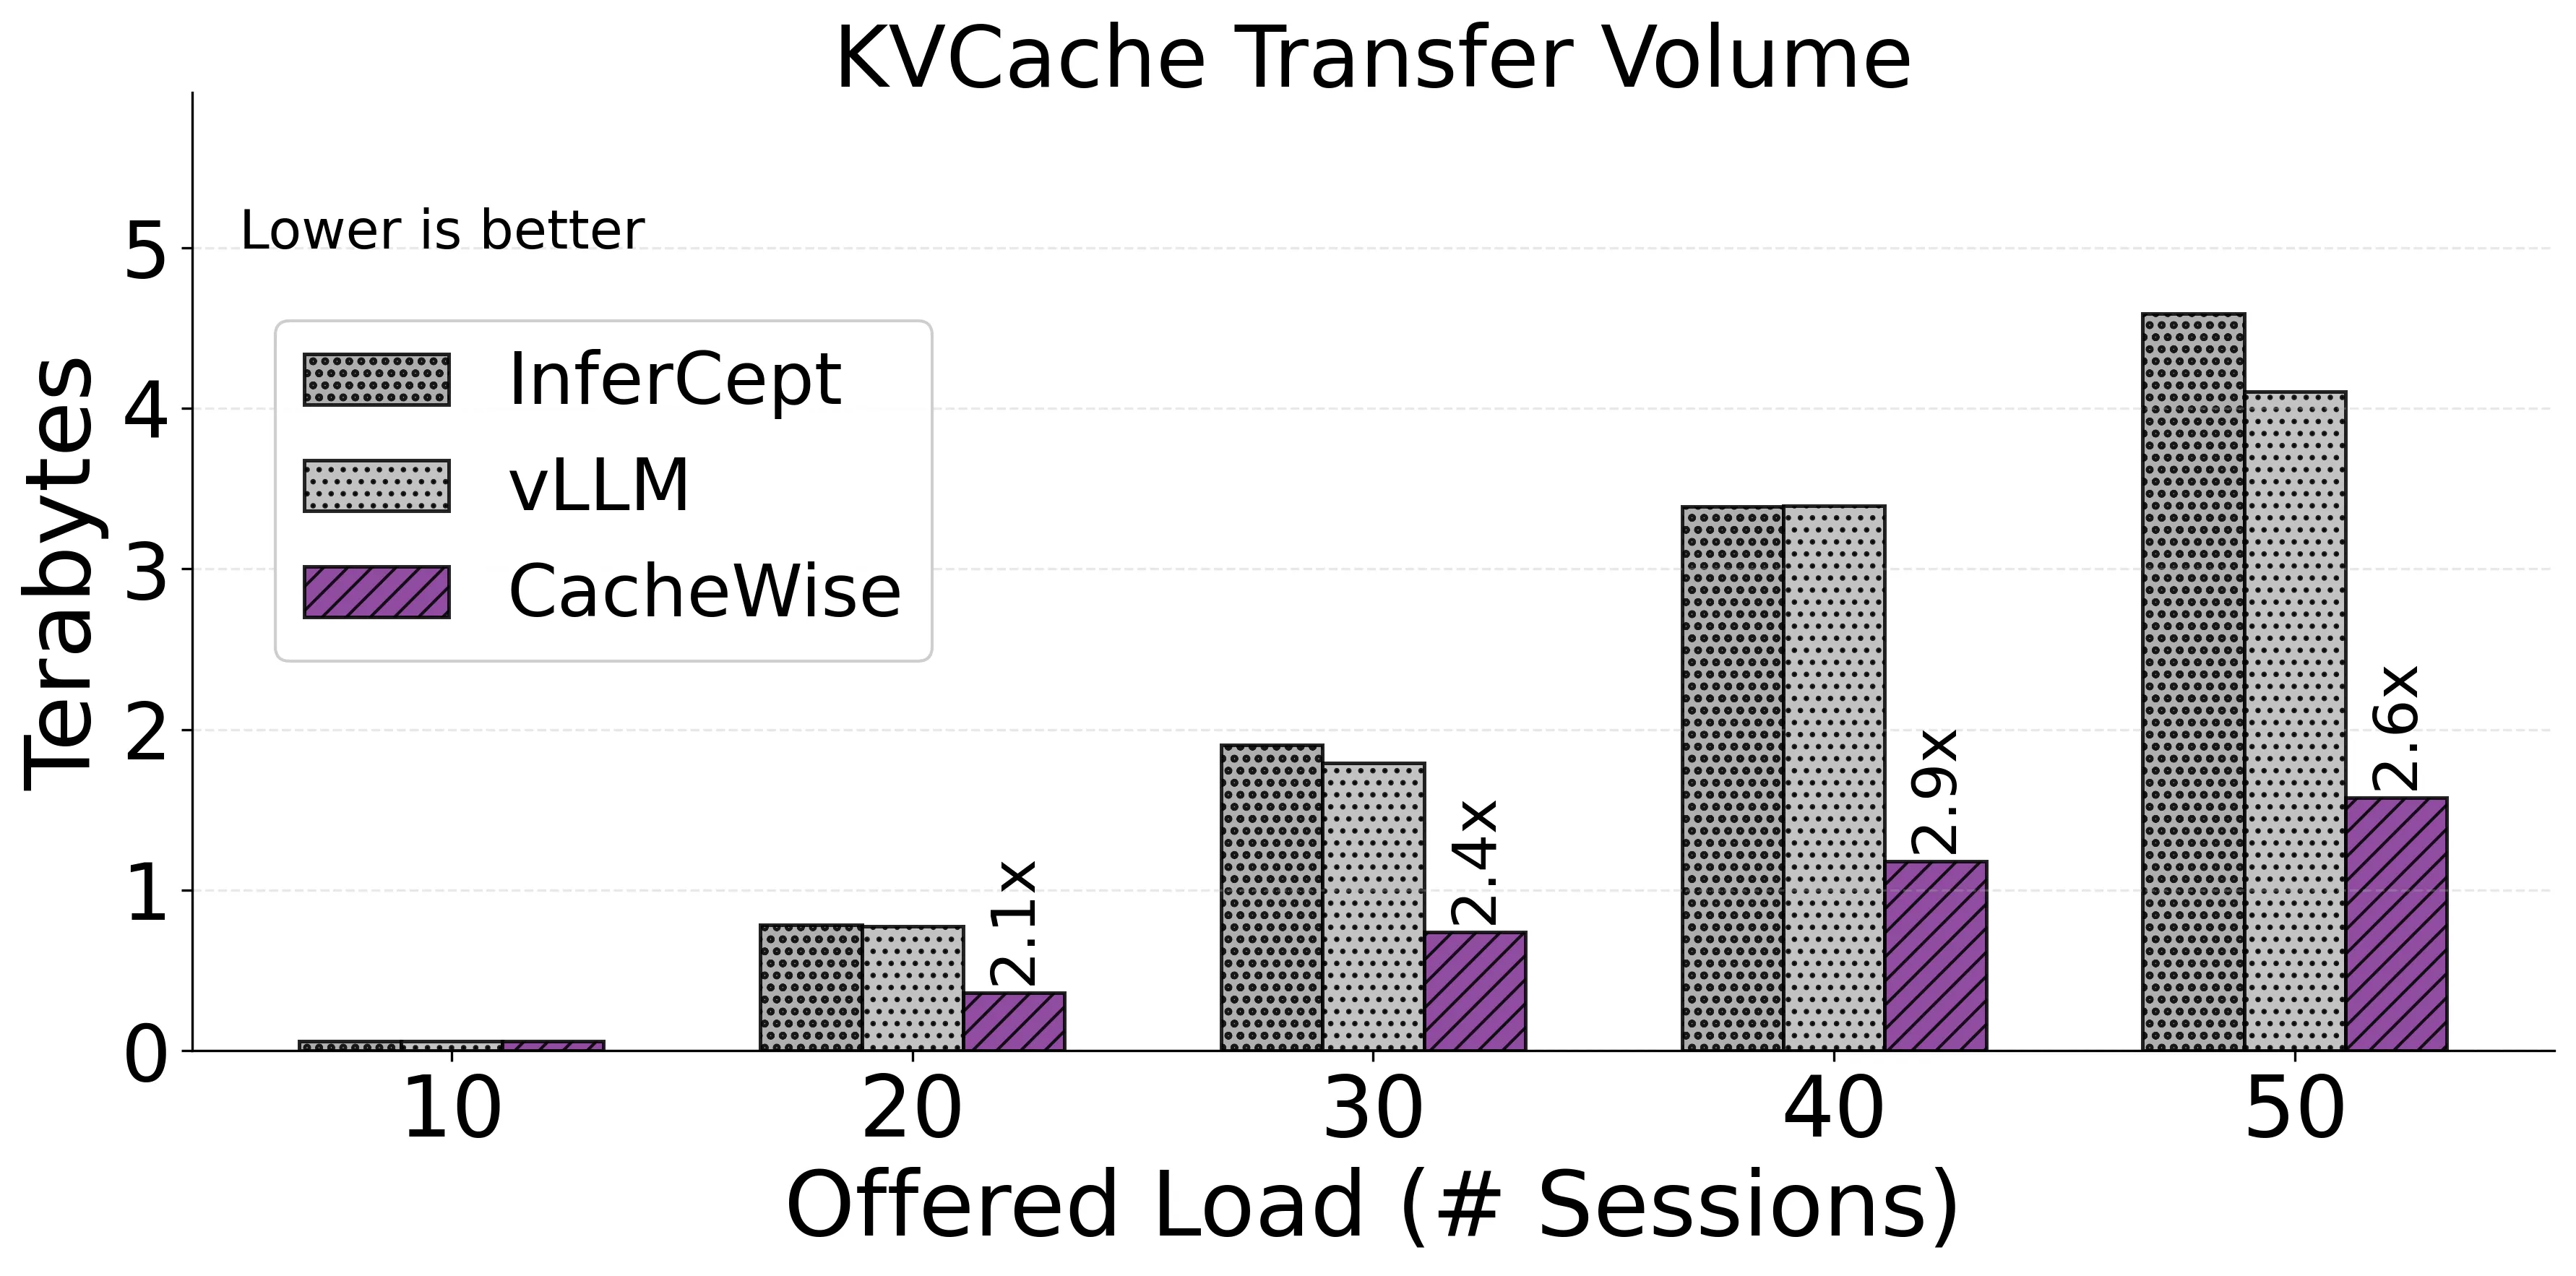
- 传输量减少 ~2×–2.6×。
- 在使用 CPU offload 而非重算的配置下,CacheWise 仍带来 ~1.19× session 完成时间收益(PCIe 传输比 prefill 便宜,因此上限较低)。
5.5 预测粒度消融
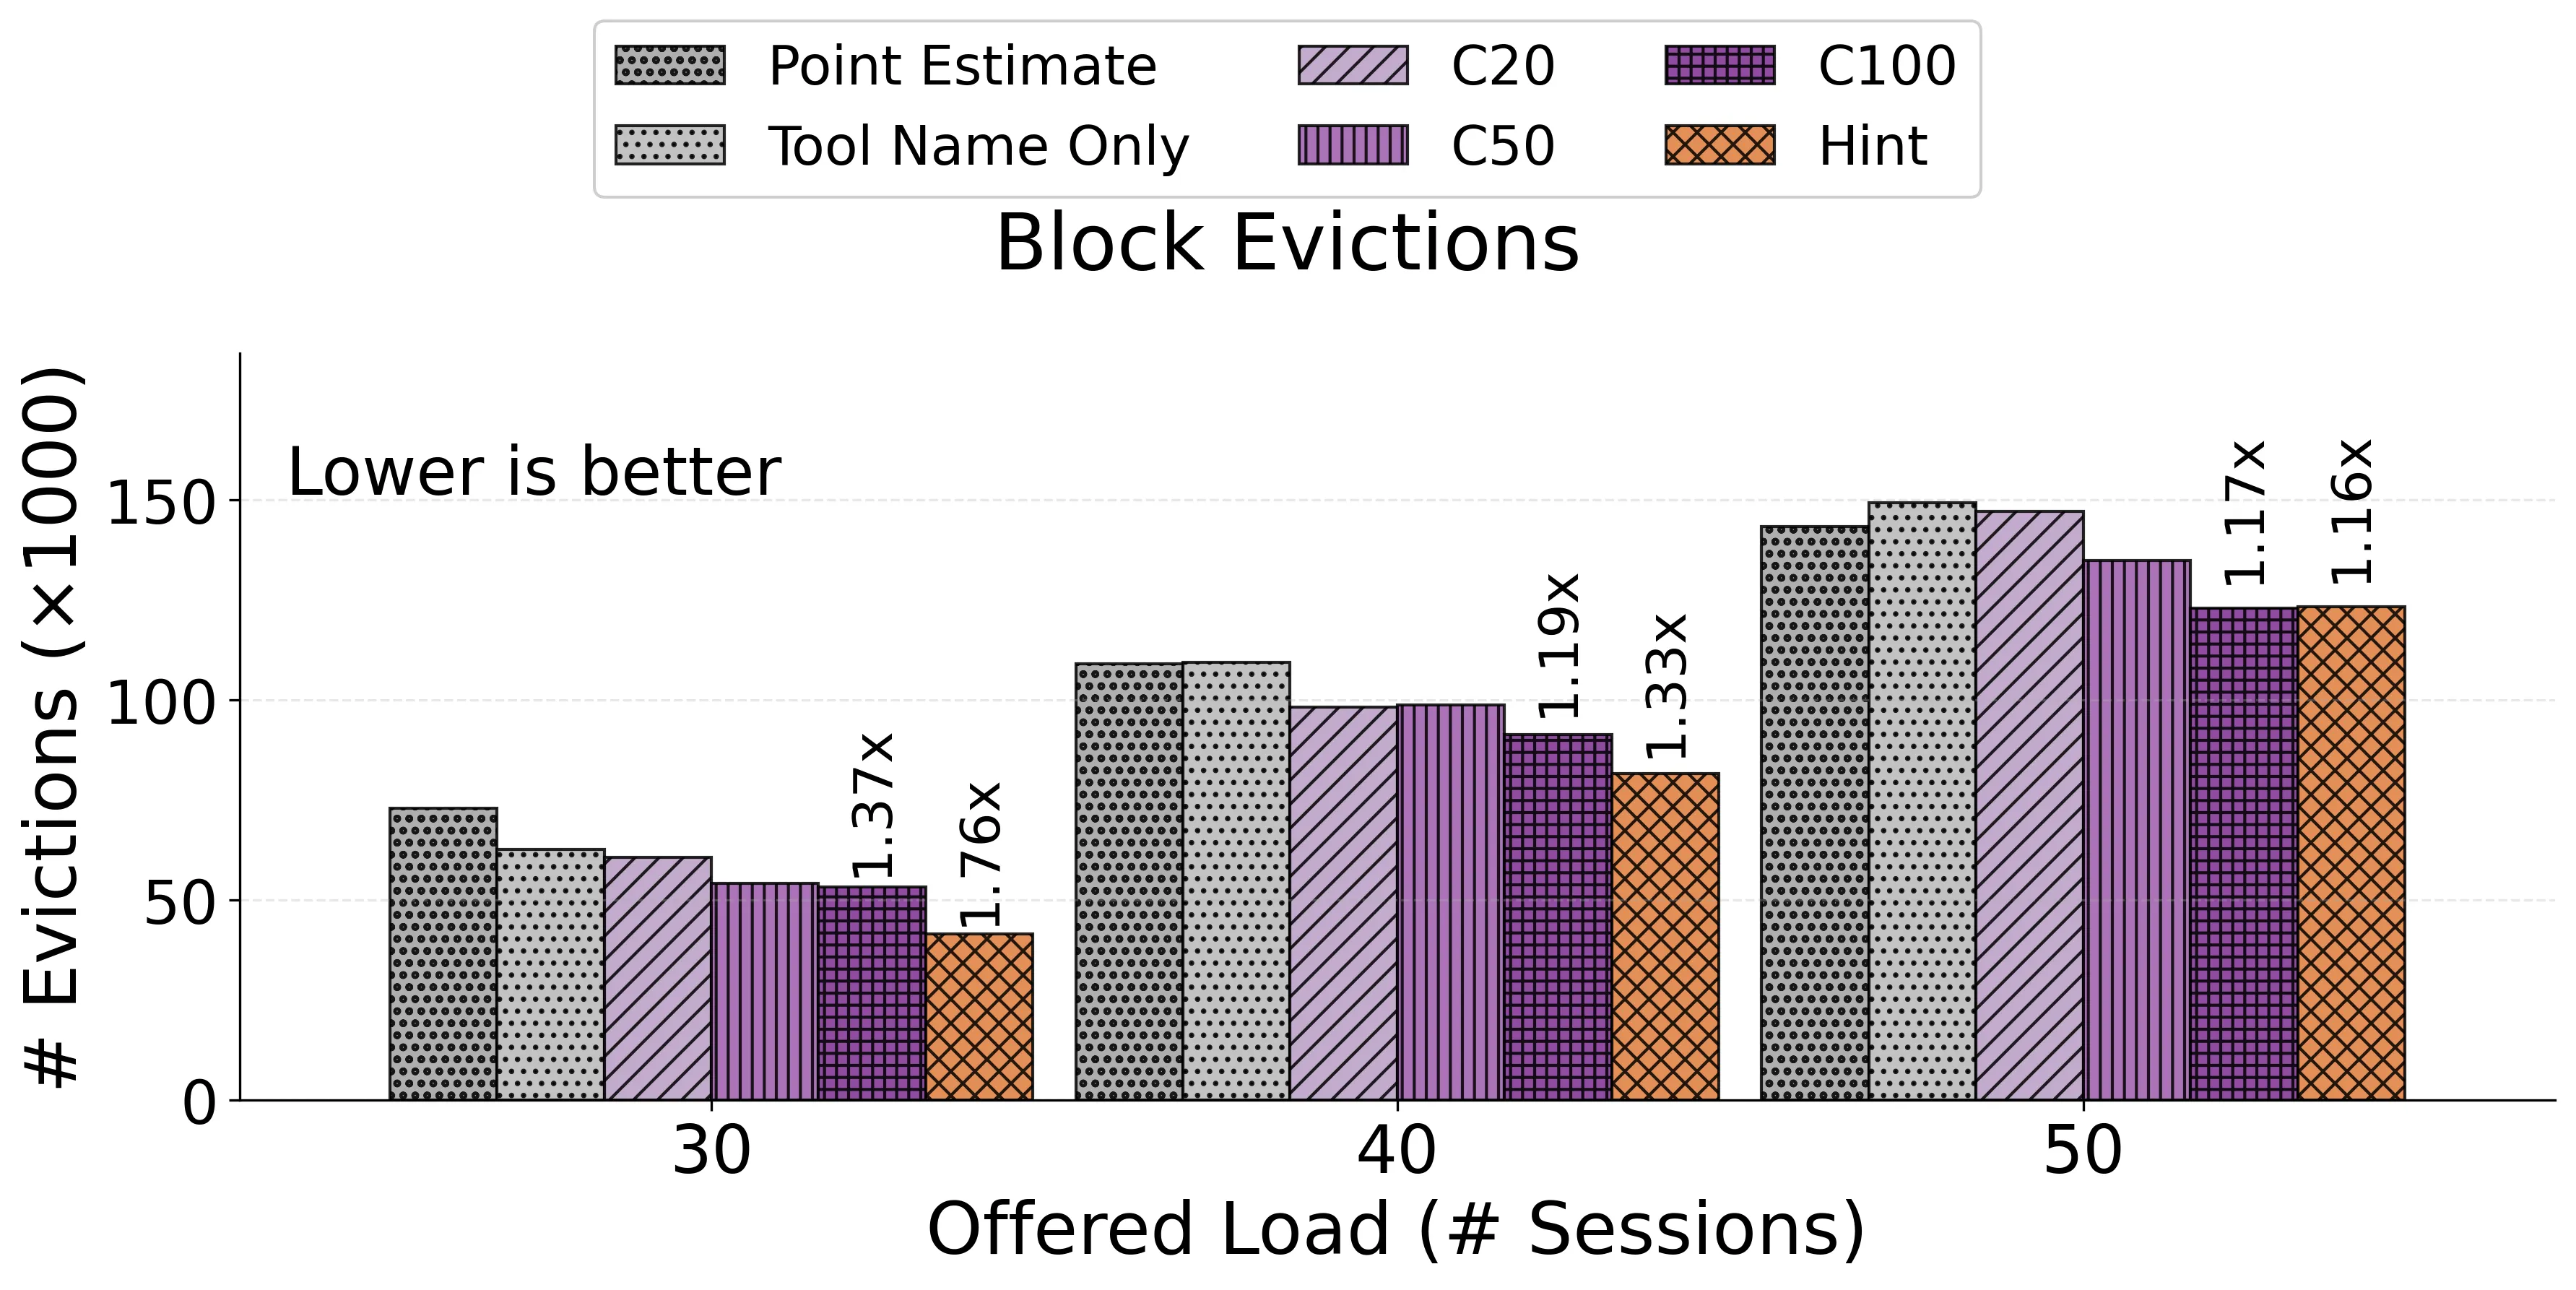
- 点估计 → tool_name → C20 → C50 → C100,驱逐次数与完成时间递减。
- C100 最高,比 C0 baseline 提升最多 19% session 完成时间。
- 超过 100 桶无更多 cluster(数据不足)。
5.6 调度开销
- CPU 调度开销从 vLLM 的 0.33 s 涨到 CacheWise 的 0.99 s(3×),但 GPU model exec 从 16.6 s 降到 11.2 s(1.48×),净收益 -4.7 s / 请求。
- 相对占比:vLLM ~6% → CacheWise ~9%。
六、总结
核心贡献
- 收集并系统性分析首个真实编码 Agent trace(CATraces),揭示与 chat 工作负载的本质差异。
- 提出面向 closed-loop 会话的 KVCache 管理层 CacheWise:前缀感知调度 + 元数据驱动的预测式驱逐。
- 在 vLLM 上以 2500 行代码实现,评测证明 KV 驱逐降 2–2.6×、session 完成时间降最高 3.5×、goodput 提升 1.64–2×。
- 消融表明前缀调度与预测驱逐相互正交,均对 coding-agent 极为关键。
技术影响
- 将 LLM serving 优化目标从 per-request 指标(TTFT/TBT)扩展到 session 级指标,为 agent 时代提供新的评估框架。
- 显示 tool metadata 是低成本、高价值的调度信号;可推广至其他 tool-heavy agent 系统。
局限性
- 依赖历史 trace 训练预测器,工作负载漂移下需要周期重训(作者留作 future work)。
- 目前预测粒度停留在 tool_args 聚类(≤100 桶),对超长 tail 参数分布仍粗糙。
- 评估仅覆盖 Qwen2.5-Coder-32B 与 H200 平台,其他模型/加速器泛化性未直接验证。
- 与 workflow-aware 系统(Autellix、Pie)不同,CacheWise 无法感知 agent 语义,只能通过 tool 元数据近似。
七、参考资源
- arXiv: https://arxiv.org/abs/2606.16824
- HTML: https://arxiv.org/html/2606.16824v1
- 主题:cs.DC, cs.OS
- 相关系统:vLLM、SGLang、InferCept、Mooncake、Autellix、Pie