daVinci-kernel: Co-Evolving Skill Selection, Summarization, and Utilization via RL for GPU Kernel Optimization
GPU kernel 优化的强化学习框架:让 Skill Selection、Policy、Skill Summary 三个 agent 共享同一 LLM backbone 端到端联合优化。选择器用 BM25+LLM 重排检索技能,策略生成多轮 CUDA/Triton,摘要器把成功 rollout 蒸馏为可复用 skill,并用执行验证过滤。SFT 冷启动+多轮 REINFORCE 联合训练。KernelBench 上 daVinci-kernel-14B 在 Fast_1 阈值下 L1/L2/L3 达 37.2%/70.6%/32.2%,8B 上 L2 Fast_1.2 从 9.4→22.1、L3 从 0.5→3.0,超越 Dr. Kernel-14B。
daVinci-kernel: Co-Evolving Skill Selection, Summarization, and Utilization via RL for GPU Kernel Optimization
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | daVinci-kernel: Co-Evolving Skill Selection, Summarization, and Utilization via RL for GPU Kernel Optimization |
| 作者 | Dayuan Fu, Mohan Jiang, Tongyu Wang, Dian Yang, Jiarui Hu, Liming Liu, Jinlong Hou, Pengfei Liu† |
| 提交时间 | 2026-06-15(v1),2026-06-24(v2) |
| arXiv | 2606.16497 |
| 分类 | cs.LG / cs.AI / cs.CL |
| 基础模型 | Qwen3-8B / Qwen3-14B |
| Benchmark | KernelBench(Level 1 / 2 / 3,速度阈值 Fast 1/1.2/1.5/2) |
二、核心思想
问题定义:GPU kernel 优化不同于普通代码生成 —— 正确性视为前提,目标是最大化执行效率。这需要模型持续演化”优化知识(skills)“以跟上不断变化的硬件与算子模式。已有做法要么使用静态技能库,要么单独训练策略 agent,导致技能库与策略进化脱节。
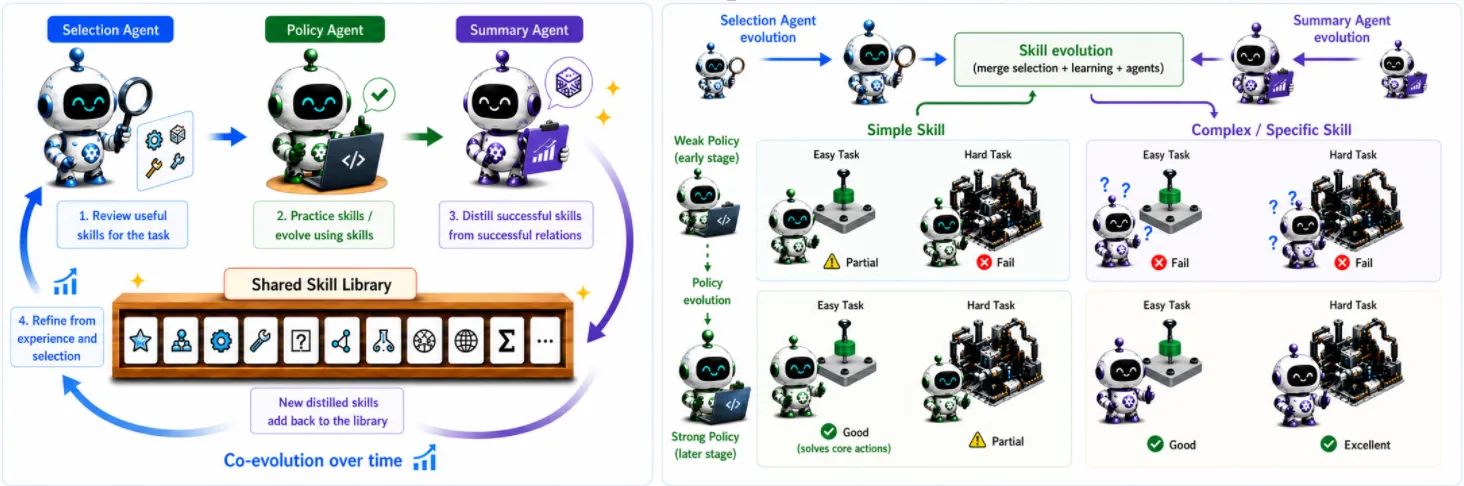
解决方案:daVinci-kernel 把三种角色统一到同一个 LLM backbone、以 RL 联合训练:
- Skill Selection Agent:用 BM25 粗检 + LLM 重排精排,从动态 skill library 中挑出与当前任务最相关的若干 skills。
- Policy Agent:以选中的 skills 为上下文,生成多轮 CUDA / Triton kernel(多轮迭代允许失败后修补)。
- Skill Summary Agent:将成功 rollout 蒸馏成新的可复用 skill 摘要。
- 执行验证准入:候选 skill 只有在 execution-based verification 确认可复现加速后,才被写入 skill library。
三个 agent 共享同一 LLM 参数,端到端用多轮 REINFORCE(TRLOO)以及每 agent 独立 advantage 估计联合优化,训练前用 diversity-filtered SFT 冷启动。
三、技术架构 / 方法
3.1 整体结构
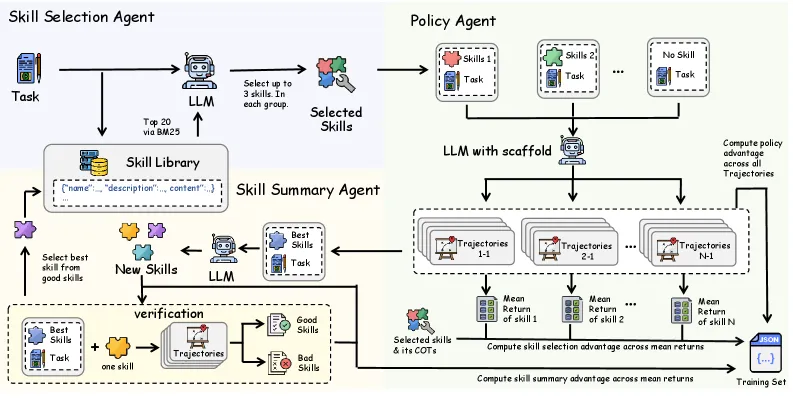
一个 LLM 通过不同的 system prompt 扮演三种 agent;每一轮 rollout 涉及”检索 skills → 生成/修补 kernel → 执行测速 → 若成功则摘要成 skill”闭环。
3.2 Skill Library
- 每个 skill = 自然语言摘要 + 触发条件 + 参考代码片段。
- 只有经过 execution-grounded verification 且 reproducible speedup 的候选 skill 才被加入 library。
- 检索走 BM25 → LLM reranker 两阶段。
3.3 Joint RL (TRLOO)
- Multi-turn REINFORCE,每个 agent 使用其自身产出的 log-probability 计算 loss。
- Per-agent advantage estimation:每个 agent 用自己的 baseline 估计 advantage,避免策略 agent 的高方差污染其他 agent。
- 奖励主要来自 kernel 执行速度阈值达成情况 (Fast 1 / 1.2 / 1.5 / 2)。
- SFT 冷启动阶段用 diversity-filtered 数据,防止 skill mode collapse。
四、核心创新
| 创新点 | 描述 |
|---|---|
| 三 agent 共享同一 backbone | 用单个 LLM 通过不同 prompt 扮演选择/策略/摘要,节省显存并让技能与策略共同进化 |
| 动态执行验证的 skill library | 只有执行验证可复现加速的 skill 才加入库,避免”看起来好听但实际无效”的伪技能 |
| BM25 + LLM Rerank 检索 | 两阶段检索兼顾召回与相关性 |
| Multi-turn REINFORCE + Per-agent advantage | 支持多轮修补,且不同 agent 的方差互不干扰 |
| Diversity-Filtered SFT 冷启动 | 通过多样性过滤避免 skill 崩塌为少数通用模式 |
五、实验结果
5.1 KernelBench 主结果(Fast 1.2)
| Model | L1 F1 | L1 F1.2 | L2 F1 | L2 F1.2 | L3 F1 | L3 F1.2 |
|---|---|---|---|---|---|---|
| Dr. Kernel-8B | 17.9 | 14.9 | 26.8 | 9.4 | 3.0 | 0.5 |
| daVinci-kernel-8B | 26.1 | 20.4 | 44.8 | 22.1 | 10.1 | 3.0 |
| Dr. Kernel-14B | 30.4 | 26.0 | 58.5 | 18.1 | 22.1 | 2.8 |
| daVinci-kernel-14B | 37.2 | 27.3 | 70.6 | 29.3 | 32.2 | 7.3 |
- 14B 上 Level 2 Fast 1.2:18.1 → 29.3,Level 3 Fast 1.2:2.8 → 7.3。
- 8B 上 Level 2 Fast 1.2:9.4 → 22.1,Level 3 Fast 1.2:0.5 → 3.0。
- 收益随任务难度增加而放大,说明”检索并复用技能”在难题上尤为关键。
5.2 消融研究 (Table 2)
以 8B 为例,Fast 1.2 阈值 Level 1 / 2 / 3:
| 变体 | L1 | L2 | L3 |
|---|---|---|---|
| daVinci-kernel-8B | 20.4 | 22.1 | 3.0 |
| Abl.1 推理时不注入 skill | 12.8 | 10.5 | 0.8 |
| Abl.2 SFT 无多样性过滤 | 16.9 | 23.5 | 2.5 |
| Abl.3 只训 policy agent | 17.4 | 16.8 | 1.3 |
| Abl.4 policy RL + BM25 (无 rerank) | 19.8 | 19.2 | 0.8 |
| Abl.5 完全无 skill | 19.8 | 16.5 | 0.3 |
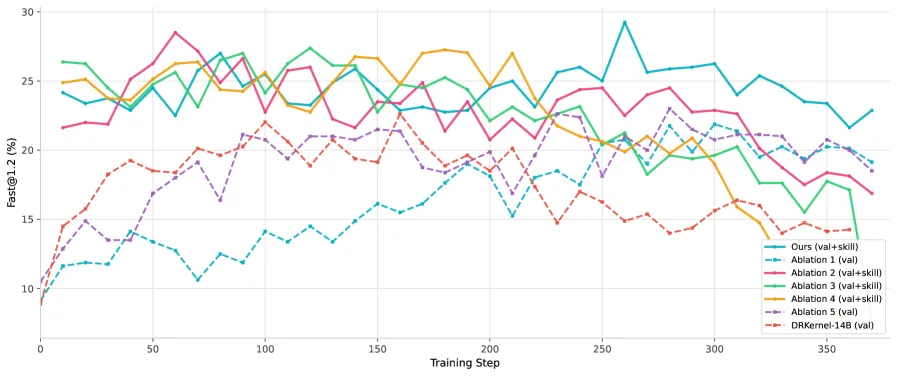
- 推理时是否注入 skill 影响最大(Abl.1):L1 Fast 1 从 26.1 → 16.2、L2 从 44.8 → 20.6、L3 从 10.1 → 2.0,越难越依赖 skill。
- Abl.3 联合训练缺失会使高精度阈值坍塌(Level 2 Fast 2 从 7.9 → 3.1,Level 3 近乎归零),证明”选择器/摘要器必须与 policy 一起演化”,否则技能库停滞在陈旧状态。
- Abl.4 BM25-only reranker:Fast 1 尚可但 Fast 1.2+ 明显退化,说明 LLM 重排对”高质量加速”至关重要。
5.3 Test-Time Scaling (Table 3)
| Model | L1 Best F1 | L2 Best F1 | L3 Best F1 |
|---|---|---|---|
| Dr. Kernel-14B | – | – | – |
| daVinci-kernel-14B | 56.1 / 63.2 (L1 best / L2 best) |
- 14B last-turn 提升到 L1 32.5%、L2 31.0%(Dr. Kernel-14B 28.4% / 26.1%);best-turn 更进一步显示多轮探索能力。
- daVinci-kernel-8B last-turn L2 Fast 1.2 达 30.6%,best-turn L2 Fast 1.2 达 55.4%。
六、总结
核心贡献
- 提出 daVinci-kernel:让 skill 选择、生成、摘要三个 agent 共享 LLM backbone 并联合 RL 训练,形成 skill-policy 共进化循环。
- 引入执行验证的动态 skill library 与 BM25+LLM 两阶段检索,保证技能”有用可复用”。
- KernelBench 上超越 Dr. Kernel-14B,14B Level 2 Fast 1.2 从 18.1 → 29.3,Level 3 Fast 1.2 从 2.8 → 7.3。
技术影响
- 为”LLM + 工具/知识库联合演化”提供了实用范式,可迁移到软件工程、数学工具选择、Agent planning 等场景。
- 三 agent 共 backbone 的设计降低了训练显存开销,为多 agent RL 提供轻量选项。
局限性(作者在 Appendix D)
- 仅在 GPU kernel 一域评测,泛化到科学发现、软件工程、长时任务未验证。
- Skill library 依赖文本摘要 + BM25,扩大后可能出现语义噪声与检索退化。
- Execution 验证仍无法消除”部分冗余、过度任务特化”的 skill 累积。
七、参考资源
- arXiv 论文:https://arxiv.org/abs/2606.16497
- HTML:https://arxiv.org/html/2606.16497v1
- 相关工作:Dr. Kernel、SkillRL、KernelBench、REINFORCE、BM25、Voyager (skill library)