Tropical: Enhancing SLO Attainment in Disaggregated LLM Serving via SLO-Aware Multiplexing
Tropical 在 disaggregated LLM 服务基础上引入 SLO-aware 多路复用:Multiplexing Toggle 用 slack 检测把短 prefill 借道 decode worker 执行、长 prefill 走独占 prefill worker,兼得低排队与低干扰。在 Mooncake 真实 trace 上 SLO 内可服务请求提升 2.02×,P90 TTFT 相比 DistServe 优化 9×,P90 TPOT 相比 vLLM 优化 2.33×。
Tropical: Enhancing SLO Attainment in Disaggregated LLM Serving via SLO-Aware Multiplexing
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Tropical: Enhancing SLO Attainment in Disaggregated LLM Serving via SLO-Aware Multiplexing |
| 作者 | Jinming Ma, Jiefei Chen, Xiuhong Li, Jiangfei Duan, Haojie Duanmu, Xingcheng Zhang, Chao Yang, Dahua Lin |
| 发表日期 | 2026-06-15 (arXiv) |
| arXiv | 2606.16264 |
| 分类 | cs.DC |
| 系统名 | Tropical |
| 模型 & 平台 | InternLM-20B on 8× A100 80GB, 600 GB/s NVLink |
| 数据集 | Mooncake trace |
二、核心思想
问题定义:LLM 服务需同时满足 TTFT(prefill)与 TPOT(decode)两个 SLO。
- Non-disaggregated(共置):prefill+decode 同一 worker → 排队短但干扰大 → TPOT 差;
- Disaggregated(分离):prefill/decode 分工 → 无干扰但 prefill 排队长 → TTFT 差;
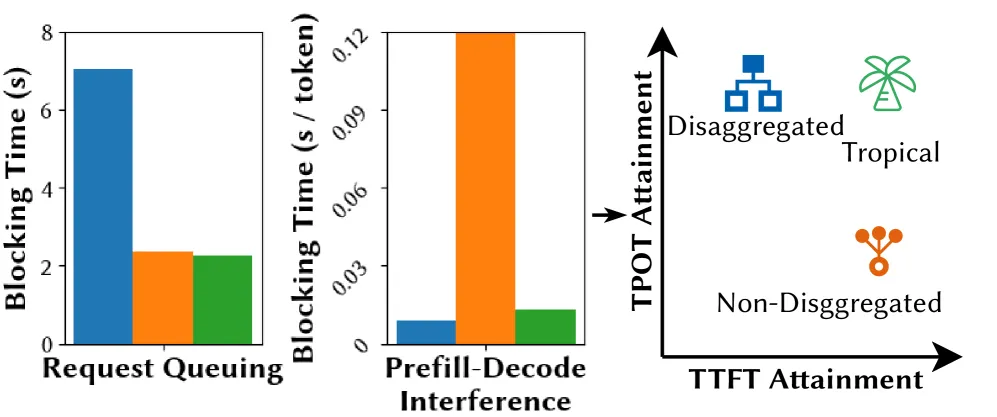
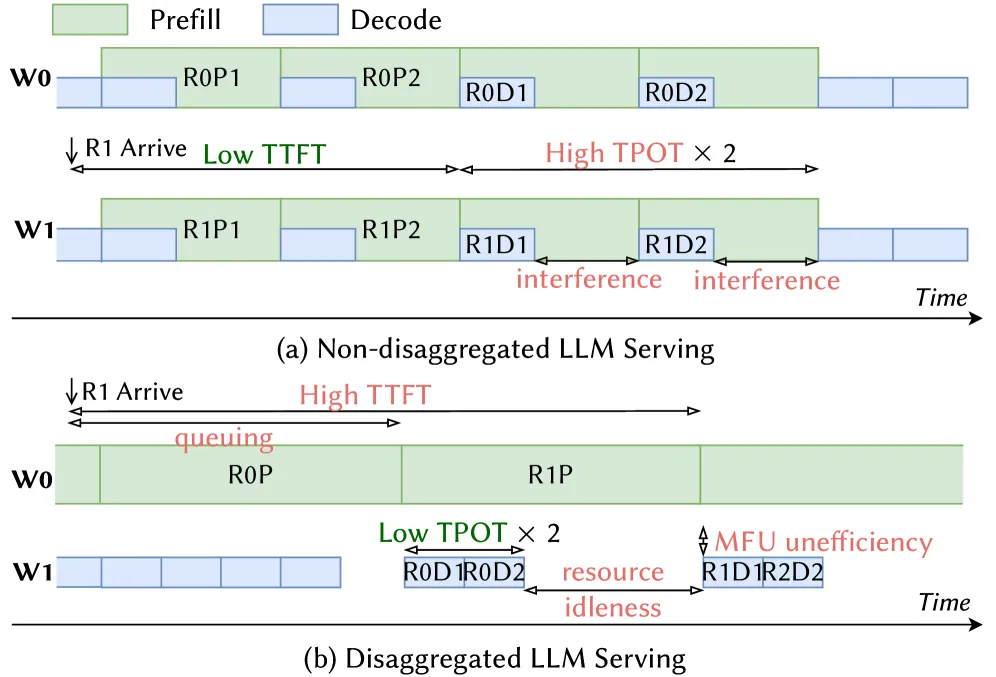
无单一架构可同时最优。
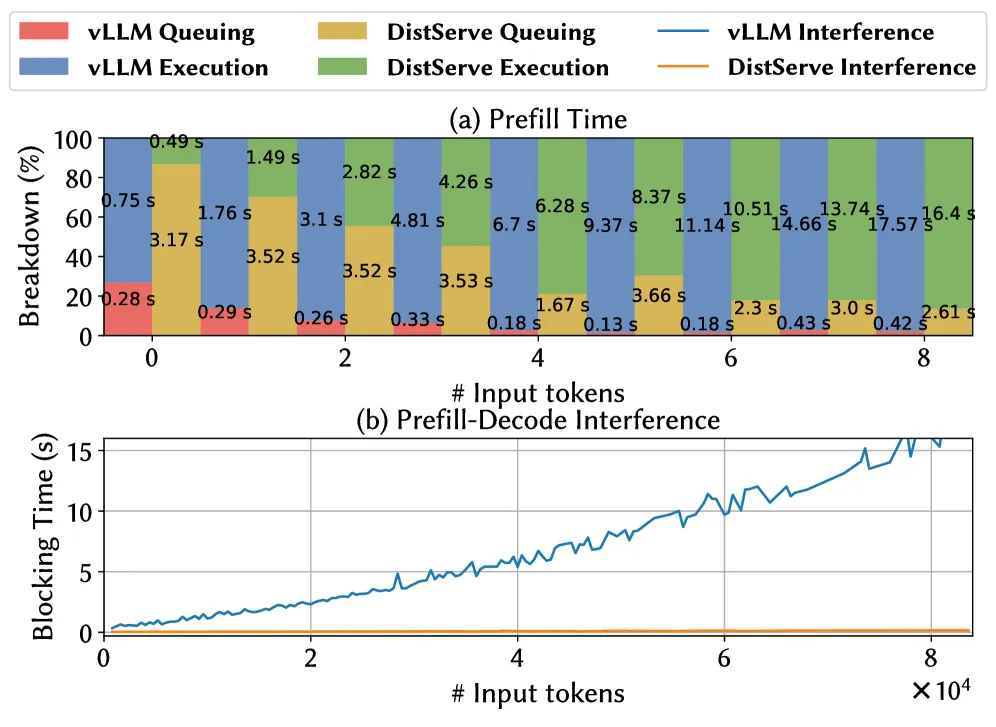
- Prefill 短时排队 dominates(~10× 执行时间),非分离胜;
- Prefill 长时干扰 dominates(KVCache 迁移比 prefill 便宜),分离胜。
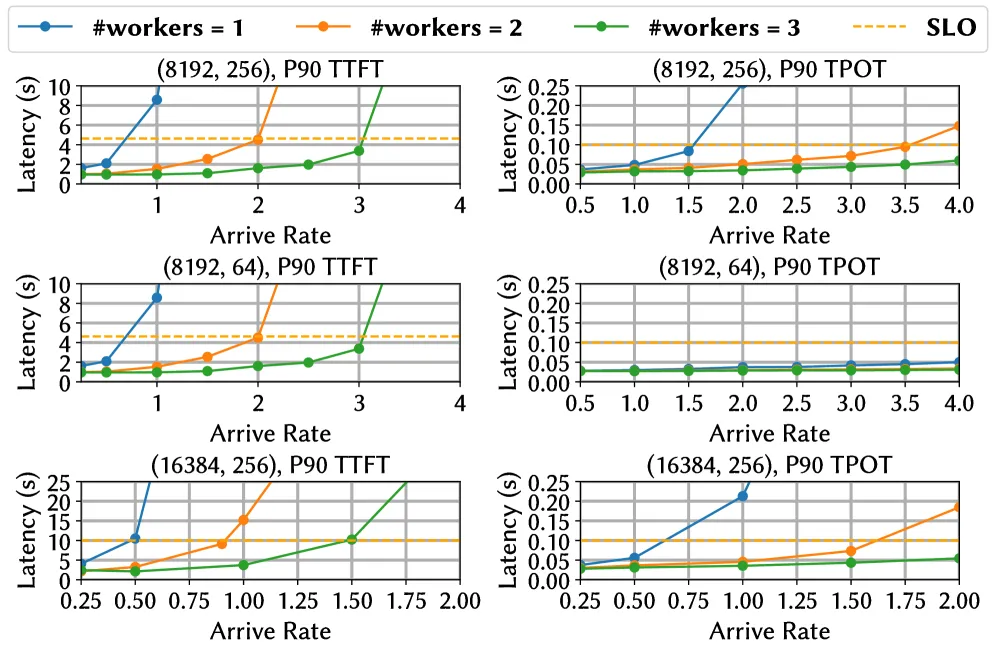
静态 prefill:decode 比例难以匹配动态负载(同数据集不同 (输入, 输出) 长度下最优比例差异大,甚至可达 9:1)。
解决方案:Tropical 提出 SLO-aware 多路复用:分离架构基础上给 decode worker 保留角色可变余地(multiplexing worker),当其 TPOT slack 足够时插入 prefill 请求,减少 prefill 排队;否则维持分离,保证 TPOT。
三、技术架构/方法
3.1 总体架构
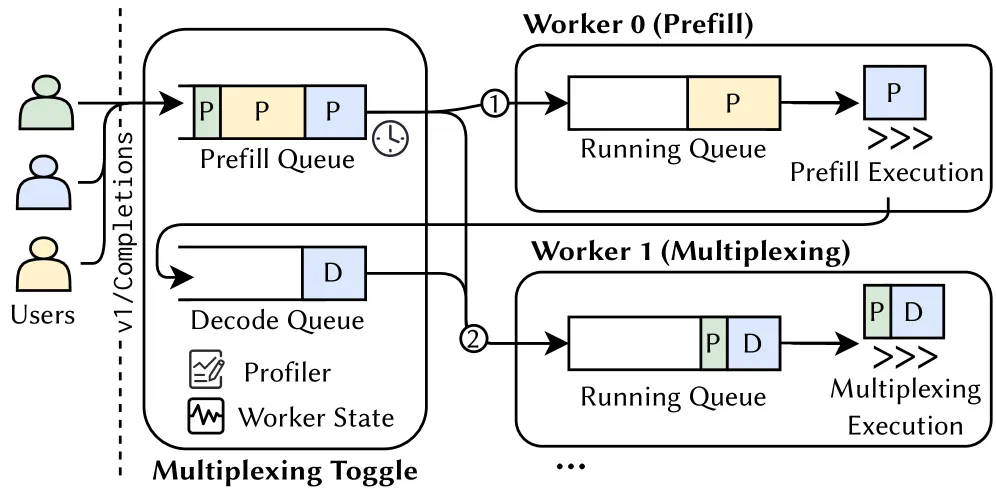
组成:
- Multiplexing Toggle:全局调度器,负责 worker 角色分配(prefill worker vs multiplexing worker)与请求 dispatch。
- Workers:可执行 prefill 或 decode,由 toggle 决定。
请求先入 prefill 队列,toggle 依照 SLO 判断走 Path ①(进 prefill worker)或 Path ②(进 multiplexing worker 直接做 prefill)。
3.2 SLO-Aware 多路复用
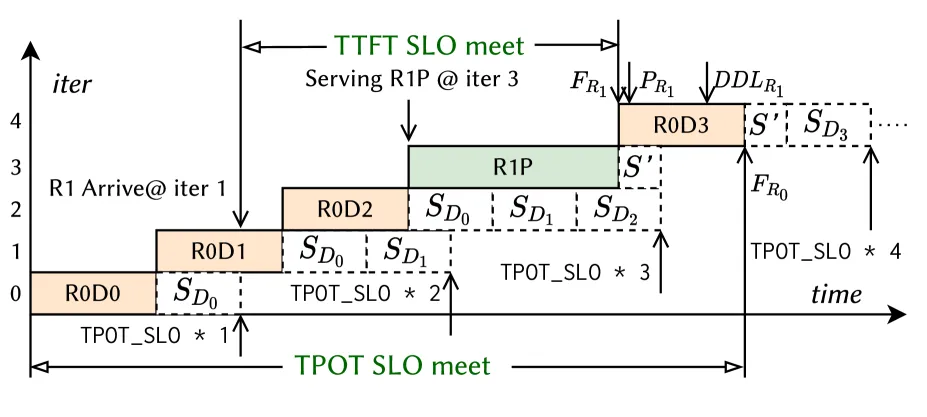
- 单次 decode 迭代记录 TPOT slack = TPOT SLO − 实际 decode 时间。
- 当预测的 prefill 执行时间 ≤ 可用 slack 时,把 prefill 放入 multiplexing worker(decode 期间“借道”执行 prefill),不违反 TPOT。
- 优先放短 prefill(排队占主导,非分离更佳);长 prefill 仍走独占 prefill worker(干扰主导,需分离)。
3.3 Multiplexing Toggle 机制
- Toggle 监控每个 worker 的 HBM watermark 与本地队列,通过 offline profiling 预测 prefill 执行时间与排队时间。
- Path ①:仅当
predicted_exec + predicted_queue ≤ TTFT slack时才发至 prefill worker。 - Path ②:仅当
multiplexing worker 当前 decode batch 执行时间 + prefill exec ≤ TPOT slack时才允许插入 prefill。 - 二级保守判断保证不违反任一 SLO。
由于 decode 是有状态的,多路复用只允许「decode worker → prefill」方向的临时插入(无需迁移 KVCache),避免了 stateful decode → prefill 的迁移或重算问题。
3.4 与 chunked-prefill 的区别
vLLM 的 chunked-prefill 只将 prefill 切成 2048-token chunks 交错执行;chunk 计算时间会随索引增长且仍会干扰 decode。Tropical 显式基于 SLO slack 决策,能保留大段 prefill 集中执行的效率,同时避免 TPOT 违反。
四、核心创新
| 创新点 | 说明 |
|---|---|
| SLO-aware 多路复用 | 分离/共置架构的动态融合:借用 decode slack 服务短 prefill,兼得低干扰与低排队 |
| Slack 双路径检测 | Path ① 检查 TTFT slack;Path ② 检查 TPOT slack;均保守估计 |
| 可复用角色的 worker | 通过 toggle 分配 prefill/multiplexing 角色,避免 decode→prefill 状态迁移代价 |
| 干扰抑制器 | prefill worker 在干扰主导时充当抑制器,降低对 decode 的冲击 |
| Offline profiling 驱动预测 | 利用 LLM prefill 执行时间高可预测性作调度依据 |
五、实验结果
5.1 实验设置
- 8× A100 80GB,600 GB/s P2P NVLink;InternLM-20B(200K 上下文)。
- 8 GPU 分 4 worker,每 worker TP=2;Tropical/DistServe 均为 2 prefill worker + 2 decode/multiplexing worker。
- 数据集:Mooncake 真实长上下文 trace;SLO:TTFT SLO = 5× 光负载下延迟。
- Baseline:vLLM、vLLM+chunked prefill (chunk=2048)、DistServe(基于 vLLM 的分离实现)。
- Dispatch 策略统一 InFaas(fewest unfinished tokens)。
5.2 SLO Attainment
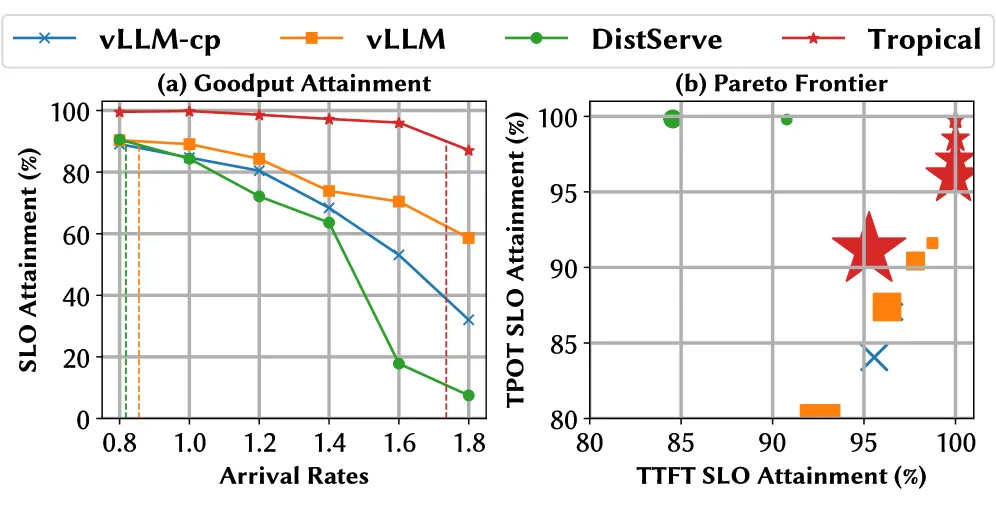
- Tropical 相较基线在 90% SLO 达成下可承接 2.02×(论文摘要口径最高 2.09×)请求量。
- Pareto 前沿显示 DistServe 被 TTFT 拖累,vLLM 被 TPOT 拖累;Tropical 同时改进两者。
- Chunked-prefill 由于 chunk 计算时间随索引增大,末端仍违反 TPOT。
5.3 延迟
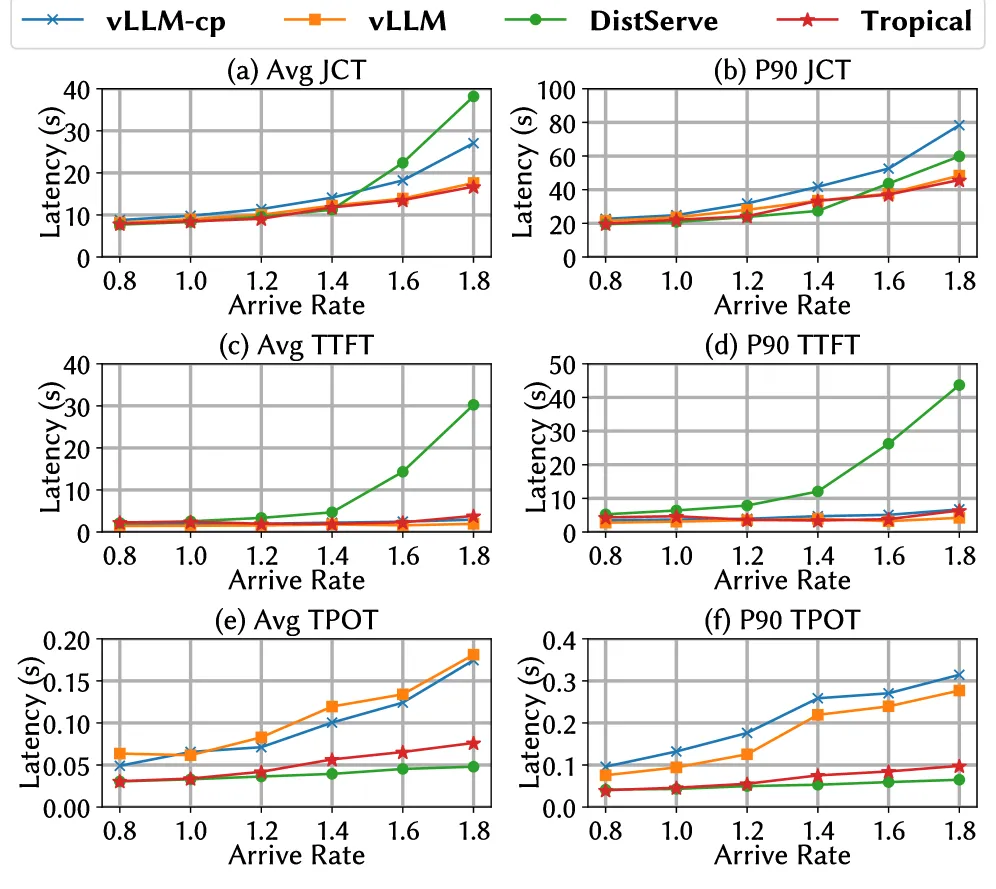
- P90 TTFT vs DistServe:9× 提升。
- P90 TPOT vs vLLM / vLLM+chunked:最高 2.33×(论文摘要口径 2.8×)。
- Tropical TPOT 略低于纯 DistServe,但整体 SLO 达成明显更高。
5.4 排队时间
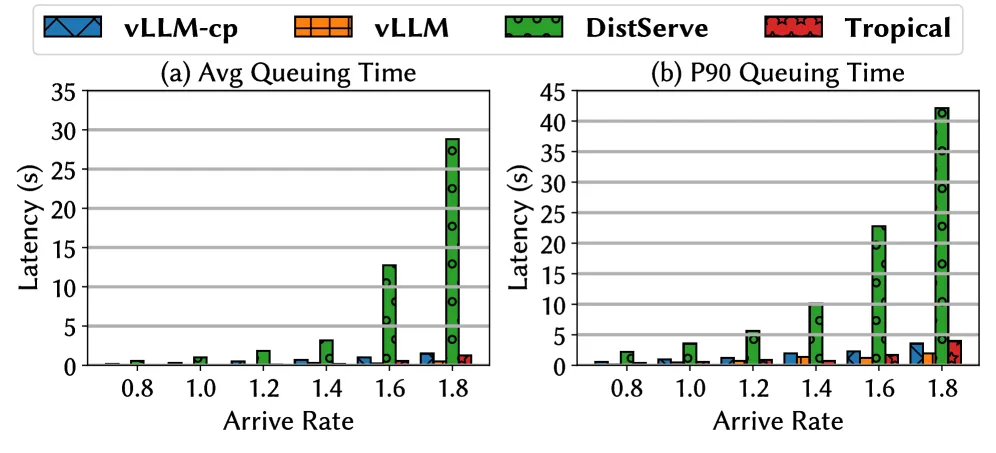
- P90 排队时间 vs DistServe:9× 改善;说明 TTFT 提升源自减少排队。
- 高到达率下 Tropical 平均/P90 排队时间略高于 vLLM,但通过 prefill worker 抑制干扰使 TTFT 与 vLLM 基本相当。
5.5 CDF
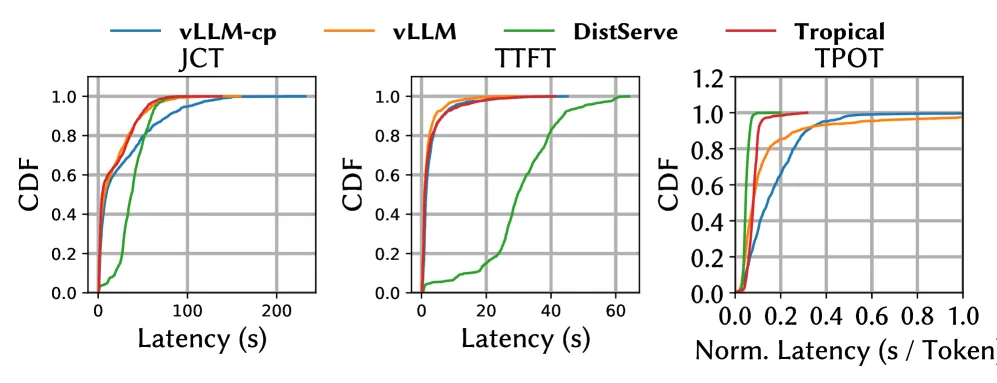
- 其他系统尾延迟显著;Tropical 兼顾 TTFT 与 TPOT,全分布上取得平衡。
5.6 关键量化摘要
- 相比 disaggregated 系统:P90 TTFT 提升 9×,P90 TPOT 仅下降 15%。
- 相比 non-disaggregated 系统:P90 TPOT 提升 2.8×,P90 TTFT 保持相当。
- SLO 内可承接请求量提升 最高 2.09×(平均 2.02×)。
六、总结
核心贡献
- 首次系统地识别 disaggregated / non-disaggregated 分别被排队与干扰主导,且长短 prefill 各有优势的经验规律。
- 提出 SLO-aware 多路复用,通过 slack 检测把两种架构的优点动态融合。
- 通过 offline profiling + 双路径保守判断,避免 decode→prefill 状态迁移代价。
- 在 InternLM-20B + Mooncake 真实 trace 上大幅提升 SLO 达成率。
技术影响
- 为 LLM serving 提供「架构不再二选一」的调度范式,可与 chunked-prefill、DistServe 等已有工作正交组合。
- 引入 slack 作为一等公民信号,为 SLO-aware 系统设计提供新工具。
局限性
- Slack 检测依赖 offline profiling 精度;模型或硬件切换时需重新 profile。
- 只支持「decode worker 借道 prefill」单向切换,无法解决 prefill 侧空闲时向 decode 迁移的问题。
- 目前仅评估 InternLM-20B 单模型;小/大模型的 slack 特性差异未展开。
- 与更细粒度调度(chunked-prefill、Sarathi 等)叠加的收益尚未探索。
七、参考资源
- arXiv: https://arxiv.org/abs/2606.16264
- HTML: https://arxiv.org/html/2606.16264v1
- 主题:cs.DC
- 相关系统:vLLM、DistServe、Mooncake、Sarathi、Andes