Service-Induced Congestion in Memory-Constrained LLM Serving
将 LLM 连续批处理下的 KV-Cache 内存增长建模为离散动力系统,证明同质负载下无驱逐平衡点不稳定,最坏极限环吞吐损失可达 50%;异质负载在共素解码长度下才能稳定;给出速率限制准入与请求混合两种消驱逐策略。
Service-Induced Congestion in Memory-Constrained LLM Serving
一、论文概述
| 项目 | 内容 |
|---|---|
| arXiv ID | 2606.15555 |
| 标题 | Service-Induced Congestion in Memory-Constrained LLM Serving |
| 作者 | Ruicheng Ao, Jing Dong, Gan Luo, David Simchi-Levi |
| 机构 | MIT · Columbia Business School · Peking University |
| 提交日期 | 2026-06-14 |
| 学科 | math.OC; cs.AI; cs.LG; stat.ML |
| 链接 | https://arxiv.org/abs/2606.15555 |
二、核心思想
问题定义:现代 LLM 推理采用连续批处理(continuous batching)并维持 KV-Cache。请求每生成一个 token 就使 GPU 显存单调增长,服务过程本身内生地积累”未来容量压力”——一种传统排队论未涵盖的服务诱发拥塞(service-induced congestion)。当显存被耗尽时,系统必须驱逐(evict)正在运行的请求,之后再重新执行,从而浪费算力、降低吞吐。
解决方案概述:作者建立一个离散时间动力系统模型来描述”执行 → 到达 → 驱逐 → 准入”的每一步;在饱和输入体制下刻画其平衡点和极限环。核心结论:
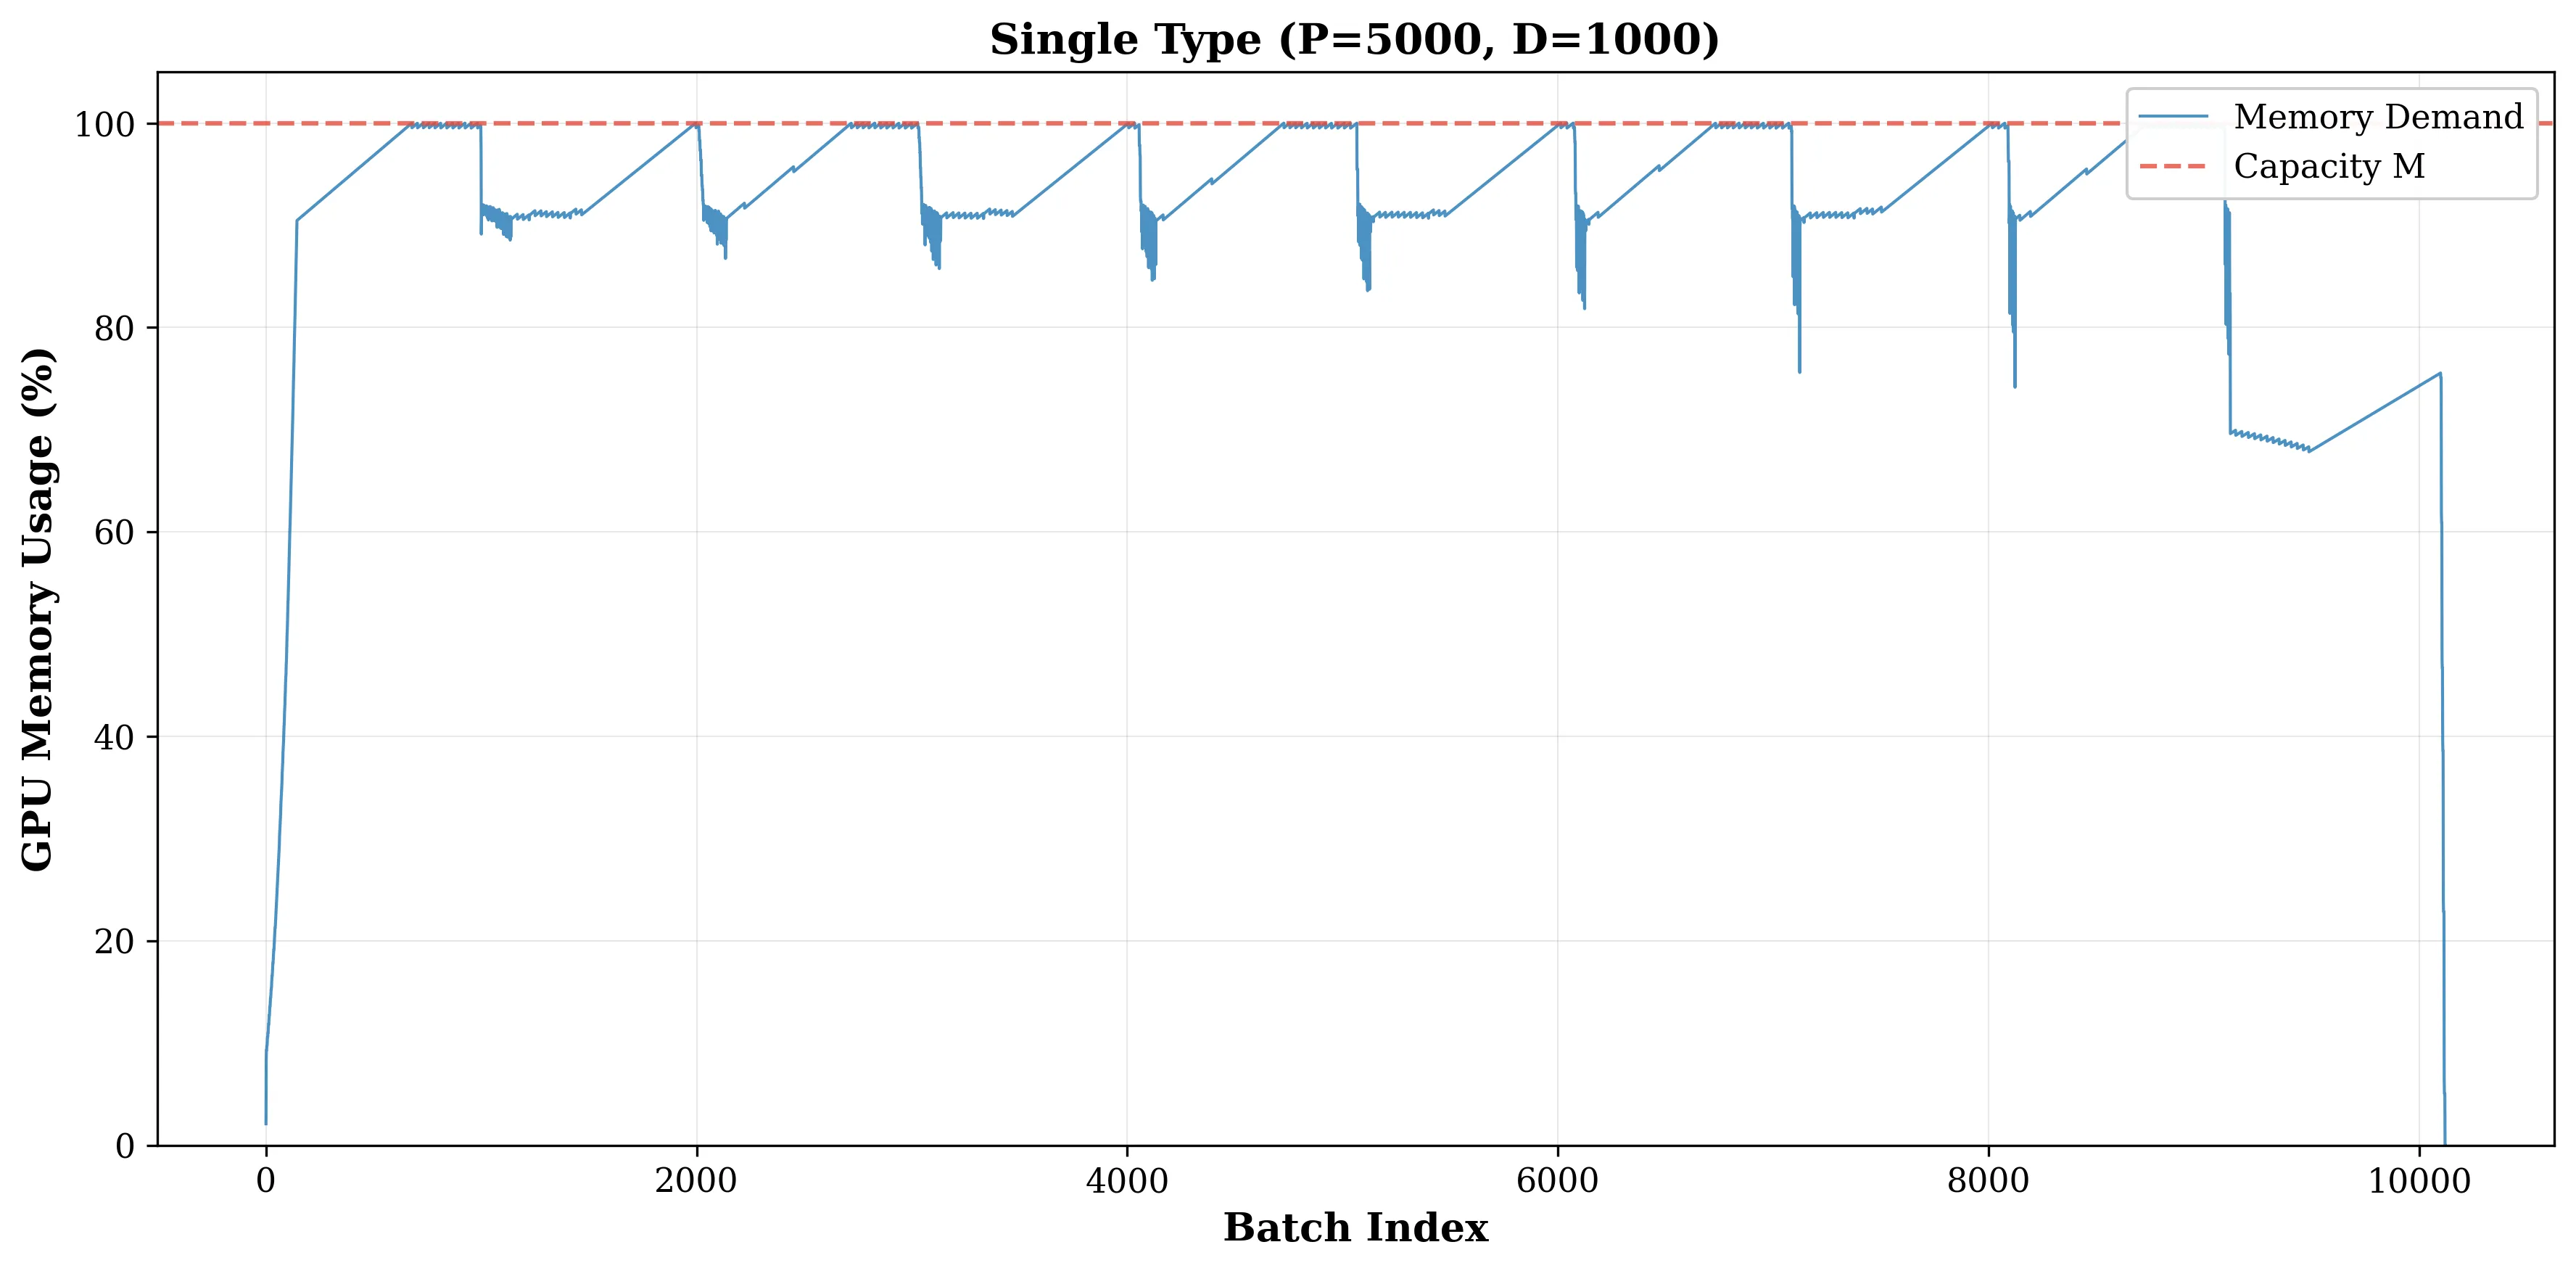
- 同质负载:无驱逐平衡点结构性不稳定,系统几乎必然收敛到唯一的”最坏极限环”,吞吐损失可高达 50%。
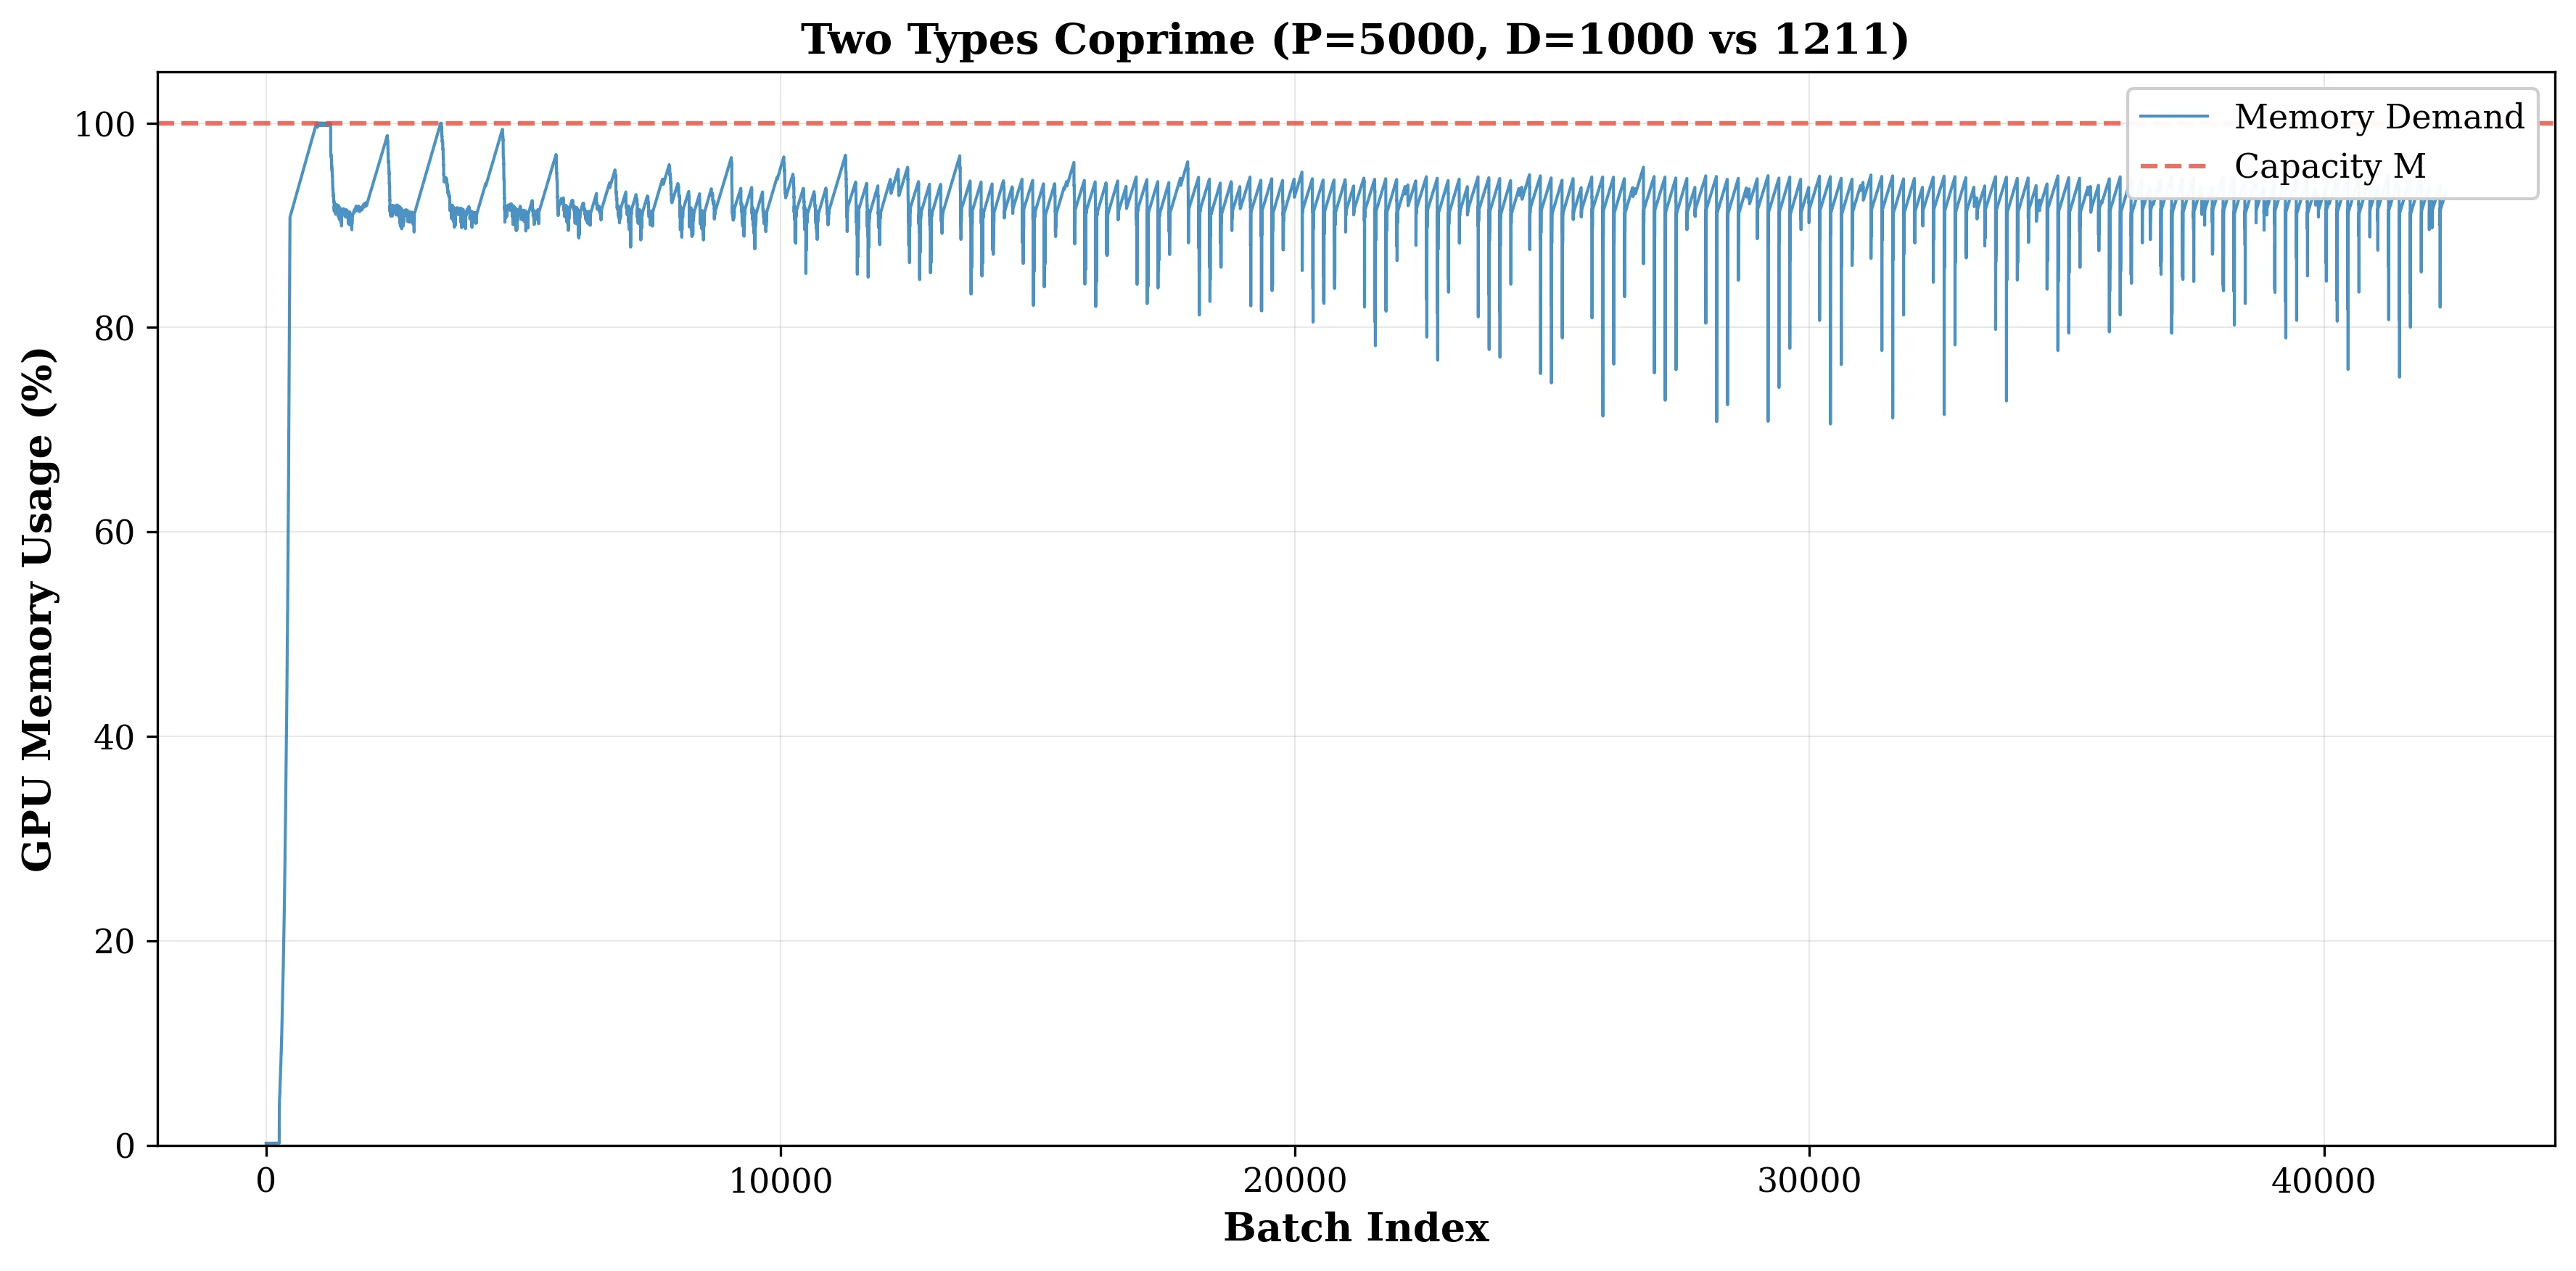
- 异质负载:两类共同输入长度下,无驱逐平衡点稳定当且仅当两个解码长度互素(coprime);当解码长度共享公因子时,完成事件周期性同步,驱动系统进入驱逐。
- 控制策略:给出(1)速率限制准入(rate-limited admission)与(2)请求混合(request mixing)两种可实施的调度原则。
三、技术架构 / 方法
3.1 离散时间动力系统
每个调度周期内四个动作依次发生(Execute → Arrive → Evict → Admit)。定义 为第 步的准入向量, 为存活位置上的归一化质量向量。设 为输入长度、 为解码长度、 为显存容量,则饱和输入体制下无驱逐等式给出稳态准入量:
对应无驱逐吞吐 。
3.2 同质工作负载的结构不稳定性(Theorem 2)
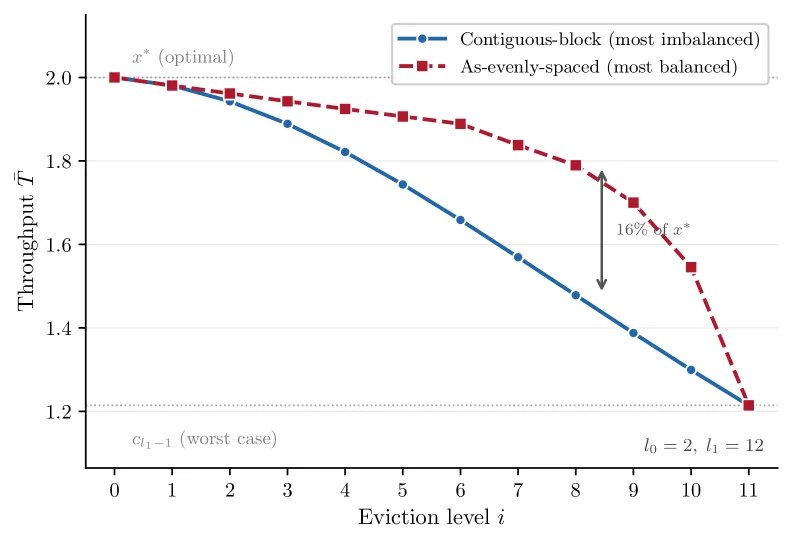
作者证明:在标准连续批处理策略下,无驱逐固定点是不稳定的;中间驱逐级别的极限环也不稳定;除去一个 Lebesgue 零测的”精准捕获集”,系统渐近收敛到唯一的最大驱逐极限环。当 较大时,最坏环的吞吐相对无驱逐平衡点可下降近 50%。
关键技术为不平衡放大、支持丢失分析与循环稳定性论证的组合。
3.3 多类工作负载的数论稳定性(Theorem 3)
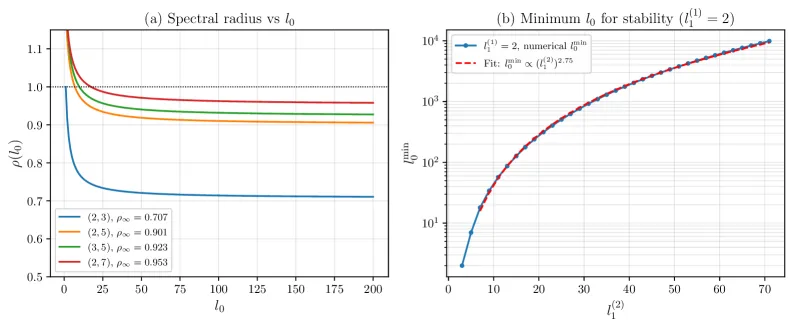
两类同输入模型 :对无驱逐平衡点作线性化,得到扰动的有限阶递推,其特征多项式在大输入尺度下的根结构完全由解码长度决定。
机制是同步与去同步:非互素时完成事件周期对齐、产生振荡模态并驱动驱逐;互素时完成相位相对漂移,去同步显存释放并阻尼扰动。附录 B 将该结论推广到多类以及异质输入长度。
3.4 面向消除驱逐的控制策略
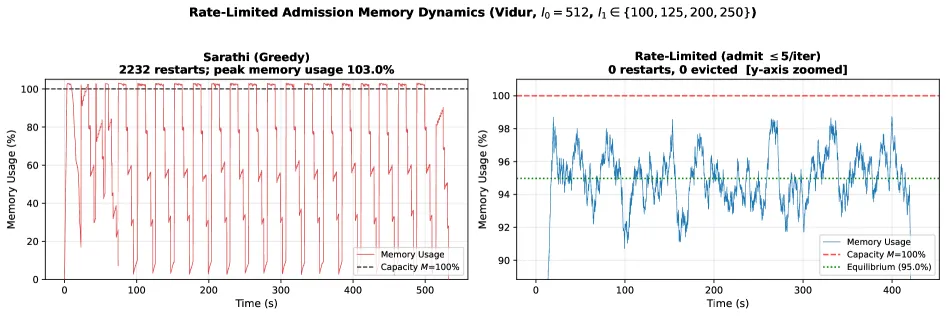
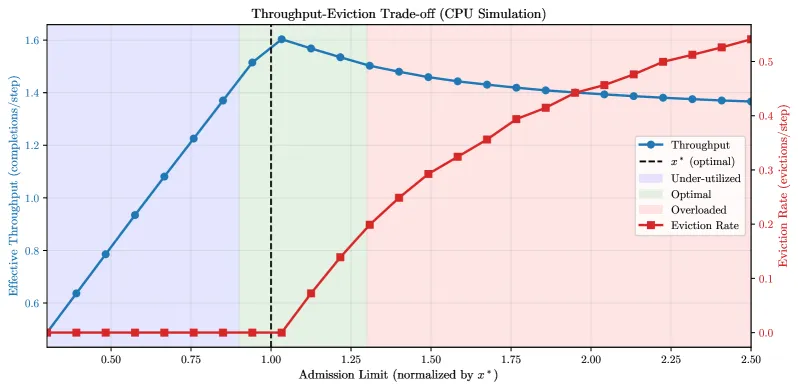
(1)速率限制准入:使用理论推导出的无驱逐准入率作为每次迭代的上限,避免贪心准入触发驱逐级联;同时保持接近满利用率。
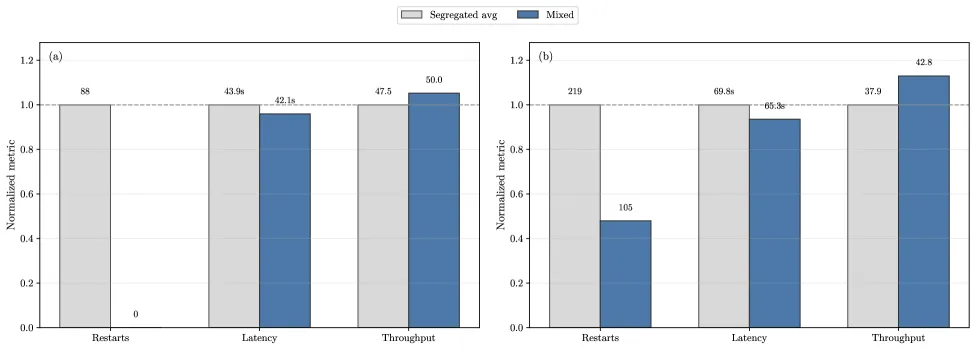
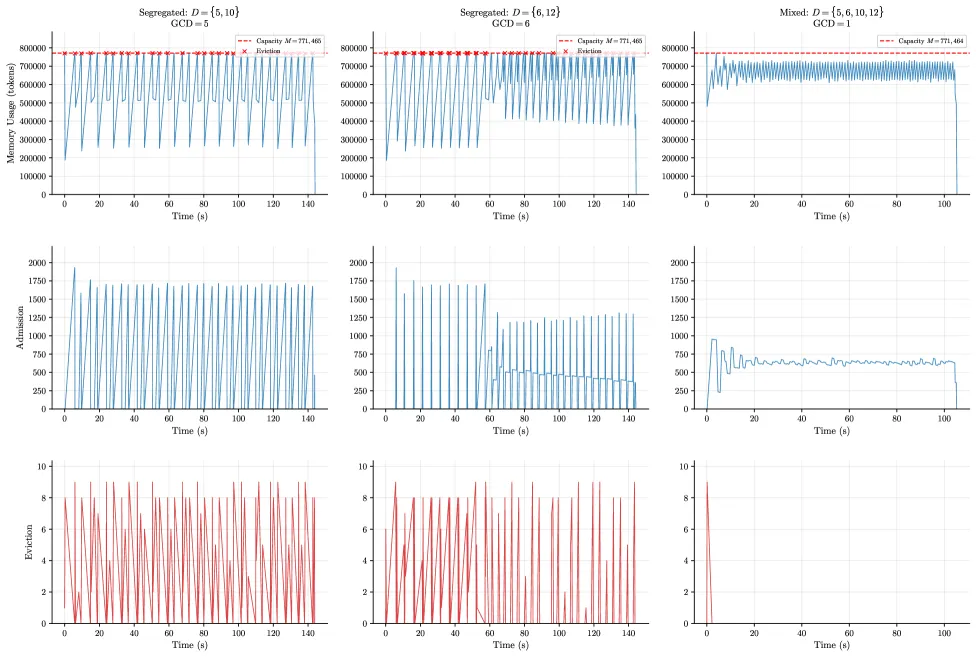
(2)请求混合(Request Mixing):将解码长度不同的请求路由到同一节点,利用互素性打破同步。即便只是”部分 GCD 缩减”(把公因子从大降到较小),也能显著改善。
四、核心创新
| 创新点 | 说明 |
|---|---|
| 服务诱发拥塞模型 | 首次以离散动力系统刻画 KV-Cache 内存内生增长与驱逐的耦合,独立于随机到达波动分析结构性不稳定 |
| 最坏极限环刻画 | 同质负载下几乎必然收敛到唯一最坏环,量化最高 50% 吞吐损失 |
| 数论稳定性判据 | 双类共同输入下”互素 ↔ 稳定”充要条件,将稳定性归结于解码长度的算术结构 |
| 消驱逐控制原则 | 速率限制准入 + 请求混合两条可工程化的调度规则 |
| 分析工具 | 特征多项式 + Lyapunov + 支持丢失分析等适用于”随时间增长资源需求”的服务系统 |
五、实验结果
评测使用模型驱动仿真、Vidur 高保真 LLM 推理仿真器和真实 GPU 单节点实验。
- 同质情形:贪心准入使实际内存超过容量 的调度周期占 25.2%(Vidur 运行),产生周期性驱逐;速率限制后系统稳定在无驱逐平衡点附近,接近满利用。
- 异质情形(模型仿真):在 的 Poisson 到达下,最坏环吞吐是无驱逐吞吐的 ~50%。
- 两类共素 vs 非共素:共素 显存曲线保持在容量以下、无驱逐;非共素则出现驱逐周期。
- 部分 GCD 缩减:混合 与 (GCD 从 25 降到 25 但相对更小)已能减少同步驱逐。
- 真实 GPU 实验:同质与两类互素设定下,混合与速率限制均把驱逐次数压至个位数或消除,实测显存曲线与理论最坏环吻合。
六、总结
- 核心贡献:把 LLM 服务的显存动力刻画为一个具有算术结构的动力系统,提出”服务诱发拥塞”这一新拥塞机制,并给出充要稳定性判据与两条控制策略。
- 技术影响:将连续批处理与内存管理系统研究从”实现层”提升到”稳定性理论层”,为 vLLM/TensorRT-LLM 之类系统的准入与路由策略提供可解释设计准则。
- 局限性:分析主要在饱和输入体制与常数输入长度下;数论条件在解码长度随机分布的真实系统中需要更精细的推广;策略是启发式且未与更复杂的 SLO 感知调度联合优化。
七、参考资源
- 论文原文:arXiv:2606.15555
- 相关系统:Orca (continuous batching)、vLLM (PagedAttention)、Vidur 仿真器
- 相关理论:连续批处理下的排队分析(Li et al. 2025;Ao et al. 2025)