Coordinated Scheduling for MoE LLM Serving
Gimbal 为 MoE LLM 推理设计跨层协同调度:前端基于 KV / prefill / 队列 / 专家压力的细粒度 DP 引擎选择 + 引擎内 SJF+aging 队列;后端结合源感知路由统计与 MINLP 校准的启发式专家放置,实现前后端反馈闭环,在 vLLM 之上将 TTFT 降 42.9%、TPOT 降 33.3%,高负载吞吐提升 3.0%。
Coordinated Scheduling for MoE LLM Serving (Gimbal)
一、论文概述
| 项目 | 内容 |
|---|---|
| arXiv ID | 2606.15177 |
| 标题 | Coordinated Scheduling for MoE LLM Serving |
| 作者 | Yifan Sun, Zhexiang Zhang, Jiantong Jiang, Gholamreza Haffari, Minxian Xu, Feng Liu, Rajkumar Buyya, Adel N. Toosi |
| 机构 | University of Melbourne · Monash University · SIAT, CAS |
| 会议 | ACM SIGOPS ATC 2026 |
| 提交日期 | 2026-06-13 |
| 学科 | cs.DC |
| 链接 | https://arxiv.org/abs/2606.15177 |
二、核心思想
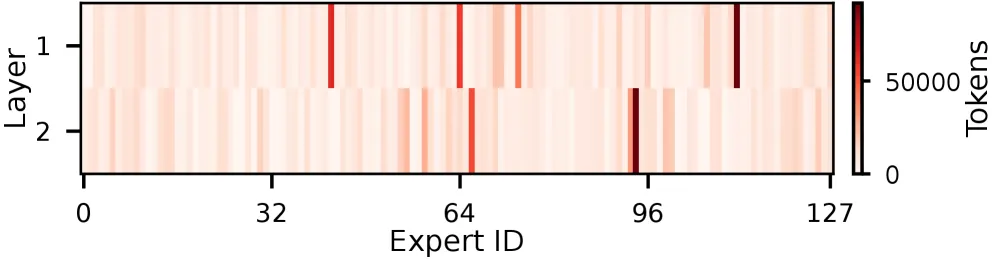
问题定义:MoE LLM 推理通常同时使用数据并行(DP)+ 张量并行(TP)+ 专家并行(EP)。动态请求负载与稀疏专家路由耦合,产生两类不均衡:DP 引擎不均衡与专家级热点。现有系统的前端调度器只看请求计数、后端专家均衡器只看聚合激活计数,两者相互隔离,忽略细粒度引擎压力、后端 MoE 压力与源相关的专家流量。
解决方案:提出 Gimbal,一个跨层协同调度框架:
- 细粒度 DP 引擎调度:使用运行/等待 prefill tokens、KV 使用率、后端 MoE 压力等在线信号选目标引擎;引擎内用 SJF + aging 减少 HOL。
- 源感知专家放置:在线收集”DP 源 → 专家”路由统计,以 MINLP 参考解校准的启发式联合优化专家负载、跨 DP 通信、迁移开销。
- 后端专家压力回馈前端 DP 调度器,形成闭环。
三、技术架构 / 方法
3.1 系统架构
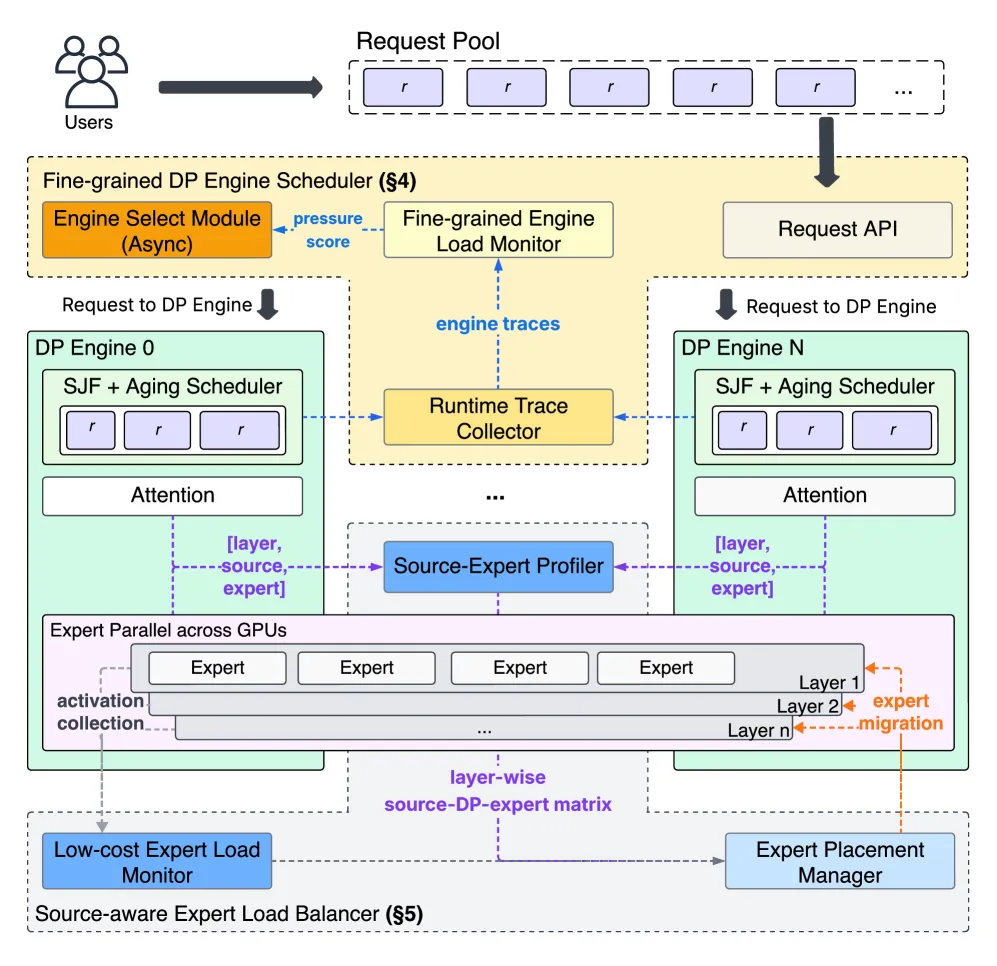
Gimbal 包含 Fine-grained DP Scheduler + Source-aware Expert Load Balancer。DP 引擎异步上报 4 类运行时状态:
- 运行请求的剩余 prefill tokens
- 等待队列 prefill tokens
- KV cache 使用率
- 后端 MoE 专家压力
3.2 压力感知引擎选择
KV 优先:若某引擎 KV 使用率明显更高,直接选低 KV 引擎;否则用加权得分融合剩余 prefill、等待 tokens、近期分发补偿、KV 惩罚、MoE 专家压力惩罚。
选择公式(示意):
引擎内使用 SJF-style(按剩余 prefill 长度升序)+ aging 保证长请求不饥饿。
3.3 源感知专家放置
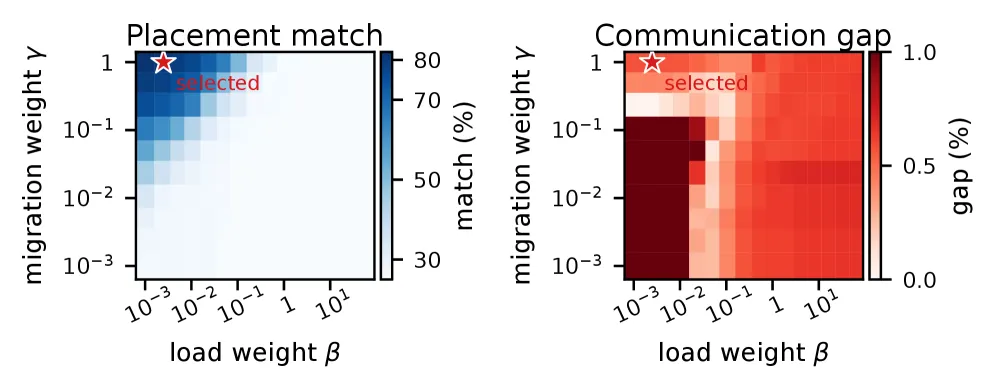
在线统计 layer-wise 源-专家矩阵 (层 × DP 源 × 专家)。放置目标:最小化通信 + 负载不均衡代价,同时惩罚迁移。原始 MINLP:
MINLP 只作离线参考;在线用按专家热度降序的贪心算法,权重通过 MINLP 校准,避免过度反应短窗负载波动。
3.4 反馈闭环
后端专家迁移会改变 EP rank 上的负载分布,Gimbal 将该压力回馈 DP 调度器,防止新请求继续压向已经承担高专家压力的 co-located 引擎。
四、核心创新
| 创新点 | 说明 |
|---|---|
| 细粒度 DP 引擎调度 | 从请求计数升级到 token 级运行时压力信号(prefill/KV/queue/MoE) |
| 源感知专家放置 | 首次将 DP-源 → 专家路由矩阵在线收集并纳入放置代价 |
| MINLP 校准启发式 | 用离线 MINLP 参考校准在线贪心,兼顾质量与开销 |
| 跨层反馈闭环 | 专家压力回灌 DP 调度,前后端协同 |
| 无需输出长度预测的 SJF+aging | 引擎内轻量重排减少 HOL blocking |
五、实验结果
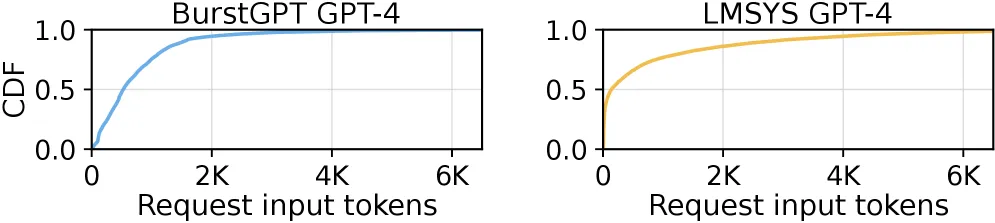
测试床:2× Intel Xeon 8462Y+,4× H100 80GB NVLink,1 TB 内存;模型 Qwen3-30B-A3B;配置 DP=2, TP=2, EP=4。 数据集:BurstGPT(Random / Central / Descending / Two-end / Average 五种分布),每分布 1000 请求 × 3 seed。 基线:vLLM(默认 request-count DP + EPLB)、MoETuner、Sem-MoE(含 oracle)。
端到端延迟
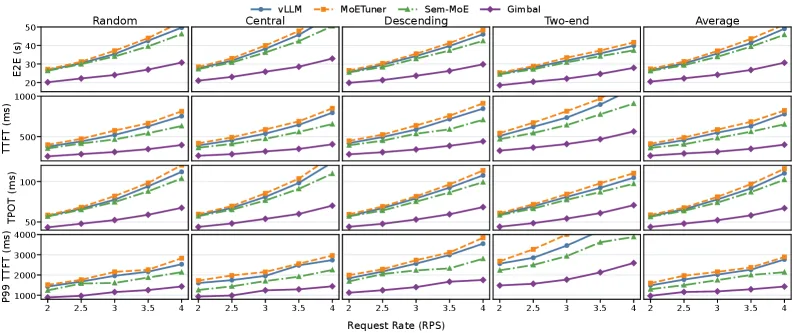
- 相比 vLLM:mean E2E ↓ 32.0%,TTFT ↓ 42.9%,TPOT ↓ 33.3%,P99 TTFT ↓ 44.3%。
- 相比 MoETuner:E2E ↓ 34.7%,TTFT ↓ 47.0%,TPOT ↓ 36.2%。
- 相比 Sem-MoE:E2E ↓ 28.5%,TTFT ↓ 34.7%,TPOT ↓ 29.5%。
- 高负载放大:TTFT 相对 vLLM 的降幅从 RPS=2 的 33.1% 升至 RPS=4 的 48.3%;TPOT 从 24.1% 升至 38.4%。
吞吐
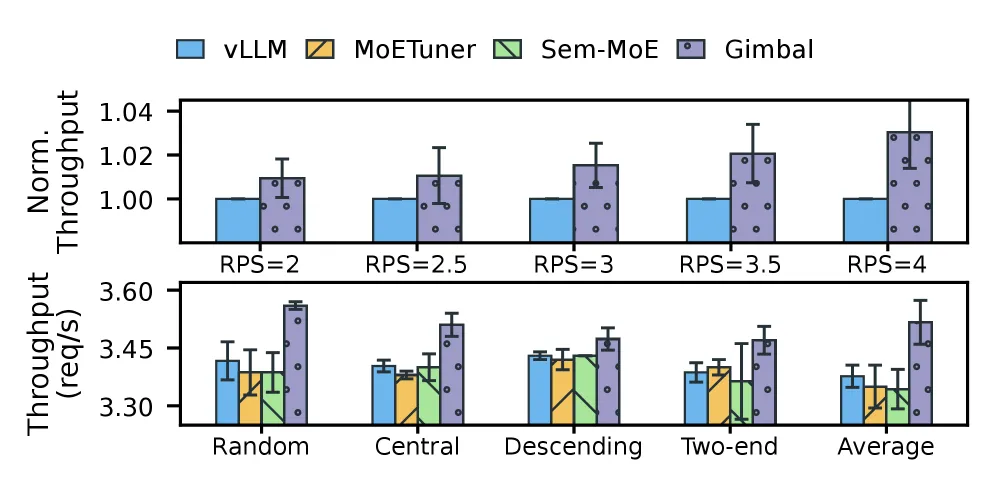
- 每档 RPS 均高于 vLLM:0.94% (RPS=2) → 3.04% (RPS=4)。
- RPS=4 时不同分布提升 1.26%–4.20%。
消融
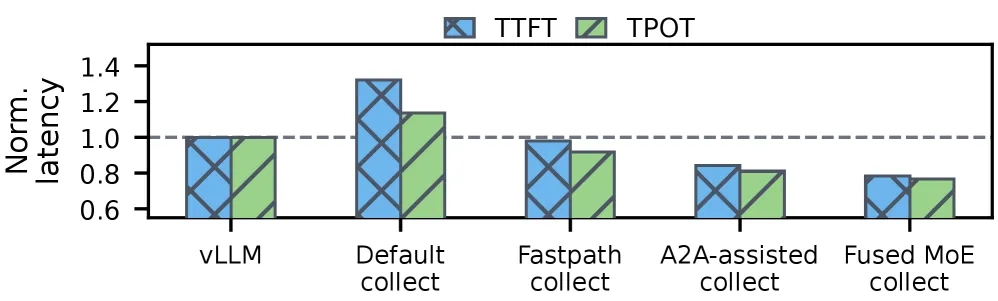
- Gimbal-DP:TTFT ↓25.1%,TPOT ↓13.4%。
- Gimbal-EP:TTFT ↓26.2%,TPOT ↓22.7%。
- Gimbal-All(无 collab):TTFT ↓29.8%。
- 完整协同版进一步扩大领先,验证跨层反馈的必要性。
案例细节
RPS=4 Random 轨迹:vLLM 两引擎运行请求 91/90、KV 26–27%、prompt 吞吐差 1.24K tok/s;Gimbal 降至 58/57、17% KV、0.74K tok/s 吞吐差。
系统开销
源感知矩阵采集的归一化延迟开销可忽略。
六、总结
- 核心贡献:提出面向 MoE 服务的跨层协同调度框架 Gimbal,把 DP 引擎压力与源感知专家路由统计闭环耦合。
- 技术影响:把 LLM serving 前端调度从 request-count 抽象升级到 token-level 多维压力向量,并首次用 MINLP 校准在线专家放置,可直接嵌入 vLLM 等系统。
- 局限性:目前仅在 4× H100、DP=2/TP=2/EP=4 与 Qwen3-30B 上验证;启发式权重虽经 MINLP 校准但仍与工作负载弱相关;缺少与 speculative decoding、chunked prefill 等其他优化的联合评估。
七、参考资源
- 论文原文:arXiv:2606.15177
- 相关工作:vLLM、SGLang、FastServe、Preble、MoETuner、Sem-MoE、EPLB (DeepSeek)
- 数据集:BurstGPT、LMSYS-Chat-1M