Characterizing Software Aging in GPU-Based LLM Serving Systems
首次系统性研究GPU上LLM推理引擎的软件老化现象。以三种部署栈(vLLM standalone/Triton+vLLM/PyTorch+HF)在NVIDIA L40S上做6×36小时=216小时压力测试,结合Mann-Kendall/Theil-Sen统计流水线,发现所有部署均存在统计显著的进程私有内存泄漏,泄漏率跨约两个数量级(1.8→157 KB/h),且最脏配置为Triton包裹的旧V0引擎。
Characterizing Software Aging in GPU-Based LLM Serving Systems
一、论文概述
| 项目 | 内容 |
|---|---|
| arXiv ID | 2606.11916 |
| 标题 | Characterizing Software Aging in GPU-Based LLM Serving Systems |
| 作者 | Domenico Cotroneo, Bojan Cukic |
| 提交日期 | 2026-06-10 |
| 学科分类 | cs.SE, cs.AI |
| 关键词 | LLM Serving, Software Aging, Memory Leak, vLLM, Triton, Reliability |
二、核心思想
问题定义:近三十年来,软件老化与再生(Software Aging and Rejuvenation, SAR)社区已在数据库、虚拟化、操作系统、区块链等 CPU 中心的长期运行系统中系统性地记录了随时间累积的性能退化(内存泄漏、资源耗尽、性能漂移)。然而对 GPU 上运行的 LLM 推理引擎(vLLM、NVIDIA Triton 等)——它们跨越 Python 宿主与 CUDA 设备两侧,请求代价可跨数个数量级、且代码栈仍在快速演进——软件老化行为几乎完全未被研究。生产团队通常仅关注分钟级的吞吐/延迟指标,对多天、多周窗口内的健康度基本无认知。
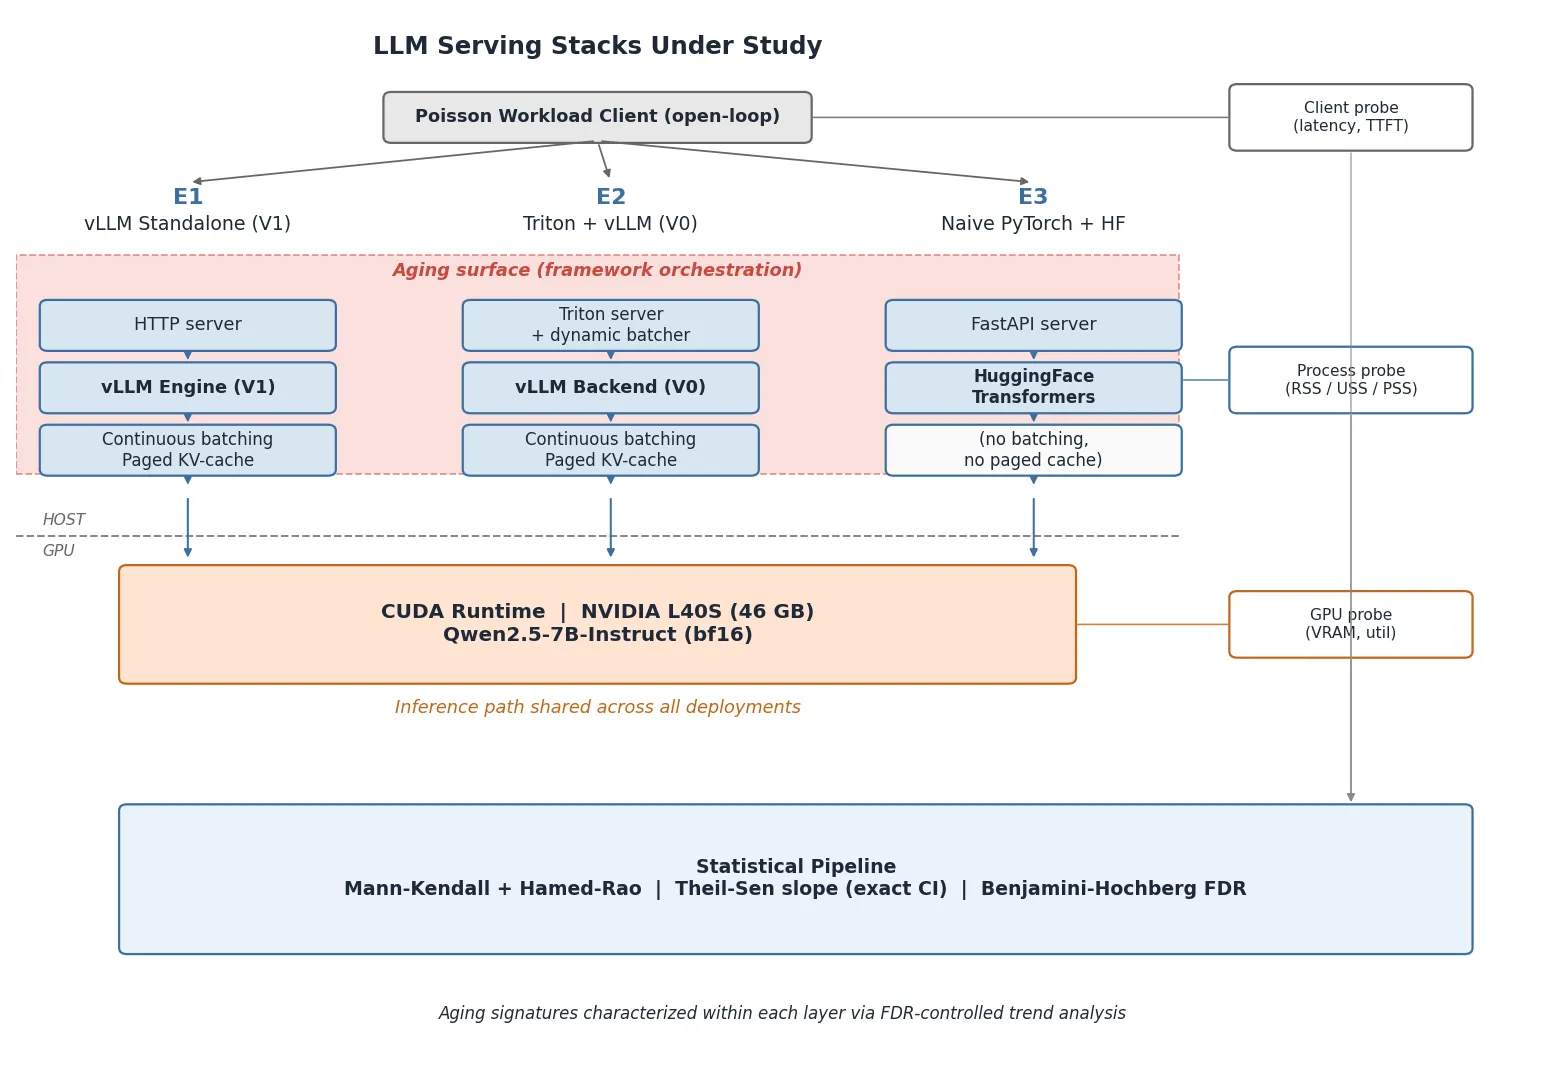
解决方案:作者提出一套面向 GPU-based LLM serving 的经验方法学:在同一台 NVIDIA L40S 主机上并行部署 3 种服务栈(每 GPU 一路),使用相同的开环 Poisson 负载(arXiv 摘要提示,最大长度到 7.5k token)连续压测 36 小时;再加两组针对性消融(低负载 E3b 和 vLLM V0/V1 × standalone/Triton 的 2×2 因子),累计 216 小时。监控 34 个宿主/进程/GPU/客户端指标,用具备自相关鲁棒性的统计流水线(Mann-Kendall 趋势 + serial-correlation 校正、Theil-Sen 斜率 + 精确 CI、Benjamini-Hochberg FDR)判定是否存在统计显著的老化趋势。
三、技术架构/方法
3.1 部署与工作负载
三种主部署(同一模型 Qwen2.5-7B-Instruct,bf16,L40S 46 GB VRAM):
- E1:vLLM standalone(V1 引擎,vLLM 0.21.0),目标 2.55 RPS
- E2:NVIDIA Triton 包裹 vLLM(V0 引擎,NV-patched 0.10.1.1),目标 2.17 RPS
- E3:朴素 PyTorch + HuggingFace transformers(FastAPI),目标 0.17 RPS(饱和)
消融:E3b(PyTorch 低负载 0.05 RPS),A1(vLLM V0 standalone,0.80 RPS),A2(Triton + V1,1.75 RPS)。
Prompt 由 3000 条 arXiv 摘要拼接到 log-normal 目标长度 256–7500 token(中位数 1500),输出长度 log-normal(中位 200,上限 1500),70% 流式。目标速率取”机械上限的 85%”。
3.2 监控与统计流水线
四类监控并行采样:GPU(1 Hz:VRAM/util/温度/功率/时钟/ECC)、进程(每 5 秒:USS/RSS/PSS、线程、FD、CPU、I/O)、宿主、客户端(延迟 p50/p95/p99、TTFT、吞吐、丢弃)。
判定规则:趋势测试与 CI 必须同时显著才计入老化。因监控序列高度自相关(),采用带 serial-correlation 校正的非参数检验,并对多重比较做 FDR 控制。
3.3 泄漏率估计
以 Theil-Sen 斜率作为每小时私有内存增长速率的鲁棒估计,主要看 USS(Unique Set Size,进程独占页);USS 与 RSS 斜率一致意味着增长发生在进程私有页而非共享映射,从而排除库共享内存伪影。
四、核心创新
| 创新点 | 说明 |
|---|---|
| GPU LLM Serving 上首个多引擎老化研究 | 覆盖 vLLM V0/V1、Triton wrapper、朴素 PyTorch+HF 三档”从研究原型到生产级”部署 |
| 自相关鲁棒的统计流水线 | Mann-Kendall + Sen slope + serial-correlation 校正 + FDR,比传统 SAR 研究更严谨 |
| 2×2 因子拆分老化来源 | 分离”vLLM 引擎代际(V0/V1)“与”托管层(standalone/Triton)“两个因子 |
| 可复现框架 | 提供 216 小时端到端复现方案,架起 SAR 与 LLM serving 社区桥梁 |
五、实验结果
5.1 客户端视角:几乎无退化
E1/E2/E3/A1/A2 的端到端 p50/p95/p99 延迟、TTFT、输出吞吐、丢弃率均稳态(Theil-Sen CI 包含 0)。仅 E1 出现极小的 p50 延迟上升(~5 ms/h,约占基线 2%),但输出吞吐同期反而略升,不构成”操作员可察觉的退化”。E3 全程稳态丢弃约 15.6%,是容量天花板而非增长损失。
5.2 进程视角:所有部署均有统计显著内存泄漏
USS 泄漏斜率(Theil-Sen 估计,95% CI):
| ID | 部署 | USS 斜率 /h | 95% CI |
|---|---|---|---|
| E1 | vLLM standalone (V1) | +1.8 KB | [0.7, 23.8] KB |
| E2 | Triton + vLLM (V0) | +157 KB | [33, 228] KB |
| E3 | PyTorch + HF naive | +31 KB | [21, 88] KB |
反直觉结论:最”干净”的不是朴素 PyTorch 而是 vLLM standalone;最脏的是 Triton 包裹的旧 V0 引擎,斜率相差近 100 倍。30 天投影约 1 MB / 22 MB / 110 MB。三者共享模型/推理路径,因此泄漏来源于 serving 基础设施而非推理内核本身。
5.3 负载消融
E3b(0.05 RPS 低载)泄漏反而更大(+103 KB/h vs. 饱和态 +31 KB/h),说明老化由时间驱动而非请求数驱动,与队列/饱和无关。同时 PyTorch 部署的虚拟内存增长远超 RSS(E3b 约 +127 MB/h VMS ≈ 30 天 90 GB),线程/FD 稳定,指向 CUDA caching allocator 的匿名地址空间持续预留。
5.4 2×2 因子分析:引擎代际 × 托管层
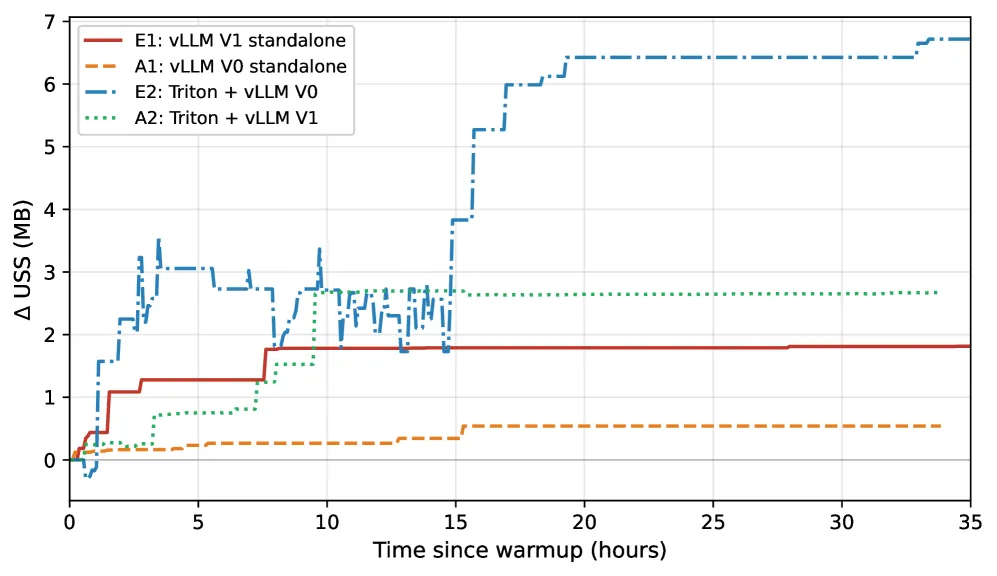
| V0 engine | V1 engine | |
|---|---|---|
| Standalone | A1: +13 KB/h | E1: +1.8 KB/h |
| Triton-wrapped | E2: +157 KB/h | A2: +5.9 KB/h |
- V0 泄漏 > V1:standalone 下 ~7×(A1 vs E1),Triton 下 ~27×(E2 vs A2)
- Triton 放大泄漏,对 V0 尤甚
- 唯独 E2 表现出阶跃式内存增长(1% 分位增量接近 1.8 MB,RSS 与 VMS 同步跃升,),指示周期性内存映射未释放;其他三配置为平滑漂移()
5.5 GPU 端
所有部署 VRAM 使用未见显著趋势——36 小时窗口内 PyTorch caching allocator 的碎片化并未显性显现。
六、总结
核心贡献
- 首次给出 GPU-based LLM serving 的老化证据:所有部署在 36 小时窗口内均出现统计显著的进程私有内存缓慢增长;
- 老化源于 orchestration 层而非推理路径:跨 100× 的泄漏率差距在共享同一模型/GPU 的前提下产生,只能归因于 serving 运行时;
- 代际 × 托管层交互效应:Triton + V0 是最差组合并展现独特的阶跃式内存跳变,指向定期映射保留机制;
- 可复现方法学:提供含自相关鲁棒统计的完整框架,为 SAR 社区首度打开 LLM/GPU 场景。
技术影响
- 对运维:现代 LLM 服务在数月量级仍可持续,但 Triton+V0 组合应尽快迁移到 V1;朴素 PyTorch 服务在长期部署下并不比”生产级”更差反而更差;
- 对研究:将 rejuvenation 策略(周期性重启、内存回收提示)引入 LLM serving 是明确的下一步;
- 对可靠性工程:论文提供的 34 指标 × 6 部署 × 36 小时数据集可作为老化基线。
局限性
- 单次运行/单硬件(L40S)/单模型(Qwen2.5-7B),未做 n≥3 复现;
- 2×2 因子存在 vLLM 版本漂移(0.7.3 / 0.10.1.1 / 0.21.0),引擎代际效应与版本效应部分混淆;
- 多租户共享宿主的 CPU/内存/I/O 竞争嵌入了泄漏率估计,未做单租户对照;
- 合成 Poisson 负载缺乏真实流量的突发性与提示重复性。
七、参考资源
- 论文原文:https://arxiv.org/abs/2606.11916
- HTML 版本:https://arxiv.org/html/2606.11916v1
- 相关工作:
- PagedAttention / vLLM(Kwon et al., 2023)
- SAR 综述:Trivedi & Vaidyanathan 系列
- Santos et al. 关于 CPU 上 LLM 推理老化