Kwai Keye-VL-2.0 Technical Report
开源30B MoE多模态基础模型,仅3B激活参数,支持256K超长视频理解
Kwai Keye-VL-2.0 Technical Report: 开源30B MoE多模态基础模型,仅3B激活参数,支持256K超长视频理解
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Kwai Keye-VL-2.0 Technical Report |
| 作者 | Kwai Keye Team, Bin Wen, Changyi Liu, Chengru Song, et al. |
| 机构 | 快手 (Kuaishou) |
| 论文 | arXiv:2606.10651 |
| 代码 | 未开源 |
| 发布 | 2026年6月9日 |
| 许可 | CC BY 4.0 |
二、核心思想
Kwai Keye-VL-2.0-30B-A3B 是快手推出的开源多模态基础模型,采用30B参数的混合专家(MoE)架构,但仅激活3B参数。该模型旨在解决超长视频理解中的两个核心挑战:
- 基础设施瓶颈:扩展到极端视频上下文会导致计算和内存成本激增
- 算法困境:集成复杂异构智能体任务会导致灾难性遗忘,降低基础推理能力
问题定义
现有模型在处理小时级视频时面临两大难题:
- 标准密集注意力机制导致KV缓存灾难性膨胀,迫使模型通过激进的帧子采样牺牲时间连续性
- 多任务对齐过程中,直接注入视频理解和工具使用能力会触发灾难性遗忘,降低STEM、数学和语言推理能力
解决方案概述
Keye-VL-2.0通过以下创新解决上述问题:
- 多模态DSA(DeepSeek Sparse Attention):首次将DSA应用于GQA多模态架构,实现无损256K上下文处理
- 跨模态多教师在线蒸馏(MOPD):通过Context-RL和Video-RL解决多任务对齐中的灾难性遗忘
- 高效训练和推理基础设施:包括可扩展视频I/O、异构ViT-LM并行和自定义DSA内核
三、技术架构
整体框架图
模型由四个核心组件构成:
| 组件 | 说明 | 关键参数 |
|---|---|---|
| Vision Encoder (ViT) | 继承自Keye-VL-1.5-8B,提取视觉特征 | SigLIP-400M-384-14 |
| Language Decoder (LLM) | 基于Qwen3-30B-A3B-Thinking-2507 | 30B参数,3B激活 |
| MLP Projector | 随机初始化,Stage 0训练 | 对齐视觉-语言特征 |
| Sparse Attention Module | GQA兼容的DSA设计 | 全局MQA索引 + 分组GQA聚合 |
核心公式
DSA Lightning Indexer评分函数:
其中 是索引器头数, 和 来自当前查询token , 是共享键。
Top-k稀疏索引集:
GQA稀疏聚合:
设置 ,将核心注意力复杂度从 降低到 ,其中 。
密集预热损失:
稀疏适应损失:
模型组件
Native-Resolution Vision Encoder:
- 自适应位置编码:插值固定绝对可学习位置嵌入,支持可变分辨率
- 2D RoPE:引入二维旋转位置嵌入,提升空间建模能力
- 序列打包:结合NaViT的Patch n’ Pack机制和FlashAttention,支持变分辨率批量训练
DSA for Long-Context Multimodal Modeling:
- MQA风格闪电索引器:全局MQA键共享设计,FP8实现
- GQA稀疏聚合:相同稀疏索引集应用于所有组,保持GQA骨干表示结构
- 两阶段训练:密集预热(2B多模态token)+ 稀疏适应
训练流程
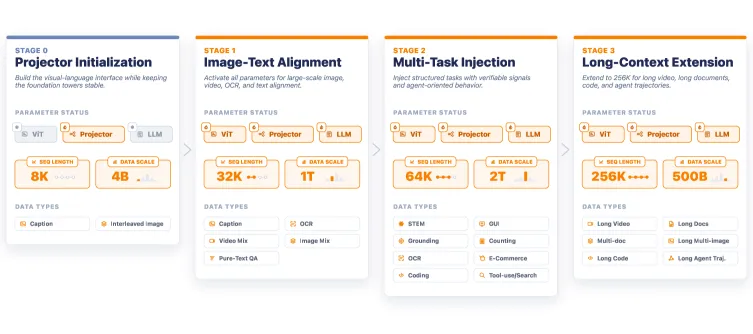
预训练四阶段课程:
| 阶段 | 上下文长度 | 训练token数 | 训练内容 |
|---|---|---|---|
| Stage 0 | - | - | 仅训练Projector,初始化视觉-语言映射 |
| Stage 1 | 32K | ~1T | 全参数多模态预训练,建立视觉-语言对齐 |
| Stage 2 | 64K | ~2T | 多任务能力注入(OCR, VQA, STEM, GUI, grounding等) |
| Stage 3 | 256K | - | 长上下文扩展,聚焦长视频、多页文档、长程智能体轨迹 |
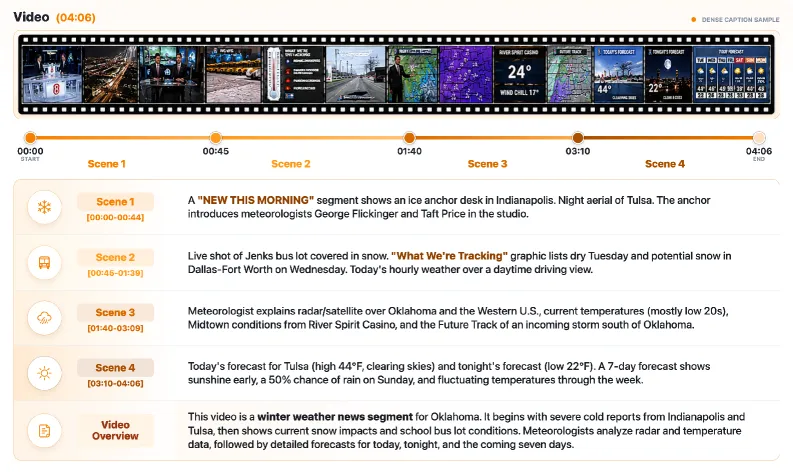
视频预训练策略:
- 每个视频分割为15秒片段
- 每个片段配对caption,组织为交错多模态序列
- 支持时间连续性、场景转换和事件演进理解
后训练流程:
- SFT(监督微调):~500B token,包含Text NLP, Video, Perception, Reasoning, Agent, Long-context数据
- 合成CoT:强教师模型生成推理链,通过质量检查过滤
- 强化学习:Context-RL, Video-RL, 域特定RL(Math, Grounding, OCR等)
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
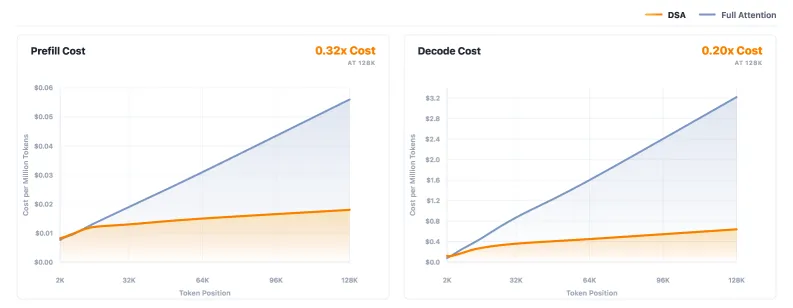
| 多模态DSA | 首次将DeepSeek Sparse Attention应用于GQA多模态架构 | 无损256K上下文处理,推理成本显著降低 |
| Native-Resolution ViT | 原生分辨率视觉编码,避免裁剪或平铺 | 保持全局结构和局部细节,特别适合文档、OCR、视频场景 |
| MOPD跨模态蒸馏 | 跨模态多教师在线蒸馏,解决多任务对齐中的灾难性遗忘 | 密集token级教师反馈蒸馏回MoE骨干 |
| ViT-LM异构并行 | ViT和LM采用不同并行分片策略,负载均衡 | 训练吞吐量提升约20% |
| DSA内核优化 | 使用FlashInfer和TileLang优化DSA,实现2倍以上加速 | Top-k内存优化、短序列优化、索引器损失优化 |
五、代码实现分析
论文未开源代码,但从技术报告可推断关键实现细节:
训练基础设施:
- ExtraIO:异步流水线的可扩展I/O服务,解耦视频解码和帧采样
- ViT-LM异构并行:ViT和LM位于同一GPU组,但采用独立并行分片策略
- 两级负载均衡:多模态token级别和LM样本级别均衡
推理优化:
- Chunk ViT推理:将视觉编码分块处理,支持超长视频
- DSA+GQA联合推理:全局MQA索引 + 分组GQA聚合
- FP8量化:闪电索引器使用FP8实现,提升效率
六、实验结果
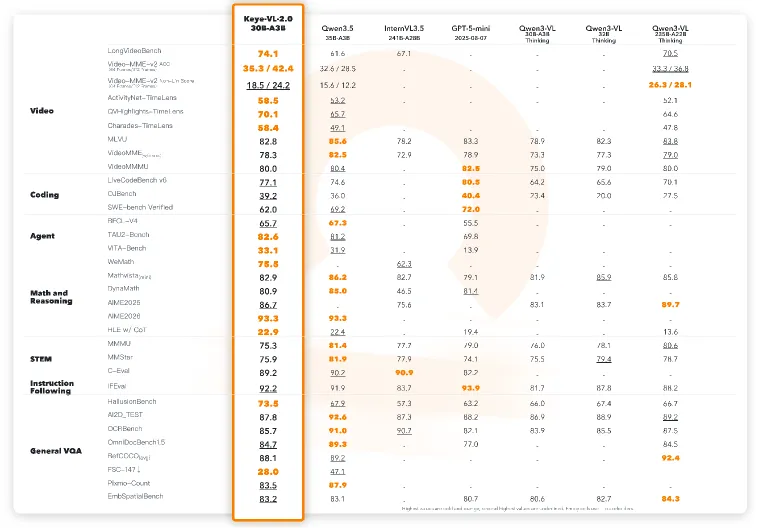
基准测试
视频理解:
| 基准 | Keye-VL-2.0 | Qwen3.5-35B-A3B | InternVL3.5-241B | GPT-5-mini | Qwen3-VL-235B |
|---|---|---|---|---|---|
| LongVideoBench | 74.1 | 61.6 | 67.1 | - | 70.5 |
| Video-MME-v2 (64帧) | 35.3 | 32.6 | - | - | 33.3 |
| Video-MME-v2 (512帧) | 42.4 | 28.5 | - | - | 36.8 |
| MLVU | 82.8 | 85.6 | 78.2 | 83.3 | 83.8 |
| Video-MME (w/o sub.) | 78.3 | 82.5 | 72.9 | 78.9 | 79.0 |
时间定位(TimeLens):
| 基准 | Keye-VL-2.0 | Qwen3.5-35B-A3B | Qwen3-VL-235B |
|---|---|---|---|
| ActivityNet-TimeLens | 58.5 | 53.2 | 52.1 |
| QVHighlights-TimeLens | - | - | - |
| Charades-TimeLens | - | - | - |
代码智能体:
| 基准 | Keye-VL-2.0 | Qwen3.5-35B-A3B | GPT-5-mini | Qwen3-VL-235B |
|---|---|---|---|---|
| SWE-bench Verified | - | - | - | - |
| WebArena | - | - | - | - |
消融实验
论文未提供详细消融实验,但从训练流程可推断:
- DSA两阶段训练:密集预热(2B token)→ 稀疏适应,确保索引器覆盖所有GQA组的注意力分布
- MOPD多教师蒸馏:域特定教师(Math, Grounding, OCR, LAN-Instruct)路由,权重共享复用服务器实例
- Context-RL:上下文强化学习,提升长程推理能力
- Video-RL:视频强化学习,增强时序理解
与现有方法对比
Keye-VL-2.0-30B-A3B在以下方面表现突出:
- 长视频理解:LongVideoBench 74.1(超越Qwen3-VL-235B的70.5)
- 时间定位:ActivityNet-TimeLens 58.5(超越Qwen3.5-35B-A3B的53.2)
- 模型效率:30B参数仅激活3B,推理成本显著低于同等规模密集模型
- 上下文长度:支持256K无损处理,适合小时级视频
七、相关工作
- DeepSeek Sparse Attention (DSA):DeepSeek-V3.2引入的稀疏注意力机制,Keye-VL-2.0首次将其应用于GQA多模态架构
- Native-Resolution ViT:NaViT, Qwen3.5, K2.5, MiMO等模型采用的原生分辨率视觉编码
- Mixture-of-Experts (MoE):Shazeer等人提出的混合专家架构,Keye-VL-2.0采用30B参数仅激活3B的设计
- 多模态强化学习:Context-RL, Video-RL等方法,用于提升长程推理和时序理解能力
- 跨模态蒸馏:MIMO v2 Flash等模型采用的多教师在线蒸馏方法
八、总结
核心贡献
- 多模态DSA架构:首次将DeepSeek Sparse Attention应用于GQA多模态架构,实现无损256K上下文处理
- Native-Resolution ViT:原生分辨率视觉编码,保持全局结构和局部细节
- MOPD跨模态蒸馏:解决多任务对齐中的灾难性遗忘,通过密集token级教师反馈蒸馏
- 高效训练推理基础设施:ViT-LM异构并行、DSA内核优化、Chunk ViT推理
- SOTA性能:在长视频理解、时间定位等基准上达到同等规模模型领先水平
技术影响
- 长视频理解:使小时级视频理解成为可能,突破传统模型的帧数限制
- 部署效率:30B参数仅激活3B,推理成本可控,适合实际应用
- 开源生态:提供开源模型检查点,推动社区向可扩展多模态智能体应用发展
- 基础设施:异构并行和DSA优化为大规模多模态训练提供参考
局限性
- 代码未开源:技术报告未提供代码实现细节
- 评估覆盖有限:部分基准(如WebArena、SWE-bench)结果未提供
- 训练成本:四阶段预训练和多阶段后训练需要大量计算资源
- 智能体能力:虽然支持Code、Tool、Search场景,但具体实现细节不足
九、参考资源
- 论文: arXiv:2606.10651
- HTML版本: arXiv HTML
- 相关工作:
- DeepSeek-V3.2: DeepSeek Sparse Attention (DSA)
- Qwen3-30B-A3B: 语言解码器基础
- Keye-VL-1.5: 视觉编码器继承
- SigLIP-400M-384-14: ViT骨干网络